ARTICLE · 1372371
选举源码拆解,kill 掉 leader 的那八秒里发生了什么
落笔相逢,我是军哥!
半夜两点,告警群里弹出一条消息,某条日志流的 leader 所在节点宕机,业务写入卡了几秒后自动恢复。第二天晨会,老板问了一个所有 DBA 都会被问的问题,那几秒里到底发生了什么,为什么是几秒不是毫秒也不是几分钟。
这个问题靠"教材说 OB 有自动选主"是糊弄不过去的。我把 src/logservice/palf/election 目录翻了一遍,答案比我预想的清楚得多。那几秒可以拆成四段,每一段在代码里都有对应的东西在跑。这篇就把这四段拆给你看。
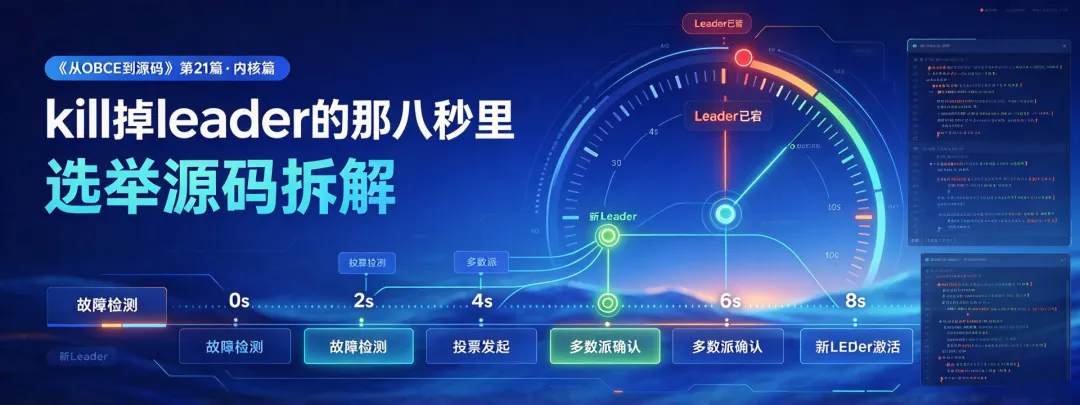
八秒是怎么花掉的
以一次典型的 leader 宕机为例,时间轴大致这么走。
第一段,租约检测。leader 和 follower 之间有租约机制,leader 定期续约证明自己活着。节点宕机后没人续约,follower 要等租约过期才敢确定"leader 真的死了"。这段是大头,通常几秒。
第二段,选举。候选者发 prepare 请求拉票,收齐多数派赞成票后进入 accept 阶段正式登基。网络正常的话这段是毫秒到百毫秒级。
第三段,服务恢复。新 leader 要把日志状态追齐,确认位点推到位,这个日志流才能重新接写。palf 里有个专门的 reconfirm 阶段干这件事。
第四段,应用感知。OBProxy 和应用端要知道新 leader 在哪,路由表刷新,连接重定向。这段快则几百毫秒,慢则一两秒。
四段加起来,就是告警里那个"几秒"。经验数字八秒上下,前提是参数没被人乱动。下面进代码。
选举三件套,proposer、acceptor、impl
src/logservice/palf/election/algorithm 目录下三个核心文件,分工明确。
election_proposer.cpp 管拉票,我要当 leader,我发请求,我统计票。election_acceptor.cpp 管投票,别人来拉票,我判断投不投。election_impl.cpp 管状态机和消息分发,选举请求进来后由它分发给 proposer 和 acceptor 两个角色。
一个节点同时是 proposer 和 acceptor,这跟经典 Paxos 的角色设定一致。OceanBase 的选举协议基本就是 Paxos 选主那套,prepare 加 accept 两个阶段,加了租约和优先级这些工程化改良。
拉票侧,续约和主动发起
先看 leader 这边怎么保住位子。election_proposer.cpp:225 的 register_renew_lease_task_ 注册了一个周期任务:
// 如果续约不够快很多case不能及时切主,所以当MAX_TST设置的比较大时,也让续约间隔设置的短一些 if (CLICK_FAIL(p_election_->timer_->schedule_task_repeat(renew_lease_task_handle_, std::min(int64_t(500_ms), CALCULATE_RENEW_LEASE_INTERVAL()),
中文注释直接躺在源码里,续约间隔取 500 毫秒和计算值的较小者。任务体里有一行关键判断(:259),leader_revoke_if_lease_expired_,leader 发现自己的租约过期了会主动退位。这个设计防的是脑裂,leader 跟多数派失联后自己让贤,不能赖在位子上继续接写。
还有个细节值得品味,:294 附近的注释写着"Leader 不应该靠定时任务主动做 Prepare,只能被动触发 Prepare"。在任 leader 不主动拉票,只续约。拉票是挑战者干的事。这个约束让稳态下的选举消息量降到接近零。
投票侧,时间窗和租约检查
再看 acceptor 怎么投票。election_acceptor.cpp:124 起是一个 250 毫秒跑一次的定时任务,里面有整篇最精彩的一段:
bool lease_valid_state = !lease_.is_expired(); if (last_record_lease_valid_state != lease_valid_state) { if (lease_valid_state) { LOG_ELECT_LEADER(INFO, "witness new leader"); } else { LOG_RENEW_LEASE(WARN, "lease expired"); p_election_->event_recorder_.report_acceptor_lease_expired_event(lease_); lease_.reset(); } }
acceptor 盯着自己见证的租约。租约从有效变无效,意味着"本副本可能与 Leader 失去了网络连接"(源码注释原文),这时才具备投票给别人前提条件。租约还有效的时候来了拉票请求,acceptor 不会立刻投,它把请求记进"时间窗口"(:158 起的 is_time_window_opened_ 逻辑),等窗口关闭时挑出优先级最高的那个候选者投票。
时间窗这个设计是选举不抖的关键。多个候选者同时拉票时,acceptor 不急着投给先到的,等一小段窗口期,把票投给窗口内条件最好的。对应八秒时间轴里的第二段,选举本身很快,快就快手投票是集中式收集而非一来一回的拉扯。
投完票 ballot number 推高(:178),旧 ballot 的请求一律拒掉(:59 的 check_ballot_valid),防止过期消息复活旧 leader。
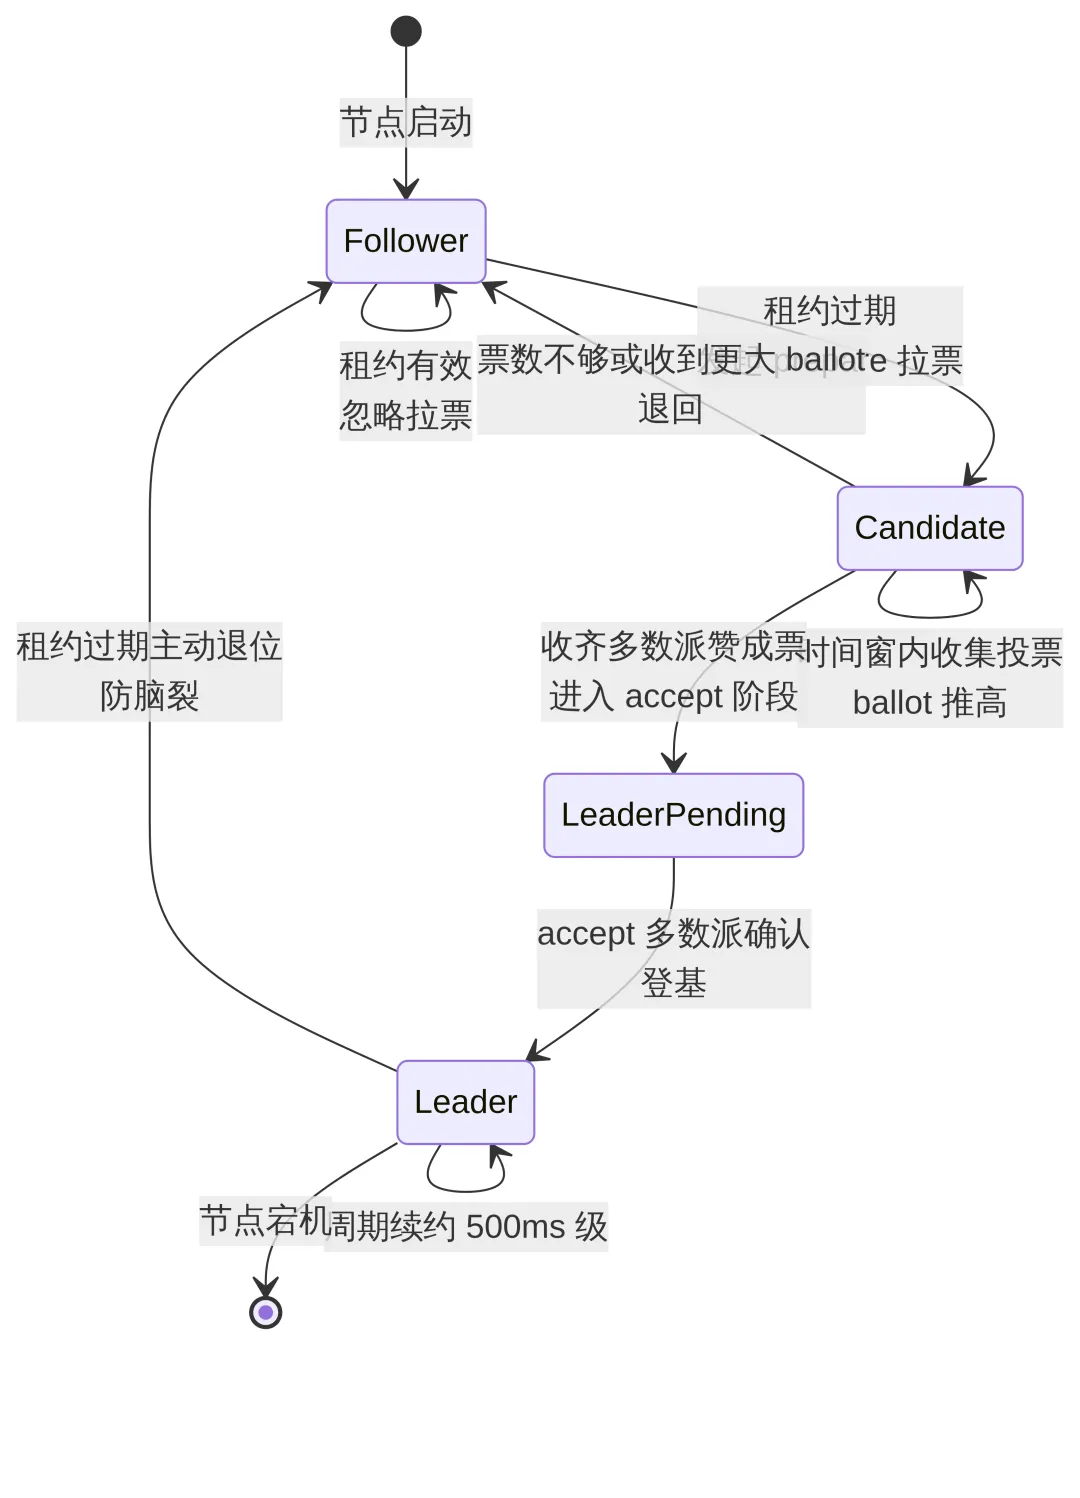
状态机全景
把上面这些串成一张图:
资格审查,RPO=0 是怎么保住的
选举本身只解决"选谁",不解决"选出来的人数据全不全"。OceanBase 的答案分两层。
第一层在选举侧,候选者必须是 paxos 成员列表里的人,优先级模块(ElectionPriority,election_impl.cpp:197 的 set_priority)可以表达"我不希望它当 leader",比如异地副本、刚Rebuild完的副本。
第二层在选举之后,新 leader 上位先过 reconfirm 这一关。src/logservice/palf/log_reconfirm.cpp:427 附近,新 leader 要拿到 majority_match_lsn,跟多数派成员逐条对齐日志,把上一任 leader 已确认但自己还没有的日志追齐,确认位点推到多数派确认过的位置之后才开始接写。多数派确认过的日志在新 leader 上必然存在(多数派的交集性质,第 3 篇的账本),所以已提交的数据一条不丢,RPO=0 就是这么闭环的。
优先级管理日常运维里打交道的地方是 leader_coordinator,它负责把 leader 往该去的地方调度,比如 primary zone 设置后把 leader 切到指定机房。底层调的正是 PalfHandleImpl::change_leader_to(palf_handle_impl.cpp:517),最终走到 ElectionProposer::change_leader_to(election_proposer.cpp:144)。
几千个日志流同时选举的消息风暴
一台 observer 宕机,上面可能有几千条日志流的副本。它们同时检测到租约过期,同时发起选举,这就是消息风暴。
OceanBase 的缓解手段前面已经见过两个。时间窗机制让 acceptor 把拉票请求攒起来批量处理。续约周期 500 毫秒加随机化的触发时机,避免所有日志流齐刷刷在同一毫秒行动。再有就是消息本身的统计和限流,election_impl.cpp 里每个 handle_message 入口都有 msg_counter_ 统计收发量(:238),出问题时有据可查。
风暴期查选举问题,observer 日志里 grep "ELECT" 关键字,dump proposer info 和 dump acceptor info 每 3 秒各打一次(前面两段代码里都见过这个 3_s),角色、ballot、租约状态全在里面。
实验,kill leader 掐表
三副本测试集群,可复现。
第一组,裸切换。找到某日志流 leader 所在节点,kill -9 observer 进程,同时掐表。观察点三个,业务写入恢复时间、GV$OB_LOG_STAT 里角色变化、observer 日志里 "witness new leader" 和 "lease expired" 的时间差。预期写入中断几秒后恢复,日志里能看到租约过期、拉票、登基的完整序列。
第二组,优先级对照。给某个 follower 配低选举优先级,再 kill leader,观察新 leader 是不是绕开了它。再把优先级调回来做一次。两组对照,优先级生效的路径就验证了。
第三组,主动切主。不 kill,用 alter system switch replica 或 leader_coordinator 的方式主动切。预期切换时间明显短于 kill,因为走 change_leader_to 主动禅让,不用等租约过期。三组摆在一起,八秒时间轴的每一段都能被单独验证。
面试怎么答,生产怎么查
面试问"OB 的选举和 Raft 有什么区别",抓手有三个。租约机制,稳态靠续约维持权威,leader 失联自己退位防脑裂。时间窗投票,acceptor 攒票择优,选举快且不抖。两阶段职责分离,选举管选谁,reconfirm 管数据追齐,RPO=0 是两层合力的结果。
生产上怀疑选举异常,先看现象是选不出来还是选出来又掉。选不出来查成员列表和多数派是否健在。反复切换查网络抖动和租约参数。日志路径 grep ELECT observer.log,witness new leader、lease expired、vote 这几行按时间排开,八秒时间轴自己就浮现了。
留给你的三个思考题
1. 面试官问"为什么 leader 发现租约过期要主动退位,等别人把自己选下去不行吗",用脑裂场景回答。
2. 时间窗机制里,如果窗口设得太长会怎样,太短会怎样?这个参数在调什么权衡?
3. 一台机器宕机触发几千条日志流同时选举。除了文中提到的手段,你还能想到什么工程办法压制风暴?(提示,想想分批和退避)
干货已送达,点赞是签收,转发是好评,留言是售后!
关于我:郭一军 | 云贝教育创始人 | 25 年数据库老兵,长期为银行、证券等金融机构授课,专注信创数据库人才培养。
推荐阅读.从OBCE到源码
一、基础篇
二、架构篇
三台机器的 CPU 是 85%、30%、25%,负载均衡坏了吗
我把租户 A 的 CPU 打满了,租户 B 为什么还是抖了一下
IO调度源码合并和业务抢IO怎么办?翻出IO调度器的源码
三、内核篇
MemTable 明明最新,OceanBase 为什么不先读它
一次空查询要读几张 SSTable?BloomFilter的拦截战
更多精彩,关注我公众号,一起学习、成长