ARTICLE · 1374143
百万骑手的 App 要同时收到派单指令,这条通道怎么建
那年七月一个暴雨晚高峰,我在值班群里看着派单成功率从 99.6% 一路往下掉,十分钟跌到 91%(示例数字,下同)。
最诡异的是,派单引擎这边的日志干干净净:每一单都算出了最优骑手,每一条消息都显示"下发成功"。但客服电话已经被打爆了,骑手们反馈高度一致——手机根本没响,等看到订单弹出来,顾客已经催了三遍。
问题出在派单的"最后一公里":服务器知道这单该给谁,但这条指令没能走到骑手的手机上。
排查下来是两个问题叠在一起。第一,大量骑手在高架、电梯、地下商场里穿梭,TCP 连接其实早就断了,但服务器这边的 socket 还"看起来连着",消息写进了内核缓冲区,石沉大海。第二,一些国产手机把后台 App 进程清理掉了,我们走厂商通道的兜底推送又赶上渠道限流,唤醒延迟从平时的几百毫秒飙到了几十秒。
前面几篇文章,我们花了很大力气讲上行通道:位置多久上报一次、上报洪峰怎么削、位置索引怎么建。那条通道解决的是"服务器怎么看清骑手在哪"。但派单是一笔双向生意——看清楚之后,你还得把指令送回去。这篇就讲这条下行通道:自研长连接怎么建、在线状态怎么判、推送触达率怎么抠到 99.9% 以上。
一、上行和下行,根本不是一条对称的通道
很多团队做推送的第一个坑,是把下行通道当成上行通道的"反向版"来做。这俩看起来都跑在同一条网络连接上,脾气却完全相反。
位置上报是高频、可降级的流量。骑手每几秒一次坐标,丢一两个点无所谓,系统本来就允许位置旧几秒;饭点洪峰来了,降频、合并、排队,什么手段都能用——这个系列第六篇算过那笔账,上报间隔这个参数背后是几千万的成本,第八篇讲洪峰时也是先砍上报保派单。
派单指令是低频、不可降级的流量。一个骑手高峰期一分钟也就收几条指令,但每一条都有三个硬要求:不能丢,丢了这单就没人送;不能晚,晚一分钟顾客就退单;不能重复执行,重复弹单会让两个骑手同时奔向一家取餐。
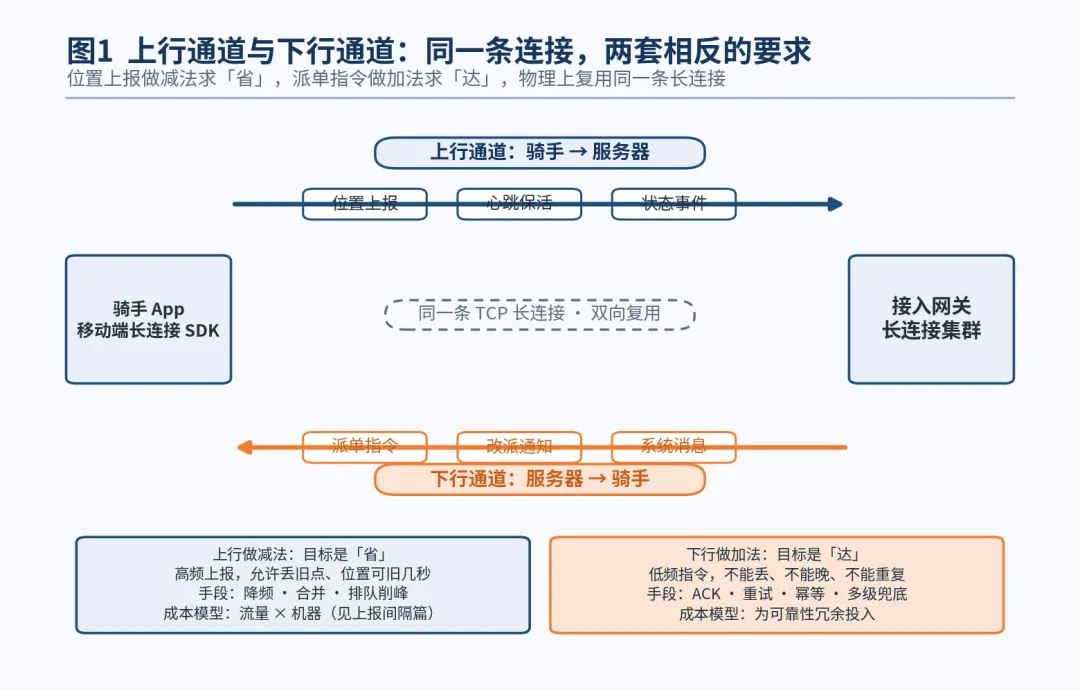
两个方向的要求可以拉成一张对照表看:上报通道追求的是省,用最少的流量和机器维持全局视野;派单通道追求的是达,不惜加确认、加重试、加兜底也要保证指令落地。一个做减法,一个做加法。
但有意思的是,这两条脾气相反的通道,物理上复用的是同一条长连接。骑手 App 与网关之间维护一条 TCP 长连接,位置上报从这条管道往上走,派单指令从这条管道往下推,连心跳信令都搭这趟便车。能不能把这一条连接用好,就是接入层团队的全部功夫。
二、为什么不能全靠手机厂商推送
听到"给手机发消息",很多人第一反应是接 APNs、接华为小米 OPPO vivo 的厂商推送通道,SDK 一接完事。我们早期也这么想过,直到真正研究了这些通道的语义。
厂商推送的本质是尽力而为(best effort),它有四个绕不过去的坎。
第一,链路不可控。消息要先出我们的机房,进厂商的推送服务器,再由厂商的长连接下发到手机。任何一段拥塞,时延就不可控,平时几百毫秒,高峰期几十秒甚至分钟级,而派单指令的预算是秒级。
第二,生命周期不归你管。消息可能被系统折叠、合并、限流,推送配额按 App 分级,新 App、小 App 的配额低得可怜。payload 也只有几 KB,塞不下订单详情。
第三,状态是黑盒。你知道"我交给厂商了",但不知道厂商什么时候发出去、手机什么时候收到、用户有没有看到,没有 ACK,触达率算不清楚。
第四,数据要出域。订单指令带着商家地址、顾客位置,走第三方通道涉及数据合规审查,能少发就少发。这也是兜底推送只放精简指令、完整订单走自己通道拉取的另一个原因——敏感数据尽量不出自己的机房。
那厂商通道是不是没用?恰恰相反,它有一个不可替代的场景:唤醒。App 被系统杀掉之后,你自己的长连接已经不存在了,整个世界上只有厂商通道能把 App 重新拉起来。
所以最终的分工是这样的:App 在前台、长连接活着的时候,自研通道是主力,毫秒级、可确认、可双向通信;App 不在了,厂商通道当"叫醒电话",payload 里只放一句精简指令,App 被唤醒后重新建连,再走长连接把完整订单拉回来。把主力和兜底分开,是这条通道的第一个架构决策。
顺带解释为什么不用轮询。假设百万骑手每 4 秒拉一次"有没有我的单",服务端要扛 25 万 QPS,而其中 95% 以上是空轮询、查无收益——绝大多数请求除了证明"现在没单"什么都换不回来,这是用服务器的命去填移动端的省电策略。长连接的思路反过来:不问了,改成"等着",有单时服务器主动找你。成本从"百万次无效询问"变成"维护百万条连接",这就引出了接入层的设计。
三、自研长连接的骨架:网关集群与全局路由表
长连接系统的核心矛盾是:连接是有状态的(一条 TCP 连在某台网关机上),但集群必须是可水平扩展的。我们的解法是把"连接态"和"路由视图"分开存放。
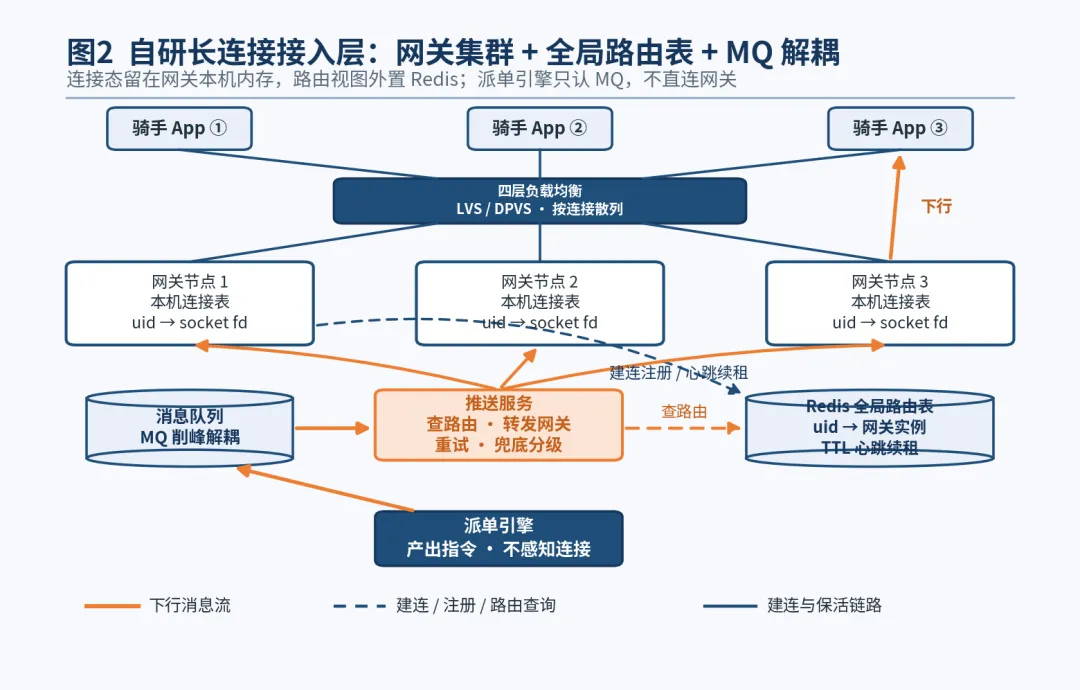
整体骨架分四层。
接入层是网关集群,前面挂四层负载均衡(LVS/DPVS),骑手 App 建连时被分散到不同网关机。网关之间不互相感知,每台机器只负责自己手上的连接,用 epoll(或 Go netpoll)加协程模型承载,单机维持几十万条长连接是常规水平。
路由层是一张全局表,放在 Redis 里:key 是骑手 uid,value 是他当前连在哪台网关机上,附带连接的逻辑编号。这张表带 TTL,由心跳持续续租。网关本机内存里还有一份连接表,记录 uid 到 socket fd 的映射——本机表回答"这条连接在我这怎么写",Redis 表回答"这个骑手在哪台机器"。
消息层是消息队列。派单引擎不直接找网关,而是把派单指令投进 MQ,下游的推送服务消费后,先查 Redis 路由表定位网关机,再通过内网 RPC 把消息转给那台网关,网关从本机连接表里找到 fd 写下去。加 MQ 这一跳不只是为了解耦和削峰:引擎只管发,网关集群扩缩容、重启换机,引擎完全无感;更关键的是它顺手把消息语义抬了一档——MQ 天然提供"至少一次"投递,推送服务处理失败或重启时消息会被重投,消费速度跟不上时队列堆积形成背压,保护下游不被打穿。这条"引擎投 MQ、推送服务消费、失败可重投"的链路,正是第五节 at-least-once 加客户端幂等能够成立的地基,而不是到了终端才临时补上的约定。
终端层就是骑手 App,内置私有协议栈。
协议选型上,原生 App 走的是基于 TCP 的私有二进制协议,套 TLS,序列化用 protobuf。对比过 WebSocket:WSS 要带 HTTP 头、帧结构也更重,适合 H5 和小程序这类没有别的选择的场景;原生 App 用私有协议,心跳格式、重试策略、字段裁剪全都自己说了算,一条心跳包能压到几十字节。
建连过程有几个不能省的细节。App 启动后先用登录 token 请求网关,网关鉴权通过才把 uid 与这条连接绑定,然后写 Redis 路由表。同一个账号在新设备登录,新连接要把旧连接踢掉,否则一条指令会在两个终端同时响——骑手换手机、双开 App 都是真实场景。断线重连用指数退避加随机抖动,为什么要加抖动?暴雨天一个基站断了,底下几万人同时重连,齐刷刷的重试会把网关打成第二次故障,随机抖动把这股人潮摊平到几秒里。
四、在线是一种"状态",不是一根连着的线
这是整篇文章里我最想讲清楚的一点:TCP 连着,不等于骑手在线。
移动网络会制造大量"假在线"。骑手进电梯、过隧道,手机信号丢了,但 TCP 不会立刻感知,socket 在服务器端依然完好,这个状态可能维持几分钟,直到 TCP keepalive 或下一次写操作失败才暴露。运营商的 NAT 设备还有表项老化机制,连接空闲一段时间,NAT 上的映射直接被回收,这条连接在服务器视角里还"活着",其实回程路已经断了。再加上 App 被切后台、被系统冻结、被省电策略查杀,"连接态"和"业务可用态"之间隔着一整条鸿沟。
我们的做法是把在线显式建模成一个状态机,而不是隐含在 socket 状态里。
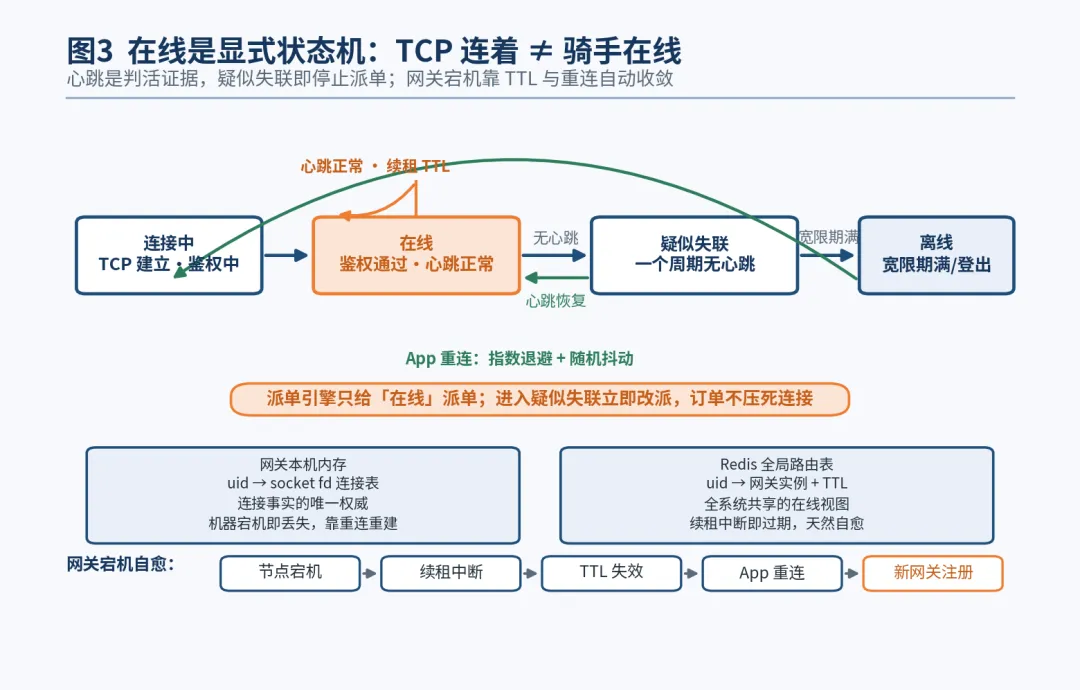
状态机有五个状态:连接中(TCP 建立、鉴权未完成)、在线(鉴权通过、心跳正常)、疑似失联(一个心跳周期没收到心跳,开始倒计时)、离线(宽限期满仍未恢复,或 App 主动登出)、以及重连后的回流。派单引擎只给"在线"状态的骑手派单;进入"疑似失联"的骑手,订单改派给其他人,原通道保留一小段时间等他回来。
判活的证据是心跳。App 按约定间隔发心跳包,网关收到就刷新本机计时、续租 Redis 的 TTL。心跳间隔怎么定是个经典权衡:间隔太短,百万连接的心跳流量和手机电量都扛不住;间隔太长,NAT 老化会先一步掐断连接,假在线窗口变大。我们用的是智能心跳:App 在前台时用短间隔,切后台后逐级放宽,结合当前网络类型(Wi-Fi/4G/5G)和历史 NAT 老化探测结果自适应;一旦监测到网络切换(基站切换、IP 变化),立即重置连接而不是等超时。
两级存储各有分工。网关本机内存是连接的权威事实,fd 在不在、能不能写,只有这台机器说了算;Redis 路由表是给全系统看的全局在线视图,带 TTL 意味着它天然能自愈。代价是两者之间必然存在一个短暂的不一致窗口:连接刚断开的瞬间,Redis 里的路由项可能还指着已经失效的网关,任何系统都做不到两级存储的瞬时强一致。我们的选择是不追求强一致,而是允许路由表"短暂陈旧",把正确性交给 TTL 兜底——陈旧项最多存活一个心跳周期就自动失效,配合推送失败后的重试与改派,这个窗口不会造成实质损失。下面这次宕机演练,就是这套自愈机制的完整展示。
这里讲一次真实的故障演练。一台网关机物理宕机,上面压着几十万连接,本机内存里的连接表瞬间蒸发。系统没有做任何"摘除"动作:Redis 里那些 uid 的路由表项因为续租中断,在 TTL 到期后自动失效,骑手 App 检测到断线后自动重连,被负载均衡分配到健康网关机、重新注册路由。整个收敛过程等于 TTL 加一次重连的时间,期间这些骑手在全局视图里处于"疑似失联",派单引擎绕开他们。没有人工干预,没有脏数据残留——这就是把状态机和 TTL 设计对了之后,故障自己变好的样子。
五、触达率是设计出来的:三级兜底与漏斗度量
在线状态解决了"该发给谁",接下来解决"怎么确认他真的收到了"。我们的触达体系是三级兜底结构。
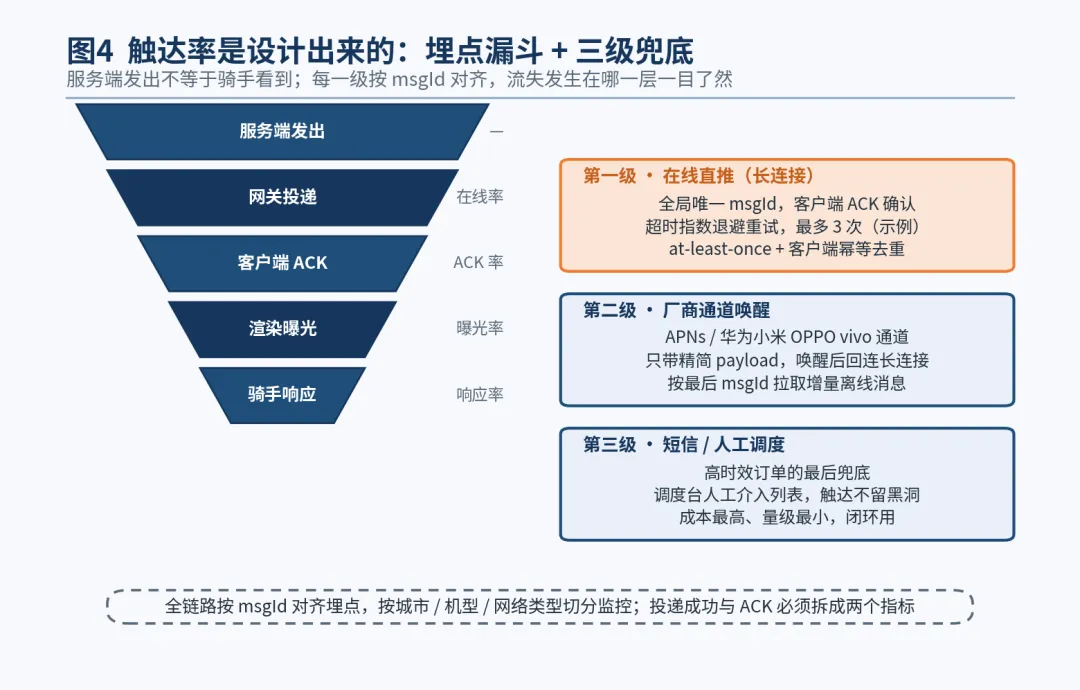
第一级,在线直推加 ACK 确认。每条派单指令生成时由发号器分配全局唯一的 msgId,网关写下去之后并不算完,客户端收到、落库、弹窗,回一个 ACK。服务端在超时时间内没等到 ACK,就按指数退避重试,最多重试 N 次(示例口径 3 次)。注意语义:我们提供的是"至少一次"(at-least-once),不承诺"恰好一次"——网络两端的握手注定无法同时确认对方的确认,工程上能做到的是重试加幂等。客户端维护一张近期 msgId 去重表,重复送达的指令只认第一条,绝不会让骑手听到两声单响。
这里要划清 ACK 的语义边界:"收到"和"看到"是两件事。ACK 只能证明客户端进程收到了消息,证明不了骑手的眼睛看到了弹窗——手机可能正揣在口袋里,弹窗也可能被系统通知栏折叠。所以派单指令的强闭环不能止步于 ACK:普通订单盯到后面漏斗里的"渲染曝光"即可,高价值或高时效订单则要继续盯到"骑手点击响应",在 SLA 时间内没有响应就自动进入改派流程。只有把确认点一路推到人的动作,"触达承诺"才算真正落地。
第二级,厂商通道唤醒。重试耗尽,或者路由表里本来就是离线状态,消息转投厂商推送。如前面说的,推送只带精简字段,App 被唤醒、长连接重建后,带着"我最后收到的 msgId"来拉增量消息。服务端按 uid 保留最近 N 条离线消息,重连后的缺口一次补齐,骑手在地下车库转一圈出来,订单不会丢,只是晚了十几秒。
第三级,短信与人工调度兜底。对时效最敏感的订单,前两级都失败时还有短信通知,以及调度后台的人工介入列表。这一级成本高、量最小,但它把系统的触达承诺从"尽量"变成了"有闭环"。
三级兜底能不能生效,前提是你得看得见每一级的流失。我们在链路上埋了五个点:服务端发出、网关投递、客户端 ACK、界面渲染曝光、骑手点击响应。每个点按 msgId 对齐,形成一个漏斗,在线率、ACK 率、曝光率、各渠道延迟分布全部按城市、机型、网络类型切分监控。前面开场那场事故,事后复盘最大的改进不是加了什么机器,而是把"网关投递成功"和"客户端 ACK"拆成了两个指标——在那之前,这两个数字被混在一起,假在线问题被掩盖了整整两个版本。
这个漏斗还有一个意外收获:按机型切分之后,问题会自己浮出来。我们曾经发现某个品牌的中端机型 ACK 率系统性地低两个百分点,顺藤摸瓜查下去,是那一版系统的后台查杀策略格外激进,App 退到后台三分钟就被冻结。针对性的解法不是改架构,而是优先接入这家的厂商推送通道、调整前台服务保活策略,再把这个机型的心跳策略调得更保守。触达率治理到最后,往往不是一次大改,而是一堆按机型、按城市、按网络环境逐个抠出来的小决策。
最后说一个反直觉的点:"百万骑手同时收到"在工程上是个伪需求。真正的全量瞬时下发会制造三场风暴:网关侧百万级并发 write,客户端所在手机的线程和通知栏风暴,以及紧接着打回来的 ACK 风暴。我们的批量下发走令牌桶分批平滑,按城市和网关分片,把一百万人摊到几百毫秒的窗口里——人感知上就是"同时",系统感知到的是一条平缓的曲线。至于全员公告这类广播消息,更不会走单播循环:服务端只推一个"版本号变了"的轻量信令,客户端按需拉取内容,把一次百万推送变成百万次各自的小动作。这个思路和第八篇讲的洪峰削峰是同一个心法。
六、百万连接的账:容量模型与心跳成本
最后算两笔账,接入层的容量规划就是从这两笔账倒推出来的。
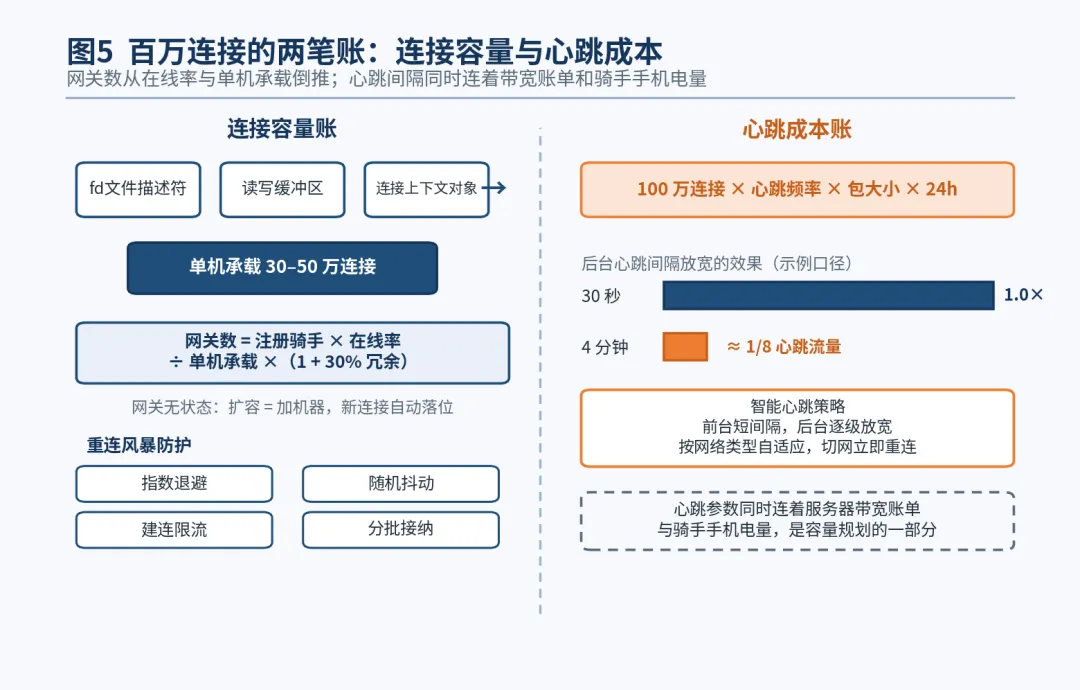
第一笔是连接容量账。一条长连接在服务器上的成本是三项:一个文件描述符、一块读写缓冲区、一个连接上下文对象。按我们的示例口径,单机稳定承载 30 到 50 万条连接,那么百万在线需要的网关数不是简单地拿一百万除——先乘在线率(注册骑手里高峰同时在线的比例),再除以单机承载,最后留 30% 以上的冗余应对宕机和重连迁移。网关是无状态设计,扩容就是加机器,新连接自动落上来,老连接靠重连逐步摊平。
第二笔是心跳成本账,这笔账和第六篇的上报成本乘法是同一个公式:连接数 × 心跳频率 × 单包大小 × 时长。百万连接如果心跳间隔 30 秒,一天光心跳就是 288000 万次 × 百万量级的双向包;把后台心跳放宽到 4 分钟级,心跳流量直接降到八分之一上下,手机电量曲线也好看得多。这也是为什么智能心跳不是体验优化,而是容量规划的一部分——心跳间隔这个参数,同时连着服务器带宽账单和骑手的手机电量。
容量规划里还要预留一个最容易漏的场景:重连风暴。正常情况下连接是均匀建立的,但大面积网络抖动、网关重启、雷雨天气会制造集中重连。除了前面说的客户端随机抖动,网关侧要做建连限流和分批接纳,宁可让一部分骑手多等两秒重连,也不能让集群在重连潮里雪崩。上线前我们会专门压这个场景,这是后话。
收尾:三条心法
第一条,在线是"证伪"出来的,不是默认的。没有心跳证据,就按疑似失联处理,派单引擎宁可保守改派,也不要把订单压在一条可能已经死了的连接上。
第二条,可靠性来自确认和兜底,不来自"连上了"。msgId、ACK、重试、客户端幂等、离线消息、厂商唤醒,一层一层把"尽力而为"垫成"有闭环"。
第三条,上行做减法,下行做加法,但它们跑在同一条连接上。上报通道靠降频合并省钱,派单通道靠确认重试保到达,把一条长连接的双向价值吃透,就不用为两套链路付两份成本。再往深看一层,这也是接入层在整个系统里的特殊之处:全系统每一层都只服务一个目标,唯独接入层必须在同一个物理层上同时伺候"省"和"达"两个相反的目标——心跳既要够勤以判活,又要够省以护着带宽和电量;连接既要轻到能单机扛几十万条,又要重到带得动确认、重试和兜底。这个系列一路讲下来的"从业务模式倒推架构",在接入层体现得最集中:不是先有一条连接再往上堆功能,而是两个相反的业务诉求,把这条连接逼成了现在的样子。