ARTICLE · 1383378
商汤开源 9B 新模型:免费下载,10GB 显存就能本地跑
先说结论
它是什么商汤“日日新”开源的多模态模型,能读图和文字,输出文字
免费程度权重和代码全开放,Apache 2.0,官方说明允许商用;自己部署,没有调用费
门槛官方 4bit 量化版约 4.9GB,部署显存最低约 10GB 内(64K 上下文)
新在哪把中间 24 层重复跑两遍,9B 存储量跑出 56 次层计算
要留意这是“自己部署”,不是云端免费额度;官方说复杂长任务还不稳
它是什么:参数不涨,让模型多“想”一遍
11 月 17 日晚,商汤正式发布并开源 SenseNova Loop-9B。10 月 31 日它先放出过 Preview 版,这次是正式版。
官方页面给的规格:总参数约 9B,输入文字和图片、输出文字,上下文最高 512K tokens。
特别的地方是结构。模型有 32 个物理层,其中第 4 到 27 层共用同一套权重、连续跑两遍,一次推理就是 56 次层计算,但存的权重只有 32 层的量。
打个比方:不是再招一批人,而是让同一批人把材料再过一遍。
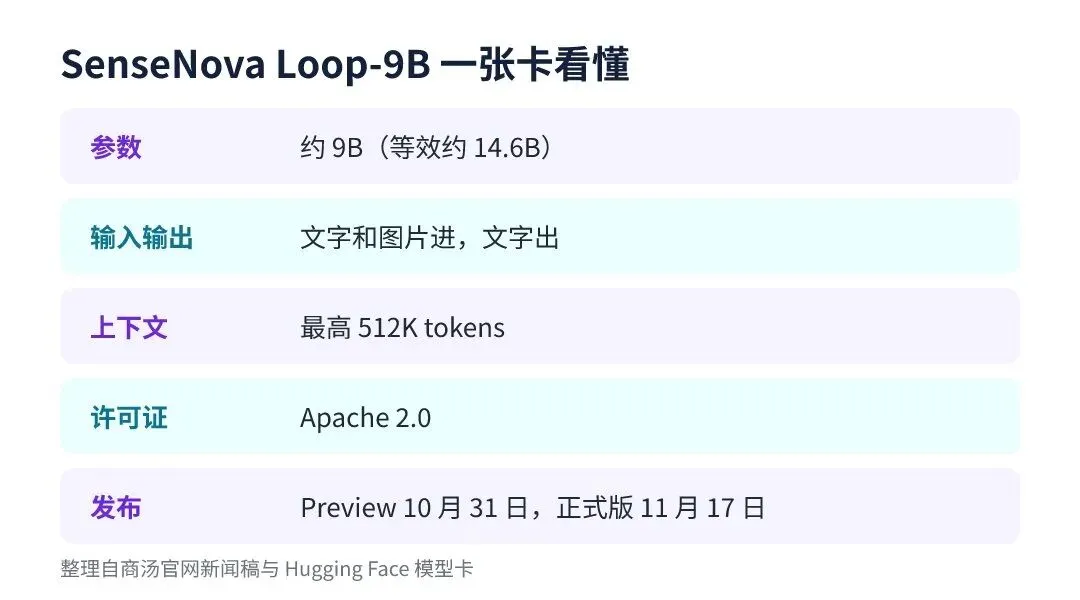
Loop-9B 一张卡看懂(整理自商汤官方新闻稿与 Hugging Face 模型卡,2026 年 11 月 19 日查询)
免费在哪:开源权重,自己下、自己跑
许可证是 Apache 2.0,模型卡写明权重和代码向社区开放。下载、本地部署都不收钱。
要分清一件事:这不是“送你多少 Token”的云端额度。你得有自己的显卡或服务器,电费和机器钱是自己的。想直接在线调用,官方页没提供免费接口,Hugging Face 页面也显示目前没有推理服务商托管它。
下载地址有三个:BF16 完整权重在 Hugging Face 和魔搭(ModelScope)都有;4bit AWQ 版和 GGUF 版(BF16、Q8_0、Q5_K_M、Q4_K_M)目前官方只列了 Hugging Face。
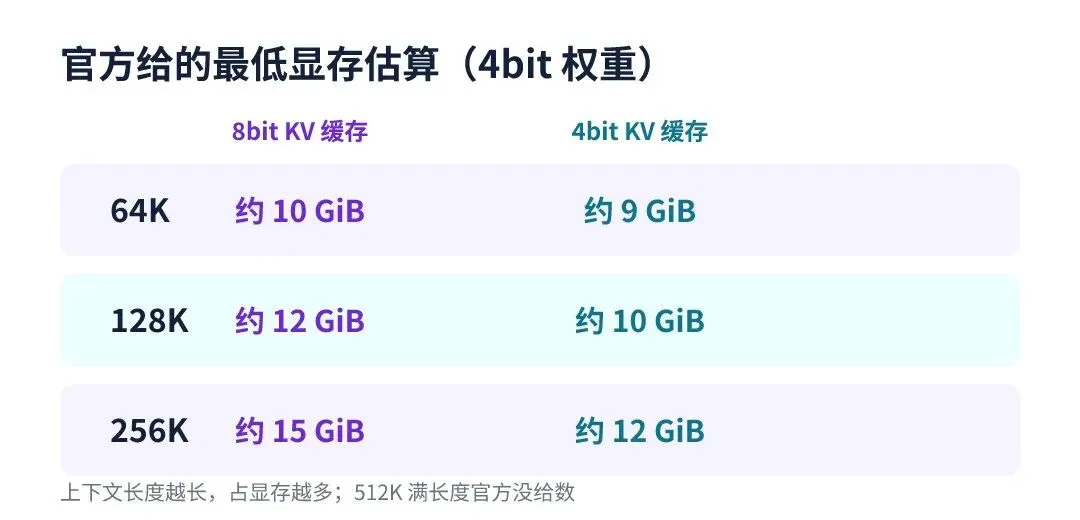
官方给的最低显存估算
显存要多少:10GB 起步,别指望更低
官方数字是:4bit 权重约 4.9GB,加 8bit KV 缓存,64K 上下文约 10GiB,128K 约 12GiB,256K 约 15GiB。用 4bit KV 缓存可以再省 1 到 3GiB。
所以它的定位是“一张 12GB 或 16GB 显卡”,不是手机,也不是纯 CPU 小本。512K 的满长度官方没给显存数。
官方 BF16 完整权重没写体积,要用原版得准备更大的显存,具体以仓库文件大小为准。
官方对性能的说法:在 Agent 与数据分析评测里和 Qwen3.8-27B 相当,AIDABench 65.31 对 65.01,NL2Repo 41.36 对 44.60。这是商汤自己报的成绩,我没有复测。
怎么上手:按官方模型卡整理
我没有亲手部署过,下面是按官方模型卡整理的路径,细节以仓库为准。
1登录 Hugging Face 或魔搭,进 sensenova 组织页,找到 SenseNova-Loop-9B
2图省事先选 AWQ 4bit 版;用 llama.cpp 系工具就看 GGUF 版。官方没写 Ollama 是否已支持这个新结构,先看 GGUF 页的说明
3想用 Transformers 跑:官方示例用 transformers 5.18.0,加载时要开 trust_remote_code
4想起成 OpenAI 兼容服务:vLLM 和 SGLang 目前要用官方指向的 PR 分支,并不是装个新版本就行
5先用短上下文跑通,再慢慢加长,别一上来就开 256K
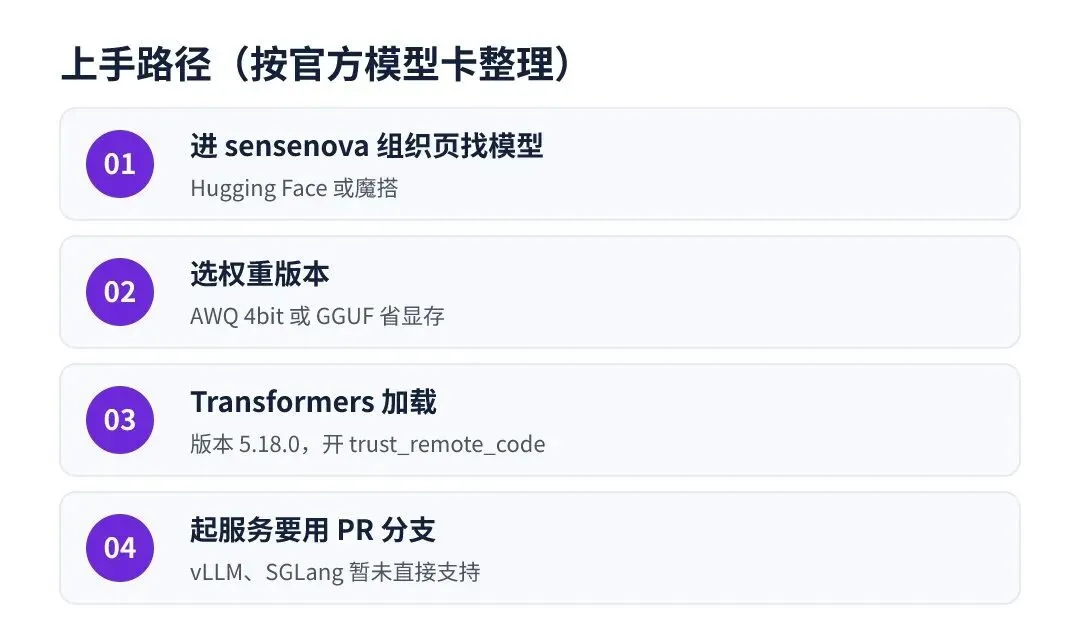
上手路径(按官方模型卡整理)
先看清这 5 个限制
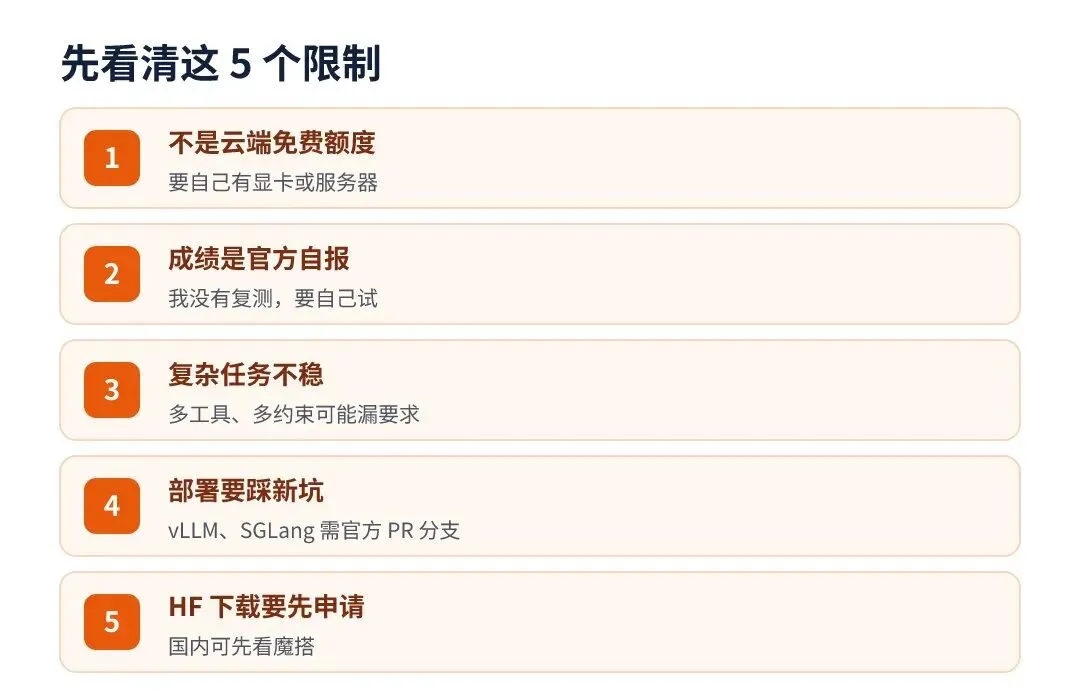
5 个要先看清的限制
官方模型卡自己写了“已知限制”:很多复杂工具定义或多重约束时,可能漏掉要求;编程和通用 Agent 任务表现不稳定;带复杂 3D 和动画的网页,一次生成不一定做完,要来回改两三轮。
另外,Hugging Face 上这个模型需要先同意共享你的账号信息才能看文件;社区报道还指出下载需要申请访问。国内读者可以先看魔搭。
你会先试哪一个:本地跑小模型,还是继续用云端免费额度?评论区说说。
本文信息核对自商汤官网新闻稿(SenseNova Loop-9B 正式版)和 Hugging Face 模型卡 sensenova/SenseNova-Loop-9B(2026 年 11 月 19 日查询),性能数字为官方自报,以官方最新说明为准。