ARTICLE · 1385817
报价单转Excel全是空格,pdfplumber半秒拆干净
口径说明:测试用的报价单为本机生成的真实 PDF(3 页、34 行明细、8 列、含两级表头、类别列纵向合并、跨页续表和千分位金额),提取与转换于 2026-11-19 在本机实测(Windows 11、纯 CPU、pdfplumber 0.11.10、openpyxl 写 Excel)。人工录入口径按「每格 2 秒的键盘速度」估算,不是官方宣传数据。工具 Star 数与版本号截至 2026-11-19 查证。
供应商发来一份 PDF 报价单,你把它拖进某个「PDF 转 Excel」的在线工具,转完发现类别列一片空白,三页表格断成三截,金额加起来是零。
这个循环我见过太多次:复制、粘贴、修格式、核对,一刻钟没了,还得提防哪个数贴错了列。
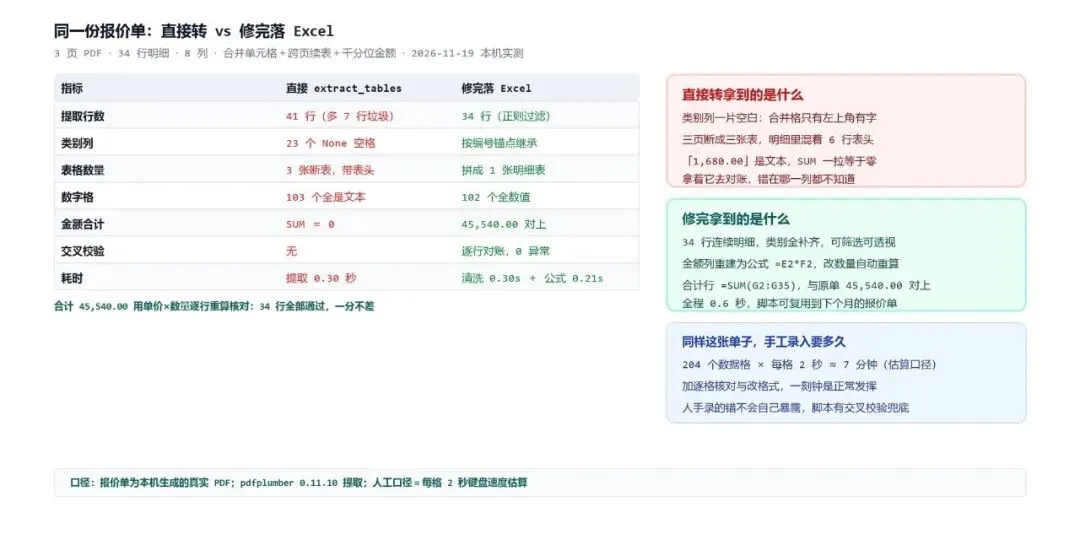
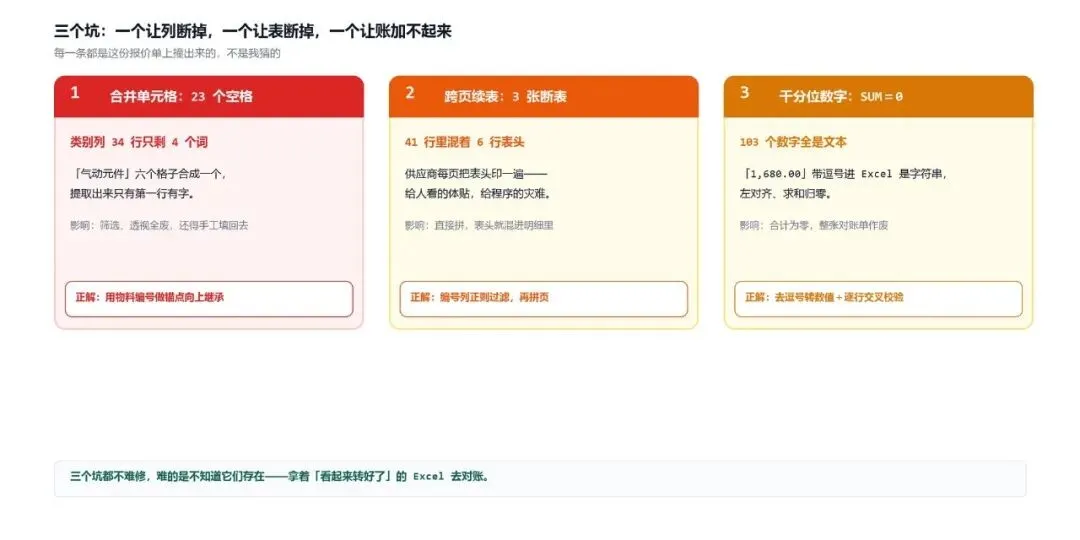
先说结论:PDF 转 Excel 这件事,pdfplumber 能干,但不能「直接干」。它半秒钟把表格结构原样提出来,可合并单元格、跨页、千分位这三个坑,一个都不会自己修。我在本机造了一份 34 行的报价单跑了一遍,直接转出来的版本有 23 个空格、103 个「看起来是数字其实是文本」的单元格;修完之后 34 行一分不差,合计 45,540.00 与原单完全对上,全程 0.6 秒。
直接转出来长什么样:41 行、23 个空格。
装它一行命令:pip install pdfplumber(我走的还是阿里云镜像)。核心调用也是一行:
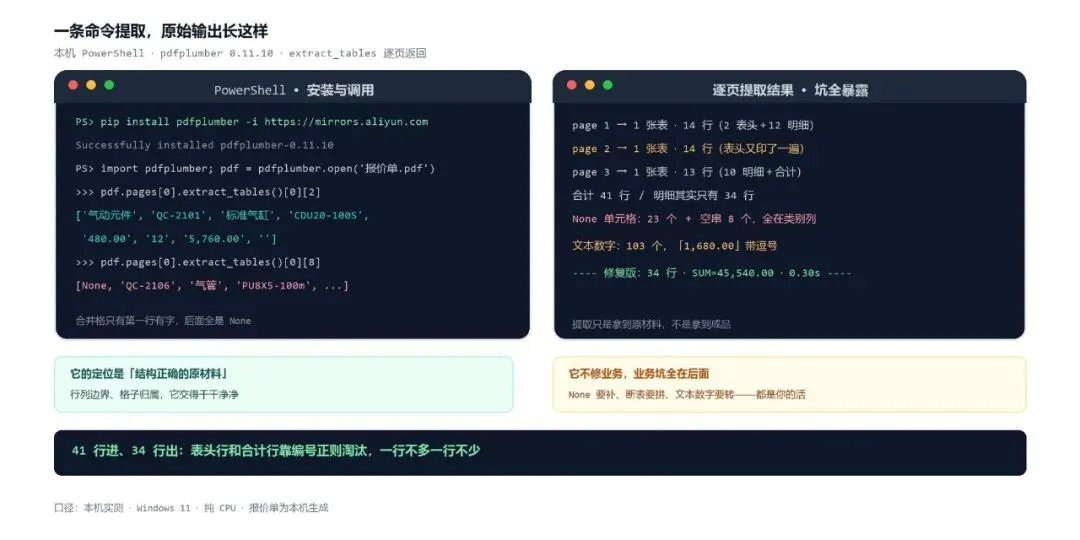
pdfplumber.open("报价单.pdf").pages[0].extract_tables()
它返回的不是表格,是「每页一个列表,列表里每行又是一个列表」。听起来够直接,直接写进 Excel 就完事?我把提取结果原样落盘,得到这么几组数字:
3 页 PDF,拆成 3 张独立的表,41 行——比 34 行明细多出 7 行垃圾:6 行重复表头加 1 行合计。 23 个单元格是 None,另有 8 个是空字符串——同一个「没字」,它给你两种返回值,全在类别列上,备注列一个都没有。 103 个数字格提取出来全是文本。「1,680.00」进去是字符串,Excel 右对齐变左对齐,SUM 一拉,结果为零。
三个问题拆开看,每个都不难;难的是不知道它们存在的人,会拿着一份「看起来转好了」的 Excel 去对账。
顺便说一句为什么我在本机跑、不挂在那些在线转换站上:报价单里有供应商名称、单价、账期,这些是往外发一次就收不回来的东西。财务把单子拖进一个陌生网站换一份 Excel,省下的十分钟,抵不上一次数据外流的解释成本。能用本地脚本的,别过别人的服务器。
坑一:合并单元格,一片空白。
供应商做报价单,为了好看,把「气动元件」六个格子合成一个,字写在中间。PDF 里这叫视觉合并;提出来就是六个格子只有第一个有字,后五个是空的。类别列 34 行只剩 4 个孤零零的词。
这里有个特别容易漏的细节:同样是「没字」,它给你两种返回值。我这 34 行里,23 个提成 None,8 个提成空字符串。如果你的判空只写了 if cell is None,那 8 个空串会被当成有值,继承逻辑在那几行悄悄失效——不报错,只是类别列多出几个空格,你翻到第三页才发现。
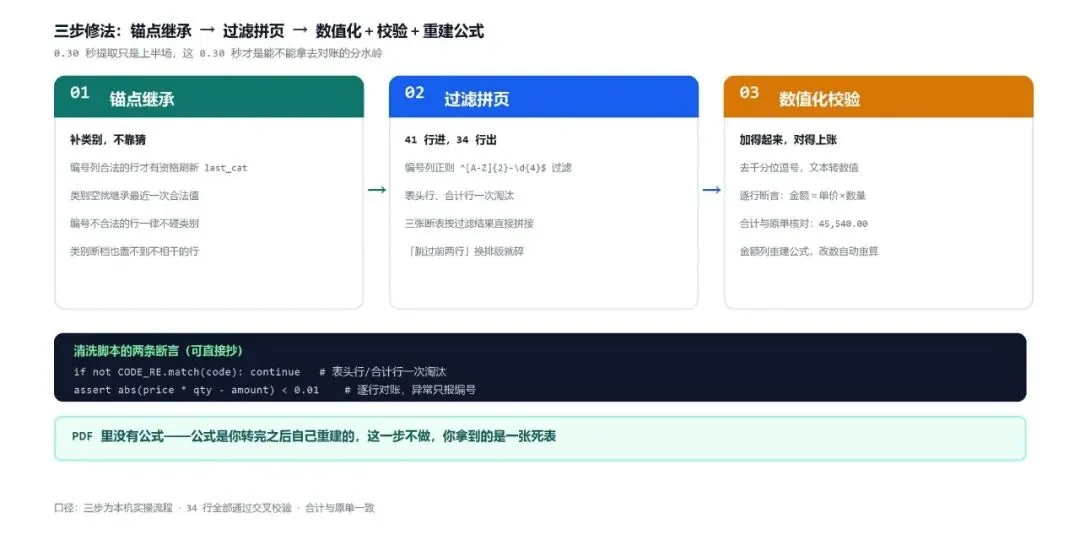
修法想清楚一件事就行:别去猜哪个空格属于哪个类别,用唯一编号做锚点。每行物料都有自己的编号(我这份是 QC-2101 这种样式),第一列空白就向上继承最近的类别——但继承的触发条件不是「上一列有字」,而是「这行的编号合法」。两行代码:
if code looks valid and cat is not empty: last_cat = catcat_out = last_cat if cat is empty else cat
这样哪怕某行类别真的丢了,也不会把上一个类别错误地盖到不相干的行上。
坑二:跨页续表,三张断表。
第 2 页、第 3 页开头,供应商把表头又印了一遍——这是给人看的体贴,给程序看的灾难:三张表,每张都带表头,直接拼接,明细里混着 6 行「物料编号 | 物料名称 | 规格型号……」。
我的过滤条件就一条:编号列必须长得像编号。正则一放:^[A-Z]{2}-\d{4}$,表头行、合计行(编号列是空的)全部淘汰,41 行进来、34 行出去,一行不多一行不少。这比「跳过前两行」可靠得多——因为「前两行」这个假设,换个供应商的排版就碎了。
还有一种更隐蔽的情况:一页里不止一张表。报价单页脚常有「付款条款」「签章栏」也用框线排成小表,extract_tables() 会一股脑全返回。我的取法是按行数挑——只保留行数最多的那张当明细,其余需要时单独取。别用索引 [0]、[1] 去拿:供应商多加一个签章框,索引就整体错位,而这种错位不会报错,只会让你少抄几行。
坑三:数字全是文本,SUM 归零。
「1,680.00」去掉逗号转成数值,只是及格线。我在这一步多做了一道交叉校验:每行金额必须等于单价乘数量。34 行里只要有一行对不上,立刻把编号报出来,人工只查那一行。这份测试单 34 行全部通过,合计 45,540.00 与原单分毫不差。
顺手补了一层:金额列不写死数值,写成公式 =E2*F2,合计行写 =SUM(G2:G35)。以后供应商改了数量,Excel 自己重算,你不用再跑一遍脚本。上次 markitdown 那篇结尾说的「公式怎么处理」,答案就在这:PDF 里没有公式,公式是你转完之后自己重建的——这一步不做,你拿到的是一张死表。
换个供应商,脚本会不会废。
会废一半。我这套流程里,跟具体单据绑死的只有三样东西:编号长什么样、列的顺序、表头叫什么。前两样我用正则和「按内容识别」处理了;第三样建议你单独维护一张列名映射表,别把中文列名写进代码逻辑里。
理由很直接:同一家公司,半年后的报价单就可能把「含税单价」改成「单价(含税)」,把「规格型号」改成「型号规格」。代码里写着 if col == "含税单价",它改一个字你就跑不通,而报错信息往往只是「取不到值」。把映射表放在脚本外面的一个 json 里,采购改版了,改 json 不改代码——能交给同事维护的东西,别让它长在你脑子里。
半秒钟花在哪。
整个过程三个阶段分开计时:直接提取 0.30 秒,清洗修坑 0.30 秒,写公式版 Excel 0.21 秒,合计 0.6 秒出头。同样这张单子,让实习生键盘录入:204 个数据格,按每格 2 秒算,7 分钟;加上逐格核对和改格式,一刻钟是正常发挥。而且人手录入的错不会自己暴露,脚本那份有交叉校验兜底。
我的判据:三种单子别指望它。
没有框线的表格:pdfplumber 默认靠线条识别表格,遇到纯空格排版的单子要改用 text 策略,准确率明显下降,得逐页人工核。 扫描件、拍照件:它读的是文字层,图里的字看不见。先走 OCR(上上篇写的 rapidocr 就干这个),再进来。 盖了章压住表格线的:章的线条会被误认成表格线,单元格边界乱掉。遇到盖章页,先看提取结果的行数对不对,不对就绕开那一页。 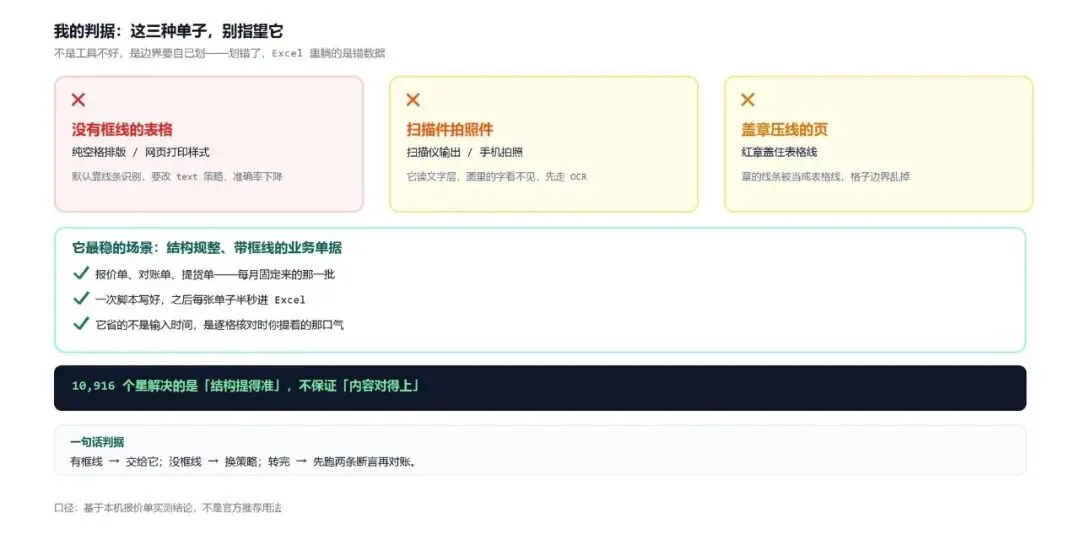
反过来,它最稳的场景就是这类结构规整、带框线的业务单据:报价单、对账单、提货单。一次脚本写好,之后每张单子半秒进 Excel。
最后说点实在的。
pdfplumber 在 GitHub 上有 10,916 个星(截至 2026-11-19),不算最出圈的明星项目,但它解决的问题极其高频:财务、采购、运营,谁每个月没收几份 PDF 报表。它给的只是「结构正确的原始数据」,从原始数据到能对账的 Excel,中间这三道坑,得你自己修——或者把你修的脚本留下来,给团队复用。
我的落法就是三样东西放共享盘:一个脚本、一份列名映射的 json、一页说明写着「收到单子跑哪条命令、跑完文件存哪」。做一次,之后每个月省下来的时间是同事的,不是我的——这才叫把工具用进流程里。
如果你团队也有每月固定的 PDF 单子要转 Excel,点个赞;转给那个每个月都在拿鼠标拉选区的财务同事——关注一下,这类一份一份跑出来的实测,我每周都交一份。你上一次手工转 PDF 表格,花了多久?评论区说一声,超过十分钟的话,这篇的脚本值得你抄走。
管得住团队管不住自己,所以我做了个打卡小程序逼自己——目前我自己天天打卡。