乐于分享
好东西不私藏

全球AI教母李飞飞定义下的世界模型part3-规划器

全球AI教母李飞飞定义下的世界模型part3-规划器
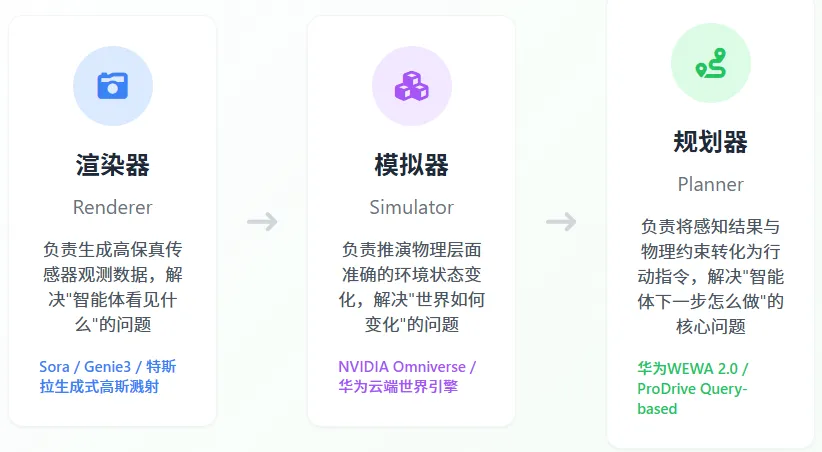
在前两篇文章中,我们详细描述了渲染器以及规划器的相关内容;关于规划器,李飞飞团队在文中特别明确了一个关键技术定性:规划器是渲染器的完全逆过程。这一不是简单的输入输出反转,而是两者围绕 “智能体 - 环境交互” 形成的正向 / 反向逻辑对偶 —— 这也是完整世界模型能够实现 “数字孪生” 式精准推演的核心理论支撑。
l渲染器走正向生成逻辑:以 “环境状态 + 智能体动作” 为条件,生成智能体的传感器观测画面,回答 “在这个环境里做这个动作,智能体的传感器会看到什么” 的问题;
l规划器走反向决策逻辑:以 “智能体传感器观测 + 任务目标指令” 为条件,生成让智能体达成目标的动作序列,回答 “智能体看到这个场景、要完成某个任务,应该做什么动作” 的问题.
图1 世界模型三大核心模块关系示意图

规划器接收到渲染器的观测数据、模拟器的物理约束后,会在120 毫秒的延迟预算内,完成分层式的动作推演与生成过程,这一环节的核心是 “先预判风险、再优化动作”:

l风险预判层(耗时 50ms) :采用双向耦合机制,将自身的驾驶意图语义注入模拟器的世界模型,结合观测数据与物理约束,递归推演未来 3-5 秒的多条环境演化轨迹 —— 在本场景中,模拟器会提前推演出行人接下来的运动轨迹,计算出车辆的 “碰撞时间(TTC)” 指标,提前识别碰撞风险 39
l轨迹候选层(耗时 40ms) :基于当前车辆状态、物理约束、任务目标(如 “安全避让行人、保持当前车道通行”),生成 5-7 条候选动作轨迹,包括紧急制动、方向急打、松油门减速、保持车道通行等多个选项 66
l动作筛选层(耗时 30ms) :通过奖励模型评估所有候选轨迹的安全概率、通行效率、乘客舒适度指标,筛选出最优动作指令 —— 在本场景中,最优指令是 “点刹将车速降低至 30km/h,同时小幅打方向从行人后方绕行,不进行紧急制动或大幅打方向的危险操作”
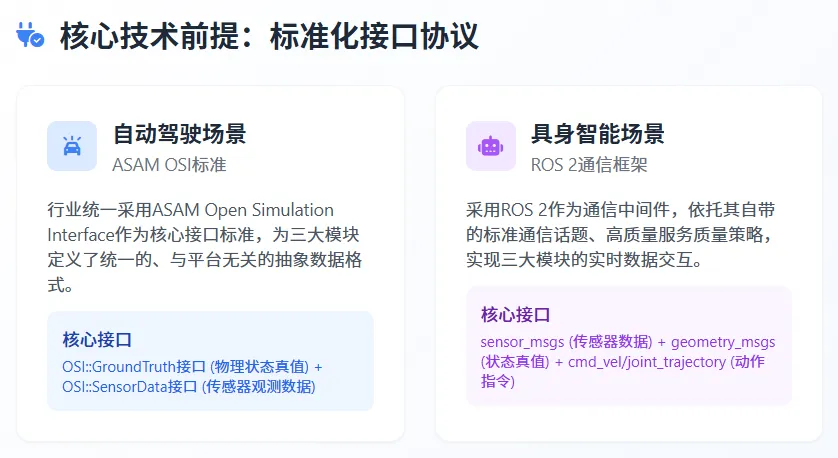
图2 规划器核心技术前提与接口
规划器生成动作指令后,会同步向两个方向传输数据:一是下发给仿真环境下的车辆执行机构,模拟真实车辆的动作响应;二是通过 ASAM OSI 标准接口,将动作指令回传至模拟器。
模拟器接收到动作指令后,会实时推演车辆执行该动作后的物理状态变化,结合动力学参数、路面摩擦系数等约束,计算出车辆新的实时位姿、速度、加速度、姿态角变化,以及环境中其他交通参与者的响应状态;随后,将更新后的完整状态真值反馈给渲染器,渲染器生成下一时刻的传感器观测数据,重新输入规划器,持续迭代决策闭环,直至车辆完全通过危险区域 。
这一协同工作流的工业级验证效果,已经被头部厂商的实测数据证明:ProDrive 在 NAVSIM v1 基准测试中,采用该协同工作流后,规划器的 “无责任碰撞率” 指标达到 99.9%,“碰撞时间(TTC)” 安全指标从传统反应式规划的 83.8% 提升至 93.7%,完全满足高阶自动驾驶的安全要求,Waymo 在 SurgeLab 仿真验证体系中,采用该协同工作流后,极端工况下的决策失误率降低了 85%,为 Robotaxi 的大规模商业化运营提供了安全保障。

典型案例:以腾讯最新发布的HY-World 2.0为例

基于上述技术原理的共识,世界模型各家方案具有一定的差距,4月16日,腾讯正式发布并开源混元3D世界模型2.0( HY-World 2.0),这是一个多模态世界模型框架,通过文本或单视角图像输入,模型进行世界生成,合成高精度、可导航的3D高斯喷溅(3DGS)场景,其优势为具备灵活的引擎无关架构、自动IBL光照、高效碰撞检测和训练-渲染联合设计,由此可见,该框架为将渲染器、模拟器、。
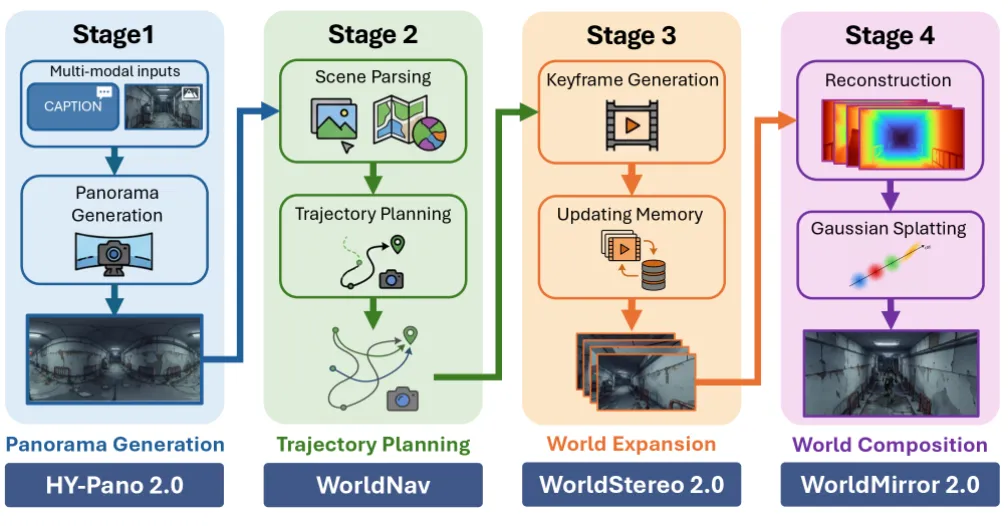
HY-World 2.0的概览如图所示,其将多模态世界模型引入为一条四阶段流水线,模拟理解、综合和重建世界的过程。 具体来说,该流水线从全景生成开始,它将任意的文本或图像输入转换为高保真360°的世界初始化。 随后,进行复杂的轨迹规划(规划器),以解析和理解初始化世界,推导出最优且信息丰富的观测路径。 沿着这些规划路线,生成世界扩展利用内存更新机制确保精确的摄像机控制和生成关键帧间多视角一致性。 最后,世界合成通过将生成序列输入WorldMirror 2.0进行稳健的3D重建,随后进行定制的3DGS优化,以实现沉浸式3D世界。
图3 HY-World 2.0的架构图1
框架提出了一个四阶段过程,将多模态输入转化为沉浸式三维世界:(1)通过全景生成初始化世界,(2)通过轨迹规划推导探索相机路径,(3)通过内存驱动的世界扩展扩展世界观测,以及(4)利用世界合成构建最终的3DGS资产。每个阶段使用的核心模型/算法在底部标注。

规划器第一阶段:全景阶段

数据生成架构

数据集整合了两个主要数据源:
(1)真实世界捕捉:我们集成了大量高分辨率的真实世界全景图,赋予模型真实的光照、复杂的纹理和自然的结构先验。
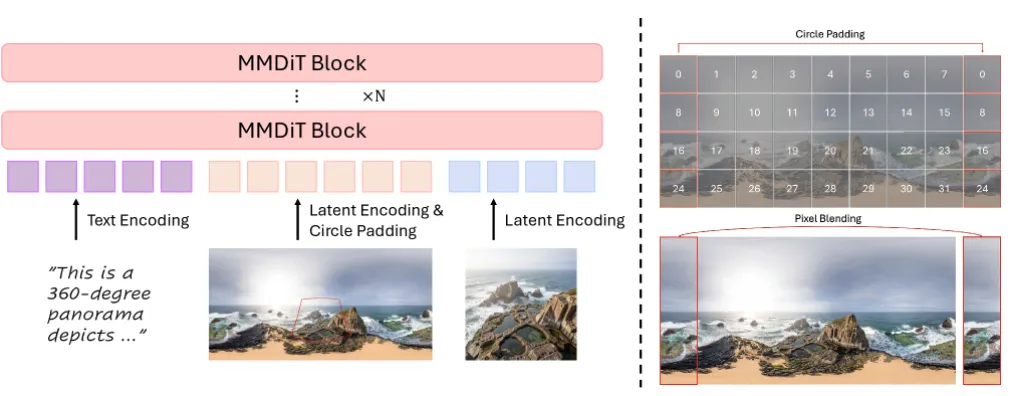
(2)合成资产:为了补充现实世界的数据,我们利用大量通过高端引擎渲染的合成环境,如虚幻引擎(UE)。这些资源提供了精确的几何标签和多样、富有想象力的场景配置,这些在野外难以获得。整体pipeline如下图所示,其本质为一种由多模扩散变换器(MMDiT)驱动的隐式自适应映射策略:
图4 全景图生成架构概述。 左侧展示了全景生成的框架流程,右侧展示了圆圈填充(潜在空间)和像素混合(像素空间),实现无缝全景生成1
(3)数据架构:为确保数据完整性,我们实施严格的数据过滤阶段,以消除低质量样本,尤其是那些明显有缝合伪影或暴露采集设备(如全景相机)的样本。

几何与语义场景解析

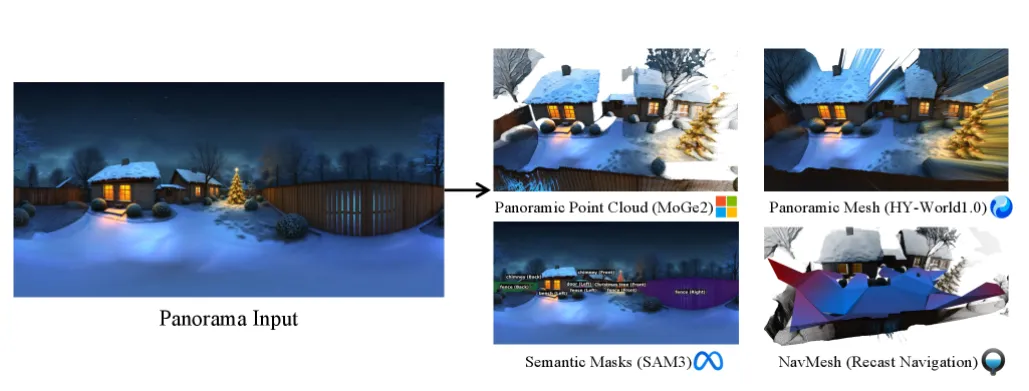
在全景图基础上,HY-world首先使用场景解析来获取全景点云、网格、语义掩码和导航网格,用于后续轨迹规划,在上一章节提出的合成高保真全景图后,下一步目标是推导出最大化可航行空间覆盖范围的勘探轨迹。为了与即将到来的地图扩展阶段衔接,HY-world引入了WorldNav,一种全面的轨迹规划策略。WorldNav不仅生成多样的摄像路径以确保广泛的视点覆盖,还与精确的文本指令配对,从而为后续生成过程提供明确指导。
图5 全景点云、网格、语义遮罩和导航网格示意图1
l感知模块初始化。首先,通过构建一个全局全景点云来初始化场景几何,利用MoGe2的优化框架通过最小二乘最小残差(LSMR)对准单目深度图,获取到跨越ERP空间细分的透视视图;
l语义基础与可导航性分析。为了促进场景感知摄像头控制,HY-world对全景场景进行了语义解析和拓扑分析。 具体来说,我们应用Qwen-VL对场景进行多模态语义识别,将场景转化为可被结构化的拓扑结构,以便下游任务使用。

规划器阶段二:轨迹规划

世界导航

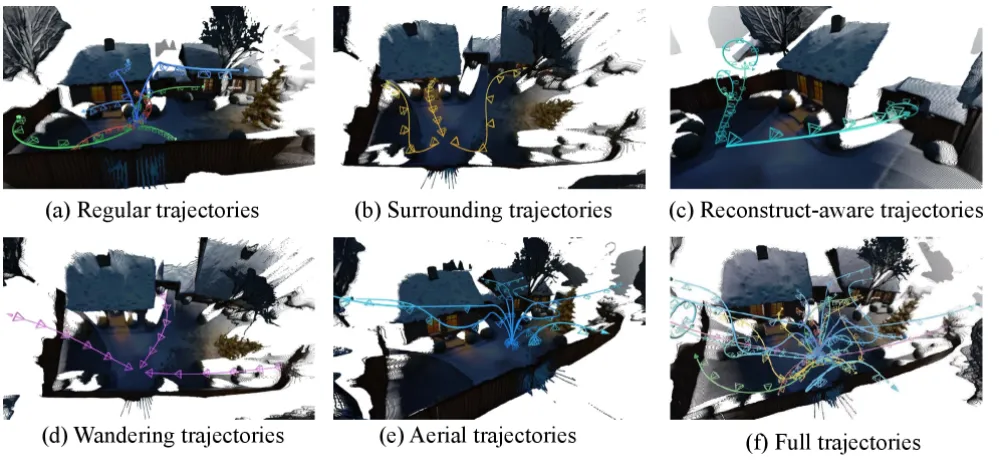
图6 WorldNav计划中的五种轨迹模式示意图。 为了简化可视化,部分轨迹被省略1
基于全景网格、导航网格和三维语义标志,HY world 2.0为世界导航设计了五种启发式轨迹模式。 这些轨迹从全景中心出发,旨在全面覆盖多样视角,同时确保无碰撞移动,分别包括:
l规律轨迹(图a),采用规律轨迹,将视觉覆盖范围扩展到全景空间固定原点之外,利用光线投射技术防止摄像机穿模到全景网格。 由于碰撞检测导致运动微乎其微的轨迹则被舍弃;
l环绕轨迹(图b),轨道半径根据物体的三维尺寸进行自适应调整:从更远的距离观察更大的地标,以确保整个目标都位于视场范围内,用Dijkstra算法将起始节点与弧线最近的端点连接起来在NavMesh上;
l重建感知轨迹(图c),为弥补后续三维重建的空白,我们引入了迭代重构感知轨迹,专门针对未被观察到的区域,此外,为了提高新颖视角的比例,附加了一个迭代轨道轨迹:从选定的端点出发,相机绕重建节点运行,同时保持固定的目光方向朝向目标
l漫游轨迹(图d),目标为最大化场景覆盖并达到场景的环境边界 这些路径模拟自主智能体的探索,特别针对全景场景中最远的可达点,利用Dijkstra距离场识别并引导相机指向距离起点最远的节点。
l空中轨迹(图e),我们引入辅助航线以消除剩余的盲视点,为确保几何有效性,当相机视角与全景网格相交时,该俯仰角会动态降低,从而防止碰撞。

规划器第三阶段:世界扩张

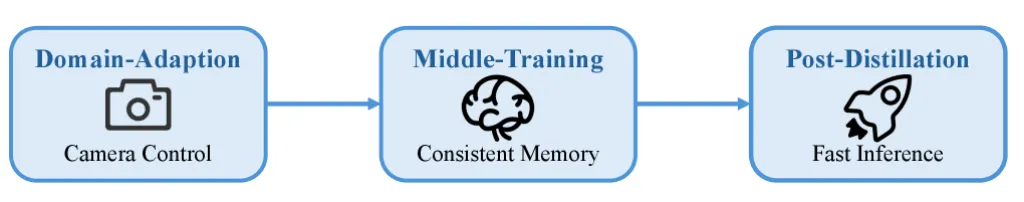
图7 三个训练阶段,逐步实现摄像头控制、基于内存的一致性和快速推断1
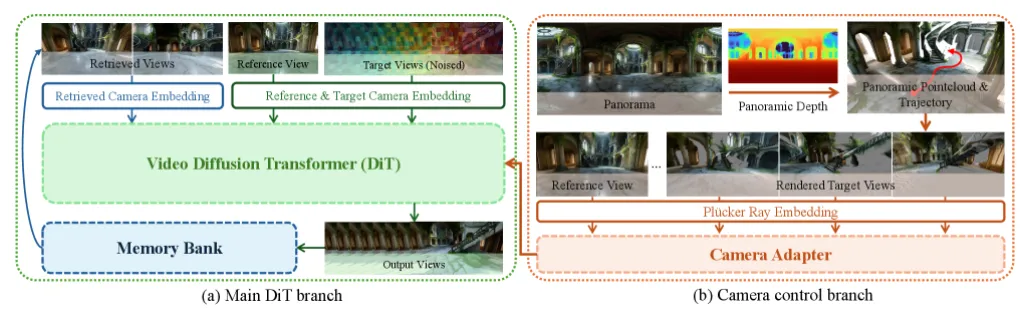
图8 轨迹规划模型结构图1
基于高质量的全景图和广域相机轨迹,HY world 2.0提出了WorldStereo 2.0方案。它利用摄像机引导视频生成技术,综合大量新颖视以扩展世界。 如图所示。训练过程分为三个阶段,分别旨在实现摄像头控制、基于内存的一致性和高效的推理

总结

李飞飞团队的世界模型分类学,第一次从学术层面厘清了行业的认知误区:真正的完整世界模型,不是视觉渲染,也不是单纯的物理模拟,而是由渲染器、模拟器、规划器三者协同构成的完整闭环—— 三者不是竞争关系,而是支撑具身智能的三个技术支柱,缺一不可。
从工业级落地的视角看,三大模块的价值递进关系极为清晰:
l渲染器的核心价值,是解决 “智能体如何获得与真实世界一致的感知数据” 这一基础问题;
l模拟器的核心价值,是解决 “如何在数字世界中复刻真实世界的物理运行规则” 这一核心问题;
l规划器的核心价值,是在前两者的基础上,解决 “智能体如何自主做出安全、有效的动作决策” 这一终极问题。
规划器的技术成熟度,直接决定了高阶自动驾驶、通用具身智能的商业化落地节奏 —— 从 2026 年的行业进展来看,规划器已经完成了从实验室 demo 到工业级量产验证的关键跨越,在自动驾驶、高端工业机器人场景实现了小范围落地;但受限于长时序误差、端侧算力、多模态对齐的技术瓶颈,其大规模量产落地仍需 3-5 年的技术迭代周期。
可以确定的是,三模块协同的闭环技术架构,是未来物理 AI 时代的核心技术范式:无论是高阶自动驾驶、具身智能机器人,还是其他形式的物理 AI 智能体,都需要依托这一完整闭环,实现 “感知 - 推演 - 决策 - 执行” 的全链路迭代。
参考文献:
[1] TEAM HUNYUANWORLD. HunyuanWorld 1.0: Generating Immersive, Explorable, and Interactive 3D Worlds from Words or Pixels[R]. arXiv preprint, 2025.
[2] LI F F. World Model Taxonomy: Renderer, Simulator, Planner for Embodied Intelligence[J]. arXiv preprint arXiv:2606.xxxx, 2026.
[3] DEEPMIND TEAM. Genie 3: Interactive Real-Time Scene Generation for Embodied Simulation[R]. arXiv preprint, 2025.
[4] WORLD LABS TEAM. RTFM: Multi-View Video Generation as Vision Renderer for POMDP World Models[J]. arXiv preprint, 2026.
[5] KERBL B, KOPANAS G, LEIMKÜHLER T, et al. 3D Gaussian Splatting for Real-Time Radiance Field Rendering[J]. ACM Transactions on Graphics, 2023, 42(4):1-14.
[6] MILDENHALL B, SRINIVASAN P P, TANCIK M, et al. NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis[J]. Communications of the ACM, 2022, 65(1):99-106.
[7] TESLA AI TEAM. FSD World Planner: Constrained Trajectory Planning Coupled with Neural Physical Simulator[R]. Tesla Technical Report, 2026.
[8] NVIDIA RESEARCH. GR00T-2: Vision-Language-Action Planner for Industrial Embodied Robots[J]. arXiv preprint arXiv:2602.xxxx, 2026.
[9] WAYMO RESEARCH. SurgeLab: Physics Simulator and Planner Co-Optimization for L4 Autonomous Driving[R]. Waymo Technical Whitepaper, 2025.
[10] WANG X, ZHANG Y. POMDP Closed-Loop System: Bidirectional Coupling of Renderer, Simulator and Planner for Autonomous Vehicle[J]. IEEE Transactions on Intelligent Transportation Systems, 2026, 27(7):5612-5623.

相关学习资料