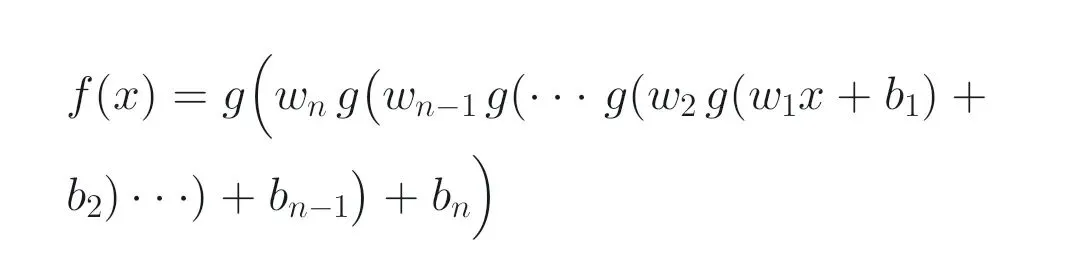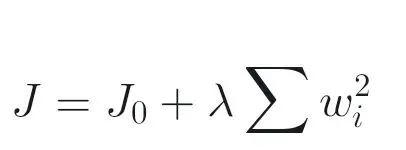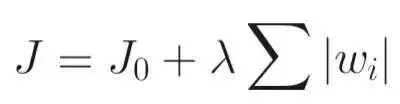当前时间: 2026-08-16 06:52:52
分类:办公文件
评论(0)
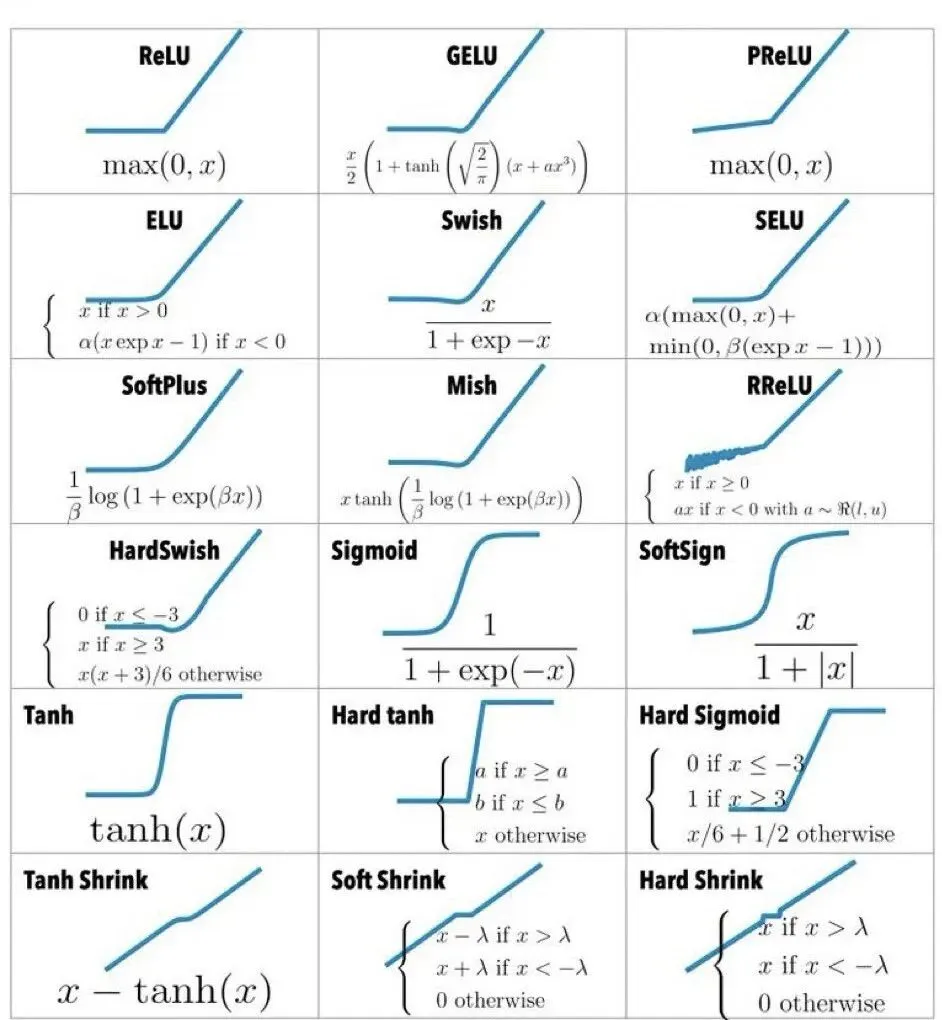
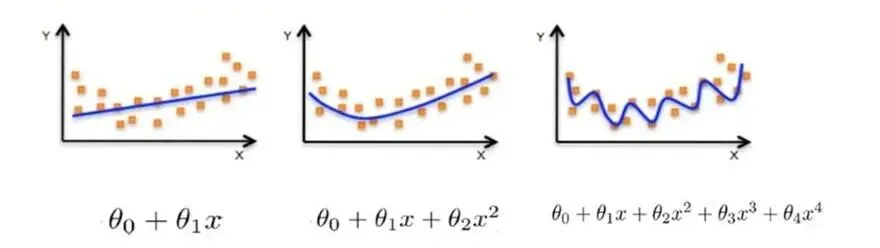
详解AI:真是越来越狗了……还是老话:本篇劝退率可能偏高,但我希望各位既然已经进来了,还是翻到底吧,有什么不感兴趣的地方,无聊的公式就不用看了,往下滑就是了。上一期我们详细讲了函数与AI的关联,以及如何判断并找到最佳拟合直线。我们的研究人员们得出最佳拟合直线还是不满足,为什么呢?有时候平面上点的分散情况,单单一条直线已经没有能力能够很好地拟合了,永远有距离过远的点不能很好地被预测到。这个时候又开始发挥数学的魔力了。怎么让一条直线变弯一点呢?什么叫激活函数呢?就是在原有的,简单的线性函数,也可以理解成一次函数,的基础上,把得到的结果再用一个函数图像本身比较扭的函数运算一遍,这样就使得这条直线弯起来了。比如这个函数:y=wx+b,只要再套一个激活函数g,它就舞动起来了——当然。这个函数可能还是不够复杂,那就把这个结果再作为输入x放到另一个一次函数中,再套一层激活函数,就像这样:但是,熟读200年狗血小说的你立马敏感地意识到,作者绝对不会允许情节发展得如此顺利,于是又狗了一把——按照常理,第三段线拟合得确实好,基本上每个点都离得挺近,但是,你看起来总感觉弯弯绕绕有点剑。那么请你自行发挥想象延伸一下,哪一段函数能更好地预测出下一组数据呢?你可以设想出来,第二段看起来明显合理一些,虽然肯定有误差,但大体上走势是对的。那么第三段呢?看起来真是对极了,差几个就全拟合上了,可是你看到这么一个歪歪扭扭弯弯绕绕的函数,总感觉哪里不对劲——不对,之前的数据确实是这么绕,这么扭的,但是以后的数据呢?难道还和以前一样这么排列吗?直觉告诉我我们这是不可能的。这就意味着随着后期的发展,我们的第三个函数的预测会越来越倾向于离谱。像这种对于已经训练过的数据表现得极其优异,但是对于未接触过的数据却不能很好地进行预测的现象,叫做——我特意把字放大一些,这是个非常重要的概念。过拟合会导致模型反而在实际项目上跑不了一点。有一个很好解决的方法。我先举个例子,假设有许多橘子,你只有10元,拿一个橘子需要1角,最好肯定是多拿几个,但是你拿了101个的时候,发现自己付不起钱,就赶紧放回去1个。学习的时候就是在反复调整w和b。而正则化,就是在调整w的时候下手的。至于为什么不调整b,后面会讲。一开始的损失假设是J0(有一个下标),那么模型只管J0越小越好,这样就会过拟合,结果就是把w调的很大来拟合数据。那为什么w越大越复杂呢?我们知道,w也表示斜率,其实就是一条线有多陡,也就是变化程度有多剧烈。w越大越陡,越小越平缓。所以想要让函数图像复杂,必然导致变化剧烈,所以必须把w调大一些。损失可以看做给AI的惩罚,惩罚越小越好。聪明的研究人员把所有的权重w(参见之前给我的那个超长函数)分别平方,再加起来,添加到损失里面,这样,当AI把J0变小,代价是把权重提高,反而导致了新的惩罚出现。注意求和符号∑之前的那个“入”是一个人为定义的可调整的系数,越大正则化惩罚越严格,越小越宽松。这个纯凭人力撞大运慢慢调。当然,还有一种宽松一点的,没有取权重的平方,而是绝对值——平方的惩罚方式叫做“L2正则化”,绝对值的叫做“L1正则化”,都很莫名其妙。祖传瞪眼法告诉我们,带平方的遇到绝对值大于1的数,乘出来会变大大大大大所以L2正则化的目的很明显,不是惩罚那种小不愣登的权重,而是惩罚那些很大的胖子——而L1就很明显了,一视同仁,谁都来那么一点,都给我罚。所以L2露头就秒,L1五大三粗。(人机输出ing…)一个细致一些,一个潇洒(mangzhuang)一些。可是深度学习中常用的是L2正则化,为什么呢?从上面你也能看出来,L2明显比L1平稳,而且,一个事实是L2算的不如L1多。具体就不解释了。我猛地想起来还有一个问题没有解答,为什么不惩罚偏置b呢?因为b只决定了位置,而不是函数图像的形状,不会导致过拟合,所以完全不用管。好了我说累了,也不给预告了。上一期预告错了,有点尴尬。
 夜雨聆风