ARTICLE · 1036222
未来三年 AI 怎么看:模型、数据、Agent 与下一轮范式
过去几年看 AI,很多人的习惯是盯排行榜。谁的模型分数高了,谁的发布会更炸,谁就像暂时赢下了比赛。可当最前面的几家都已经进入同一个水平区间之后,问题开始变了。以后判断 AI,不能只问“谁最强”,更要问“它在哪个任务上更强”“这项能力能不能变成产品”“用户愿不愿意长期使用和付费”。
把整份材料压缩下来,最值得留下的并不是某个短期排名,而是四条主线:基础模型从一家领先走向交替领先,产品竞争从大而全走向局部突破,数据和工作流变成越来越重要的护城河,同时下一轮技术范式开始把注意力从“训练得更大”推向“能不能在使用中继续学习”。
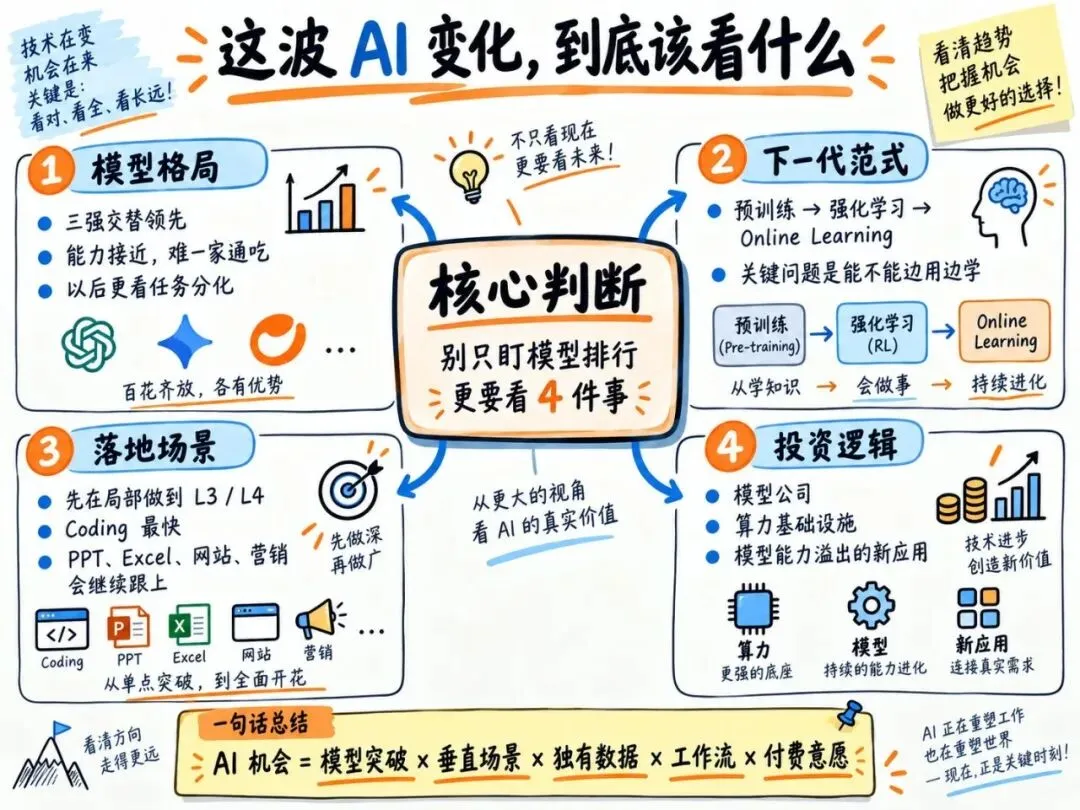
一张图先看懂:这波 AI 变化应该盯住什么
模型榜单还重要,但已经没有过去那么重要
现在最前面的几家模型公司,通用能力越来越接近。一次更新可能让 A 暂时超过 B,下一轮又可能反过来。人才在流动,研究方法在互相借鉴,算力和数据也都在快速堆上去。于是,长期维持断层式领先会越来越难。
这并不意味着差距消失了。恰恰相反,差距开始从“总分”转移到具体任务。有人把多模态做得更深,有人把编程和企业知识工作做得更扎实,也有人把个人助理和消费者入口做得更强。用户最后感受到的,不是模型在测试集上多了几分,而是“这件事到底谁做得最好”。
以后看模型,更像看一组“分科成绩”,而不是只看一张总分榜。
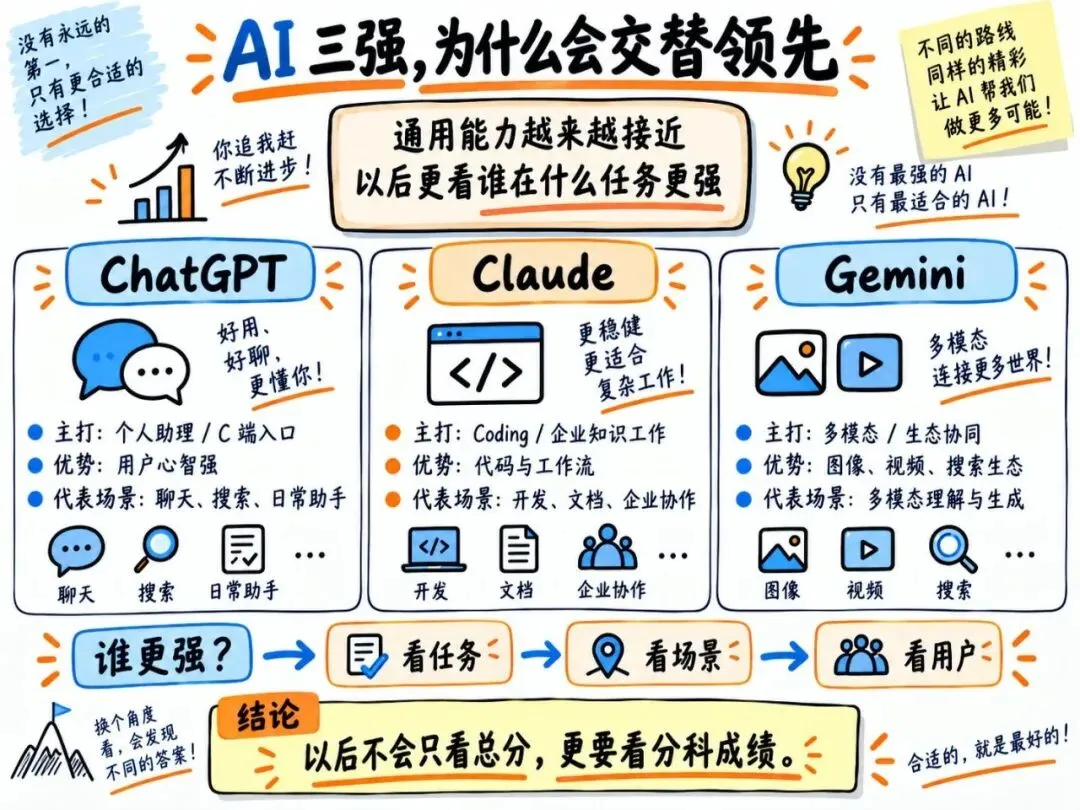
模型竞争正在从“总分”转向“分科成绩”
这对企业和创业者的启发很直接。没有必要一开始就追求一个什么都能做的 AI。更有效的路径,是先找到一个足够尖锐、足够高频、用户足够愿意付费的任务,把这一件事做深。
编程就是最典型的例子。它没有先解决所有白领工作,而是先把代码生成、修改、调试、理解这些高频环节做得越来越顺。用户第一次感受到明显的效率差,就会出现所谓的 Magic Moment。之后再从单点向更多任务扩展,成本和阻力都会小很多。
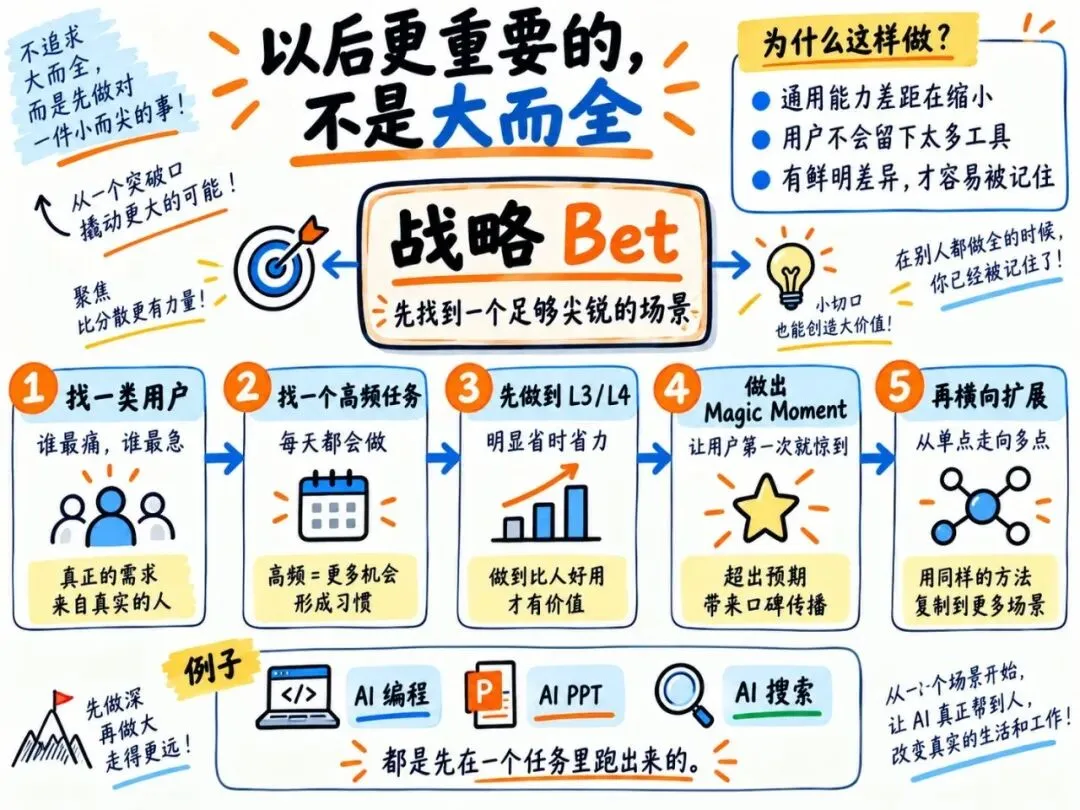
先做深一个场景,再考虑横向扩展
越往下做,越会发现模型只是其中一层
很多人做 AI 产品时,第一反应是换一个更强的模型。模型升级当然有用,但如果场景没选好、数据很乱、工具没接通、工作流没有重新设计,最后的体验往往只会小幅变好。
真正拉开产品差距的,经常是数据。模型可以看成一个巨大的压缩器,它见过什么、怎么见过、这些数据有没有被筛选和标注,都会影响输出。通用模型可以提供一个很高的起点,但企业自己的业务细节、客户习惯、流程记录、专业判断,如果没有被整理成可用的数据,模型很难凭空学会。
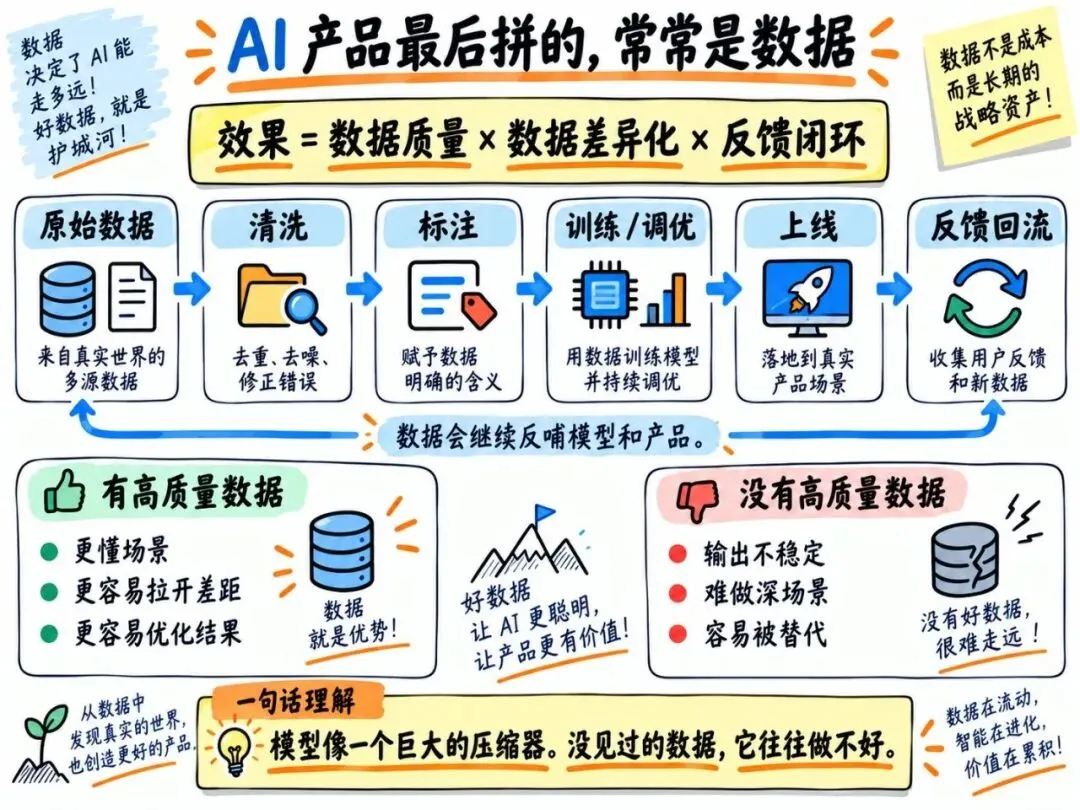
很多 AI 产品最后拉开差距的,是数据
所以,企业里的 AI 数据建设不能只理解成“建一个知识库”。更重要的是形成闭环:真实业务产生数据,数据经过清洗、标注和结构化,再进入模型或工作流;系统上线后,用户的修改、反馈和结果又重新回到数据里。这个闭环转起来之后,产品才会一点点拥有别人不容易复制的东西。
同样的逻辑也适用于端到端优化。一个 AI 编程产品,不只是模型会不会写代码,还包括需求怎么理解、代码怎么落到项目里、怎么调用工具、怎么调试、怎么验收。一个 AI PPT 产品,也不只是生成几页文字,而是素材、结构、视觉、图表、修改、导出整条链路都要顺。
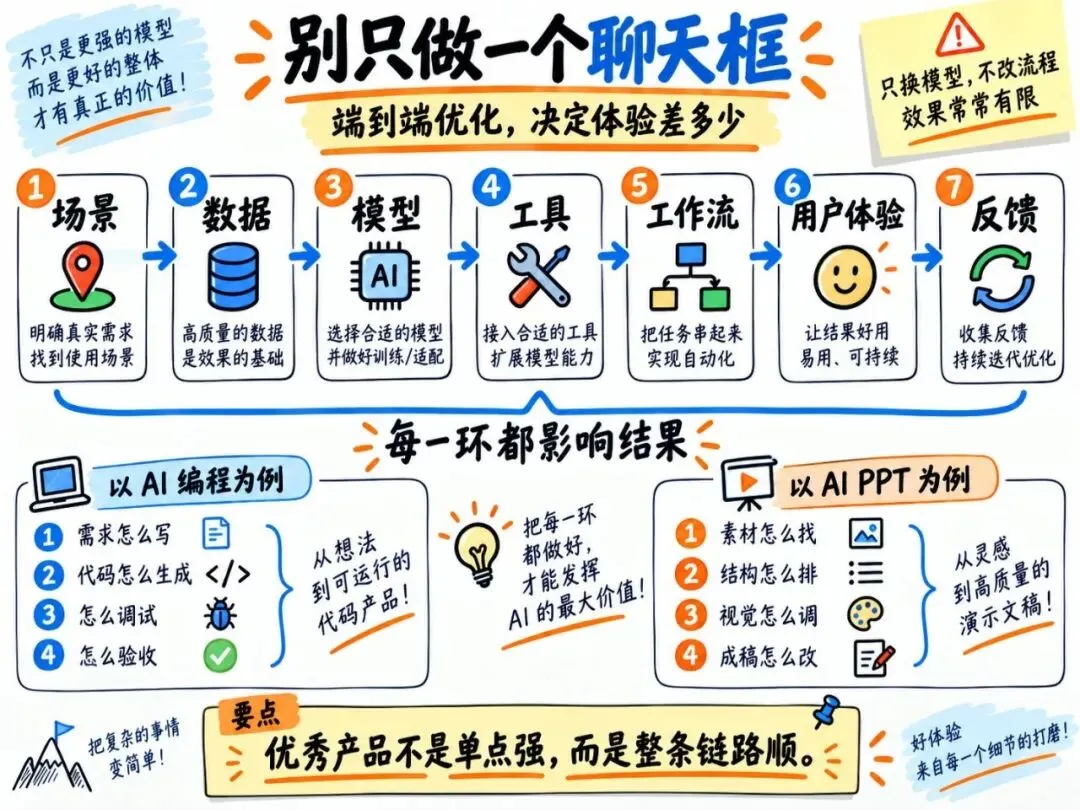
AI 产品不是一个聊天框,而是一整条工作链
底层也在形成两种不同的生态路线
从更底层看,AI 正在形成两种很不一样的路线。一种更强调垂直整合,从芯片、模型一直做到产品和分发;另一种更像开放平台,由通用算力服务多家模型公司,再让不同应用继续向外扩散。
前一种路径的优势是协同,很多环节可以一起设计,成本、体验和分发都能联动。后一种路径的优势是开放,一套基础设施可以承接大量不同模型和应用,创新速度更容易被整个生态放大。未来很可能不是哪一边彻底吃掉另一边,而是两边持续加码、互相逼着对方进步。
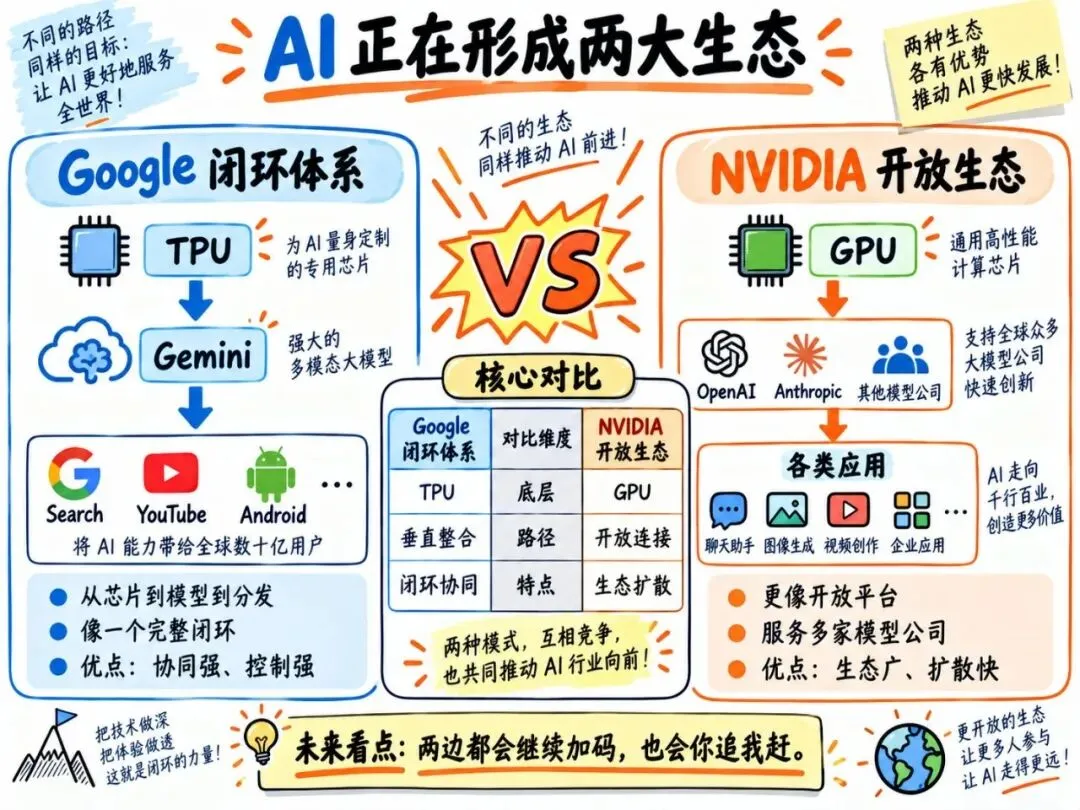
底层生态也在分成两种不同路径
下一轮更值得盯住的,不只是更大模型,而是 Online Learning
今天的大模型有一个容易被忽略的限制:训练完成以后,它基本是“冻结”的。你和它交互很多次,这些交互并不会自动变成模型新的能力。它可以通过记忆功能保存一些信息,也可以在很长的上下文里临时利用历史,但这和持续学习还不是一回事。
这也是为什么 Online Learning 或 Continual Learning 会被反复提到。它指向的是另一种 AI:不只是上线前训练一次,而是在真实使用中继续积累经验,学会哪些做法有效,哪些做法会失败,然后把这些经验带进下一次任务。
如果这条路线出现明显突破,Agent 的角色会从“等你提问的工具”向“能长期积累经验的工作伙伴”移动。
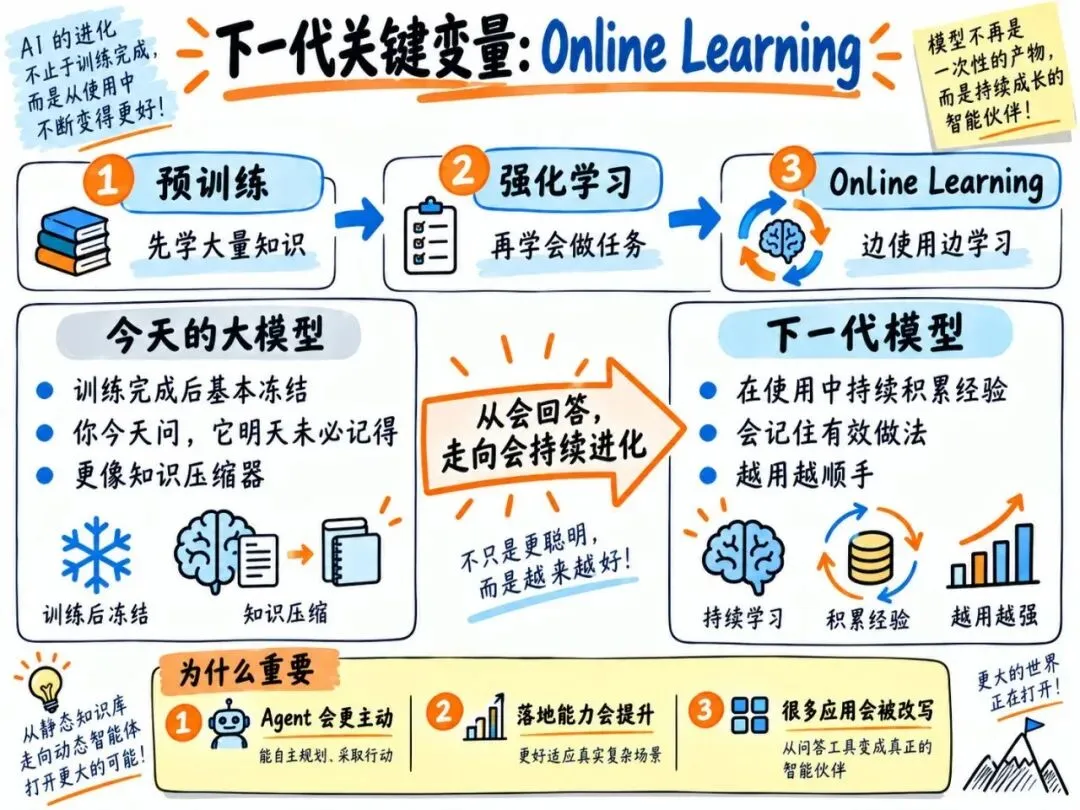
下一代重要变量之一:Online Learning
可要做到边用边学,记忆系统就绕不过去。人的大脑并不会因为每天学到新东西就彻底重构,但记忆会不断积累。AI 也需要类似的机制:更长的 Context 帮它装下更多历史,Memory 保存用户偏好和任务习惯,In-context Learning 把过往经验直接带进当前任务,多模型并行采样可以让系统尝试不同路径,再选择更好的结果。
这些东西如果最后能和推理、训练、更新连在一起,才可能出现更接近“训推一体”的系统。那时,模型的价值不只来自上线那一天有多聪明,也来自用了半年之后,它有没有更懂业务、更懂用户、更懂怎么完成任务。
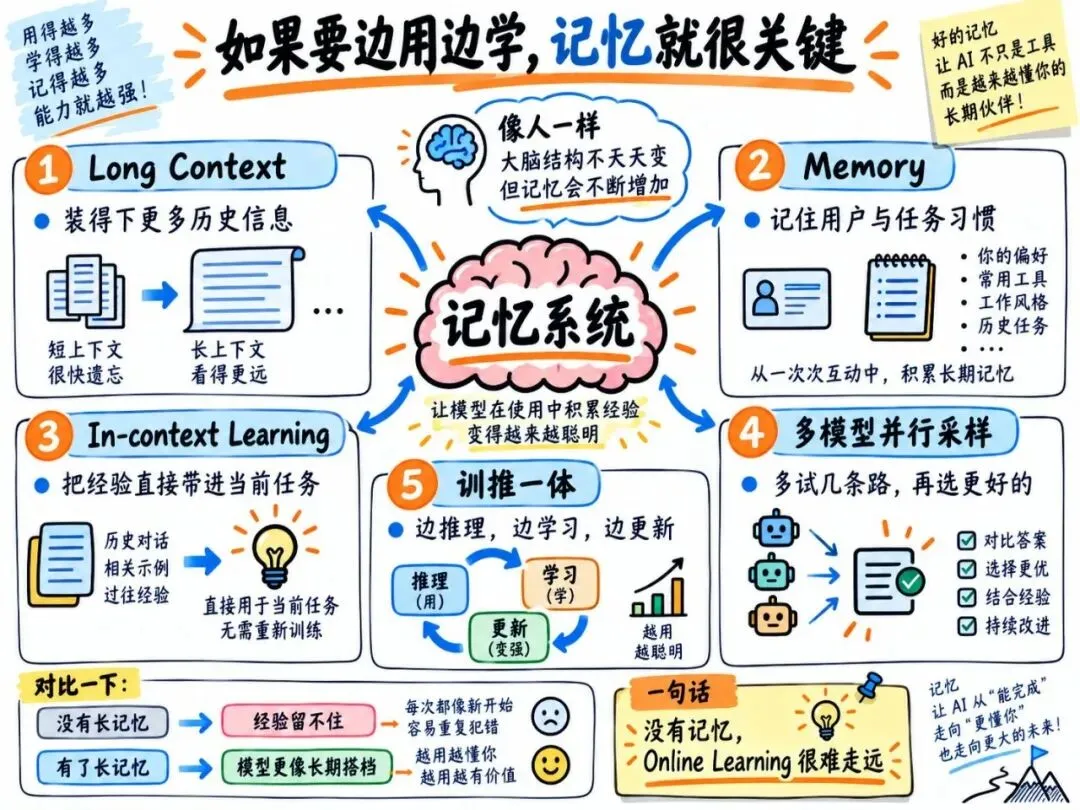
如果 AI 要边用边学,记忆系统就绕不过去
AI 离 AGI 的距离,可能更多卡在“工作现场”
今天的 AI 在知识问答、写代码、做 PPT、分析表格和文案生成上,已经能覆盖大量日常任务。可一旦把问题推进到完整工作,就会遇到另一层复杂度。
一个医生会看资料,并不等于会完整处理一次诊疗。一个销售知道销售方法,也不等于能熟练操作 CRM、判断客户状态、跟同事协作、处理异常情况。现实工作里充满跨系统、跨步骤、长尾例外、模糊信息和责任边界。模型掌握了大量“知识”,但它见过的人类工作现场仍然不够多。
这意味着,AI 渗透不会像按下一个开关那样,一夜之间把所有岗位重做一遍。更可能的情况是一个任务一个任务突破,一个流程一个流程重构。Coding 会跑得快一些,PPT、Excel、网站、营销、研究分析也会逐渐跟上,但不同领域的速度不会一样。
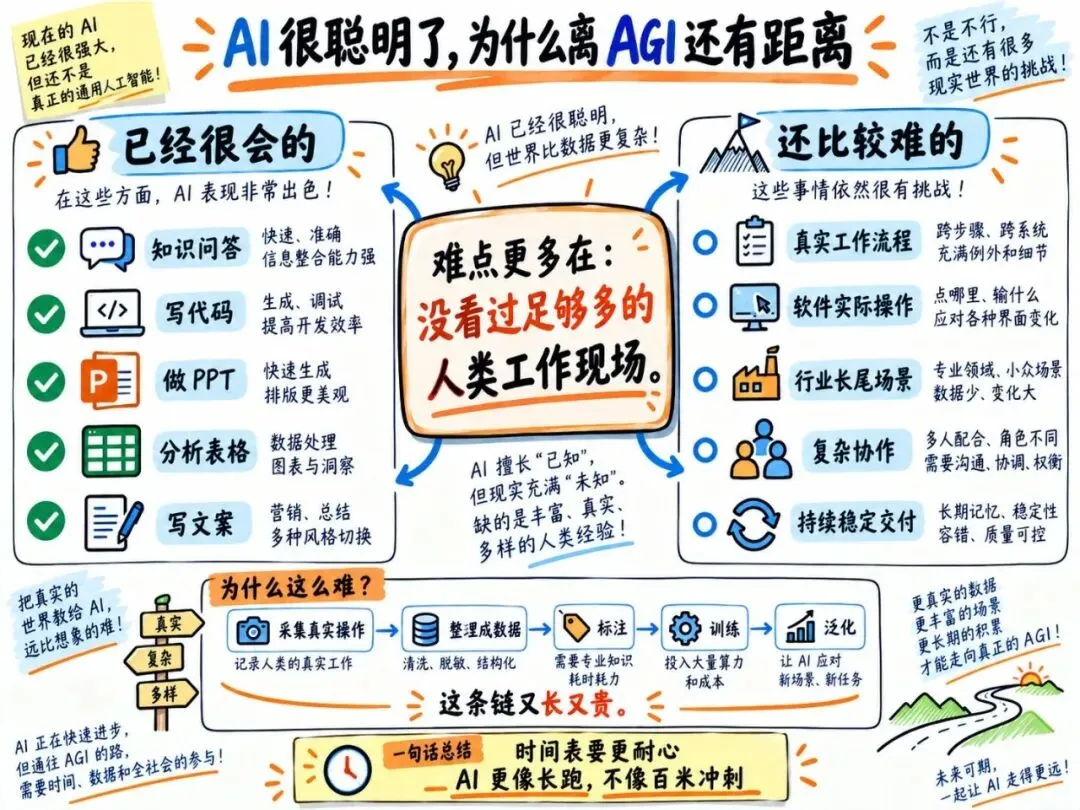
AI 已经很强,但真实工作世界比知识问答复杂得多
所以接下来找机会,要看“最陡峭的地方”
不管是做产品还是看投资,最值得盯的都不是所有带 AI 标签的东西,而是模型能力刚刚越过某个门槛、用户需求又恰好足够强的交叉点。过去编程已经展示了这种路径:能力一旦达到可用水平,需求会迅速从尝鲜变成高频使用。
往后看,知识工作者仍然是非常重要的落地人群。Coding 之后,PPT、Excel、网站生成、营销内容、研究分析和更主动的 Agent 都值得继续观察。判断一个场景有没有机会,可以问三个问题:模型能力是不是刚刚突破,任务是不是高频且有明确成本,用户是不是已经愿意为结果付费。
从投资框架看,也可以简单拆成三个圈:第一圈是最领先的模型公司,第二圈是支撑它们持续进化的算力和基础设施,第三圈是模型能力外溢后新长出来的应用。真正高弹性的机会,往往出现在第三圈刚刚形成、但用户需求已经开始爆发的时候。
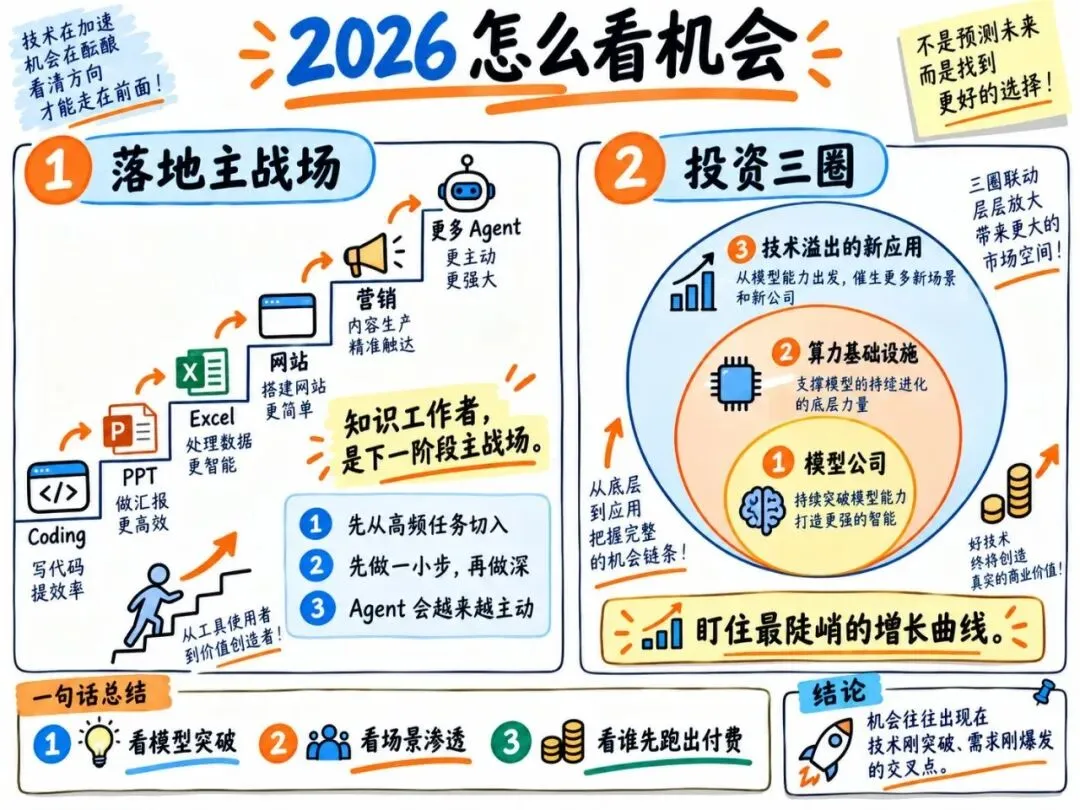
从落地和投资两个方向看接下来的机会
最后,把这波变化记成一句话就够了
未来几年,AI 的主线不会只是“模型变得更聪明”。更大的变化会发生在模型能力开始进入真实工作之后:谁能把一个具体任务做深,谁能沉淀高质量数据,谁能把模型、工具和工作流串成闭环,谁又能让系统在长期使用中积累经验,谁就更容易把技术红利变成可持续的产品价值。
AI 机会 = 模型能力突破 × 垂直场景 × 独有数据 × 端到端工作流 × 用户付费意愿。
因此,与其每天追着排行榜跑,不如把注意力放到那些已经开始改变工作方式的具体场景里。技术的变化很快,但商业价值最后仍然要落到同一件事上:有没有把一件原本麻烦、昂贵、耗时的工作,变得明显更好。