ARTICLE · 1043295
把复杂文档变成模型真正能用的结构化数据其实不难
很多 AI 应用卡在第一步:资料明明就在 PDF、Word、PPT 和扫描件里,模型拿到的却是一团失去版面关系的文本。标题、表格、代码、公式和阅读顺序一旦被拆散,后面的检索、问答和智能体调用都会跟着失真。
Docling 解决的不是“把文件打开”这么简单,而是把复杂文档解析成可继续处理的结构化内容。项目由 IBM Research Zurich 的 AI for knowledge 团队发起,目前托管在 LF AI & Data Foundation,代码库采用 MIT 许可证。
它真正关心的,是文档里的关系
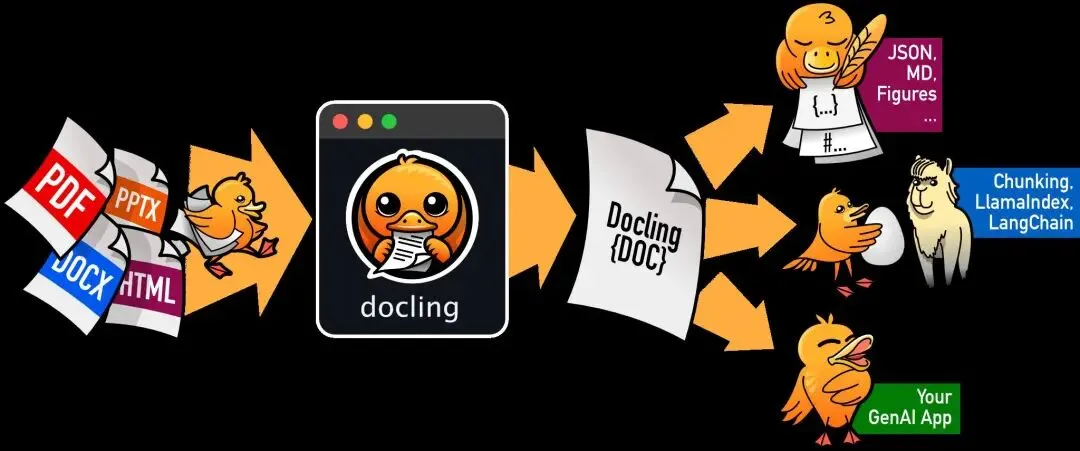
Docling 支持 PDF、DOCX、PPTX、XLSX、HTML、EPUB、Apple Pages、图片、LaTeX、纯文本、邮件和音频等多类输入;README 还列出了视频、ODF、XBRL 等近期解析能力。输出可以是 Markdown、HTML、WebVTT、DocLang、DocTags 和无损 JSON,也可以统一落到表达力更强的 DoclingDocument 表示中。
对 PDF 来说,项目强调的不只是 OCR。它还处理页面布局、阅读顺序、表格结构、代码、公式和图像分类。这样做的价值在于,后续系统拿到的不是“看起来像文字”的结果,而是带有文档结构的中间表示。对于 RAG、知识库和 Agent 工作流,这种结构往往比单纯增加向量数量更重要。
项目还提供扫描 PDF 与图片的 OCR 支持,并支持 GraniteDocling 等视觉语言模型。敏感数据场景可以选择本地执行或隔离环境;同时,Docling 提供 LangChain、LlamaIndex、Crew AI、Haystack 集成,以及 MCP server 和 docling-serve API server,方便接入现有 AI 应用。
上手并不复杂
官方 README 给出的安装命令是:
pip install doclingDocling 2.70.0 起不再支持 Python 3.9,建议使用 Python 3.10 或更高版本。项目说明支持 macOS、Linux 和 Windows,并覆盖 x86_64 与 arm64 架构。
命令行可以直接转换在线 PDF:
docling https://arxiv.org/pdf/2206.01062执行后会在当前目录生成包含结构化内容的 Markdown 文件。如果要使用 GraniteDocling,可以指定 VLM pipeline:
docling --pipeline vlm --vlm-model granite_docling https://arxiv.org/pdf/2206.01062Python 调用则从 DocumentConverter 开始:
from docling.document_converter import DocumentConvertersource = "https://arxiv.org/pdf/2408.09869"converter = DocumentConverter()result = converter.convert(source)print(result.document.export_to_markdown())这几行代码背后的设计很克制:输入可以是本地路径,也可以是 URL;转换结果先进入统一文档对象,再按需要导出。应用层不必为每种文件格式各写一套解析和清洗逻辑。
Docling 的边界也很清楚
它不是一个自动替你完成知识库建设的黑盒。解析质量仍会受到原始文件、扫描清晰度、模型选择和具体版式影响;视觉语言模型与其他模型的使用,还要遵守原始模型包各自的许可证。仓库本身是 MIT,并不意味着所有模型和外部资料都共享同一授权。
更值得关注的是,Docling 把“文档进入 AI 系统前的整理”做成了独立基础设施。它既能服务于简单的 Markdown 转换,也能成为 OCR、表格理解、结构化抽取、RAG 和 Agent 工具链之间的连接层。对于希望在本地处理敏感文档、又不想被格式差异拖慢开发的团队,这种统一入口有现实吸引力。
文档解析的竞争,最后比的不是能识别多少字符,而是能不能保住内容之间的结构。Docling 的路线很明确:先把文档还原成可理解、可检查、可复用的对象,再把它交给搜索、模型和智能体。这个顺序,决定了后面的 AI 是在理解资料,还是只是在猜测资料。
https://github.com/docling-project/docling