ARTICLE · 1043314
AI 读网页好助手:crawl4ai vs NewsCrawler
想让AI 能阅读或下载网页吗,可以试试crawl4ai 和 NewsCrawler。这俩不是同一重量级的对手,也基本不是二选一的关系。crawl4ai 是覆盖任意网站的通用爬取框架,83.8K Star,要走浏览器渲染;NewsCrawler 是 12 个新闻平台的定向提取器,608 Star,不启动浏览器。
如果你的 Agent 主要读新闻和公众号文章,NewsCrawler 的 Skill 用起来更轻、输出更干净;如果输入什么网站都可能,只能选 crawl4ai。
最关键的决策在获取层:一个靠 Chromium 渲染再启发式清洗,一个靠平台专项代码直接输出结构化 JSON。
一句话定位
crawl4ai 的目标是把网页变成干净的、LLM 可用的 Markdown,服务 RAG、Agent 和数据流水线。它解决的是任意网站的通用提取问题,附带 CLI、Docker 服务、深度爬取和 LLM 结构化抽取,一个完整的框架。
NewsCrawler 的目标是给 Agent 一条 URL,直接拿到正文、图片和元数据,不启动浏览器,不把整页 DOM 塞进上下文。它现在的主推形态不是 pip 包,是一个叫 news-extractor 的 Agent Skill,装进 Claude Code 或 Codex 就能用,覆盖微信公众号、今日头条、网易、搜狐、腾讯新闻、BBC、CNN、Twitter/X 等 12 个平台。
所以这是一场通用框架对垂直工具的对比。Star 差了 138 倍,但那是曝光度差,不是能力差,后文会讲清楚差在哪、什么时候这点差不重要。
先说关系
crawl4ai 首提交 2024 年 5 月,作者 unclecode,目前 93 位贡献者,背后有赞助商体系,正在内测 Cloud API,商业化走得很明显。NewsCrawler 首提交 2024 年 11 月,晚了半年,贡献者 2 人,基本是个人项目。两边没有互相提及,也没有 fork 关系。
但有个背景值得知道:NewsCrawler 的作者 NanmiCoder 是 MediaCrawler 的作者,那个小红书、抖音、快手、B 站、微博爬虫有 65.2K Star,是国内社交平台爬虫这个细分里最有名的项目之一。他名下还有一堆 Agent 工具项目。也就是说写 NewsCrawler 的人不是新手练手,是把 MediaCrawler 积累的平台对抗经验搬到了新闻场景,并且明确押注 Agent Skill 这个新分发形态。
对比一下吧
这张表里真正重要的差异只有四处:获取方式、依赖、覆盖范围、协议。
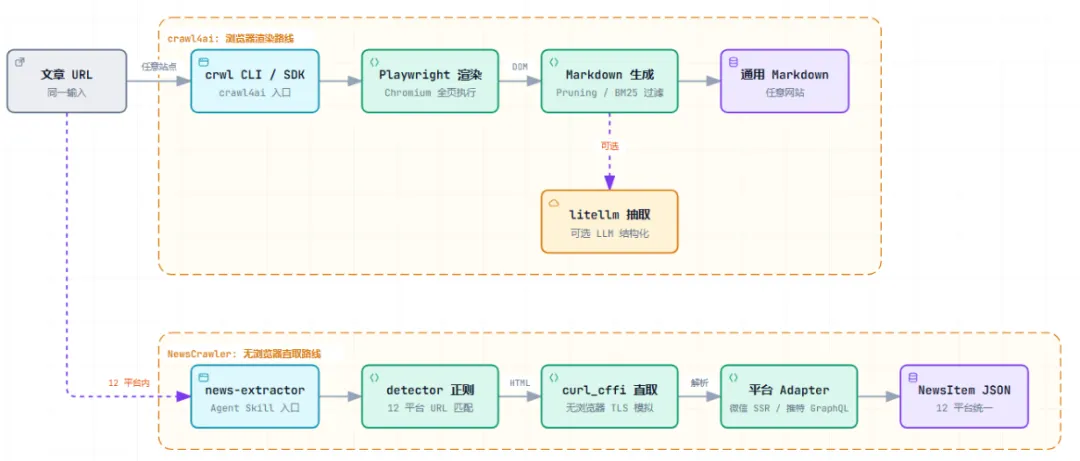
① 获取层:浏览器渲染 vs 协议直取
这是全部差异的源头。我打开 crawl4ai 的 async_crawler_strategy.py 看了下,2860 行,里面有三条策略类:AsyncPlaywrightCrawlerStrategy 走 Playwright 起 Chromium,AsyncHTTPCrawlerStrategy 走纯 HTTP,文件里还有 3 处 undetected 模式的分支用来对付反爬。它的哲学是:我不知道你的目标网站长什么样,所以我起一个真浏览器,把页面完整跑一遍,拿到 DOM 之后再做清洗。代价是每个页面都要付出浏览器启动、渲染、执行 JS 的时间和内存,一份依赖清单里 playwright 和 patchright 两个浏览器内核都得装。
NewsCrawler 的 wechat.py 是另一条路,474 行。它用 curl_cffi 模拟 Chrome 的 TLS 指纹直接发 HTTP 请求,拿到 HTML 后用正则和 parsel 解析,全程不碰浏览器。更有意思的是它处理微信页面细节的深度:微信文章页把数据埋在 window.cgiDataNew 这个 JS 对象里,里面有 JsDecode() 编码的字符串、有字符串乘以 1 的数字转换写法,它写了专门的 _strip_multiply_by_one 函数来还原,注释里还解释了为什么只匹配数字会让星号残留导致整个解析失败。这种代码只有真踩过坑的人才写得出来,通用框架不可能为某一个平台做到这个深度。
这个差异在什么场景重要:输入来源固定是新闻平台的场景里,直取路线快得多也稳得多;输入来源不可控的场景里,渲染路线是唯一解,因为直取路线遇到没适配的网站直接报无法识别该平台。
② 依赖重量:34 个 vs 6 个
两份 pyproject.toml 放在一起看最直观。crawl4ai 的运行时依赖 34 项,包括 playwright 和 patchright 双浏览器内核、numpy、litellm(换成了 fork 版 unclecode-litellm,因为 0.8.6 版本时上游 litellm 出过供应链投毒事件)、nltk、lark、alphashape、shapely。装完加上 Chromium 内核,占的空间按 GB 算。
NewsCrawler Skill 的 pyproject.toml 只有 6 项:pydantic、requests、curl_cffi、tenacity、parsel、demjson3。没有浏览器内核,没有 numpy,装完几十 MB。而且 Skill 目录自包含,SKILL.md 加 scripts 加依赖清单全在一个文件夹里,第一次运行时 uv sync 一把装完,跟仓库其他部分解耦。这个设计就是照着 Agent Skills 规范做的,可以单独迁移、单独升级。
什么时候这个差异重要:在 Agent 环境里很重要。Skill 是装进 Agent 的工作目录的,依赖越重污染越大;一次对话里 Agent 临时决定装个工具,6 个依赖几十秒搞定,34 个依赖加浏览器内核就是几分钟起步。如果你是独立服务器跑爬虫服务,这点差别可以忽略。
③ token 效率:NewsCrawler 唯一敢拿数字说话的地方
NewsCrawler 的 README 专门做了一组对照实验:拿一篇印尼 Detik 新闻,同一篇文章分别用浏览器渲染 DOM、无障碍树快照、可见文本、Skill 的 JSON 和 Markdown 五种方式喂给 Agent,用 tiktoken 的 o200k_base 编码器数 token。结果是渲染 DOM 59788 token,无障碍快照 6842,可见文本 1907,Skill JSON 1730,Skill Markdown 633。也就是 Skill 的 JSON 只有浏览器 DOM 的三十四分之一,Markdown 只有九十四分之一。
这个数字要公平地读。仓库自己在基准记录的 caveats 里承认了边界:跟浏览器可见文本比,JSON 只少 9.28%,Skill 的真正价值是字段结构化而不是字符更少;这是单页单时间点的实测,不代表所有站点。这个诚实度在开源项目里少见,我认可这种写法。crawl4ai 这边没有对位的官方数字,它走的是另一条思路:用 Pruning 和 BM25 内容过滤把 Markdown 压到 fit_markdown,方向一致,但没有给出可复现的对照实验。
什么时候重要:你的 Agent 按上下文计费、或者长上下文精度下降明显时,这个差异直接换算成钱和效果。偶尔爬几页人工看结果的场景,无所谓。
④ 工程成熟度与维护风险
crawl4ai 这边的工程化程度是商业级:7 个 CI 工作流,tests 目录 86 个条目,0.9.x 连续几个版本都在修安全问题(0.9.3 一次关掉 5 个协调披露的漏洞,包括 PDF 处理链路的任意文件写入和 SSRF),有 CHANGELOG、SECURITY.md、SECURITY-CREDITS.md、SBOM。93 个贡献者,出问题有人接。
NewsCrawler 的 .github 目录里只有一个 FUNDING.yml,没有 CI。仓库树里能找到的测试样例是 news_crawler/quora/test/ 下面一个测试文件加一份响应 HTML 快照。2 个贡献者,最近一次 push 是 2026 年 8 月 8 日,一个多月前。这意味着平台改版之后适配器什么时候修好完全看作者个人节奏,这是它的真实风险。
什么时候重要:把它放进生产流水线时重要,平台改版就是你的故障。个人 Agent 助手场景里,坏了一天再修或者换个平台用,风险可承受。
代码对位:同一个动作两边的写法
拿配置入口对位看。crawl4ai 的入口是 BrowserConfig 加 CrawlerRunConfig 两个配置类,光配置文件 async_configs.py 就 120436 字节,能配浏览器类型、代理、会话、钩子、内容过滤、爬取策略。NewsCrawler Skill 的入口是 extract_news.py,220 行,argparse 一共 5 个参数:URL、输出目录、格式、平台、Cookie。一个是框架的配置面,一个是工具的命令行面。
再看扩展点位置。crawl4ai 的钩子体系在 async_crawler_strategy.py 里接入了 12 个:before_goto、on_page_context_created、on_error 等等,爬取流水线每一步都能插逻辑。NewsCrawler 的扩展点就一个:crawlers 目录下加一个平台文件,继承 BaseNewsCrawler,实现 parse_content 和 get_article_id 两个方法,再在 detector.py 的字典里加一行正则。加第 13 个平台的成本是一两百行代码,AGENTS.md 里连测试放哪、README 平台表要同步更新都写了规矩。
# crawl4ai:配置驱动,先组装再执行browser_config = BrowserConfig(headless=True)run_config = CrawlerRunConfig( markdown_generator=DefaultMarkdownGenerator( content_filter=PruningContentFilter(threshold=0.48)))async with AsyncWebCrawler(config=browser_config) as crawler: result = await crawler.arun(url="https://...", config=run_config)# NewsCrawler:一条命令,平台自动识别uv run scripts/extract_news.py "https://mp.weixin.qq.com/s/xxxx" \ --format both --output ./output为什么分道扬镳:两种押注
crawl4ai 押注的是通用性。README 里 unclecode 自己讲了起源:2023 年他要网页转 Markdown,当时的开源方案要注册账号、要 API token、还要 16 美元,他一怒之下几天写了 crawl4ai。所以这个项目从第一天起就是冲着任意网站去的,接受浏览器渲染的重量作为通用性的代价。现在的路线图是平台化:Cloud API、赞助商体系、Docker 服务化,往商业基础设施走。
NewsCrawler 押注的是确定性。它的 README 那张对照表写得很直白:普通浏览器路径下 Agent 每次都要重新理解站点结构,平台规则由 Adapter 维护才可测试、可复用。作者把平台知识从模型运行时的猜测变成了代码库里显式维护的规则。这个选择放弃了通用性换来两样东西:输出结构的稳定,和上下文体积的可控。从作者背景看,这是 MediaCrawler 路线在 Agent 时代的自然延伸,平台对抗经验是可复用资产。
顺带一个观察:crawl4ai 的 README 里残留着一句没删干净的 AI 对话文本,I will help modify the license section with badges 开头那两句,卡在贡献指南和许可证章节中间。83K Star 的项目 README 也有这种手滑痕迹,挺真实的。
同一个任务两边各跑一遍
拿一篇微信公众号文章做例子,这是两边都声称支持的少数交集平台之一。
crawl4ai 这边:pip install 装包,crawl4ai-setup 装 Chromium(首次约几百 MB 下载),然后写 Python 或者用 crwl 命令行。它起 Chromium 加载页面,微信文章是 SSR 渲染的,浏览器能拿到完整 DOM,然后 Markdown 生成器把 js_content 区块转成 Markdown,PruningContentFilter 过滤噪声。输出的 Markdown 里正文、作者、发布时间混在一起,需要下游再解析一遍才能拿到结构化字段。浏览器渲染微信页面,一次几秒到十几秒。
NewsCrawler 这边:npx skills add NanmiCoder/NewsCrawler --skill news-extractor -g 一条命令装进 Agent,首次运行 uv sync 装 6 个依赖。然后 Agent 对话里直接给链接,或者手动 uv run scripts/extract_news.py 加 URL。detector 正则认出是微信,curl_cffi 模拟 Chrome 指纹发请求(wechat.py 里连默认 Cookie 都备好了),解析 cgiDataNew 拿正文,输出 NewsItem JSON:title、author_name、publish_time、contents 按原文顺序排好,texts 和 images 分列可直接取用。不渲染 JS,一次一两秒。
输出形态的差别是本质性的:一个给你一篇给人看的 Markdown,一个给你一份给程序用的 JSON。Agent 拿到后者可以直接入库、排序、检索,拿到前者还要再理解一遍。
能不能一起用
能,而且这是我认为最合理的用法。两者根本不互斥:NewsCrawler 管 12 个新闻平台的确定性提取,这 12 个平台之外的任何 URL 交给 crawl4ai 兜底。装在一个环境里技术上没有冲突,NewsCrawler 的 Skill 依赖自包含,不会跟 crawl4ai 的依赖打架。迁移成本这个概念在这里不太成立,因为没什么可迁的:从 crawl4ai 切到 NewsCrawler 是把 Markdown 输出改成 JSON 消费,属于下游适配工作,不是配置平移。
成本对照
两边基础功能都不需要 API Key,都免费,都本地跑,不需要 GPU。crawl4ai 的 LLM 结构化抽取是可选项,要用的话接各家 LLM 的 Key,费用随模型走;Docker 服务也是免费自托管,但 Cloud API 在内测,商业定价未公布。NewsCrawler 全功能无 Key,Twitter 受保护推文需要你自己登录后的 Cookie,这不算钱算门槛。跑同一个微信文章的成本对比:crawl4ai 是浏览器渲染的时间成本,NewsCrawler 是一次 HTTP 请求的时间成本,token 成本上 NewsCrawler 的 JSON 输出按仓库实测数据是浏览器路径的三十分之一量级。
怎么选
你的 Agent 主要消费新闻和公众号文章,比如做舆情监控、内容聚合、个人知识库,12 个平台覆盖了你的常用来源:选 NewsCrawler,装 Skill 十几秒的事,输出直接可入库,token 账单立省一个量级。
你的输入来源不可控,要做通用网页转 Markdown、深度爬站、大规模采集,或者要 Docker 服务化部署:选 crawl4ai,这个场景里它是唯一解,NewsCrawler 出了 12 个平台就罢工。
你是重度 Agent 用户、来源一半新闻一半杂七杂八:两个都装,NewsCrawler 当第一层,crawl4ai 当兜底层,成本几乎为零,收益是两条路线的优点都拿到。
顺便说 GPL-3.0 的事:NewsCrawler 的协议对个人使用和内部工具没有实际影响,但如果你做商业产品并且分发给用户,GPL 的传染性条款需要过一遍法务。crawl4ai 的 Apache-2.0 没有这个负担,这也是选型时企业团队常卡的一条。
各自不适合谁
crawl4ai 不适合轻量环境:8GB 内存的机器上跑浏览器池会捉襟见肘,树莓派之类的设备直接放弃;也不适合只需要固定几个新闻平台的人,杀鸡用牛刀,装依赖的时间比用的时间长。NewsCrawler 不适合来源不固定的场景,第 13 类网站它就不认了;也不适合需要生产级保障的团队,无 CI、2 个贡献者、一个月没 push,平台一改版就等着作者有空。两边共同的边界:都别用来大规模爬取,两个 README 都明确写了遵守目标站点服务条款和 robots.txt,要遵守法律法规,微信和 Twitter 对自动抓取的态度你是知道的。
项目地址:github.com/unclecode/crawl4ai
项目地址:github.com/NanmiCoder/NewsCrawler
按上面怎么选那一段对号入座,来源固定装 Skill,来源不定装框架,重度的两个都装
— END —
欢迎关注,后续获得更多 AI 工具分享
--开源开研,拆解每一个值得用的开源项目--