ARTICLE · 1047606
Jev AI不是聊天机器人:它是软件里的「决策函数」
Diogo Almeida,OpenAI前研究员和ChatGPT共同发明者之一,2024年创办了TypeSafe AI,Jev是这家公司推出的首个模型。Jev不生成文字,是一种“决策型AI”,提前定义好选项或评分标准,然后直接输出带校准概率和置信度的结构化决策,特点是快(70-500毫秒)、便宜、不会格式出错、可量化信任,专门用于替代Agent编排和自动化流程中那些语义理解的“智能if-ese”判断。
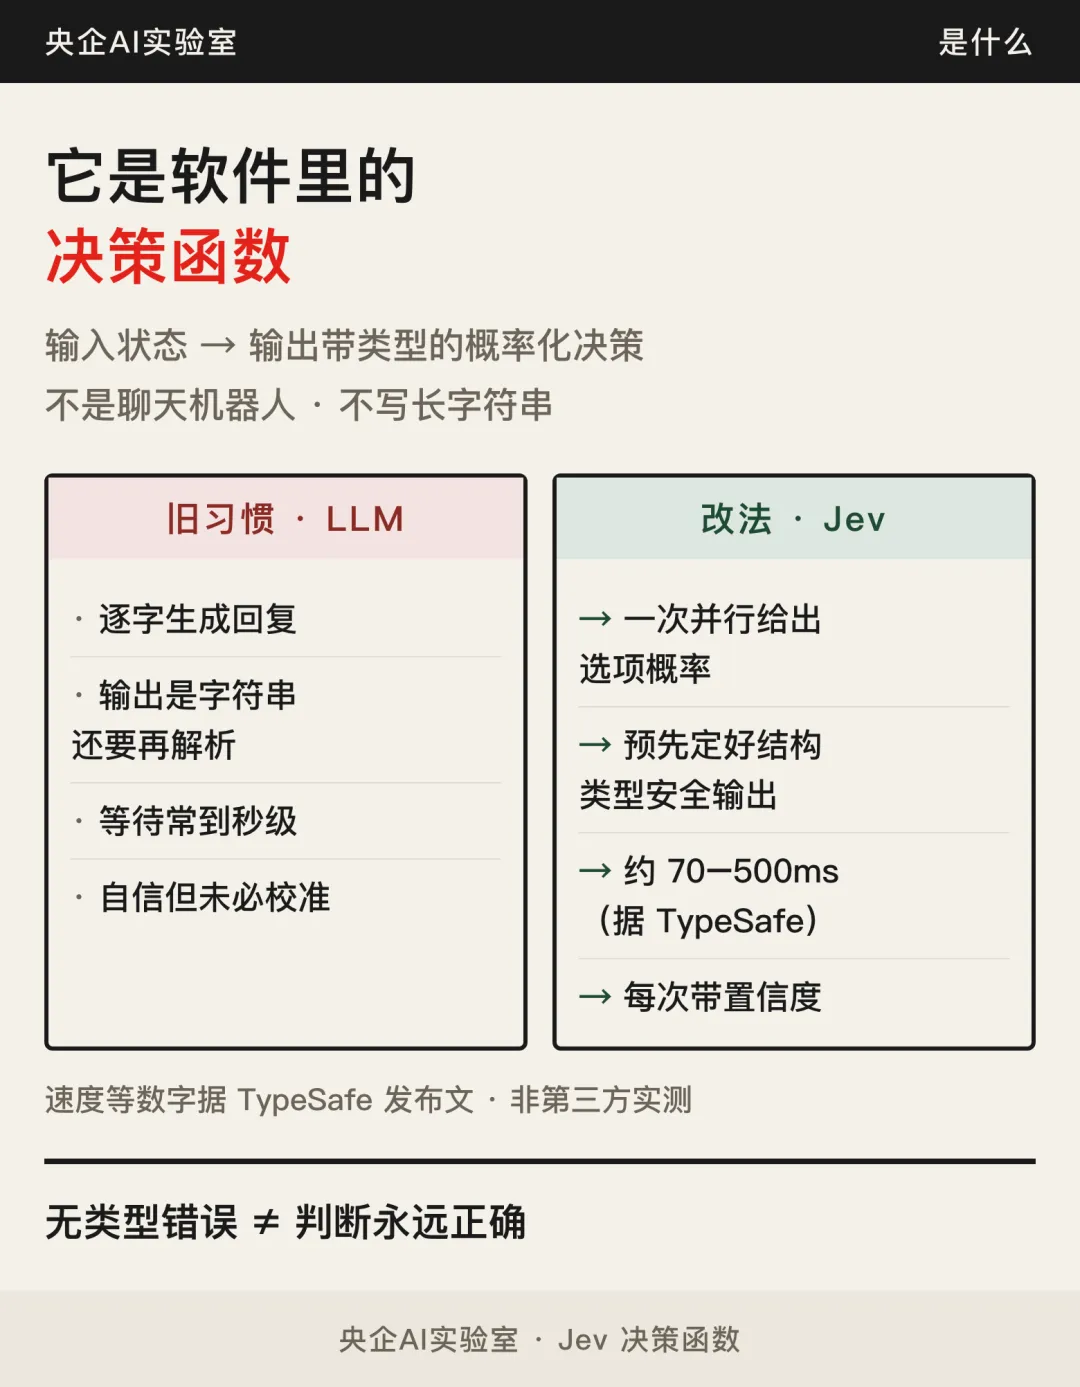
▍一、是什么:System One,不是聊天机器人
TypeSafe 在 2026 年 9 月中旬的发布文里,把 Jev 称为第一款公开的 System One 模型。名字借自《思考,快与慢》里「系统一」那种偏快、偏直觉的判断。创始人提出的驱动问题很直白:模型聊天已经很强了,自动化为什么还没铺开? 他们的答案不是再做一个更会寒暄的助手,而是重做一整个面向自动化的栈——新架构、并行采样,以及名为 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)的训练方法。
用人话讲 Jev 做什么:
- 输入:非结构化状态。可以是一段业务描述、程序当前状态、上一环 Agent 的结果摘要,重点是「状态」而不是「聊着聊着的多轮闲谈」。
- 输出:带类型的、概率化的决策。选项和结构事先定好;模型给出各选项的概率,并附带置信度。
- 不做:字符串生成。不写长邮件、不写整页方案、不「即兴」蹦出一段自然语言来凑数。
官方说法是:把 Jev 想成一个前沿智能的函数调用——非结构化状态进去,带类型的概率化决策出来。职场里更贴的比喻是:它不是替你开会发言的同事,而是嵌在流程里的智能开关 / 智能裁判——你问它「这次走哪条道」,它在合法道路里给概率,而不是再写一篇分析作文。
▍二、和旧 LLM 对照:习惯要换
下面对照表口径均来自 TypeSafe 发布文(Introducing System One Models & Jev,约 2026-09-15)。速度、成本等数字请按「据 TypeSafe 发布文」理解,不是我们第三方实测,也不是可承诺的生产 SLA。
表内数字与对比据 TypeSafe 发布文,非第三方实测。
请同时记住两句,缺一句都会用错:
1. 无类型错误:菜单外的非法字段、乱编的枚举值,它做不出来——「格式幻觉」被针对。
2. ≠ 判断永远正确:合法选项里仍可能选错。置信度是给你设自动 / 人工阈值的把手,不是免责金牌。
用法像先给菜单再点菜——选项你先写死,模型只在菜单里给概率和置信度。放对位置:决策点,不是写稿点。
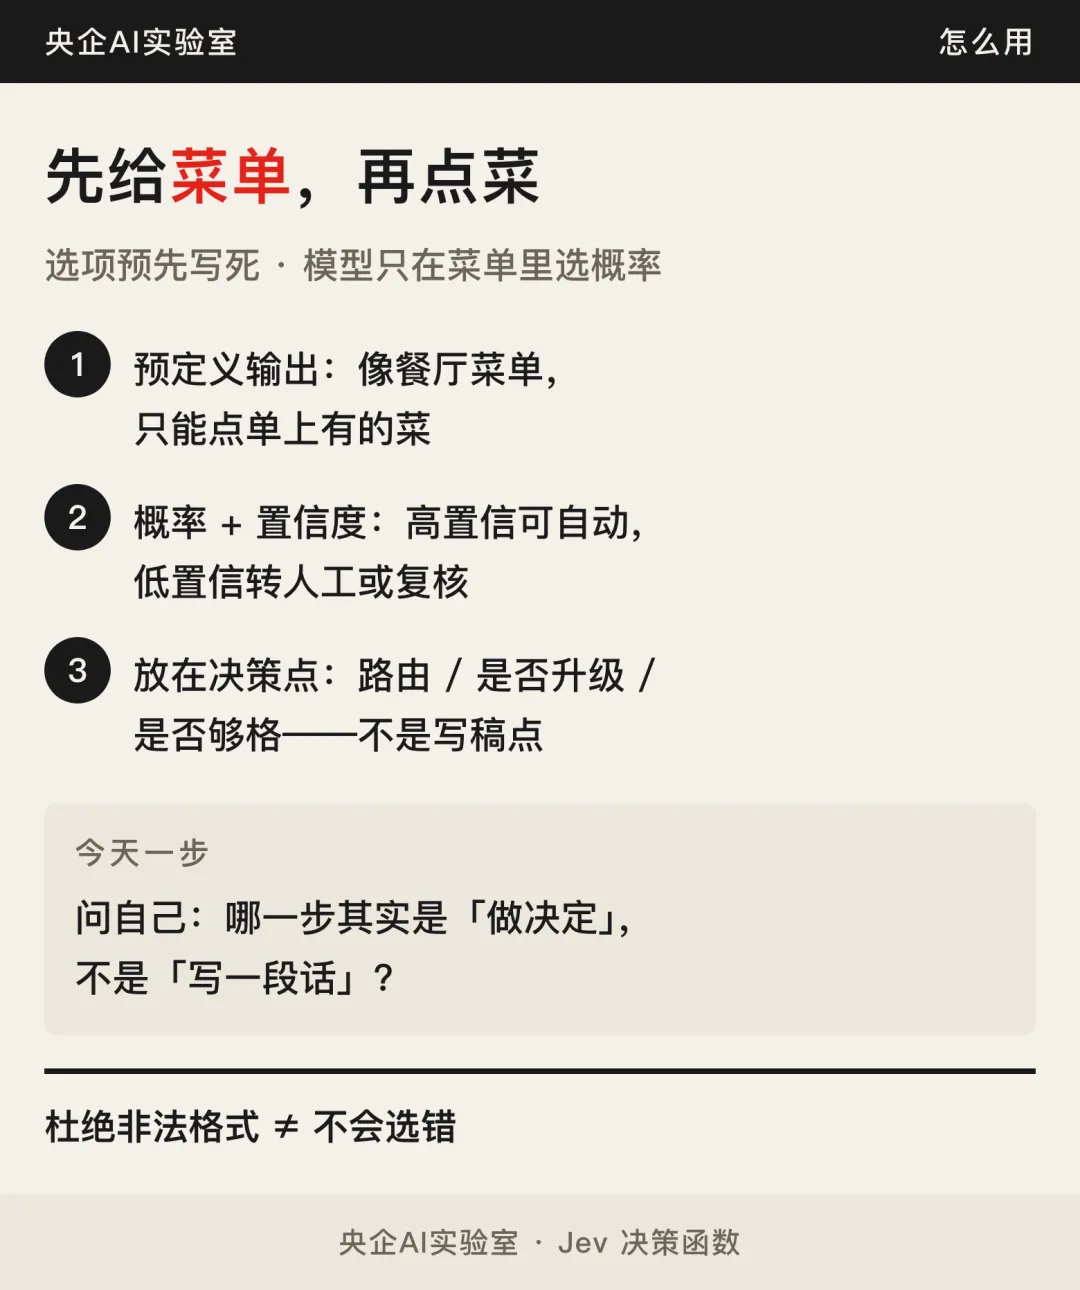
▍三、预定义输出:先给菜单,再点菜
最形象的用法,是餐厅菜单。
你先把「能点的菜」写死,例如:通过 / 退回 / 转人工;急件 / 常规 / 归档;低风险 / 中风险 / 升级评审。模型只能在菜单里分配概率,不能突然端出「再写一首诗」或「额外发明第四种状态」这种菜单上没有的菜。
这对自动化很关键:下游代码不用再猜「这句话到底算哪一类」,也不用为偶发的 JSON 缺字段、多字段写一堆补丁。结构被约束住了,自由留给概率。 你仍然要为业务定义好菜单——菜单设计本身就是产品与流程工作,模型替不了你拍板「世界上有哪几道菜」。
若选项特别多(例如上千个链接里选下一个),发布文在 Wikiracing 演示里提到工程上的折中(如先打分再显式选择等)。对职场读者,记住原则即可:基数越高,越要承认延迟与误差结构会变复杂,不要幻想一个黑盒包打天下。
▍四、幻觉边界:杜绝非法格式,仍可能选错
发布文把幻觉与类型安全绑在一起讲:自动化里,一次幻觉出的工具调用或非法结构,可能不只是「麻烦」,而是延迟承诺和深层依赖链上的硬伤。Jev 放弃字符串生成,换来结构化输出,并主张不能幻觉格式(schema 匹配在设计上可保证;发布文称其类型错误率为设计上的零,而非抽样统计)。
职场里请分清两层,避免被「不能幻觉」四个字带偏:
- 格式幻觉:输出了系统接不住的字段、编造了不存在的枚举——这一层被针对。
- 判断错误:三选一里选了错的那一个——仍可能发生,尤其在信息不足、边界模糊时。
因此置信度不是装饰:高置信可走自动;低置信走人工,或交给更慢、更贵、更会写长文的模型做复核。
顾问场景(给人看建议)和开关场景(直接驱动分支)都能用,但开关场景必须配阈值与回退路径,否则「快」会放大「错」。无类型错误保护的是结构契约,不是业务真相。
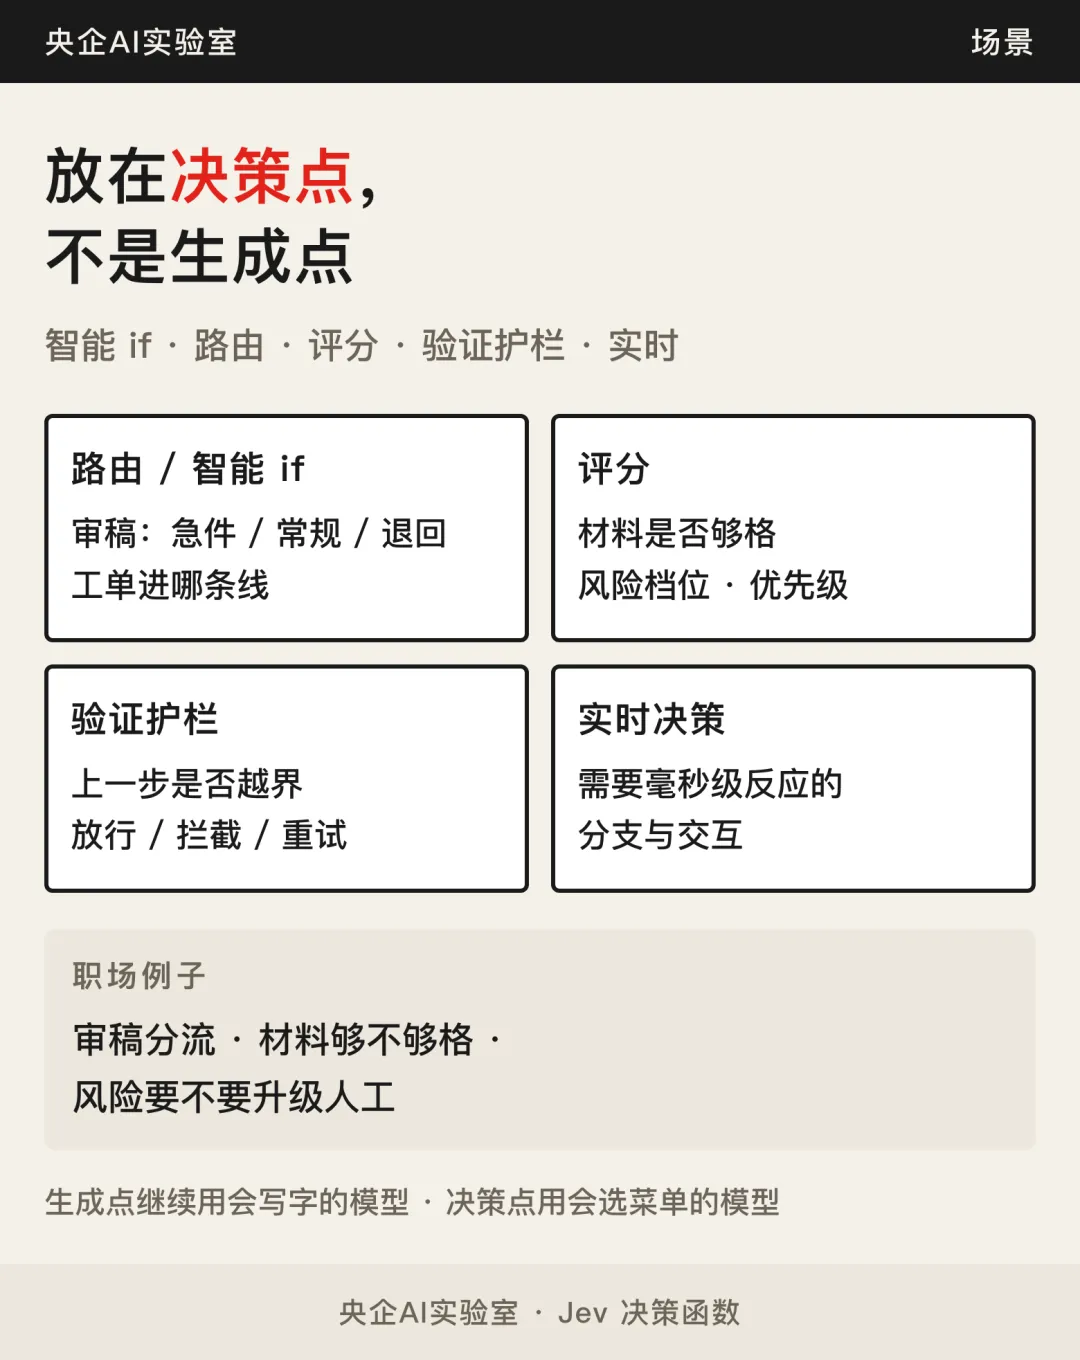
▍五、在 Agent 里放哪:决策点,不是生成点
Agent 编排越来越长时,人们容易把「每一步都让大模型说一段」当成默认。Jev 这类能力更适合卡在决策点:
- 智能 if:规则写不全、条件带糊边时的分支——不是再生成一段解释,而是给出走 A / B / C 的概率。
- 路由:审稿分流、工单分池、材料送哪条审核线。
- 评分:材料是否够格、风险档位、优先级高低。
- 验证护栏:检查上一步 LLM 的输出是否越界、是否像越狱或跑题;用结构化判定给「放行 / 拦截 / 重试」。
- 实时决策:需要约百毫秒级反应的交互或仿真。官方有 Doom、Wikiracing 等趣味演示,用来说明「快到能嵌进环里」以及高基数选项下不幻觉格式的好处——演示不等于你的生产指标,但方向清楚。
写稿、改稿、长推理、开放式方案、需要引经据典的分析——仍是传统 LLM 更擅长的地带。一句话收束:
生成用会写字的模型,决策用会选菜单的模型。
放错位置,要么浪费速度优势,要么在不该自由发挥的地方继续自由发挥。
路由、评分、验证护栏、实时分支——职场里审稿分流、材料够不够格、风险要不要升级人工,都是这类决策点。
▍六、为何会被讨论(不编热度数字)
本文不编转发量、不编排行榜、不虚构「业界一致认为」。讨论点大致来自发布主张与演示形态本身:
1. 自动化缺口:聊天与演示已经很炫,但流程里大量「模糊判断」仍卡在人工或脆弱的 if-else 上。
2. 新栈主张:不为聊天优化,而为「软件可依赖的接口」重做架构、采样与训练(RLCD);并明确放弃字符串生成换结构化输出。
3. 快、便宜、可嵌入:据 TypeSafe 发布口径,延迟与成本对「嵌进代码热路径」更友好;主页等工作流评测里还有数量级对比,发布文自己也提示那是偏高增益端的展示,需带nuance阅读。
4. 演示有趣:Doom、Wikiracing 把实时性与高基数选择讲得直观,降低「又是一篇模型软文」的陌生感。
是否适合你的生产环境,仍要以自家任务分布、延迟预算和错误代价为准。Early access 阶段更宜小步验证:先选一条决策链,量延迟、看校准、设人工兜底。
▍七、边界,以及今天一步
边界简述
- 不做开放式文本生成;需要长文时请换工具,不要硬逼决策模型「顺便写好看」。
- 「无类型错误」保护结构,不保护业务判断永远正确。
- 速度与成本以厂商发布口径为准;是否补贴、是否长期,发布文亦承认需时间验证。
- 本文不荐股、不承诺收益、不虚构第三方测评、不写具体单位客户细节。
补充一句实践提醒:若你的流程里「决策」和「生成」缠在一起——例如审稿时既要判断急缓,又要改出一段话——请拆开。先决策、再生成;决策结果作为生成步骤的输入约束。这样既方便换模型,也方便单独度量「选错了」和「写差了」分别造成多大成本。很多人觉得 Agent「不稳」,其实不稳的常常是决策点没有菜单、没有阈值,却让同一套聊天模型既当作家又当法官。
今天一步
打开你手头任意一条自动化或 Agent 流程,用两色笔标:
- 哪几步其实是「做决定」(分流、升级、够格、是否拦截);
- 哪几步是「写出来」(纪要、邮件、方案、解释)。
只把前者试着改成「菜单 + 概率 + 置信度阈值」——哪怕第一周仍用规则或现有分类器占位,也比继续让聊天模型在决策点自由发挥更清晰。等菜单稳定了,再考虑是否换成 Jev 这类 System One 接口。
生成点继续写;决策点先定菜单。