ARTICLE · 1047613
AI + 项目管理 67
模型即服务(MaaS)
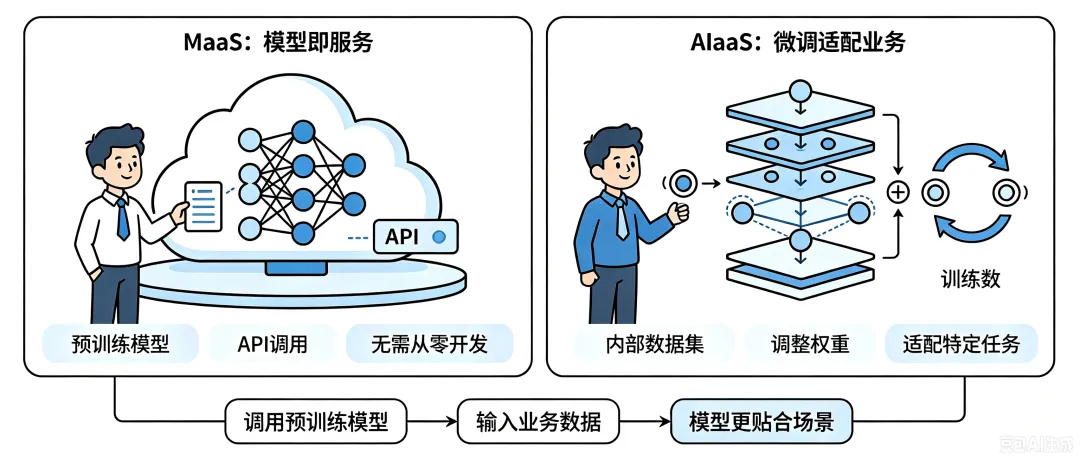
模型即服务(MaaS)主要依托云平台提供服务,但并不局限于云平台。开发者可以通过OpenAI、微软Azure OpenAI Studio等在线网站提供的应用程序编程接口(API)调用预训练大型神经网络机器学习模型。该模式降低了AI的使用门槛,所提供的模型均经过测试、性能得到验证,且并非针对单一任务定制。它简化了AI部署流程,让客户/企业无需复杂的技术储备,就可以使用机器学习的能力。
该模式具备节约成本、部署快速、可弹性扩展、持续迭代优化等优势,非常适合企业希望使用机器学习,但又不想承担自研机器学习模型的复杂工作与高额成本的场景。
微调‑AI即服务(AIaaS)
AI即服务(AIaaS)大多基于云平台实现,但不限于云平台。它可以对来自MaaS的GPT等预训练大型神经网络机器学习模型做进一步调整,使之适配客户/企业的特定业务需求,使用者无需掌握高深的AI专业知识。其过程是基于一份规模较小的内部专用数据集持续训练,同时调整模型权重(即AI模型预测句子或短语中缺失单词/词元时,输入信息的影响强度)以及其他指令参数。
通过该过程,模型在各类特定任务上的表现得以提升,例如自然语言处理、图像识别、情感分析、欺诈检测、语音识别,还可以依托自身知识库回答特定领域的专业问题。
对话类模型是目前最常用的模型类型。这类模型的核心功能是预测下一个单词或短语,表17.1中列出的巴贝奇(Babbage)、达芬奇(DaVinci)模型就属于此类。GPT‑Turbo这类聊天模型也属于对话模型。多任务微调可以同时针对多项关联任务开展训练,增强模型跨任务之间的知识共享与迁移能力,提升综合性能。AIaaS能够让云平台上的模型更贴合具体业务场景,实际效果更好。
可以对哪些模型做微调?
在开展微调之前,必须熟悉各类预训练(开箱即用)模型及其来源。市面上存在多种预训练模型,OpenAI出品的模型整体技术最为先进,能力强大。表17.1为2024年初OpenAI可用于微调的模型清单(版本会频繁更新);不同模型单次可处理的文本数据量各不相同。
表17.1:OpenAI微调模型选型参考(2024年初)
借助API或者软件开发工具包(SDK)进行微调,得到的效果会优于普通提示词工程。微调可以使用经过标注的小规模内部数据集开展训练,样本内容控制在单次提示词可容纳的范围之内,实现词元调用成本优化,同时缩短响应时间。OpenAI的文本生成模型最初是在海量文本数据上完成预训练。还有部分模型处于预览版本,不建议在生产环境中使用,这类模型会频繁迭代,直至推出稳定版本。
微调操作说明
使用这类模型时,通常会在提示词中写入指令并附带少量示例,OpenAI将该方法称为少样本学习。使用模型时,首先输入专门指令,有时还会给出少量示例告诉模型要完成什么任务。
微调则是在此基础上,使用规模大得多的示例集开展训练,提升各类任务的输出质量。经过微调后的模型,提示词中不再需要大量示例,进一步降低成本、加快响应速度(OpenAI,2024)。在项目管理场景中使用OpenAI文本生成模型的少样本学习,就好比给团队一份清晰的项目计划,再提供部分过往真实案例,帮助团队在无需额外培训的前提下,更高效、快速地完成工作。
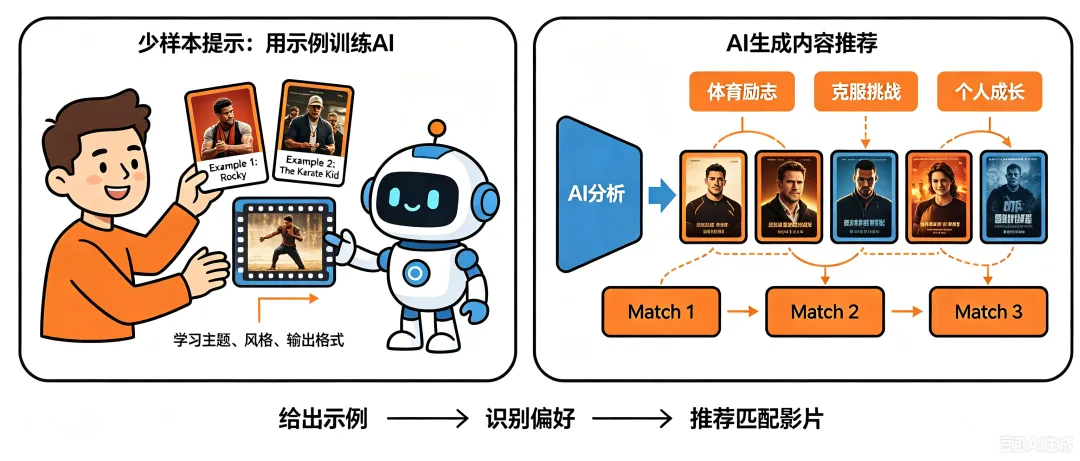
AI领域还有少样本提示,即给模型提供若干示例,引导它完成特定任务。借助这些示例,AI能够学习所需的输出格式与行文风格。举个例子,假设你要搭建类似网飞(Netflix)的流媒体平台,AI模型需要结合观众历史观影记录,根据电影剧情、主题生成影片推荐。通过向AI提供电影剧情、主题的示例,AI就可以学习并做出预测。
例如,某位观众看过《洛奇》这类体育励志影片,以及《龙小子》这类讲述克服困难、个人成长题材的电影,这些构成了该观众的观影历史。为训练AI,我们采用少样本提示,给出如下示例:
示例1:《洛奇》——出身平凡的拳击手,立志挑战世界重量级拳王的故事
示例2:《龙小子》——少年学习空手道,勇敢直面困境
AI学习这些样例之后,就可以判断该观众偏好的题材与风格,并向其推送匹配口味的电影。
完成模型微调之后,就不用再在提示词内塞入大量示例。大语言模型(LLM)不同调用量对应不同定价,因此微调可以显著节约成本。以下摘录自OpenAI官网的定价说明:
“多款模型具备不同能力与定价。价格按每1000词元计费。可以把词元理解为文字片段,1000词元大约对应750个英文单词。本段引述内容共计35词元。”
如需了解完整模型定价,请访问OpenAI官网;Azure OpenAI服务的定价可查阅微软学习平台(learn.microsoft.com)。
估算训练成本公式:
每千词元基础成本 × 输入文件总词元数 × 训练轮数(epochs)
因此,一份包含100 000词元的训练文件,完整训练3轮,成本约为2.40美元。
何时应当使用微调
未完待续
关键术语注释
token(词元):AI文本处理最小单元,英文中不等于完整单词,用于计量计费与上下文长度; epoch(训练轮):把全部训练数据集完整遍历一遍,称为1个epoch; few‑shot learning / few‑shot prompting:少样本学习 / 少样本提示; fine‑tuning:微调; pretrained model:预训练模型; weights / parameters:权重 / 参数。