ARTICLE · 1047920
杀入全球最贵行业!OpenAI发布GPT-6法律版:2.3亿卷宗砸下,百亿独角兽沦为插件
在整个商业世界里,几乎找不到比顶级律师事务所更保守、更昂贵,也更排斥“黑盒技术”的地方了。
在这里,资深合伙人的计费单位是“小时”,每小时收费动辄上千美元。一份几百页的并购合同,哪怕漏看了一个违约例外条款,或者引用了一则被上诉法院推翻的作废判例,赔偿金就可能高达数千万。
但就在 2026 年 9 月 17 日,这个由精英人类筑起的堡垒,迎来了 OpenAI 的重型攻城锤。
OpenAI 正式发布 Astra for Law,这是将公司旗下最强前沿模型 GPT-6 Astra 与一套庞大的法律专有检索索引、深度法律指令以及律所级治理架构深度打包后的“法律职业版”。
消息一出,整个欧美法律界和硅谷同时震动。
在这份生态名单中,此前估值高达 156 亿美元的法律 AI 头部公司 Harvey,以及估值百亿美元的 Legora,同时列在了 OpenAI 的“插件列表”里。
OpenAI 正在调整策略:越过单纯提供基础底座的阶段,带着整套行业实务图纸,直接进入垂直行业做深度交付。
2.3亿条卷宗:重装上阵的“数字专职律师”
许多人关心的核心问题是:OpenAI 是否从零训练了全新的底座模型?
实际情况是,Astra for Law 的底层依然依托 GPT-6 Astra。OpenAI 没有另起炉灶,直接为既有模型穿上一整套面向实务的“重装铠甲”。
你可以把它拆解为三个紧密咬合的层次:
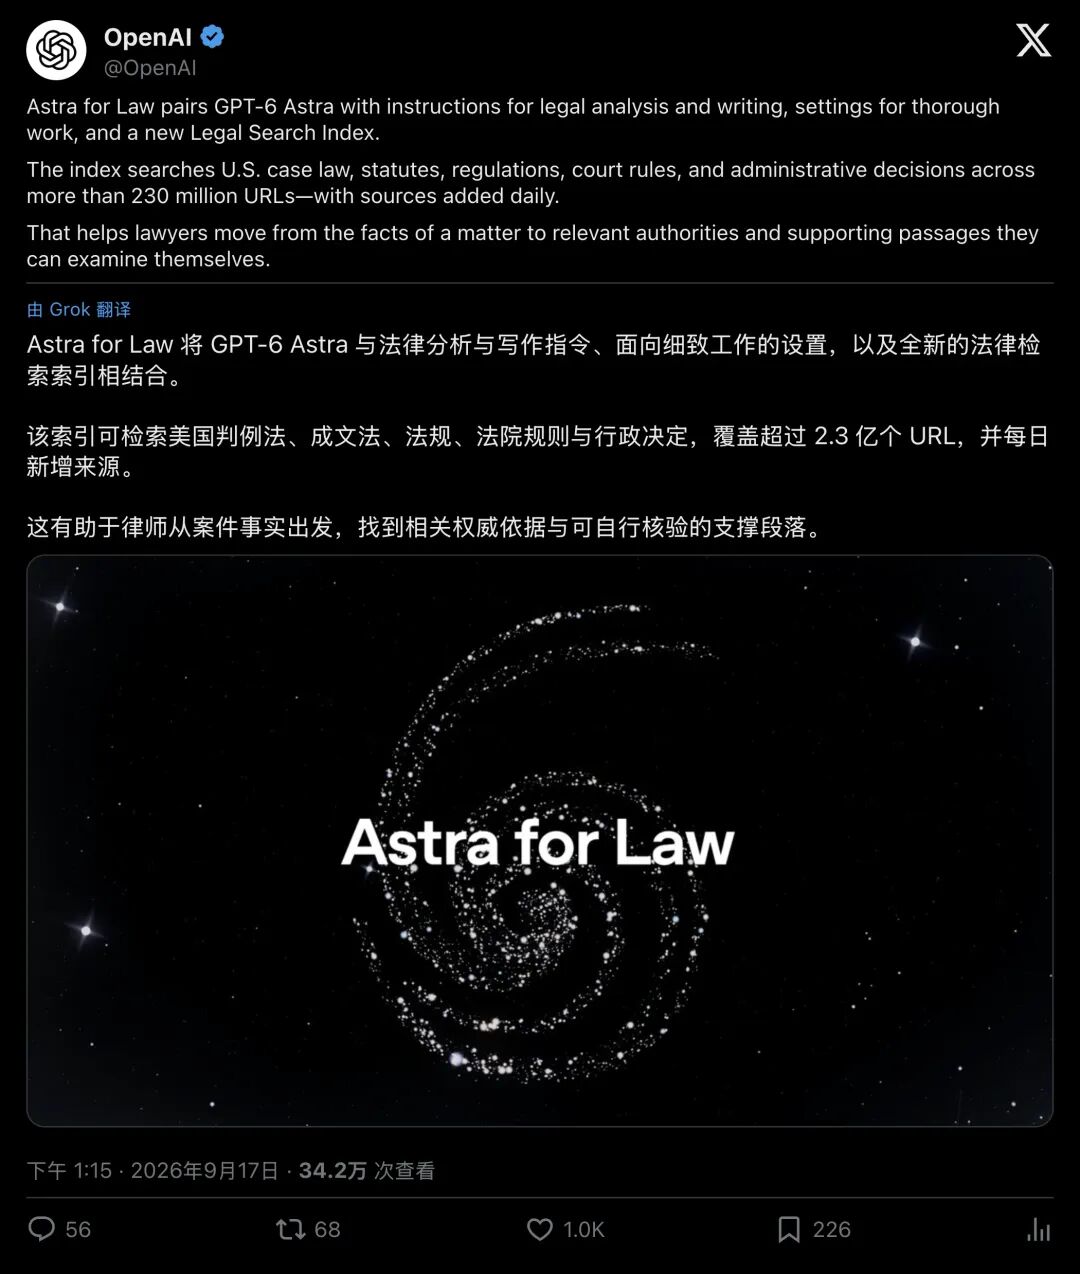
▲ 官方介绍: Legal Search Index 涵盖超 2.3 亿 URL
1. 深度法律检索索引(Legal Search Index)
通用大模型做法律检索,最大的毛病就是“一本正经地胡说八道”。
为了根除幻觉,OpenAI 搭建了一座语料规模超过 2.3 亿个 URL 的专用检索库。它通过非营利机构 Free Law Project 的 CourtListener 等权威数据源,直接覆盖了美国超过 99.9% 具有先例效力的公开判例,并纳入联邦成文法、行政法规、法院规则以及行政裁决,每日动态更新。
2. 法律推理与执业写作指令
普通人写文章要辞藻华丽,而律师写文书讲究区分裁判要旨(Holding)与附带论述(Dicta)。
Astra for Law 经过专门调试,懂得根据客户的特定事实去推演抗辩逻辑,指出己方论点的薄弱环节,甚至能精准解释某条例外条款如何将商业风险悄悄转嫁给对手。
3. 企业级治理与“零数据保留”
律所最怕什么?泄密
OpenAI 拿出了名为 Trusted Access 的准入机制。针对符合条件的律所,提供 API 侧零数据保留(Zero Data Retention, ZDR),企业版数据默认不进入人工复核。据披露,这套机制背后是一份厚达 30 页的合规接入协议,专门针对伦理墙(Ethical Walls)与客户保密义务设计。
54% 的及格线:是神话,还是清醒剂?
在官方公布的基准测试中,OpenAI 披露了一组值得深究的对比数据。
他们采用了第三方评测机构 Vals AI 的 Legal Research Bench 私有验证集,抽取了 200 道美国法律研究实务题进行最高推理力度对比:
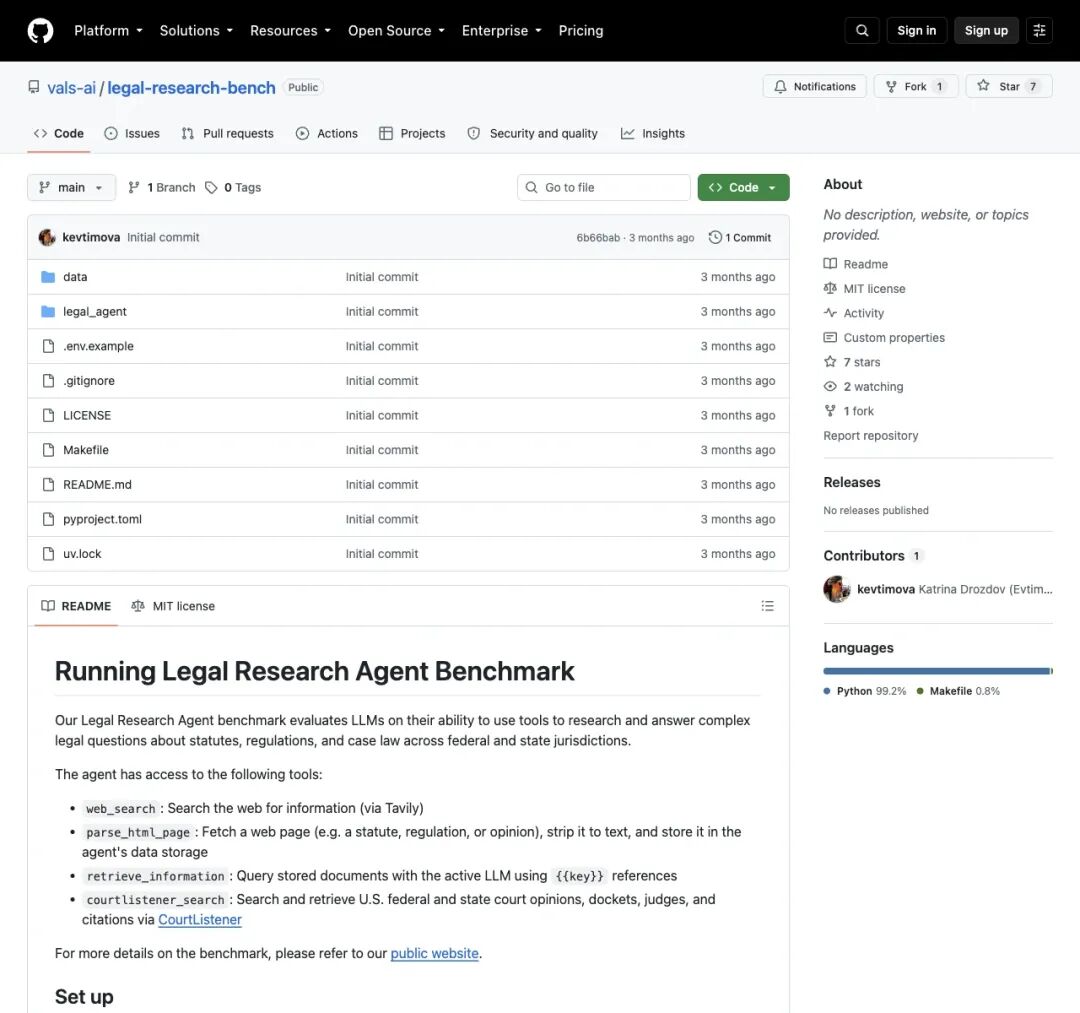
▲ Vals AI 法律研究基准(Legal Research Bench)
- GPT-6 Astra + 普通网页搜索
:综合正确(all-pass)通过率仅为 38.7%。 - Astra for Law
:综合正确率拉升到了 54.0%。 判例匹配数量增加了约 24%,从裁判文书中准确调取核心支撑段落的能力提升了 54%。
从 38.7% 提升到 54.0%,相对增幅接近 40%。在官方给出的示例对比中,通用大模型给出的判例有些甚至早已被上诉法院推翻,而 Astra for Law 准确找到了具有约束力的有效先例。
与此同时,这组数据也清晰标出了当前技术的边界。
哪怕配备了 2.3 亿 URL 的索引,Astra for Law 依然有 46% 的题目没有完全通过。
在法律行业,46% 的缺陷率代表着文书底稿绝不能直接寄送法官。正如 OpenAI 在帮助中心里的明确警告:律师必须自行审查所有输出与引用来源。
它是一个能帮你通宵翻看上千卷宗的“超级实习生”,但最终在文书上签字承担法律责任的,依然只能是合伙人。
顶级律所倒戈:华尔街豪门如何用它?
与以往“科技极客自嗨”不同,这次站在 OpenAI 身后的,是全美顶奢的律所天团。
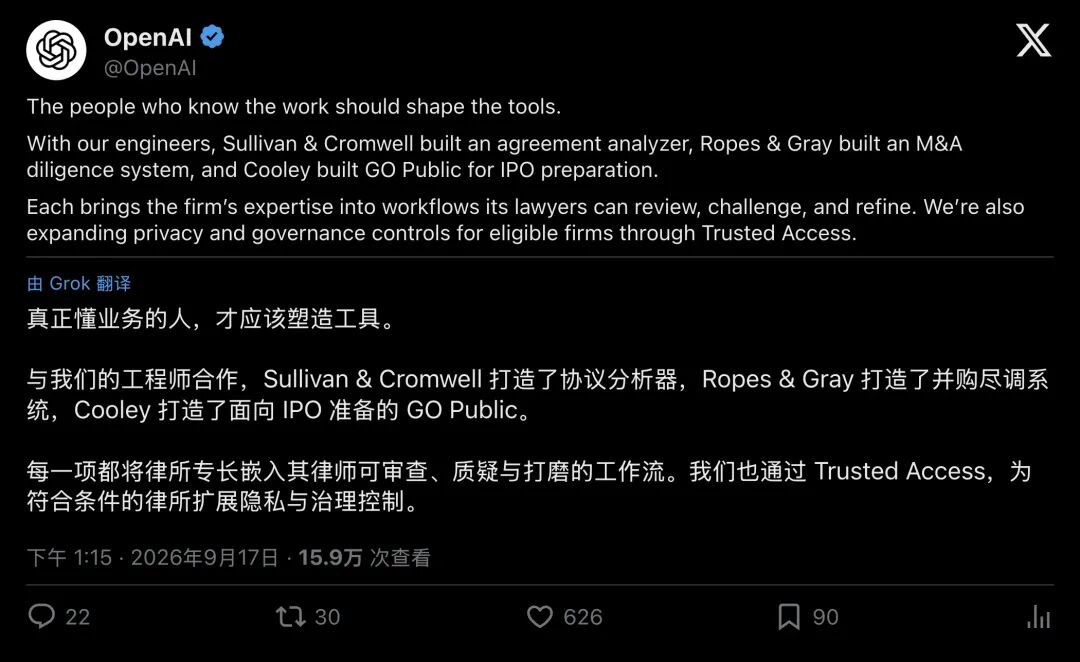
▲ 官方公布的共建律所包括 Sullivan & Cromwell、Ropes & Gray、Cooley 等
OpenAI 派出了“前向部署工程师”(Forward-Deployed Engineers),直接驻场把律所几十年来积累的独门秘籍(Playbook)变成 AI 工作流:
- Sullivan & Cromwell(苏利文·克伦威尔)
:打造了专属的“协议分析器”,将律所内部的谈判手册与历史标杆案例注入模型,在交叉审阅几份商业合同时,自动捕捉潜在的冲突风险并生成修改红线。 - Ropes & Gray(睿盛)
:构建了并购尽调系统,专门解决“虚拟数据室(Data Room)”海量文档的穿透审查,把发现的每个潜在风险精确溯源到合同的某一条款。 - Cooley(科律)
:将资本市场经验注入“GO Public”系统,从 IPO 招股书起草到挖掘潜在监管披露风险,一旦交易结构发生变化,全套申报材料同步联动核验。 - Wachtell, Lipton, Rosen & Katz(沃奇尔)
与 Latham & Watkins(瑞生):分别在复杂诉讼判断与数据安全伦理墙设计上与 OpenAI 深度捆绑。
华尔街律所跳出了单纯“购买软件”的传统角色,借助底层大模型把全所沉淀的实务经验转化为专有系统,向“软件架构师”的方向演进。
蜘蛛侠互指:百亿独角兽沦为插件?
这场发布会最具戏剧性的一幕,发生在其生态名单公布的瞬间。
OpenAI 一口气上线了 26 个合作伙伴插件,其中包括老牌法律软件 iManage、Relativity、DocuSign,也包括法律 AI 领域的两大天王级独角兽,Harvey 与 Legora。
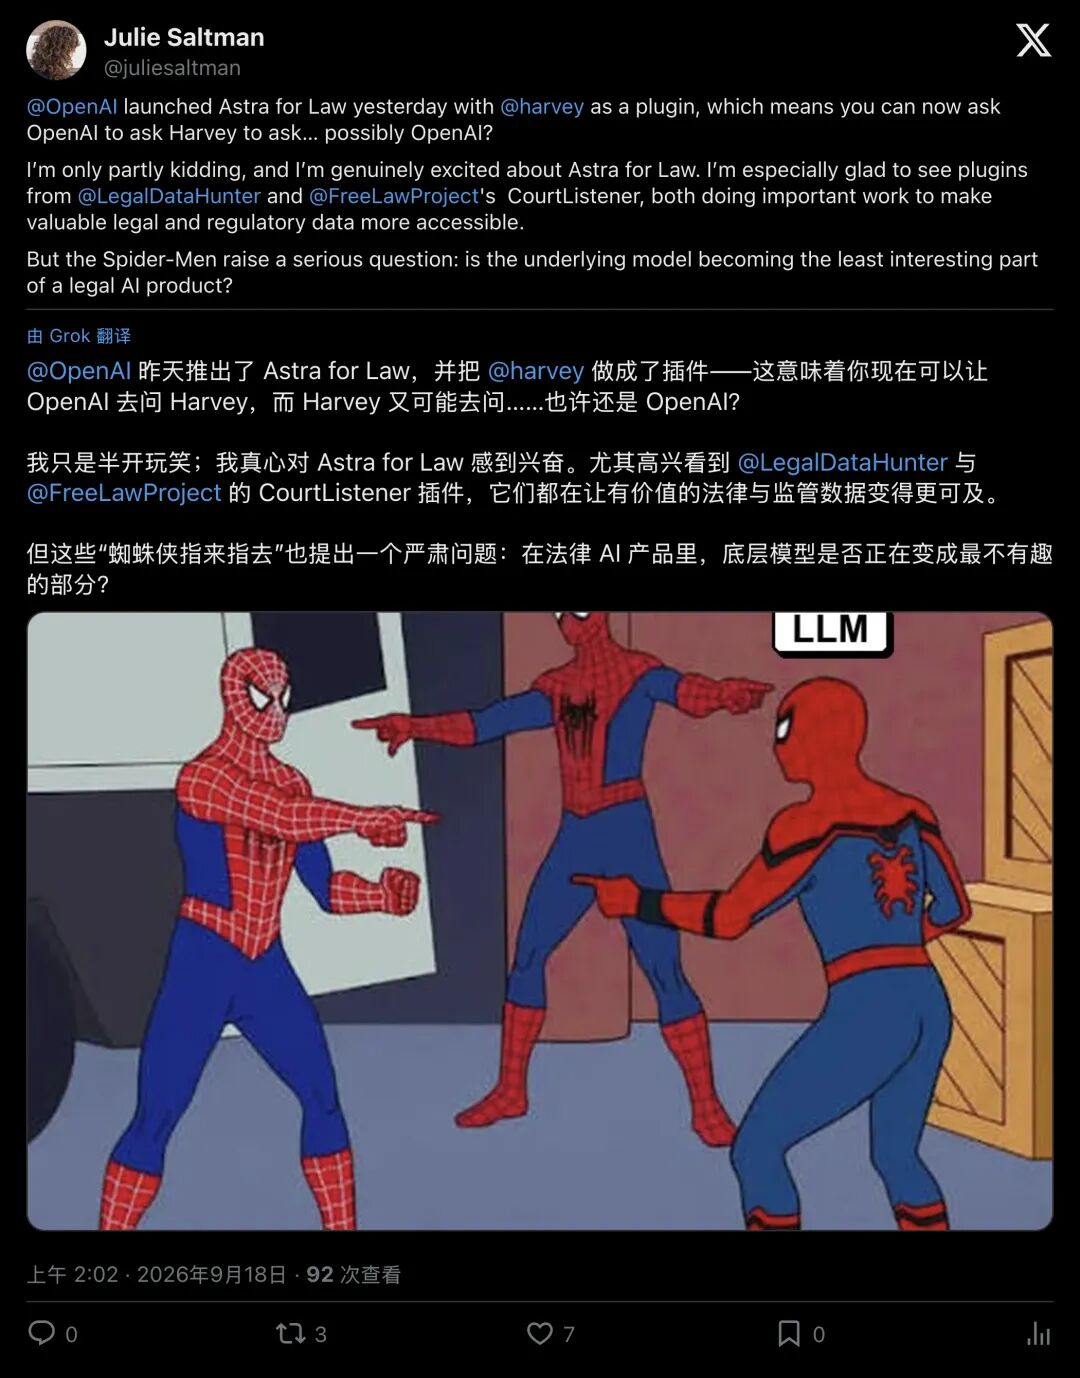
▲ 法律科技从业者 Julie Saltman 发布的推文
法律科技投资人 Julie Saltman 随即发了一张著名的“蜘蛛侠互相指认”表情包并调侃道:
“OpenAI 发布了内置 Harvey 插件的 Astra for Law。等于说,你现在可以让 OpenAI 去询问 Harvey,而 Harvey 转身又去调用……OpenAI?”
这看似玩笑的吐槽,戳中了所有垂直 AI 创业公司最敏感的神经:当底层模型厂商亲自把行业检索、合规通道和工作流都做掉了,垂直应用公司的护城河到底在哪?
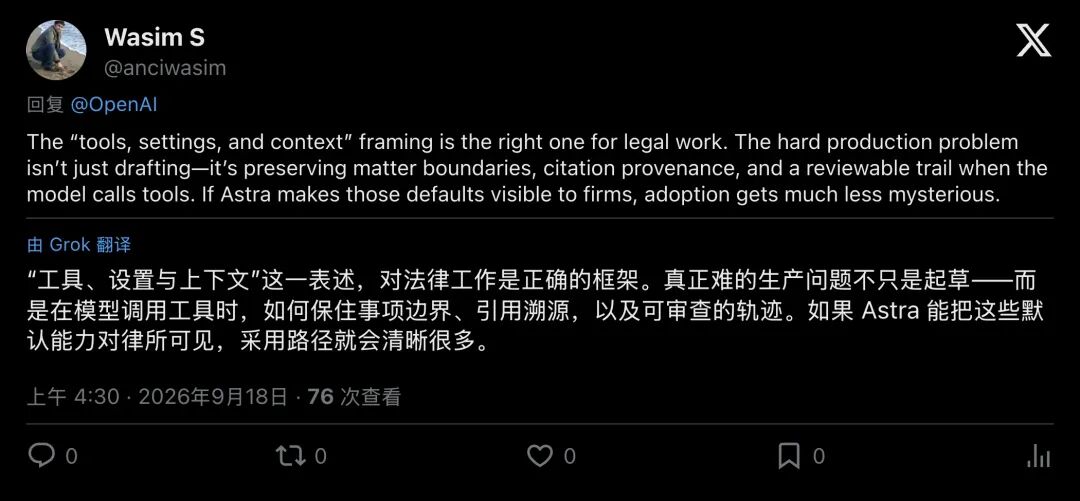
▲ 工程师解析:法律落地关键在于维护事项边界与可审查的溯源轨迹
一种残酷的共识正在硅谷蔓延:如果一家垂直 AI 公司的核心壁垒只是“精调提示词”和“好看的网页 UI”,它在平台级更新面前将脆弱不堪。
垂直工具的长远防线,落在底层模型抓不到的深处:
- 专有事项数据(Matter Data)
:深埋在客户内部系统里的非公开工作记录与交互历史。 - 法定牌照与责任兜底
:出了致命事故,谁来买单?谁能承担执业过失保险? - 深度业务工作流的嵌入度
:工时计费、证据链分析、协同审阅等脏活累活。
Harvey 和 Legora 们必须加速向工作流深水区逃逸,否则等待它们的,只能是沦为巨头生态里的一个小小“功能开关”。
连环棋局:OpenAI 正在批量生产“数字白领”
放眼整个产品版图,Astra for Law 显然属于系统性推进的一环。
就在发布法律版的大约一周前,OpenAI 刚刚推出面向金融服务的专属配置,直接打通了标普(S&P)、伦交所集团(LSEG)、穆迪(Moody’s)和 PitchBook 的专业金融数据。
一周金融,一周法律
OpenAI 正在跑通一条极其标准化的“专业角色流水线”:
顶尖基础模型 + 垂直行业权威索引 + 岗位思维链指令 + 严苛治理协议 = 即插即用的数字岗位
下一个接盘的会是谁?医疗诊断?工业设计?还是财税审计?
通用人工智能的落地之战,已经彻底告别了“聊天问答”的玩具时代。那些曾被认为最难被算法撼动的、依靠经验与智力构建的极高薪行业,正在成为第一批被前沿大模型精细收割的试验田。
对于各行各业的专业人士而言,风暴已然推门而入。