ARTICLE · 1053046
零LLM配置+精准代码审查-Open Code Review委托模式 Skill 使用与解析
OCR 版本 v1.12.7 · 源码核对基于 alibaba/open-code-review main 分支
Open Code Review(OCR)是阿里开源的 AI 代码审查 CLI。它的委托模式(Delegation Mode)把审查拆成两半:OCR 用纯确定性代码完成「该审哪些文件、按什么清单审」,宿主 AI Agent(CodeBuddy、Trae、Qoder等)用自己的 LLM 完成实际推理——OCR 端零 LLM 配置。而它完整模式(ocr review)找 Bug 准确率高的根源,是一套「确定性工程 × Agent」的混合架构:纯函数文件筛选、52 份按语言定制的规则清单、语义分组分治、Plan→审查→行号校准→事实核查四阶段流水线,以及刻意「重精确、轻召回」的不对称设计。
一、这个 Skill 解决什么问题
如果你用过CodingAgent做代码审查,大概率遇到过三个痛点(OCR README 原话):
- •覆盖不全
——变更集一大,Agent 就开始「偷工减料」,只挑部分文件审; - •位置漂移
——报告的问题对不上实际代码位置,行号或文件引用偏移; - •质量不稳
——自然语言驱动的 Skill 难以调试,prompt 稍有变化审查质量就大幅波动。
根因是:纯语言驱动的架构,对审查过程缺乏硬约束。
委托模式 Skill 的解法是把「不能出错的环节」从语言模型手里拿走,交给确定性代码:
| 环节 | 谁负责 | 为什么 |
|---|---|---|
对订阅制用户来说还有个实际好处:复用宿主 Agent 的订阅额度,不需要额外配置任何 API Key 或模型端点。
二、Skill 的使用:七步工作流
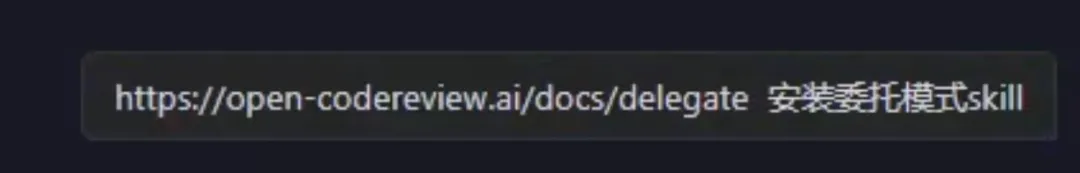
安装提示词:
https://open-codereview.ai/docs/delegate 安装委托模式skill
装好后对宿主 Agent 说「用委托模式审查代码」,它会按 SKILL.md 的七步协议执行:
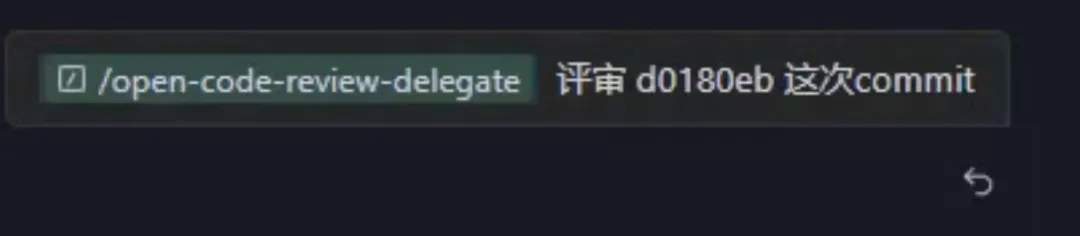
第 1 步:Preview——确定审查范围
bash
输出 JSON 包含:mode(workspace/range/commit)、ref 元数据(from/to/commit/merge_base,供你拼 git 命令)、可审查文件列表(路径、状态、增删行数)、被排除文件及排除原因。
三种常见场景:
| 场景 | 命令 |
|---|---|
ocr delegate preview | |
ocr delegate preview --from main --to feature | |
ocr delegate preview -c abc123 |
第 2 步:获取文件规则
bash
传入第 1 步的可审查文件路径,输出按规则内容分组的结果——共享相同规则的文件归为一组,避免重复。
第 3 步:获取 Diff
按 mode 用 git 直接取:range 模式 git diff <merge_base>..<to> -- <path>;commit 模式 git show <commit> -- <path>;workspace 模式已跟踪文件 git diff HEAD -- <path>,未跟踪文件直接读全文(整个文件都是新代码)。
第 4 步:逐文件审查
为每个 reviewable_files 条目建 checklist(以 (path, status) 为身份——workspace 模式下「staged 删除 + untracked 重建」会让同一路径出现两次)。每个文件:取 diff → 对照规则组清单 → 深入审查 → 标记 reviewed 或带具体原因的 skipped。大变更按共享规则分批,不要找到第一个高危问题就停。
第 5-6 步:结构化输出与覆盖率报告
每条评论必须含 path、content,可选 start_line/end_line、category(bug/security/performance/...)、severity(critical/high/medium/low)。报告前必须核对每个文件都有去向,输出 total_files、reviewed_files、skipped_files、coverage_rate——覆盖率是强制的,不许静默漏文件。
第 7 步(可选):修复
用户要求 "review and fix" 时:Critical/High 直接修,Medium 描述修法,Low 除非顺手否则跳过。
三、源码实现原理:npm 包背后是一个 Go 二进制
npm install -g @alibaba-group/open-code-review 装的其实是个二进制分发器——仓库 npm/ 下按平台预编译,npm 包根据平台下载对应的 Go 编译产物。核心代码全在 Go 里:
text
委托模式的实现出奇地薄
cmd/opencodereview/delegate_cmd.go 里,preview 子命令直接复用完整模式的 agent.Preview(),但故意不传 Template(delegate_cmd.go:119-133 的注释写明:宿主 Agent 用自己的上下文窗口审查,OCR 的 max_tokens 不是委托工作的限制)。rule 子命令则调用 internal/delegate/rulegroup.go 的 GroupRules:以 source + pattern + text 为 key 聚类(rulegroup.go:46),来源、匹配模式、规则文本三者完全一致才归同组——两份规则文本相同但来源不同的文件保持分组独立,保证每组的元数据对组内所有文件都准确。
这就是委托模式的全部:两个只读命令,输出一份「审查规格」,零 LLM 调用。
四、委托模式 vs 完整模式——差别在哪
一句话本质
委托模式 = 完整模式砍掉 LLM 那一半流水线,把推理环节外包给宿主 Agent。 两者共享同一个确定性底座(selectFiles 纯函数、规则 Resolver),分叉点在「拿到文件清单和规则之后谁来做推理」。
逐维度对比
| 维度 | 完整模式 ocr review | 委托模式 ocr delegate |
|---|---|---|
三个关键差异的深意
1. 质量责任的转移方式完全不同。 完整模式把「位置漂移」和「事实错误」这两个 LLM 最易失真的维度做成了工程模块(专职 LLM 任务 + 刻意的删除高门槛)。委托模式没有这些模块——它把同样的约束降级成 SKILL.md 里的协议文本,赌宿主 Agent 会遵守。这是委托模式最大的质量风险:约束从「代码强制」变成了「prompt 约定」。
2. 委托模式是完整模式的真子集,不是平行实现。 delegate_cmd.go:124-133 里 preview 直接复用 agent.Preview(),只是故意不传 Template——注释写明:宿主 Agent 用自己的上下文窗口,OCR 的 max_tokens 不是委托工作的限制。规则解析也是同一个 Resolver。所以 OCR 团队维护的是一套代码,委托模式只是暴露了流水线的中间产物。
3. 无状态是刻意设计,不是偷懒。 preview 不建 session 的原因在源码注释里:走 New 会自动创建 session 并留下未 finalize 的 JSONL 文件。委托模式要求「可反复调用无副作用」。