ARTICLE · 1056441
Spring AI 源码阅读(一)——ChatClient.prompt().call():一次请求到底怎么走到模型
配套仓库:https://github.com/iweidujiang/spring-ai-source-notes
对照源码:Spring AI
2.0.1(与当前main主干类名一致)样例:仓库内
ChatClientCallController
本文导航
业务代码往往只有这么几行:
@GetMapping("/chat")
public String chat(@RequestParam(defaultValue = "用一句话介绍 Spring AI 的 ChatClient") String q) {
returnthis.chatClient.prompt()
            .user(q)
            .call()
            .content();
}
看起来像 拼个字符串,直接问大模型 ,若真按这个理解去读源码,很快就会迷路:明明写了 call(),为什么还没碰到 ChatModel?Prompt 又是在哪冒出来的?
那么本文的重点就是:
Spring AI 用怎样的分层,把写起来像 RestClient、跑起来像可扩展管道这两件事同时做对。
读完你应能明白:
看见 fluent API,先问:哪一步只是组装,哪一步才是执行? 看见统一入口,先问:真正干活的对象有没有被包进可扩展点? 看见返回值很 厚 ,先问:对外简化成 String 时,中间剥了几层?
一、它要解决什么问题
把大模型接进 Spring 应用,至少有三件麻烦事:
Spring AI 的对策可以概括成三点:
** ChatModel**:不同模型厂商差异停在这一层(像 Servlet)。ChatClient+ Advisor:应用侧统一入口,横切能力挂在链上(像 Filter / Gateway)。RequestSpec / ResponseSpec:构建与执行分离(像 RestClient 先 build、再 retrieve)。
后面都围绕这三点,看它们如何落在一次同步的 call().content() 上。
二、构建与执行分离
误区
很多人下意识认为:
.call()= 已经向模型发请求了。
实际设计
fluent 链里,**.call() 只负责把这一次要说什么、用哪条管道,收束成可执行对象;真正触发管道的是 .content()(或 chatResponse() / entity() 等终端方法)**。
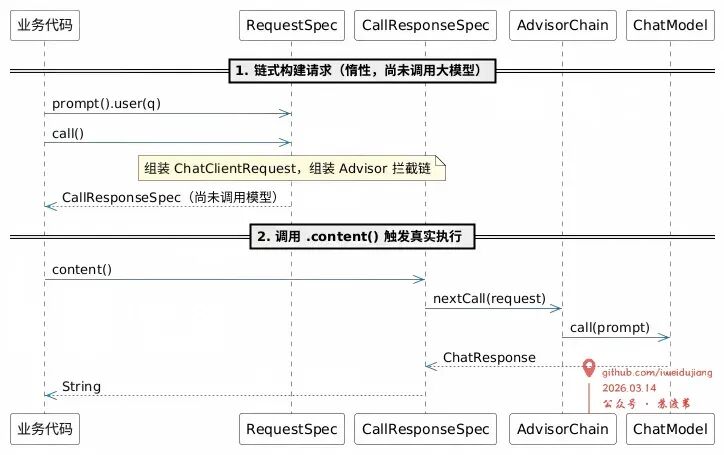
记一句就够:
.call()= 组装管道;终端方法(如.content())= 拧开水龙头。
这不是抠字眼。分不清 组装 / 执行 ,读任何 WebClient、RestClient、以及以后的 MCP Client,都会在半路上以为请求已经发出去了。
源码落点
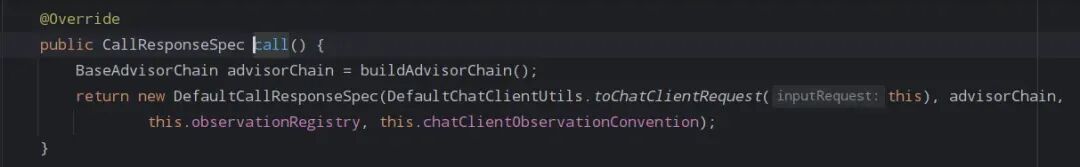
位置 1:DefaultChatClient.DefaultChatClientRequestSpec#call
做两件事: buildAdvisorChain(),再new DefaultCallResponseSpec(...)。这里没有 ChatModel.call。
位置 2:DefaultCallResponseSpec 内触发链的那一句
advisorChain.nextCall(chatClientRequest)
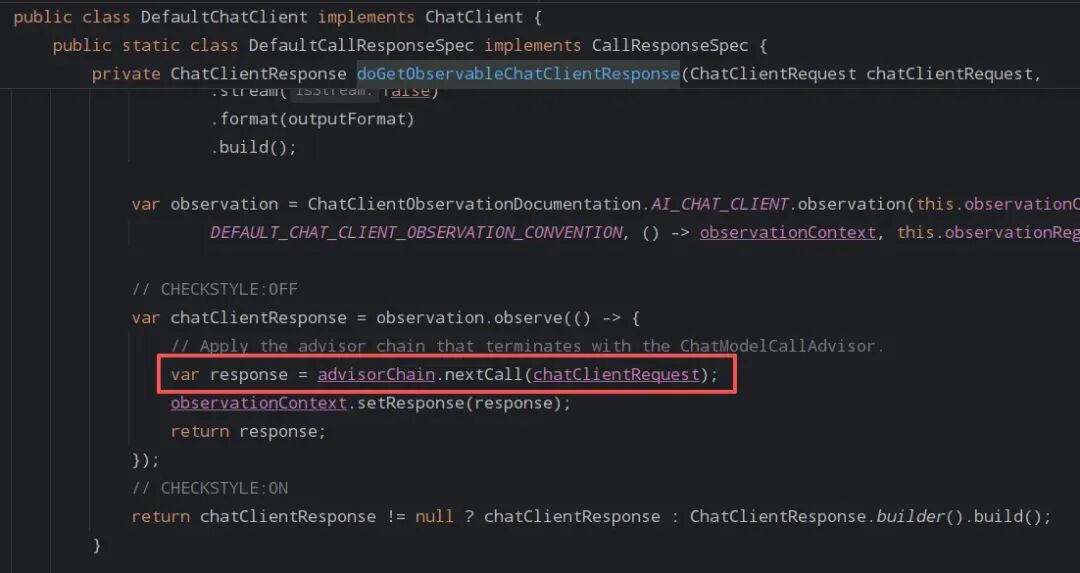
可以看到注释里写得很清楚了:advisor chain terminates with the ChatModelCallAdvisor,意思就是链路的最后一环落到 ChatModelCallAdvisor。
三、把 ChatModel 放进 Advisor 链底
要解决的问题
如果 ChatClient 内部写死:
拼 Prompt → chatModel.call → 返回
那记忆、RAG、审计、限流就只能:
改框架,或 在业务外面再包一层 伪 ChatClient 。
可扩展点和 调模型 若是两条路,以后所有横切能力都会长歪。
设计选择
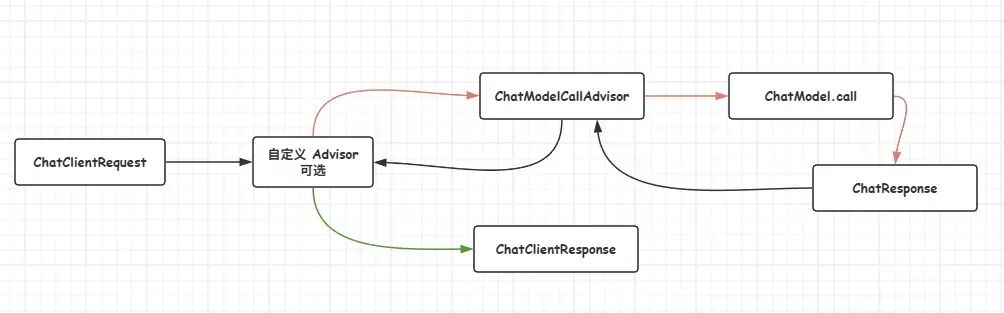
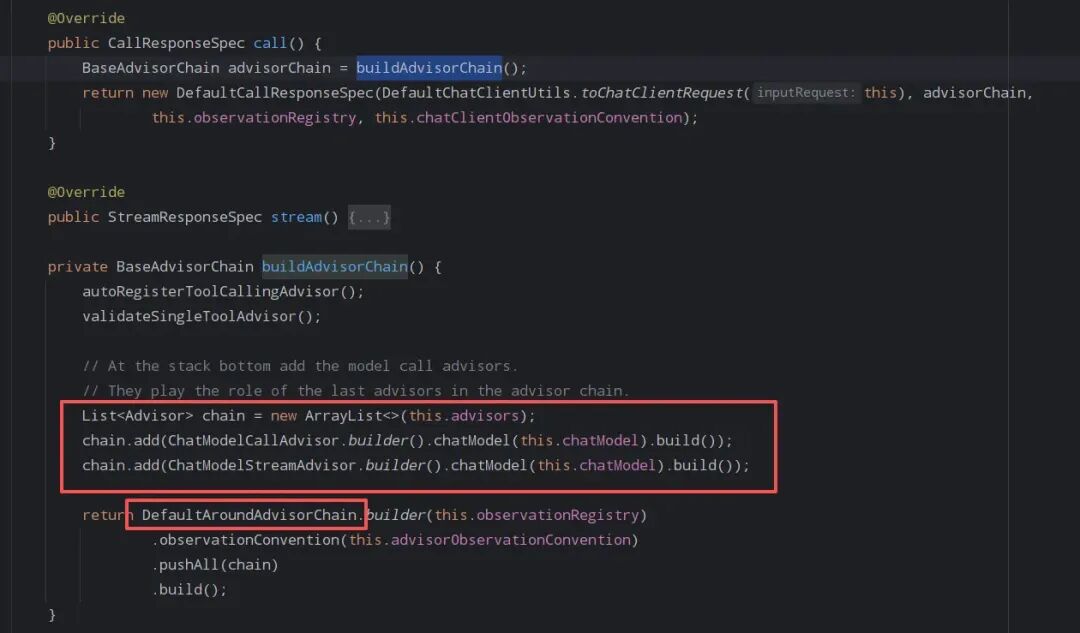
把调用 ChatModel 也做成一个 Advisor——ChatModelCallAdvisor,并在建链时自动追加到链尾(Ordered.LOWEST_PRECEDENCE)。
你没有配置任何 Advisor 时,链上依然至少有它。于是:
自定义 Advisor 与调模型走 同一套管线 ; 顺序用 getOrder()说话;同步 / 流式可以各有一套链( CallAdvisorvsStreamAdvisor),互不假装对称。
链如何往下传
DefaultAroundAdvisorChain.nextCall 的思路很 Spring:
从当前剩余 Advisor 队列里取出一个; 调用它的 adviseCall(request, chain);Advisor 若要继续,内部再调 chain.nextCall(...);链尾的 ChatModelCallAdvisor不再往后传,而是调chatModel.call(prompt),把结果包成ChatClientResponse返回。
这和 Filter 里必须 chain.doFilter、Gateway 里必须 chain.filter 是同一类契约:
扩展点负责自己的事,并决定是否交给下一环;框架负责按顺序把环串起来。
源码落点
位置 3:buildAdvisorChain
复制你配置的 advisors; chain.add(ChatModelCallAdvisor...);再 DefaultAroundAdvisorChain.builder().pushAll(chain).build()。
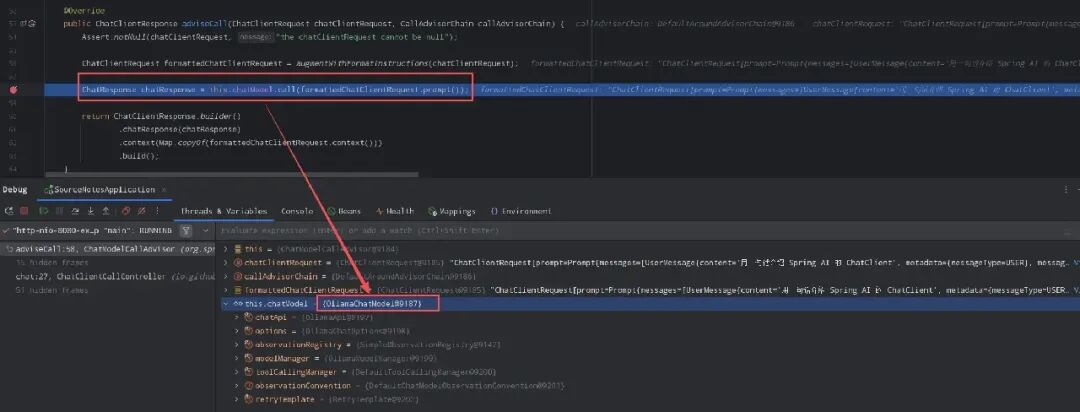
位置 4:ChatModelCallAdvisor#adviseCall
ChatResponse chatResponse = this.chatModel.call(formattedChatClientRequest.prompt());
运行时若 starter 是 Ollama,这里的 chatModel 实现类就是 OllamaChatModel。
应用层第一次跨到具体模型实现的分界线,就在这一行——之上谈的是可移植管道,之下才是厂商协议。
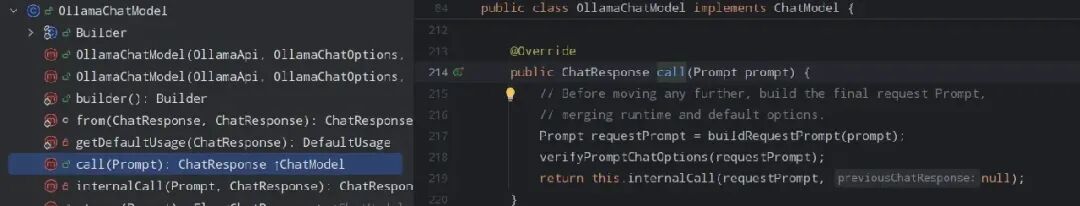
位置 5:OllamaChatModel#call(Prompt)
只为确认:厂商 HTTP、路径、JSON,都收敛在 ChatModel 实现里。
四、Prompt 何时成形,是否就是最终入参
要解决的问题
fluent API 上,system、user、messages、options、tool 是一点点叠上去的。
执行期需要一份稳定的 此次对话输入 ——这就是 Prompt(再被放进 ChatClientRequest)。
如果过早定稿,后面的 Advisor 没法改请求;
如果从不定稿,模型适配器就要去理解整棵 RequestSpec,可移植性会烂掉。
设计选择:两阶段
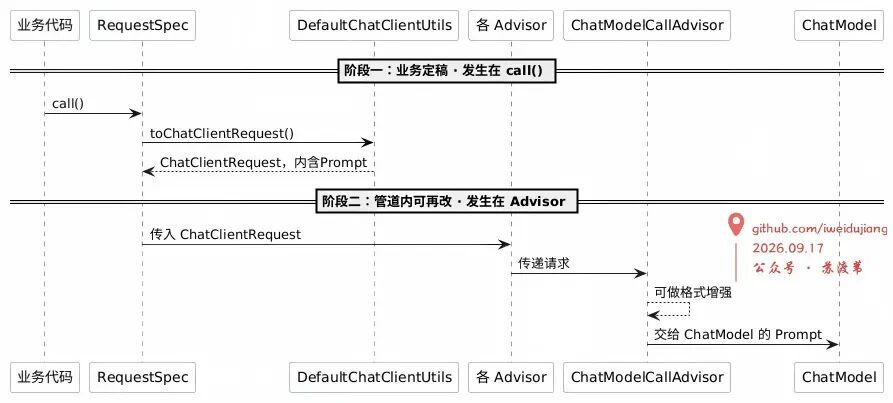
阶段一(业务定稿)
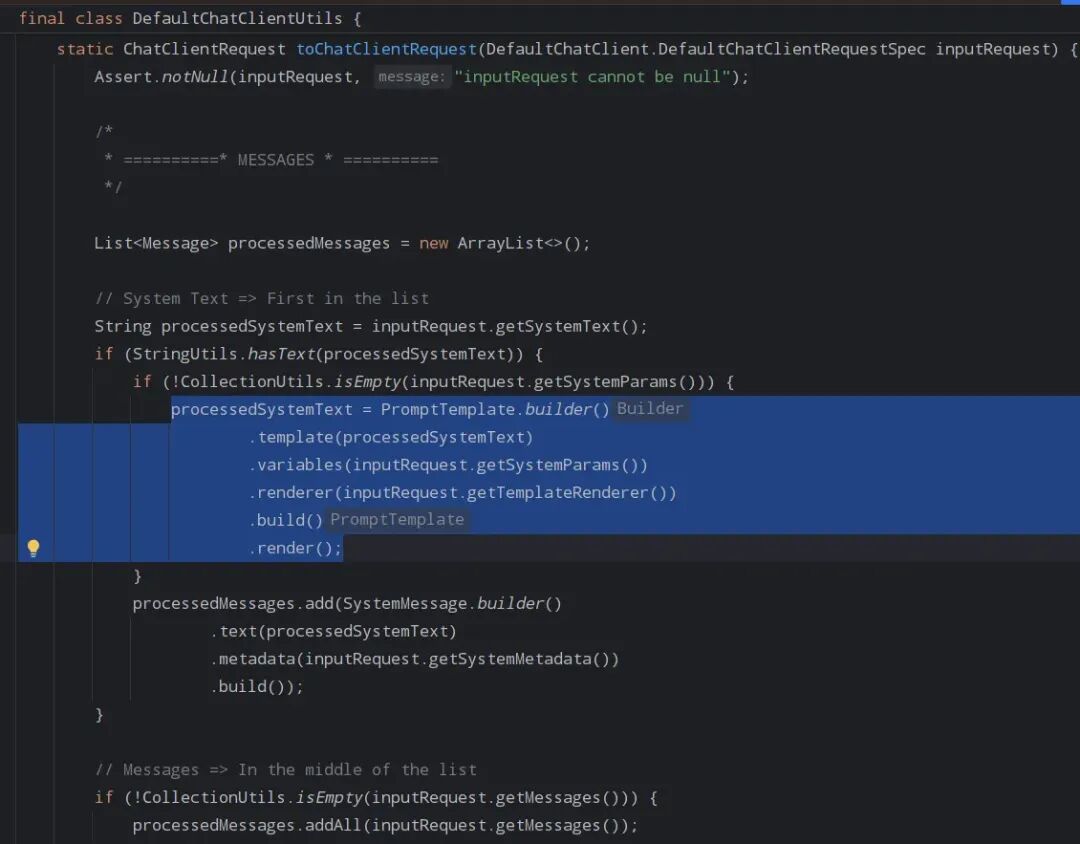
toChatClientRequest 把散装状态收成 Prompt:
system → SystemMessage(可走模板变量)已有 messages user → UserMessage(可走模板 + media)options(含 tool 等)
阶段二(管道内)
Advisor 仍可改 ChatClientRequest。链尾还可能 augmentWithFormatInstructions(结构化输出等场景会改写 user 文本或 options)。没有这类需求时,阶段二常等于原样传递——但机制上必须允许再改,否则 Advisor 模型不成立。
源码落点
位置 6:DefaultChatClientUtils.toChatClientRequest
五、返回值为什么要剥几层
要解决的问题
一次模型调用,框架侧至少要能表达:
多候选项(generation) 元数据(token、模型名……) Advisor 之间共享的 context 观测(Observation)需要的结构化响应
若 ChatModel 直接返回 String,上面这些只能靠 ThreadLocal 或副作用——那是退步。
设计选择
由内向外大致是:
ChatModel
  → ChatResponse                // 模型层:结果 + 元数据
       → Generation
            → Message.getText()

Advisor / ChatClient
  → ChatClientResponse          // 再包一层:ChatResponse + context

业务终端方法 content()
  → String                      // 只要正文时,剥到 getText()
.content() 走的路径是:
ChatResponse → getResult() → getOutput() → getText()
需要完整结果时用 chatResponse();需要带 context 的框架视图时看 ChatClientResponse。
对外 API 提供偏薄的便利方法,对内保留偏厚的结构——这和 ResponseEntity vs body() 是同一类权衡。
六、总览:一次同步调用的分层
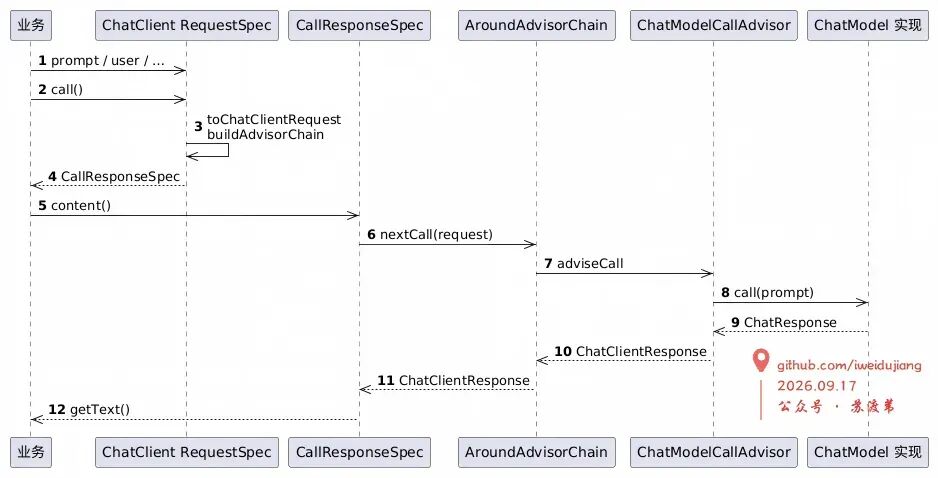
可与 Spring 对照着看:
ChatClient | RestClientWebClient 请求构建 |
call() | |
ChatModelCallAdvisor | |
ChatModel |
七、读源码复盘
以后碰到 Spring AI(以及类似框架),可以固定问四句:
哪一步是 build,哪一步是 run?
分清了,就不会在组装阶段找网络请求。
可扩展点挂在执行路径的哪一段?
这里是 Advisor;换项目可能是 Interceptor、HandlerChain、Event。
可移植边界画在哪?
这里是
ChatModel:之上应与厂商无关,之下才谈 HTTP/SDK。对外简化时,内部保留了什么?
content()很方便,但方便来自对ChatResponse的剥皮,不是模型只返回了字符串。
这几个问题搞懂了,一切就都通了。
八、小结
一次 prompt().user().call().content(),Spring AI 实际做了:
构建与执行分离—— call定稿请求并建链,终端方法才跑链;用 Advisor 统一横切与调模型—— ChatModel坐在链底,而不是旁路特判;Prompt 两阶段——业务先收束,管道仍可改,再交给可移植的 ChatModel;响应分层——对内结构完整,对外按需变薄。
下期预告:Advisor 的顺序契约、adviseCall 为什么必须(或何时不必)调用 chain.nextCall,以及自定义 Advisor 该插在链的哪一段。