ARTICLE · 1059165
Jev:一个不说话的 AI 模型,想接管软件里的"小判断"
Jev:一个不说话的 AI 模型,想接管软件里的“小判断”
TypeSafe AI · System One 模型 · 2026 年 9 月 15 日发布
今年的大模型发布,几乎都在比谁更会聊天、更会推理。TypeSafe AI 走了反方向:它的首个模型 Jev 一个句子都不写,只返回带概率的类型化决策,让代码直接拿去用。
创始人 Diogo Almeida 在发布文里抛出的问题很直接:模型在聊天上早已超越人类,那自动化都去哪儿了?
70–500ms 端到端响应 | $0.042 每百万输入 token | 免费 输出 token |
以上均为 TypeSafe 官方公布数据
01
Jev 是什么?
一句话:输入程序状态和一组类型化问题,Jev 一次并行回答所有问题,返回结构化的值和校准过的概率,而不是生成文字。
官方的比喻是“前沿智能级的函数调用”:非结构化状态进去,类型化的概率决策出来。也有开发者把它叫做“聪明的 if 语句”——普通代码能判断 order.total > 100,却判断不了“这条消息是不是很生气”。Jev 补的就是这块。
名字有两个出处。System One 来自卡尼曼《思考,快与慢》里快速、直觉的“系统 1”,与缓慢、审慎的“系统 2”相对。Jev 取自经济学家杰文斯(William Stanley Jevons)——蒸汽机效率提升反而让煤炭需求暴涨,TypeSafe 认为智能的成本每降一个数量级,就会解锁多个数量级的新用例。
背后的人也有分量:Diogo Almeida 在 OpenAI 参与了 RLHF 和 InstructGPT 的研究,也就是 ChatGPT 背后的方法。TypeSafe 隐身研发两年,发布时完成了由 DCVC 领投的 4000 万美元融资。
02
它和大语言模型差在哪?
核心区别在输出。LLM 一个 token 一个 token 地生成字符串,你还得解析、校验,并祈祷它没有幻觉或格式出错。Jev 预先定义好所有可能的答案,直接返回类型化的值,没有需要解析的东西,也从构造上杜绝了类型错误。
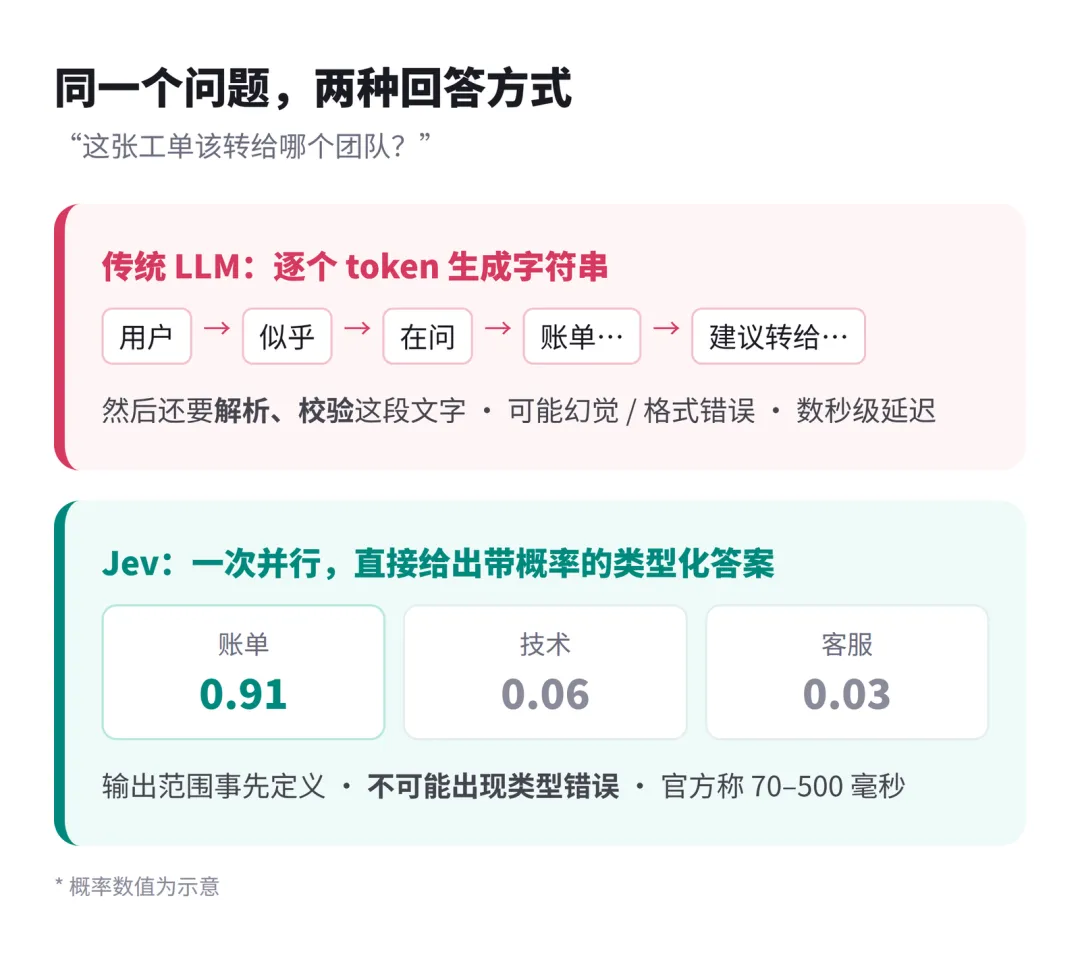
有两点最值得注意。第一是并行:一次请求里的所有问题同时评估,多加一个问题几乎不增加响应时间。第二是校准:TypeSafe 用自研的“校准决策强化学习”(RLCD)训练,让概率对齐真实结果,而不是讨好人类评审。
为什么校准这么重要?官方原话的意思是:一个模型 95% 的时候能做对,但不告诉你哪些是那 5%,这件事就没法自动化。
03
整个 API 只有三种问题
这是设计,不是限制
Choice · 多选一
从最多 255 个选项中选一个,返回选择、每个选项的概率和置信度。建议加一个 other 选项,让模型能说“都不合适”。
Score · 打分
在你用文字描述的 2–10 级量表上定位,结果可以落在两级之间,比如 1.4。
Noul · 是 / 否
一个是非问题,返回 0 到 1 之间的单一概率。
以一张客服工单为例,一次请求就能同时问三件事,然后用普通 if 语句组合结果:
// 示意结构,非官方 SDK 原样代码
state: "上周扣了两次费,我要退款!"
questions:
team → Choice[技术, 账单, 客服, other]
anger → Score[平静 … 非常愤怒]
refund → Noul("明确要求退款?")
if refund > 0.9 and team == 账单:
route_to_billing() # 高置信度,直接执行
04
实测:12 个自动化用例
来自 MindStudio 的测试整理
MindStudio 把 Jev 放进了一批分类密集型的真实工作流里,和 GPT、Claude 做对比。几个结果很有代表性:
其他值得一看的用例:
▸ 社区帖子打标签:流失风险、成员经验、推荐语质量
▸ X 实时信息流:Chrome 插件在帖子加载瞬间标注“突发”“干货”或“AI 水文”
▸ 比特币交易信号:机器人每秒重新判断一次涨 / 跌 / 持有
▸ 会议纪要归类:会议类型、是否做了决定、行动项是否有人负责
注意:那个比特币机器人在测试的第一个小时表现并不好。快,不等于判断准。
TypeSafe 官方也放了几个有趣的 demo:让 Jev 实时玩 Doom(每秒 10 次查询,约 7 美元一小时),以及“维基百科竞速”——每一步都要从成百上千个链接里选一个,正好体现高基数选择下“不幻觉”的复利优势。
05
它做不了什么
不会写:聊天、写代码、总结、头脑风暴、解释推理过程,统统不行。
没有世界知识:它只知道你喂给它的状态,不会去查资料。输入准备得好不好,直接决定上限。
上下文与模态有限:MindStudio 测试中上下文窗口为 64K token;目前只接受文本(字符串、JSON、文本数组),不支持图片、音频、视频。
校准是群体属性:它保证的是“大量预测里,高置信度对应高准确率”,不保证任何单个答案正确。
06
这些数字,要打个折看
官网首页写着“快 193.6 倍、便宜 444.6 倍”。难得的是,TypeSafe 自己在发布文里把附加说明写得很清楚:
▸ 评测是在西海岸团队自己的笔记本上跑的
▸ 无法证明定价没有补贴,需要时间检验
▸ 工作流不在训练集里,但由自家能力团队编写
▸ 以 GPT-6 Astra 和 Fable 5.1 的平均值作参考答案,本身带有偏向
▸ 193.6× / 444.6× 官方也认为偏向真实收益的上限
唯一难以反驳的:0% 类型错误。输出结构由 schema 保证,只要一个反例就能证伪——这也是它最有底气的一条。
07
正确用法:做决策层,而不是替代大模型
三篇文章给出的结论高度一致:Jev 负责便宜地分类和分流,普通代码处理能处理的部分,前沿大模型只接手少数难题——比如起草回复、总结选出来的评论主题。
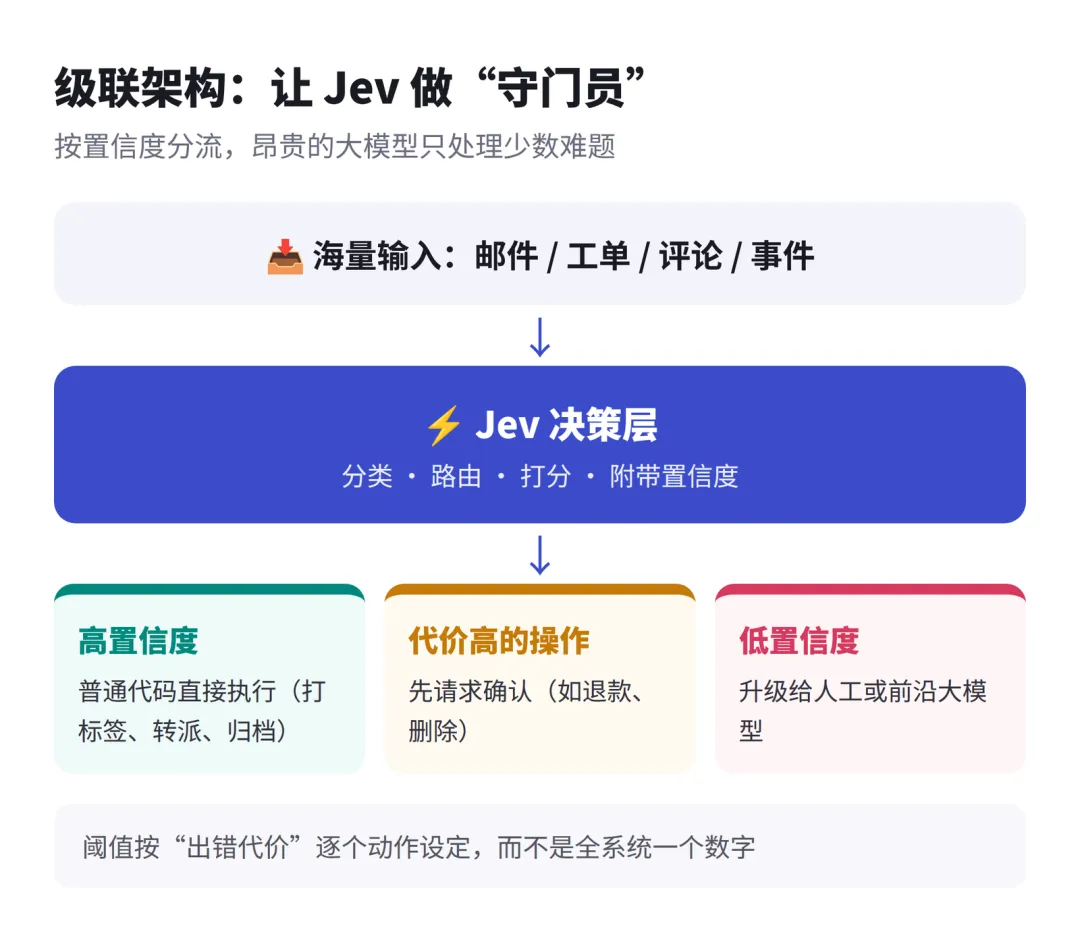
更进一步是“置信度门控”:不是全系统一个准确率阈值,而是每个动作按出错代价单独设阈值。便宜、只读的操作在高置信度时自动执行;代价高的先确认;置信度低就交给人或大模型。这样既省下大量 LLM 调用,也在“机器决定的”和“需要人看的”之间划出一条清晰、可审计的边界。
写在最后
Jev 是一个真正不同的思路:把 AI 做成函数调用的形状,而不是聊天机器人。如果它在厂商自测之外也站得住,那些尴尬地塞在 LLM 提示词里的千万个小判断,可能都会搬到 System One 模型上。但眼下它仍是早期访问、仅支持文本、性能数字均为自报。最稳妥的做法:挑一个窄而高频的决策,拿你现在的方案跟它比一比。
参考来源
· TypeSafe AI:Introducing System One Models & Jev(typesafe.ai/blog)
· Eigent:What Is Jev? TypeSafe AI's System One Model, Explained(eigent.ai/blog)
· MindStudio:12 Jev Use Cases Tested(mindstudio.ai/blog)