ARTICLE · 1059164
AI 的"小脑"来了:不会聊天的模型,正在改写 Agent 的成本结构
如果有一项技术,把 AI 做一次判断的成本砍到原来的 1/444,会发生什么?
2026 年 9 月 15 日,我们得到了第一个答案。一家名为 TypeSafe AI 的公司发布了一个叫 Jev 的模型——它不会聊天、不写文章、不生成任何文字,却在几天内刷遍了全球开发者的时间轴。
有人把它接进自己的系统后,第一件事是把 ChatGPT 的调用链砍掉了三分之二。
三天后,9 月 18 日,开源社区放出了它的免费克隆版 Laya:代码完全开源,可以下载到自己的电脑上跑,一分钱不花。
一个新品类,从诞生到被开源复刻,只隔了 72 小时。
这三天里到底发生了什么?它对做 AI 应用的人和投 AI 的人,分别意味着什么?
我们试着把这件事讲清楚。
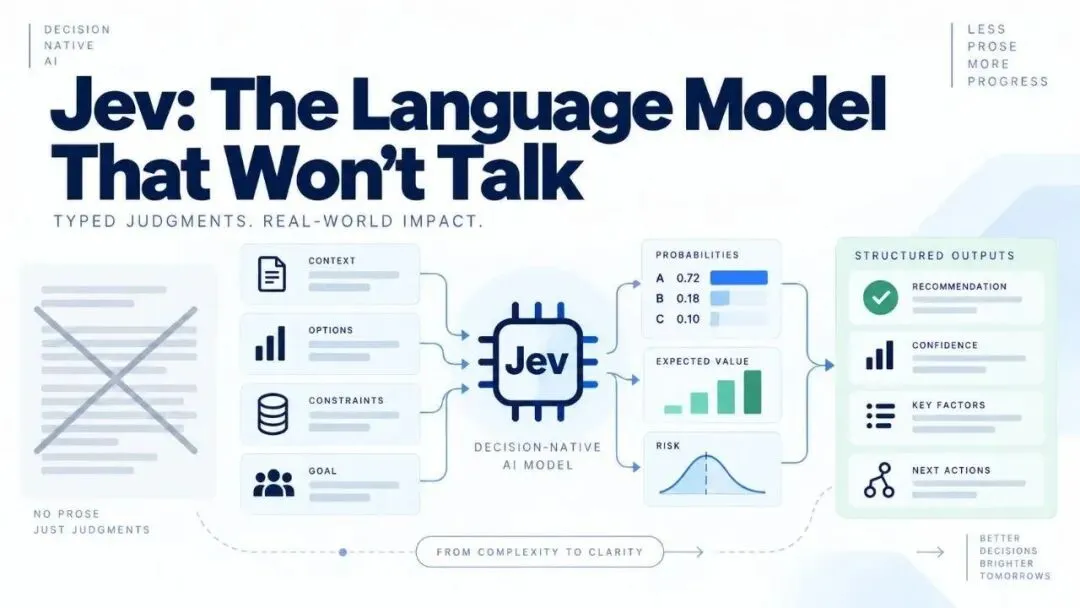 一、先认识一下这位"哑巴"
Jev 有一个很反直觉的特点:它根本不生成文本。
你给 ChatGPT 的,是一道作文题:"帮我分析这封客户邮件。"它洋洋洒洒写三百字,你的程序再从中提取结论、校验格式、防它跑题。
你给 Jev 的,是一道选择题。你把邮件原文丢给它,然后问几个固定格式的问题:
这个工单该归哪个部门?
紧急程度 0 到 10 分打几分?
客户是不是明确提出了退款要求?
它不写字、不解释、不客套,直接返回答案:"billing 部门,置信度 87%。"
因为跳过了"生成文字"这一步,官方给出的数据是:比传统大模型快约 193.6 倍,便宜约 444.6 倍——单次判断约 0.1 秒、成本约 0.008 美分。定价也很有意思:每百万输入 token 收 0.042 美元,输出免费。
值得一提的是这家公司本身的成色:创始人 Diogo Almeida 是前 OpenAI 核心研究员、ChatGPT 背后 RLHF 技术的联合发明人。公司刚拿到 DCVC 领投的 4000 万美元种子轮,Jev 已经接入了 Cloudflare、Vercel 和 OpenRouter。
一个不会说话的模型,凭什么让顶级机构和开发者集体下注?
二、问题的本质:我们一直都在用大模型干"小脑"的活
要理解 Jev,得先理解一个被忽视了三年的错配。
心理学家卡尼曼在《思考,快与慢》里把人脑分成两套系统:系统一是本能反应——手碰到烫杯子立刻缩回来,"这条消息看着像诈骗";系统二是深度思考——解奥数题、做战略规划。
过去三年,所有大模型都在卷系统二:参数越来越大,推理链越来越长,"深思熟虑"。
但一个 AI Agent 真正干活时,面对的绝大多数问题其实是系统一问题:这封邮件是不是垃圾邮件?这个工单转给哪个组?这个动作有没有风险?
问题在于,今天所有的 Agent,都在用大模型这个"大脑"去干"小脑"的活。
打个比方:你雇了一个时薪 2000 元的顶级咨询合伙人,日常工作却是让他分拣快递、给会议纪要贴标签。每一次"系统一"判断,都要完整调用一次大模型——先写几百字推理,再输出 JSON,程序再用正则校验三遍。一次判断,8 秒钟、1.4 美分。
一个客服系统,一天要发生几十万次这种判断。账单失控,延迟扛不住。
这就是为什么很多企业的 AI 项目"演示很惊艳,一上量就亏钱"。成本的大头从来不是深度推理,而是无数次微小的条件反射。
Jev 干的事,说白了就是:别让博士去做选择题。
三、真正的信号,不在模型里,在账本上
Jev 和 Laya 本身都还很小——品类诞生一周,所有性能数据均来自官方自报,尚无独立第三方复现。如果只看这两个模型,容易高估它的影响。
但如果你把它放进 AI 产业的账本里看,三个变化是实打实的。
第一,AI 应用栈正式分层,"判断层"成为新品类。
"大脑管复杂推理、小脑管海量反射"的架构一旦成立,AI 应用公司的成本模型就被改写了。原来一天数十万美元的判断类调用,理论上可以压到几百美元量级;延迟从 8 秒到 0.1 秒,意味着 AI 判断可以嵌入实时系统——机器人避障、交易风控、在线客服路由。
对 AI 应用公司毛利的重估,可能是这件事最直接的投资含义。
第二,杰文斯悖论:越便宜,用得越多。
Jev 这个名字是故意取的——19 世纪经济学家杰文斯发现:蒸汽机效率越高,煤炭总消耗反而越大。
单次判断便宜 444 倍之后,过去"不值得用 AI"的无数细小环节都会被点亮:这条推送要不要发?这个按钮放哪里?这条日志要不要报警?
判断的总量会爆炸式增长。对算力产业,这是"单价通缩、总量扩张"的经典剧本——而且请注意 Laya 这类模型只有 3-4 亿参数、CPU 就能跑:轻量推理正在从高端 GPU 集群下沉到端侧,这对端侧芯片和边缘推理,是一个真实的新增叙事。
第三,模型的护城河,正在以天为单位变薄。
Jev 发布 72 小时,开源重制版就出现了。这速度本身是个信号:模型层的"首创溢价"窗口期,正在从年压缩到天。
但 Laya 的故事还有另一面。细看它的数据:开箱即用的准确率只有 0.35——随机猜是 0.318,基本等于没比抛硬币强多少;那个漂亮的 0.766,是自己动手微调之后才跑出来的。而在高难度的复杂选择任务上,它反而被 Jev 大幅甩开(0.425 对 0.870)。Hacker News 上的开发者说得很直白:"我不想要自己管 GPU、不想标注数据,我就想要一个能直接用的好分类器。"
开源能复制模型的轮廓,复制不了开箱即用的体验、校准质量和工程积累。
这对一级市场是一个直接的拷问:当我们给一个"模型层"项目估值溢价时,它的壁垒到底在哪里?
四、泼一盆冷水
热闹看完了,说三句冷静的话。
其一,所有漂亮数字都还是官方口径。 快 193 倍、便宜 444 倍,目前没有任何独立第三方复现。新品类第一周的数据,看看就好。
其二,Jev 可能被大厂"功能内卷"吞掉。 OpenAI 的结构化输出、各家小模型都在往这个方向挤。它是新品类的开创者,还是大厂菜单上的一道前菜,现在下结论太早。
其三,Laya 的存在提醒我们:这个方向的技术门槛,可能没有你想象的那么高。如果判断层最终变成一项"commodity"能力,那么价值会流向掌握场景和数据的玩家,而不是模型本身。
五、写在最后
Jev 和 Laya 的体积都很小,但它们指向的方向很大。
过去三年,我们教会了 AI 说话;接下来三年,AI 要学会的第一件事,可能是什么时候闭嘴。
每一次分层,都是一次成本的重构;每一次成本的重构,都是一次格局的重排。 大脑与小脑的分工,在人体里用了上亿年进化出来——在 AI 身上,这个过程可能只需要几个季度。
值得盯紧的不是 Jev 本身,而是第一批把"小脑"用出成本优势的 AI 应用公司。它们的毛利拐点,会比任何 benchmark 都更早告诉我们:这个新品类到底成不成立。
你最关心的问题是什么? 如果你的公司正在用 Agent,欢迎评论区聊聊:判断类调用占了你们 AI 账单的几成?也欢迎转发给正在做 AI 应用的朋友——他们可能正为那张失控的账单发愁。
关于我们:高云资本,专注硬科技赛道的早期投资机构。关注我们,持续跟踪 AI 与半导体产业的一线变化。