ARTICLE · 1060751
中国AI软件瓶颈为何在私有化项目制
中国AI软件的核心瓶颈不在技术,而在私有化项目制切断了数据复利——模型越强,套壳越贬值,真正的出路是纵向合规闭环,而非横向规模复制。
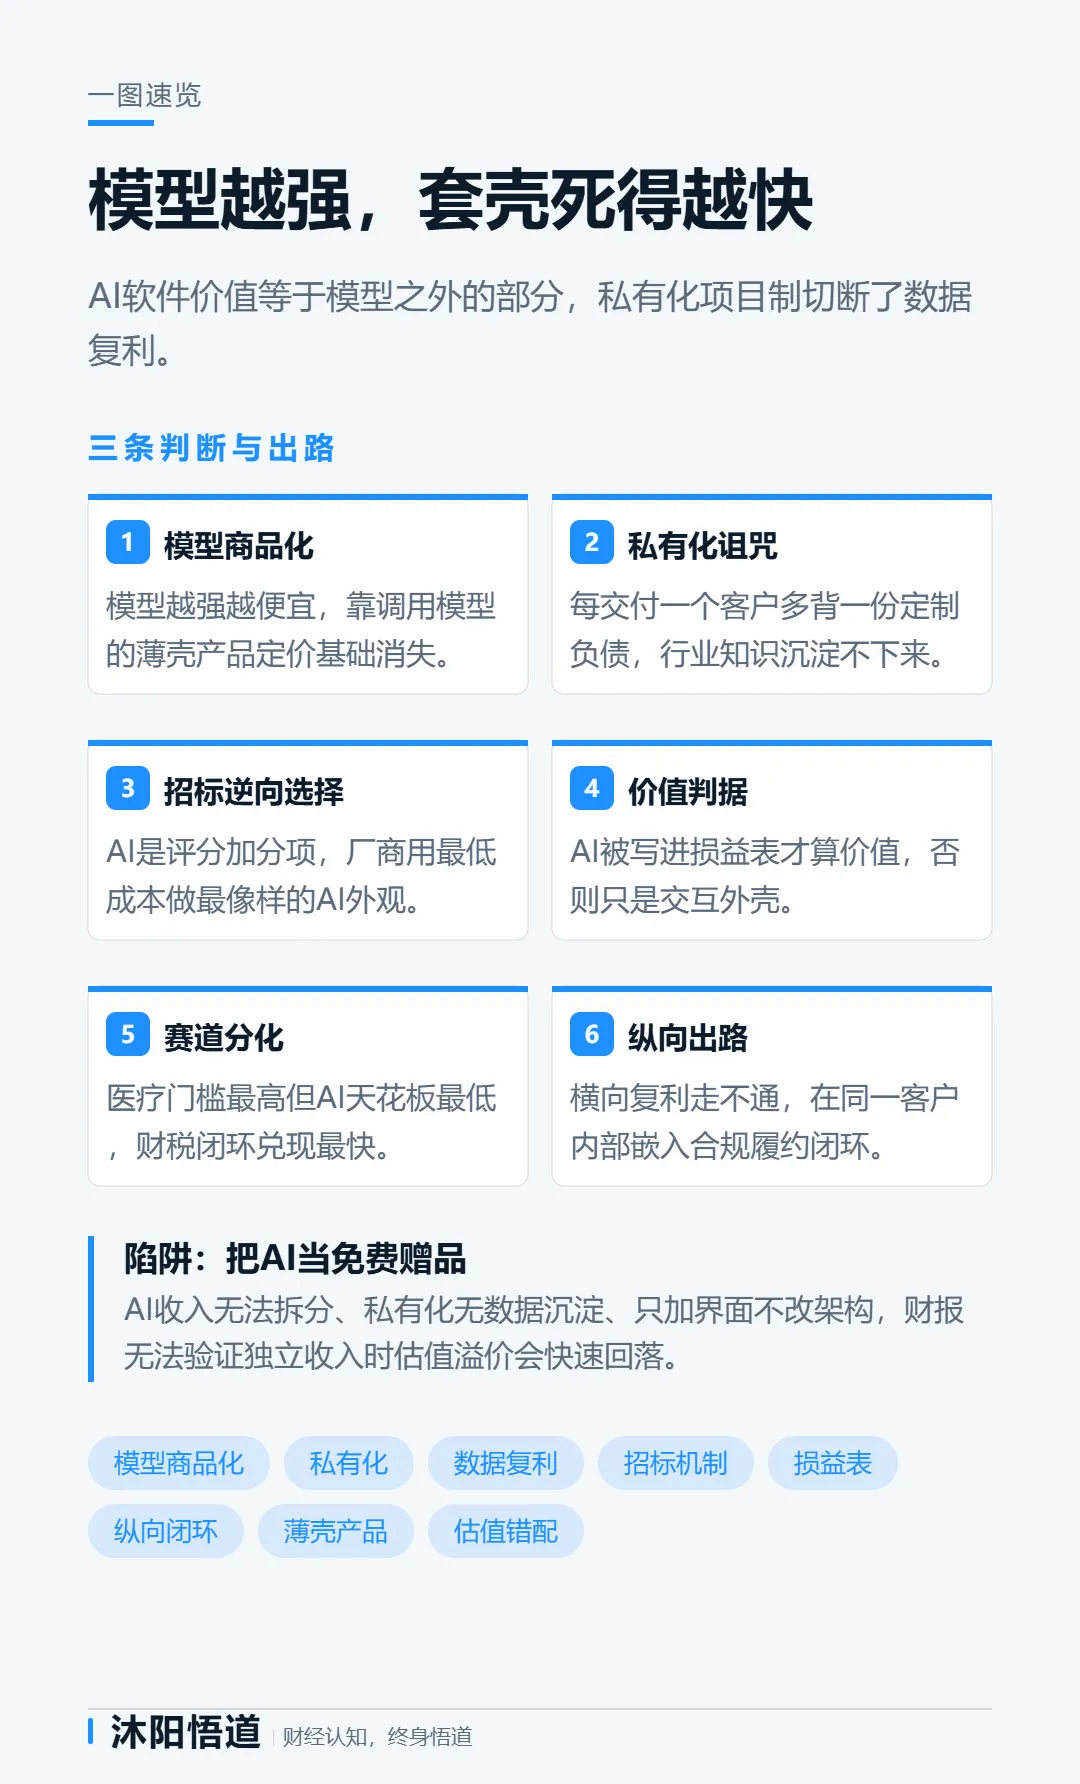
模型越强,套壳越死:AI软件的价值不在AI
行业里最流行的想象是:大模型越来越强,AI应用就越来越好做。
这个判断,方向是反的。
当模型能力变成一种公共品,任何靠调用模型形成的产品能力,都会同步贬值。薄壳产品的全部商业价值,建立在“模型能力稀缺”这个假设上;一旦假设不成立,定价基础就消失了。
真正随之增值的,是模型之外的部分:
业务数据
流程咬合
交易闭环
合规可靠性
这些东西不会因为模型变强而自动获得,也没法靠接口调用买来。
为什么重要?因为这解释了中国AI软件市场表面热闹、真正立得住的产品却很少——绝大多数产品,把全部身家押在了那个正在快速贬值的东西上。
深度与可复制性的天生对立:中国模式为何选了孤岛
AI软件最深的矛盾,几乎没有被说破:
深度和可复制性,天生互相排斥。
越深度嵌入客户业务流程,价值越高,但越难标准化复制到下一个客户。越标准化、越容易大规模复制,就越浅、越容易被替换。
海外SaaS之所以能同时拿到深度和规模,靠的是一个共享底座——所有客户跑在同一套系统上,深度沉淀在底座里,规模靠租户数扩张。
中国的私有化交付模式,把这个底座拆成了每一家客户各自的孤岛。
这不是战略选择,是模式宿命。
私有化交付:数据复利的入口被系统性切断
AI时代唯一能持续自我加强的护城河,是数据复利——产品用得越多,积累的业务数据越多,模型和产品就越好,客户就越离不开。
但这个循环需要一个前提:厂商能持续拿到高质量、可复用的业务数据。
中国的现实是:大客户普遍要求私有化部署、定制开发,数据留在客户本地。厂商交付完项目,拿到的是一个能跑的系统,而不是一份能沉淀的知识。
每来一个新客户,都要从零适配一遍。
于是出现一个荒诞的结果:项目数量在增加,护城河却没有变深。 十年做一百个项目,和十年做一个项目,在能力积累上可能没有本质差别。
这意味着什么?中国AI软件最大的结构性诅咒——它不缺订单,缺的是把订单变成资产的通道。
招标机制:一台逆向选择的放大器
如果说完付模式切断了数据复利,那么招标机制,则在需求端放大了错误的供给。
政企招投标普遍采用清单式打分,AI功能是一个加分项。厂商的理性策略因此变得非常清晰:
用最低的成本,做出最像样的AI外观。
加一个对话窗口、接一个文档摘要,评分表上的AI项就打满了。没有人会去追问:AI有没有参与业务的损益核算?
这构成了一种系统性的逆向选择:
招标制度在奖励薄壳,惩罚深度
把AI真正焊死进业务链路,成本高、周期长、风险大
而评分表上得到的加分,和做一个对话界面几乎一样
更隐蔽的代价在交付之后:大量AI功能上线即闲置,使用率偏低,客户也不愿为它单独付费。厂商的研发投入,最终变成了纯粹的成本。
这不是企业不努力,是激励机制在指引所有人走向同一个浅层解。
AI不参与损益,就不是价值
一个可以直接拿来筛选产品的判据:
AI有没有被写进业务的损益表?
如果AI的输出去决定了一个可以量化的经营指标——能耗、良品率、停机时长、坏账率、对账工时——那它就是价值。
如果它的输出只是让界面更好看、让文档更易读,那它就只是交互外壳。
AI的商业价值,不取决于它有多聪明,取决于它离损益表有多近。
这也是为什么大量宣称AI赋能的项目,财报里找不到对应的独立收入——因为它从来没被设计成能独立创造收入的东西。
三大赛道分化:医疗门槛最高,AI天花板最低
这里藏着一个反直觉的判断:
医疗是准入门槛最高的赛道,却是AI价值天花板被锁得最低的赛道。
合规壁垒保护了在位者,同时也把AI的商业化空间钉死了。高门槛,从来不等于高价值。
而财税赛道之所以商业化兑现最快,原因很朴素——它有天然的票据、资金、申报交易闭环,规则清晰、风险可控、投入产出容易测算。
有闭环的地方,AI才有地方落地。
中国版本的出路:纵向合规闭环替代横向数据复利
既然横向的数据复利(多客户共享一个底座)在中国做不出来,那出路在哪?
答案不在横向,在纵向:在同一家客户内部,把AI嵌得越来越深,绑定它的交易与合规履约闭环。
横向复利:靠租户数堆起来
纵向复利:靠单客户的深度堆起来
这条路之所以成立,因为它踩中了中国市场的两个真实付费意愿:
因此,中国AI软件最值得扎根的缝隙,不是比大模型更聪明,而是比大模型更可信——带有独立校验、异常拦截、人工复核机制的AI系统。
在高风险业务里,单纯的生成式能力满足不了需求,而可审计的可靠性,是国产厂商可以建立真实壁垒的地方。
不要去做那个跟着模型升级、随时可能被替代的智能外壳,去做那个模型升级也替代不了的、敢于为业务结果负责的闭环。
三个最锋利的判断
第一,模型越强,越该做模型之外的事,而不是更用力地接入模型。
模型能力商品化是不可逆的。继续把产品价值押在调用模型上的企业,会在每一轮模型升级中贬值一次。真正该做的,是把AI焊进业务,让模型升级自动变成产品升级。
第二,招标机制在系统性奖励薄壳,这是需求侧的制度缺陷,不是企业的道德问题。
只要AI仍然是评分表上的加分项、而不是损益表上的独立科目,理性厂商就会继续做最便宜的AI外观。改善的钥匙在客户侧的采购标准,不在厂商的技术能力。
第三,中国AI软件真正的机会,是被合规和可靠性逼出来的那些最难做的活。
横向数据复利走不通,纵向合规闭环却走得通,而且它能同时拿到政策溢价和客户付费意愿。最脏最累最需要为结果负责的场景,恰恰是最不容易被套壳替代的地方。
甄别框架与风险清单
判断一个AI软件产品是否具备长期价值,看五条:
AI是否嵌入核心业务链路,而不是独立的交互窗口 能否沉淀场景私有的业务数据,形成持续迭代的闭环 AI产出的价值能否量化,对应到成本下降或收益提升的具体指标 是否内置业务规则校验、异常拦截、人工复核机制 AI增值服务能否独立定价收费,而不是打包在项目里免费赠送
同时高度警惕五类薄壳特征:
AI只做问答和文档摘要,不影响业务结果
私有化交付却沉淀不下可复用数据
AI收入无法拆分,作为免费附加功能交付
底层业务架构长期不变,只加了一层界面
只能笼统描述提升效率,说不出一个具体数字
风险端还要正视四件事:
总结与展望
中国AI软件产业的瓶颈,从来不是技术,而是模式。模型在飞快变强,而这个行业最缺的东西——可复用的业务数据、咬合到损益表的闭环、敢于为结果负责的可靠性——一样都没法靠调用接口买来。
下一个五年,赢家不会是接入模型最快的那个,而是把AI交付成可量化业务结果、并且在私有化与合规的约束里,仍然能把每一次交付沉淀成资产的那个。
模型会继续变强。而变强这件事,只会让套壳更便宜,让深度更值钱。