ARTICLE · 1081117
别急着上向量库:你的AI应用真的需要它吗?
当我们向AI提问时,看起来都是在“找答案”。
但下面三个问题,其实完全不同:
01 “这条报错在哪份文档里出现过?”
02 “这个商品现在还有多少库存?”
03 “公司有没有与远程办公相关的制度?”
第一个问题要找准确原文,第二个要查询实时数据,第三个要理解不同说法之间的含义。它们需要的,并不是同一种搜索方式。
可现实中,不少团队一开始做AI知识助手,就会直接采用文档切片、Embedding和向量数据库。Embedding可以简单理解为:把文字转换成一组可以比较的数字,让系统按照“意思是否接近”来搜索内容。
向量检索当然有价值,但在采购向量数据库、搭建索引之前,还有一个更基础的问题值得先回答:用户究竟想从资料中找到什么?
这个问题之所以值得重新讨论,是因为近期两项AI检索研究观察到了一个有些反常识的现象:在部分任务中,更复杂的语义检索,并不一定比简单的原文搜索更准确。
一项研究关注AI如何从长期对话中寻找信息,另一项研究关注AI如何在大型代码库中定位相关代码。场景虽然不同,却都提示了同一个问题:检索方式没有绝对的高下,关键在于AI究竟要找什么。
简单搜索,为什么仍然有效?
两项研究都考察了grep式检索。这里的grep,可以简单理解成一种“按原文查找”的工具:输入一个词、一段报错或一个名称,它就去大量文本中寻找匹配内容。
在长期对话记忆实验中,grep总体上取得了更高的准确率;在代码库研究中,让AI自己生成搜索指令、再按原文寻找代码,也表现出了很强的竞争力。研究还发现,最终效果不仅取决于使用哪一种搜索方式,也受到AI如何调用工具、阅读结果和继续追查的影响。
这些结果并不能证明“grep永远优于向量检索”,更不能直接推广到所有AI应用。它们真正挑战的是一个常见预设:只要给AI搜索资料,向量检索就天然是更先进、更可靠的选择。
为什么一个看起来“不懂语义”的工具,仍能发挥作用?
因为很多时候,AI不是在找“意思差不多”的内容,而是在找一个准确出现过的事实。
找原文和找含义,是两种不同的任务
假设系统正在排查一条错误码:ERR_CONNECTION_RESET。
用户通常希望找到这串字符出现在哪份日志、哪段代码或者哪篇排障文档中。此时,精确匹配直接、可验证,也不容易被相似内容干扰。
但如果用户问:“公司允许在家办公吗?”制度文件里可能没有“在家办公”这几个字,只写了“员工可申请远程工作”。关键词检索可能因此漏掉相关内容,向量检索却能识别两种表达在语义上的联系。
向量检索解决的是表达差异。它适合概念性问题、开放式问答和相似案例搜索。但它寻找的是“相似”,而相似并不天然等于正确。
在核对错误码、产品型号、合同编号或条款原文时,一段“很像”的内容可能比没有结果更难察觉。因为大模型仍可能据此生成一个流畅、合理,却并不准确的答案。
不用向量数据库,不等于不用RAG
很多人习惯把RAG和向量数据库画上等号。所谓RAG,简单来说,就是AI回答问题之前,先到外部资料中查找依据。至于使用哪种检索方式,并没有唯一答案。
它可以使用向量检索,也可以使用关键词搜索、全文检索、SQL、业务API或知识图谱。
论文把使用grep完成这一过程的方案称为GrepRAG。它依然属于检索增强生成,改变的只是检索器:系统让AI分析任务、生成搜索指令,再通过原文匹配取得相关内容。
Agent可以先判断问题类型,再决定搜索什么;第一次结果不理想,还可以更换关键词、缩小范围或换用其他工具。系统的智能,不一定全部来自更复杂的数据库,也来自它如何组织和使用工具。
先判断:用户到底在找什么?
在讨论技术方案前,可以先把检索需求分成三类。
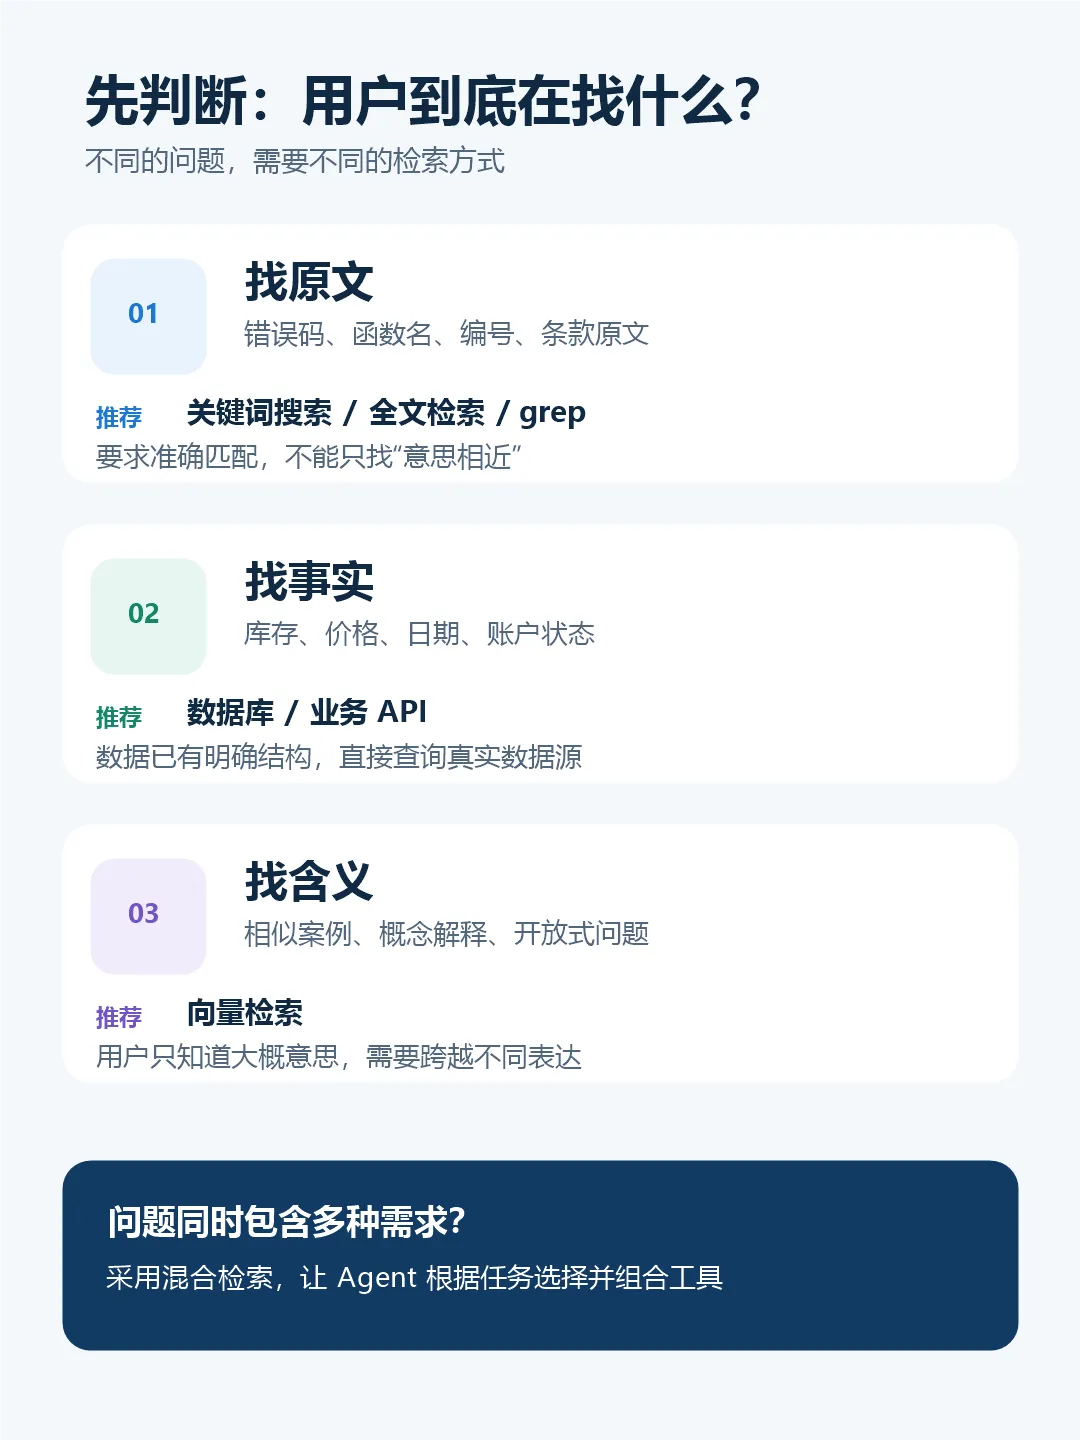
找原文:错误码、函数名、编号和条款原文,优先考虑关键词、全文检索或grep。
找事实:库存、价格、日期和账户状态,信息本来就在业务系统中,应直接查询数据库或API,而不是先把它们做成向量。
找含义:相似案例、概念解释和开放式问题,用户只知道大概意思,向量检索更能发挥价值。
现实中的问题可能同时包含三种需求。成熟的系统往往不会只选择一个检索器,而是组合多种方式:发现错误码时精确搜索,遇到模糊问题时语义检索,涉及实时数据时调用业务系统。
检索设计的起点,不是数据库
前面提到的研究,一项关注长期对话记忆,另一项关注代码库补全。它们的实验场景不同,因此不能简单得出“所有AI应用都应该使用grep”的结论。
但它们共同提醒我们:检索效果不仅取决于检索器,还取决于任务特点,以及AI如何调用、阅读和验证结果。
向量数据库没有过时,它仍然是语义检索的重要基础设施。但它也不应该成为所有AI应用未经判断的默认配置。
当问题要求寻找准确原文时,词法检索可能更可靠;当问题涉及实时、结构化事实时,应查询真实数据源;当用户只能描述模糊意图时,向量检索才真正体现价值。
所以,在设计下一套AI应用时,不妨先别急着问:“我们应该选择哪一个向量数据库?”
先问一个更重要的问题:
我们的用户,到底想找什么?
检索设计的起点,从来不是数据库,而是问题。