ARTICLE · 1081416
主流AI infras软件栈: CANN架构及其与ROCm/CUDA架构对比分析与研究
摘要
本文从系统架构角度对华为CANN(Compute Architecture for Neural Networks)、AMD ROCm(Radeon Open Compute)与NVIDIA CUDA三大AI计算软件栈进行对比分析,涵盖硬件抽象层、编译执行模型、算子调度机制、内存管理与集合通信架构。分析聚焦于三者在"图编译-任务下发-硬件执行"这一核心链路上的设计取舍差异。
1. 引言
三大软件栈服务于结构迥异的硬件后端:CANN对应昇腾(Ascend)达芬奇(Da Vinci)架构NPU,CUDA对应NVIDIA GPU的SIMT流多处理器架构,ROCm对应AMD CDNA/RDNA架构GPU。硬件基础的差异直接决定了各自软件栈的分层方式与优化重点:
• NVIDIA GPU:SIMT模型,warp级线程调度,通用性强,生态最成熟 • AMD GPU:wavefront模型(64线程/wavefront,CDNA),架构上与NVIDIA GPU同源(都是通用众核SIMT),因此ROCm可通过HIP实现对CUDA近乎源码级的映射 • 昇腾NPU:达芬奇架构是专用AI加速核,三引擎异构设计(Cube/Vector/Scalar),本质上不是SIMT架构,而是更接近"可编程DSA(Domain Specific Architecture)",因此CANN无法走"翻译层"路线,必须自建完整的图编译与调度体系
这一硬件基础差异是理解三者软件栈设计分野的关键起点。
2. 三大软件栈分层总览
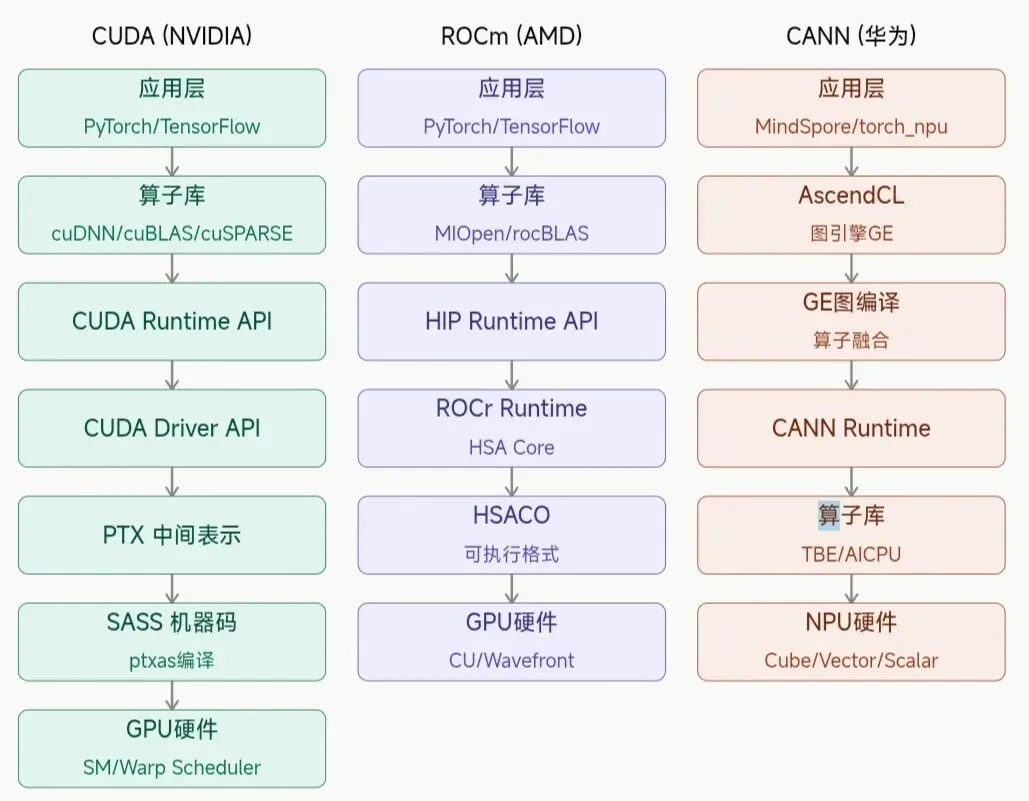
三者最显著的结构差异在于:CUDA与ROCm本质上是"运行时驱动的动态调度"模型,而CANN在核心链路上强制引入了图编译(Graph Engine, GE)作为中间层,这是理解三者性能特征与易用性权衡的第一把钥匙。
3. CANN架构详解
3.1 达芬奇架构硬件基础
达芬奇核心(Ascend AI Core)采用三引擎异构设计:
三引擎通过片上Buffer(L0A/L0B/L0C、UB统一缓冲区)与Queue机制协同,数据需要显式地在L1→L0A/L0B→Cube→L0C→UB路径上流动,这一点与GPU的Register File + Shared Memory + L1/L2隐式缓存层级有本质区别——达芬奇架构的片上存储更接近"可编程暂存器(Scratchpad)",需要编译器/算子开发者显式管理数据搬运,而非硬件自动缓存。
3.2 软件栈分层
CANN的核心链路可概括为:
框架层 (MindSpore/PyTorch+torch_npu)
    ↓
AscendCL(Ascend Computing Language,等价于CUDA Driver API的对外接口)
    ↓
GE 图引擎(Graph Engine)—— 图优化、算子融合、内存分配、任务编排
    ↓
CANN Runtime —— Stream/Event管理、Task下发
    ↓
算子库:TBE(Tensor Boost Engine,基于TVM衍生的算子自动生成框架)+ AICPU(处理Cube/Vector无法覆盖的自定义算子)
    ↓
Driver(昇腾驱动,管理设备内存、DMA、中断)关键机制:GE图引擎是CANN区别于CUDA/ROCm的核心设计。GE在离线阶段(或首次执行时)对计算图进行:
• 算子融合(Buffer Fusion / UB Fusion):将多个小算子融合为一个大Kernel,减少Launch开销与UB搬入搬出次数 • 内存复用分析(生命周期分析,静态分配显存地址) • Task编排:将图转换为一系列Task(含Kernel Launch Task、内存拷贝Task、同步Task),打包为一个可重复下发的"Task Graph"
这使得CANN在推理场景下能够将整个模型编译为一张静态Task图,一次下发、循环执行,Host侧调度开销远低于逐算子下发的CUDA Runtime调用模式,这一点在效果上接近CUDA Graph,但CANN默认即走图模式,而CUDA Graph是可选的性能优化路径。
3.3 动态图支持(AscendCL动态shape/PyTorch Ascend适配)
为支持PyTorch这类动态图/Eager模式框架,CANN提供了torch_npu适配层,在Eager模式下逐算子下发(走AscendCL直接调用TBE算子),但性能通常弱于图模式,官方也推动通过torch.compile/图模式捕获(类似TorchDynamo+GE联合编译)来弥合动态图的调度开销问题。
4. CUDA架构详解
4.1 硬件基础
NVIDIA GPU采用SIMT(Single Instruction Multiple Thread)架构,SM内部以warp(32线程)为调度粒度,多个warp通过warp scheduler实现零开销上下文切换以掩盖访存延迟。Tensor Core作为SM内嵌的矩阵乘加固定功能单元(自Volta起),与达芬奇Cube Unit功能类似,但集成粒度更细(每个SM内嵌多个Tensor Core,与CUDA Core共享调度)。
4.2 编译执行链路
CUDA C++ 源码
    ↓ nvcc前端
PTX(虚拟ISA,架构无关中间表示,类似LLVM IR但保留GPU语义)
    ↓ ptxas(可在编译时或运行时JIT)
SASS(目标架构机器码,与具体计算能力Compute Capability绑定)
    ↓
CUDA Driver 加载执行,CUDA Runtime做上层封装(Stream/Context管理)
CUDA Driver API与Runtime API是两层不同抽象:Driver API(cuLaunchKernel等)提供细粒度Context/Module管理,Runtime API(cudaLaunchKernel)做了隐式Context初始化的封装,绝大多数框架使用Runtime API。
4.3 Kernel Launch与调度模型
CUDA默认是逐Kernel下发模型:每次kernel<<<>>>()调用都是一次独立的Host→Device提交(通过Stream排队,GPU侧由硬件Queue/CWD—Compute Work Distributor调度到SM)。这带来的Launch开销(微秒级)在小算子密集的场景(如小Batch推理、RNN类模型)会成为瓶颈,这也是CUDA Graph(自CUDA 10引入)的动机——将一系列Kernel Launch"录制"为一张静态图,一次性提交,从而分摊Launch开销,其设计目标与CANN的GE图模式在效果上趋同,但CUDA Graph是运行时可选的性能特性,而非默认执行路径。
5. ROCm架构详解
5.1 硬件基础
AMD GPU分为面向数据中心的CDNA(如MI300X)与面向消费级/图形的RDNA。CDNA架构中CU(Compute Unit)以wavefront(64线程,注意是64而非NVIDIA的32)为调度粒度,MI300系列引入Matrix Core(MFMA指令,Matrix Fused Multiply Add)对标Tensor Core。
5.2 软件栈与HIP的关键定位
ROCm的核心设计哲学是"源码级可移植":HIP(Heterogeneous-computing Interface for Portability)在API层几乎是CUDA Runtime API的镜像(hipMalloc ↔ cudaMalloc,hipLaunchKernelGGL ↔ CUDA kernel launch语法),使得大量CUDA代码可以通过hipify工具近乎自动转换。
HIP C++源码(或hipify转换后的CUDA代码)
    ↓ HIP-Clang(基于LLVM/Clang)
    ↓ 对NVIDIA后端: 编译为CUDA调用(thin wrapper)
    ↓ 对AMD后端: 编译为LLVM AMDGPU目标码
HSACO(Heterogeneous System Architecture Code Object,ELF格式可执行文件)
    ↓
ROCr Runtime(基于HSA标准的运行时,管理Queue、Signal、内存)
    ↓
ROCt(Thunk层,直接系统调用接口,对接内核驱动amdgpu/amdkfd)HSA架构是ROCm与CUDA/CANN的本质不同点:HSA是一个开放标准(HSA Foundation制定),定义了统一虚拟地址空间、用户态Queue直接提交(AQL - Architected Queue Language)、跨设备一致性内存模型等,ROCr Runtime是这一标准的具体实现。相较之下,CUDA Driver与CANN Runtime都是各自厂商的私有实现,未遵循任何跨厂商标准。
5.3 算子库与图编译支持
rocBLAS/MIOpen对标cuBLAS/cuDNN,但历史上性能调优覆盖度不及NVIDIA对应库(尤其在长尾shape、非典型Batch场景)。图编译层面,ROCm本身不提供类似GE的强制图引擎,而是依赖上层框架(PyTorch的torch.compile后端TorchInductor/AITemplate等)在框架层面做图捕获与Kernel融合,这与CUDA的路径接近——图编译能力被"上移"到框架层而非驱动运行时层。
6. 三者核心机制对比
6.1 编程模型抽象层级对比
| 强制内建 | |||
6.2 任务下发与执行模型对比
值得注意的是ROCr的AQL Queue机制允许用户态直接提交任务(无需每次陷入内核态),这是HSA标准的核心设计之一,理论上Launch开销比CUDA的传统提交路径更低;但CANN的策略是从根本上减少提交次数(整图一次下发),两者是不同维度的优化路径。
6.3 集合通信库对比
三者在集合通信算法层面(Ring-AllReduce、Tree-AllReduce、以及针对大规模MoE场景的层次化通信)已趋同,差异主要体现在底层互联硬件与拓扑发现机制的具体实现上。
7. 深层架构差异:图编译哲学的分野
这是三者最本质的设计差异,值得展开:
CUDA/ROCm的立场:GPU的SIMT模型足够通用(几乎可以视为带SIMD扩展的众核CPU),因此运行时可以做到"逐Kernel灵活下发",图编译(CUDA Graph)被设计为一种性能优化的补充手段,而非必需路径——大部分训练场景仍然是Eager执行。这一设计哲学的代价是灵活性优先,损失了部分Host-Device协同调度效率。
CANN的立场:达芬奇NPU的Cube/Vector/Scalar三引擎协同执行需要精细的数据搬运编排(L1→L0A/L0B→UB路径),若采用CUDA式的逐Kernel细粒度下发,Scalar Unit的指令调度与显式Buffer管理开销会远高于GPU的隐式缓存机制。因此CANN必须在编译期(GE阶段)就完成算子融合、Buffer生命周期分析与Task编排,将"如何高效使用三引擎"这一复杂问题转移到编译器而非运行时,这是一种编译期确定性换取运行时效率的设计取舍,代价是对动态Shape、复杂控制流(如很多NLP模型中的动态长度)的支持天然弱于CUDA/ROCm的Eager模式,需要额外的动态图适配层(如torch_npu)来弥补。
8. 生态成熟度与开放性
• CUDA:生态壁垒最深,cuDNN/cuBLAS/TensorRT/Triton等长尾算子与融合Kernel覆盖度最高,几乎所有AI框架的首要后端 • ROCm:受益于HIP的源码兼容策略与HSA开放标准,移植成本相对较低,MI300X等硬件在大模型训练场景已具备一定竞争力,但长尾算子覆盖度与调优深度仍落后于CUDA • CANN:完全自建生态(TBE算子库、GE图引擎、AscendCL),需要MindSpore/ torch_npu适配层弥合与主流框架生态的差距,算子覆盖度与动态图性能是当前主要短板,但在图模式推理场景下的编译期优化potential较大
9. 结论
三大软件栈的分层设计差异根本上源于硬件架构的差异:CUDA与ROCm服务于同构的SIMT众核GPU,因此可以采用相近的"运行时驱动+可选图优化"模型(ROCm甚至可以通过HIP实现API级映射);而CANN服务于异构专用引擎(Cube/Vector/Scalar)的达芬奇NPU,架构复杂度要求图编译成为强制的核心链路。理解这一根本差异,是评估三者在不同场景(大规模训练 vs 边缘推理 vs 动态图友好度)适用性的关键出发点。
TODO: 深入研究GE图引擎的Buffer Fusion机制细节,HCCL的SDMA搬运路径