ARTICLE · 1084704
别再往 Jenkins 上堆插件了:12.4k star 的 Openship 两条命令部署 K8s,但有 3 件事它替不了
别再往 Jenkins 上堆插件了:12.4k star 的 Openship 两条命令部署 K8s,但有 3 件事它替不了
一、周三下午,Jenkins 又黄了
周三下午三点,Jenkins 构建队列从 3 个排到 17 个。
📌 本文关键词:Jenkins、Openship、CI/CD、K8s、自托管部署,这些是运维中高频踩坑的技术点。
打开页面一看:Disk space is below threshold。翻日志,是某次构建往工作区里塞了个 40G 的中间产物,没人清理。磁盘清了,构建恢复,队列消化掉——花了四十分钟,三个人在群里盯着。
这不是第一次。上个月是插件版本冲突导致流水线全部报 No such DSL method;上上个月是 Jenkins 自己 OOM,因为 JVM 堆没调,默认吃了宿主机一半内存。
每次都能修好。但每次修完,我心里都在问同一个问题:
我们真的需要一个通用自动化引擎,来干「把代码部署到服务器」这一件事吗?
这篇讲清楚三件事:Openship 到底替你干了什么;它的 Kubernetes 能力边界在哪(这里有一个几乎所有对比文都写错的地方);以及它替你不了的三件事——这三件事决定了你到底该不该动 Jenkins。
金句:把一个通用引擎用成专用工具,代价不是配置量,是你永远得有一两个懂它的人。
二、反常识:问题不是 Jenkins 慢,是它太通用
先说一个反常识的结论:Jenkins 慢,从来不是它的问题。
它的问题在于定位——Jenkins 的官方定位是「通用自动化任务与 CI/CD 管道编排引擎」。通用意味着两件事:
一是你得自己描述一切。构建命令、缓存策略、制品归档、镜像构建、推送、部署、回滚,全部要你在 Jenkinsfile 里逐条写出来。它不猜,也不替你决定。
二是能力靠插件拼。Kubernetes 部署?装 kubernetes-plugin。回滚?装插件或者手写 shell。通知?再装一个。插件之间版本互相咬,升级要排队做兼容测试。
现在换一个角度想:如果一个平台的唯一目的就是「代码进来,应用跑起来」,而且它把构建、运行、路由、证书全包了,会发生什么?
Openship 官方 README 的第一句话就是这个思路(原文引用,附翻译):
Point it at a repo — it builds, ships, routes, and TLS-terminates your app.翻译:把它指向一个仓库,构建、发布、路由、TLS 终止这几件事它全包。
金句:Jenkins 给你一套积木,Openship 给你一间装修好的房子——但积木能盖的楼,房子长不出来。
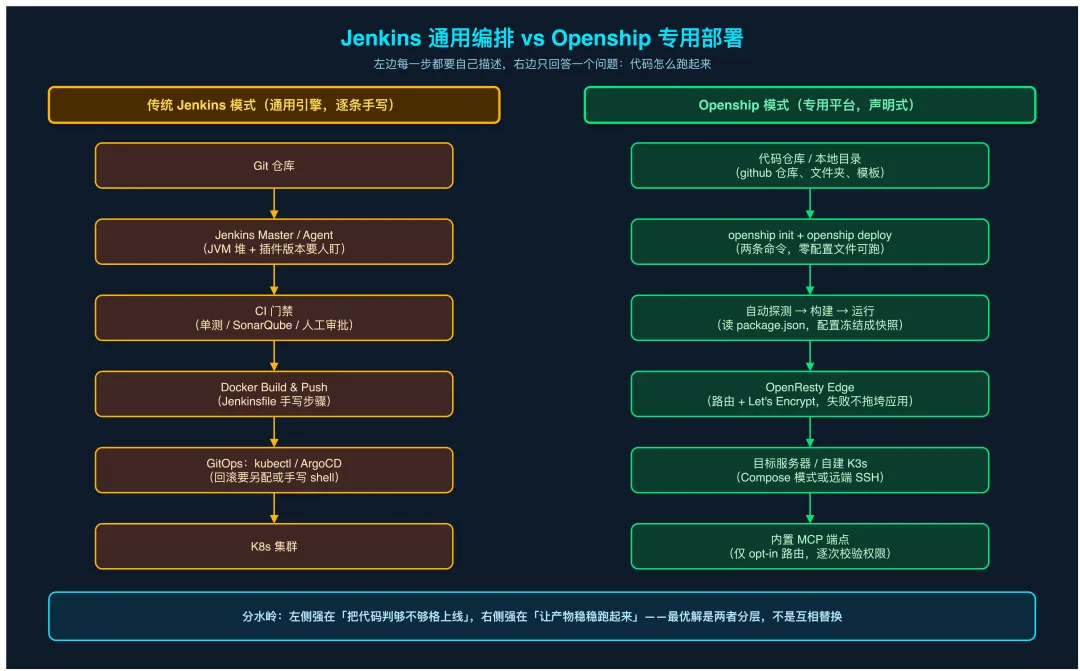
Jenkins 通用编排 vs Openship 专用部署架构对比
三、先把家底核实一遍
写对比文最怕的就是「听说」。这篇里所有事实我都对着官方的仓库、文档和发布记录核过一遍,先把底账摆出来:
github.com/oblien/openship | |
安装就一行:
curl-fsSL https://get.openship.io | sh # 或用 npm i -g openship(需 Node 22+)
装完直接跑 openship,它会用向导帮你建第一个管理员、配域名、把它自己注册成开机自启服务。
部署也短得有点不像话:
cd your-projectopenship init # 把这个目录关联到一个项目openship deploy # 部署
两条命令。这就是官方 Quick Start 里的完整部署路径。
而同一个团队用 Jenkins 做同样的事,要维护:一个 Jenkinsfile、Agent 节点配置、凭据、插件清单,再加上「谁在什么时候改了哪一行」的口头历史。
金句:你不用为 Jenkinsfile 写文档,因为写它的人已经离职了。
四、它怎么决定你的应用怎么跑
openship up 会自己挑运行方式,这是它的实际行为(官方 README 明写):
• Linux + Docker → Compose 模式(默认)。拉发布好的镜像,起一套完整栈:Postgres、Redis、API、dashboard,外加一个容器化的 OpenResty 边缘网关(:80/:443)。这个模式把应用跑在同一台机器上,自动分配域名 + Let's Encrypt 证书。
• 其他环境 → bare 模式(macOS / Windows / Linux 无 Docker)。一个轻量进程 + 内嵌数据库,常驻控制面,把应用部署到远端服务器(SSH)或 Cloud。
部署流水线本身是五步,值得逐条看,因为它解释了「为什么它不需要你写那么多脚本」:
1. 探测:读你的 package.json、框架配置、lockfile、docker-compose.yml,自己推断技术栈、包管理器、构建/启动命令和端口。零配置文件可以跑通。
2. 构建:在目标服务器或本机,产出 Docker 镜像或 bare 发布物,并把解析出来的配置冻结成快照——所以重新部署和回滚跑的是和当初完全一样的东西。
3. 运行:容器只发布在 loopback(不占公网端口),或以受监管的宿主进程运行。
4. 路由 + 证书:OpenResty 写入反代 vhost,签发 Let's Encrypt 证书(HTTP-01)。
5. 推送即部署:GitHub webhook 在推送到跟踪分支时重跑流水线,monorepo 只重建这次真正动过的服务。
第 4 步里有个设计细节,我认为是这篇文章最值得抄走的一条经验:
官方文档明确写了,路由和证书发生在应用起来之后,所以 DNS 或证书出问题时会显示成「需要处理」,它不会让部署失败,也不会把你的应用打下来。
金句:证书出问题就让部署全红,是把「旁路故障」当成了「主路故障」——这是一种设计缺陷,不是严谨。
五、反常识第二弹:它的 K8s 能力,和你以为的不一样
这是本文最重要的一节,也是几乎所有对比文都写错的地方。
网上流传的说法是「Openship 原生支持 Kubernetes,自动管理 Namespace / Pod / Ingress」。这句话不完整,而且会误导你做决策。
翻官方那份集群运行时的文档,真实机制是:它不接管你已有的 K8s 集群,它给你装一个自己的 K3s 集群。
原话是 Pin the official K3s stable release, verify the binary checksum, and install private cluster services——固定官方的 K3s 稳定版、校验二进制 checksum、安装集群服务。
具体行为(全部来自官方集群文档):
Servers → Clusters → 集群 → Enable scaling | |
而这一切的前提是——它需要的是干净的机器。官方明确写了:原生 nftables 布局、UFW、firewalld 都不被这个 K3s 装配器支持,碰到不支持的主机会在装运行时之前就停下。
金句:「支持 Kubernetes」这句话必须追问一句:是接管我的集群,还是在我机器上再起一个?——这两个答案的成本差一个数量级。
还有一层限制,官方写得很坦率但很多解读都跳过了:这个应用周期每个项目只支持一个无状态应用或 worker。多服务 Kubernetes 项目、任意持久挂载、Docker 私有服务互连,官方原文是「需要进一步集成」;数据库有独立生命周期,通过 CloudNativePG 1.30.0 和 Redis Operator 0.26.0 单独管,PostgreSQL 明确支持 Kubernetes 1.34–1.36。
所以:你已有的那套跑着几十个微服务的生产 K8s 集群,Openship 现在纳管不了。 这跟「不会用」无关,是产品当前阶段的边界。
六、它替不了的三件事
到这里可以回答标题里的悬念了。这三件事,是「该不该动 Jenkins」的真正分水岭。
第一件:复杂 CI 门禁。
如果你的流水线里有 SonarQube 静态扫描、矩阵单元测试、人工审批关卡、多阶段制品晋级——这些是通用编排引擎的强项,不是部署平台的强项。Openship 的定位是「从仓库到运行」,它不负责把「这段代码够不够格上线」判清楚。
第二件:多服务 K8s 项目 + 指标驱动的自动伸缩。
官方集群文档在「后续交付阶段」里明确列着:工作负载适配器要扩展到多服务项目、共享存储、指标、自动伸缩和冗余的 Edge/API 网关。当前版本里,自动伸缩、工作负载指标、HA 公网入口、自动网关故障转移——官方原话是「not implemented」。
第三件:纳管你现有的集群和生态。
它装自己的 K3s,用自己的一套声明/观测/权限工作流。你现有的 ArgoCD、Flux、Helm 发布链、已有的 CSI 存储类(除了本地默认类)、已有的 CNI——都不在这场对话里。它同时也拒绝把 Kubernetes 项目通过 Docker 主机迁移或 Cloud 传送搬走。
金句:一个工具的能力边界,不在它宣传页的第一行,在它文档最后那节「Remaining delivery stages」。
七、那正确的姿势是什么
把上面的结论拼起来,答案其实很清楚,而且就是官方推荐的那套:分层。
代码提交 → [CI 层] 测试 / 扫描 / 构建镜像 → [CD 层] 部署到运行环境 → 观测 / 自愈 Jenkins / GitHub Actions Openship
• CI 留在 Jenkins / GitHub Actions:它们干「多阶段流水线编排」这件事确实成熟,没必要推翻。
• CD 交给 Openship:构建产物之后的部署、域名、证书、回滚、日志,这些是它的主战场。
• 想接 AI:Openship 提供 MCP 端点给 AI Agent 用。这里有个我认为设计得很克制的细节——官方写明:只有显式 opt-in 的路由才会暴露为 MCP 工具,每次调用都重新校验权限,凭据/令牌类路由永远不会变成工具。
金句:AI 能不能碰你的生产环境,不取决于模型多聪明,取决于你的平台有没有把「哪些动作可以被调用」写成硬约束。
还有两个动手前必须知道的坑:
一是权限面。Compose 模式下,API 容器会挂载宿主的 Docker socket,官方自己标注这是「host-privileged through the socket」,建议只在可信主机上跑。同时 Compose 模式因 host networking 只支持 Linux。
二是许可。Openship 自身代码是 Apache-2.0,但它捆绑的 iRedMail 引擎是 GPL,并且「即使你没开邮件功能,它也会被包含在若干控制面发行版里」。要过合规审查的团队,这一条要提前看。
八、动手前自查清单(收藏备用)
总结
Jenkins 没有变差,是「通用引擎」这四个字的成本在涨:要多阶段门禁、要插件生态、要有人懂 Groovy,这些它给得起,但每一样都要你付维护费。Openship 用 12.4k star 换来的,是把「仓库 → 应用跑起来」这一段压成两条命令,并且把路由、证书、回滚、日志收进同一个面板。
但它的 Kubernetes 不是「接管你的集群」,是「在你机器上装一个自己的 K3s」;它的项目模型当前只容得下一个无状态应用;它的指标与自动伸缩还在文档最后那节待办里。
把这两句话记住,你就不会在别人的演示视频里做决策:先看它替你干掉了什么重复劳动,再看它的边界画在哪一行。
——◆——
延伸阅读:
Jenkins 构建慢到 40 分钟,排查 3 天才发现是这 3 个配置坑
Jenkins 流水线模板:3 套生产级 Pipeline 直接复制用
K8s 排障只会 describe 和 logs?这 5 个冷门 kubectl 命令 90% 的人没用过
——◆——
你团队现在还在维护 Jenkins 吗?迁移卡在了哪一步?留言说说你的经历 👇
——◆——
🤔 互动话题
关于别再往 Jenkins 上堆插件了,你有什么踩坑经历或心得?评论区聊聊~
📖 阅读原文 👈 底部查看
👍 点赞 + 在看 + 转发 是对我最大的支持!
本文首发于「不怕慢」