ARTICLE · 1088527
生成快 39%、读文档慢三成:本地模型部署AMD 显卡的 Vulkan 和 ROCm 到底怎么选
大家好,我是寂寞的熊猫。
之前把 A 卡全阵容过了一遍,读者反馈了一些问题,例如7800XT 能不能跑、W7900 为什么掉速、7900XTX 双卡怎么配,还有读者私信直接问 R9700 到底怎么部署。这些问题多半缠着同一件事。同一张卡,Vulkan 和 ROCm 两个后端,速度能差出四成,你装的那个,未必是快的那一个。
省流版
- 同一张 9070 XT,生成端 Vulkan 快 16%,读文档反过来慢三成:Windows 下 llama-bench 扫六组条件,Qwen3.8-27B 生成 33.7 对 29.1 tok/s,输入处理 635.7 对 898.6 tok/s。
- 五个独立环境同一个方向,RDNA4 生成端 Vulkan 领先 16% 到 39%:9070 XT、R9700 单卡,不同人不同构建,生成端全是 Vulkan 赢。
- 结论跟着负载、卡代、卡数三个变量走:聊天写代码选 Vulkan,长文档和 RAG 选 ROCm,多卡和大上下文归 ROCm,高并发直接上 vLLM。
- R9700 部署从 19.2 到 184.9 tok/s,差的全部是配置:默认 HIP 构建只有 19.2,gfx1201 定向构建加 tensor split 到 29.7,换 vLLM MXFP4 直接到 184.9。
同一张卡,两套速度
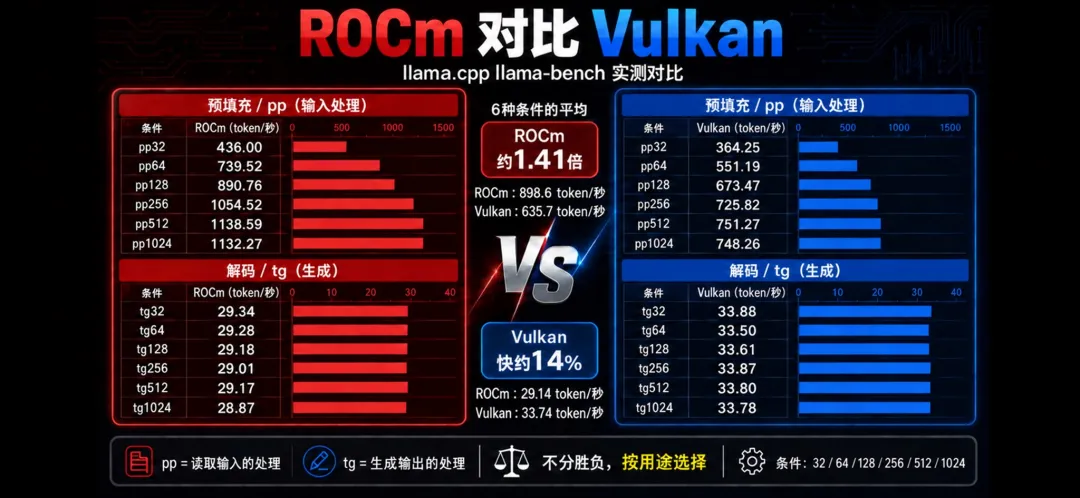
同一张 RX 9070 XT,同一台 Windows 机器,同一个 Qwen3.8-27B GGUF,llama-bench 从 32 到 1024 扫了六组输入长度和六组生成长度,不同配置组合:
| 指标(Qwen3.8-27B,9070 XT Windows) | ROCm | Vulkan | 差距 |
|---|---|---|---|
| 输入处理均值(pp32 到 pp1024) | 898.6 tok/s | 635.7 tok/s | ROCm 快 41% |
| 输入处理峰值(pp512) | 1138.6 | 751.3 | ROCm 快 52% |
| 生成均值(tg32 到 tg1024) | 29.1 tok/s | 33.7 tok/s | Vulkan 快 16% |
输入和生成各归一个赢家。读一份长文档,等它进显存,ROCm 花的时间不到 Vulkan 的四分之三;轮到逐 token 生成,Vulkan 反过来领先一成半。平时觉得卡慢,多半是在生成阶段干等,而那一阶段 ROCm 更慢。
Windows 版 llama.cpp 明明带着 ROCm 的 dll,却经常不加载,要自己追依赖、逐个进程确认运行时才跑得通。选了 ROCm 不等于真的在跑 ROCm,依赖链断一处就静默回退。AMD 官方兼容矩阵里 9070 XT 和 R9700 都在 HIP SDK 支持列表中,但 Windows 上的 ROCm生态还不完整,还不能顺畅使用。
五个环境的同卡对照
把 R9700 上的同卡对照摆在一起:
| 硬件与环境 | 模型 | ROCm 生成 | Vulkan 生成 | Vulkan 优势 |
|---|---|---|---|---|
| R9700,Fedora,AMDVLK 构建 | Qwen3.5-35B-A3B MoE | 68.8 tok/s | 133.0 | +93% |
| R9700,llama-bench build 8463 | Qwen3.5-35B MoE Q6_K | 73.8 | 102.6 | +39% |
| R9700,Arch,RADV | gpt-oss 20B MXFP4 | 142.6 | 170.8 | +19% |
| R9700,Ubuntu,RADV 25.2.8 | Qwen3-30B-A3B Q4_K_M | 约 150 | 约 183 | +22% |
| 9070 XT,Windows | Qwen3.8-27B | 29.1 | 33.7 | +16% |
五个互不相干的环境,生成端全是 Vulkan 赢,差距从一成半到九成。MoE 模型差距最大,这正好是本地部署最常用的一类模型。
+93% 那组用的 AMDVLK 驱动已经在 2025 年 9 月停止维护,RADV 成了目前唯一还在更新的 Vulkan 驱动。换到 RADV 口径,同一台 R9700 跑 Qwen3.5-35B-A3B 生成 112 tok/s,仍比 ROCm 的 68.8 快六成;同时输入处理从 1030 涨到 2987,接近原来的三倍。驱动一换,输入处理的旧结论要重算。
RDNA3 上要分开说。7900 XTX 的同卡对照是分化的,MoE 模型 Vulkan 快一成二,稠密模型反过来 ROCm 快两成三。RDNA4 的答案不能整套搬给 RDNA3。
长上下文还有个反转。R9700 上跑 Mistral Small 24B Q8,上下文堆到 48K 时,Vulkan 生成从 24.5 掉到 10.9 tok/s,衰减一半还多;ROCm 从 23.6 到 17.9,只掉两成四。单卡 100K 以内 Vulkan 生成守得住领先,再深就轮到 ROCm 接场。
生成端 Vulkan 赢面最大的组合是 RDNA4 加 MoE,两个条件缺一个,差距都要重新算。
根因在 Wave32 和驱动
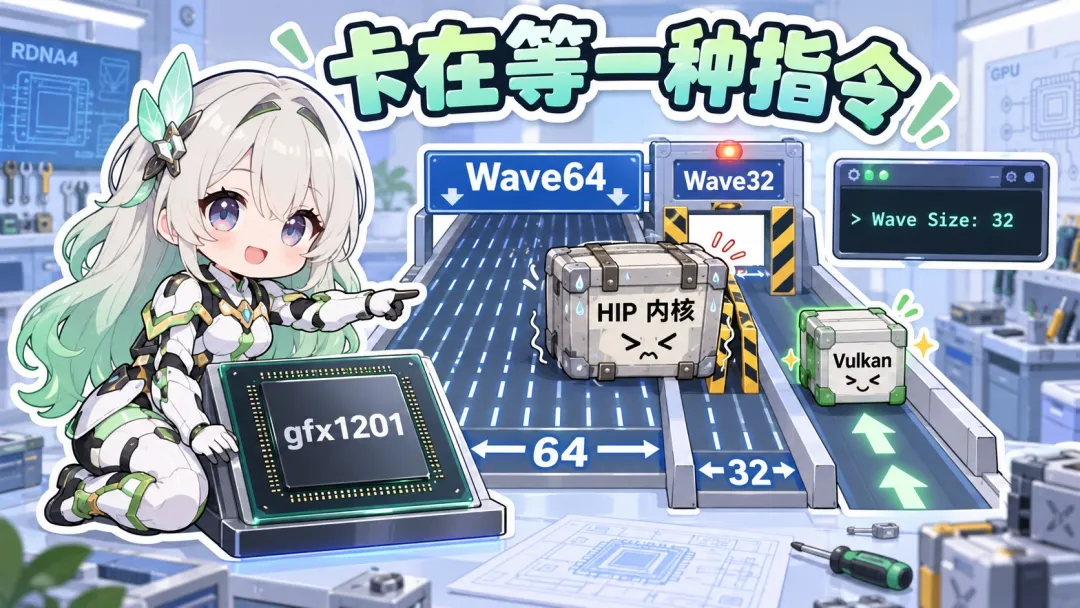
RDNA4 的计算单元按 wave32 执行,一个波前 32 个线程。ROCm 的 HIP 内核长年为数据中心的 CDNA 卡调优,那批卡按 wave64 跑。内核能跑,只是吃不满硬件。llama.cpp 在 9070 XT 上自己打印过一行日志,内容是 Device 0: AMD Radeon RX 9070 XT, gfx1201 (0x1201), VMM: no, Wave Size: 32。
参数层面能看到同一件事的影子。同一张 9070 XT 跑 Qwen3.5-27B,ROCm 后端的输入处理在 ubatch 64 时最快,拉到 72 直接掉到个位数;Vulkan 后端要开到 512 才到峰值。同一块硬件,两个后端连最优批大小都差一个量级,调度方式确实各有各的逻辑。
Vulkan 这边也在追。9 月 24 日合入的 PR #27952 给 RDNA3/4 加了 int8 coopmat 矩阵内核,R9700 跑 gpt-oss 20B MoE 输入处理快了 43%。HIP 那边 9 月 11 日合入的 PR #28102,专门调优 gfx1201 的 Flash Attention,长上下文的输入处理还在涨。两边都在追,任何一份谁快谁慢的结论,都得带上构建版本号才成立。
按负载选后端
把上面的结论压成一张表:
| 场景 | 更优方案 | 依据 |
|---|---|---|
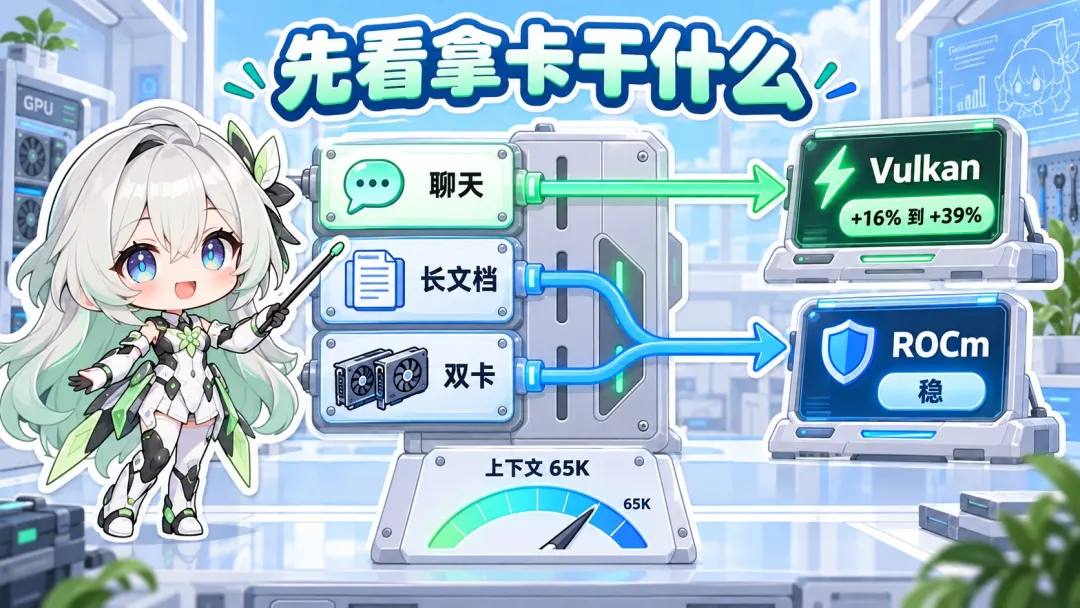
| 日常聊天、写代码 | Vulkan | 生成端快 16% 到 39%,驱动即用免编译 |
| 长文档摘要、RAG | ROCm | 输入处理快四成,稠密大模型差距更大 |
| MoE 超出显存溢出内存 | ROCm | 溢出后生成反超 |
| 双卡及以上 | ROCm | 双卡输入处理 Vulkan 只剩 ROCm 的两成 |
| 上下文超过 65K | ROCm | 65K 附近生成交叉,196K 时 ROCm 快 36% |
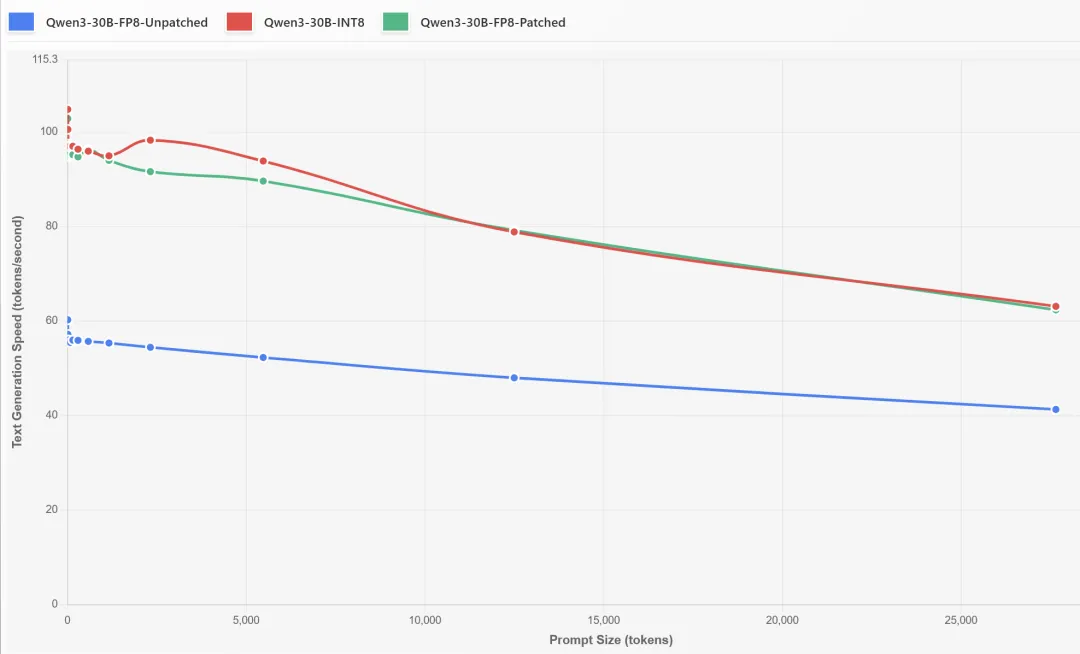
| 高并发对外服务 | vLLM | FP8 补丁后 512 并发总吞吐 6540 tok/s |
先分清拿卡干什么,再决定装哪个后端。
MoE 模型一旦超出显存开始溢出,结论立刻重排。Qwen3-Coder-30B 在 16G 的 9070 XT 上溢出到内存后,ROCm 生成 30.6 对 Vulkan 22.6 tok/s,数据一走 PCIe,输入端的优势就压过了生成端。
高并发是另一个战场。双 R9700 上给 vLLM 的 RDNA4 FP8 路径打上内核补丁,总吞吐从 4603 涨到 6540 tok/s,单并发响应从 52.7 到 87.2 tok/s。这是对外服务用的方案,自己本地聊天犯不上。
R9700 部署:从 19 到 185
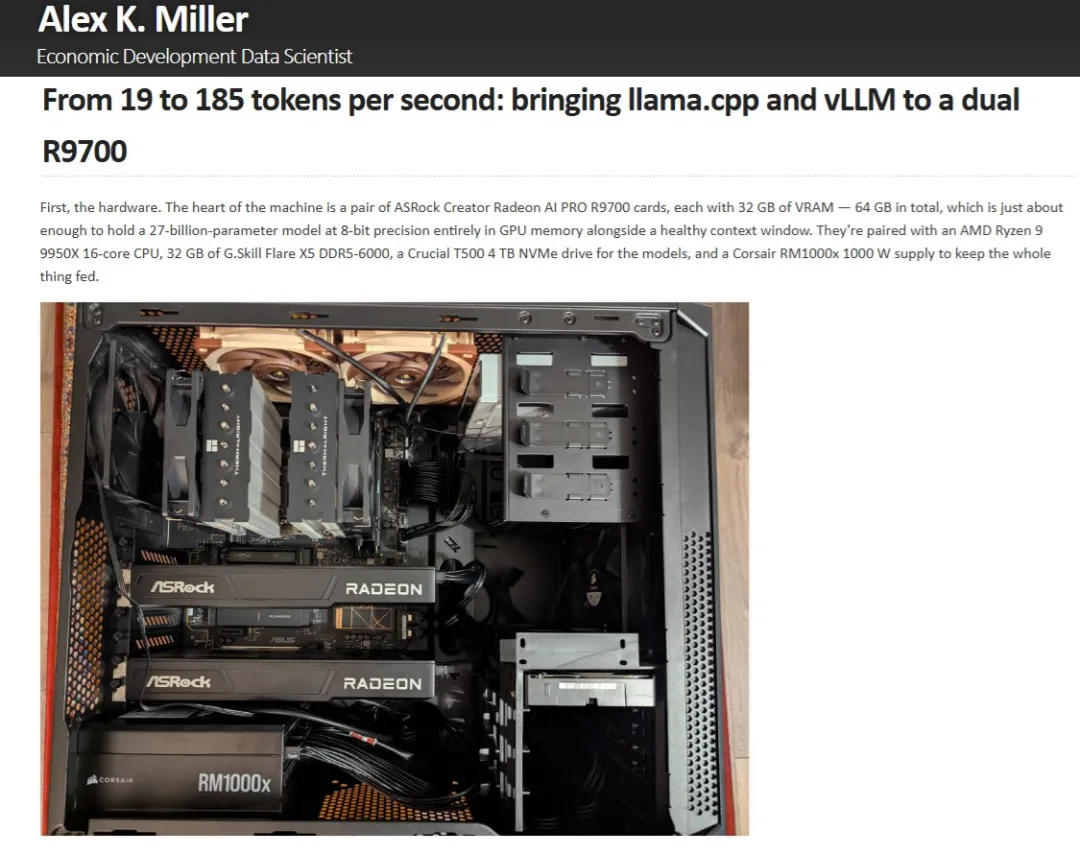
双 R9700、Ubuntu 26.04、同一个 Qwen3.8-27B Q8_0,三步配置三个速度:
| 配置(2×R9700,Ubuntu 26.04) | 输入处理 | 生成 |
|---|---|---|
| 默认 HIP 构建 | 590 tok/s | 19.2 tok/s |
| gfx1201 定向构建 + tensor split | 1,458 | 29.7 |
| vLLM + Radiance MXFP4 | 3,948 | 184.9 |
第一步的差距在编译参数。HIP 构建不写目标架构,编出来的是通用内核,写入一行就快一半以上:
HIPCXX="$(hipconfig -l)/clang" HIP_PATH="$(hipconfig -R)" cmake -S . -B build \ -DGGML_HIP=ON -DAMDGPU_TARGETS=gfx1201 -DCMAKE_BUILD_TYPE=Release第二步加 tensor split。默认层拆分会让一张卡闲着,加 -sm tensor 才能把两张卡的带宽用起来。不想编译也可以直接走 Vulkan,驱动即用;按上面的表,这条路上单卡生成还更快。这台机器上还有个坑,除 Qwen 系之外的模型加载全部挂起,加 --no-mmap 解决。
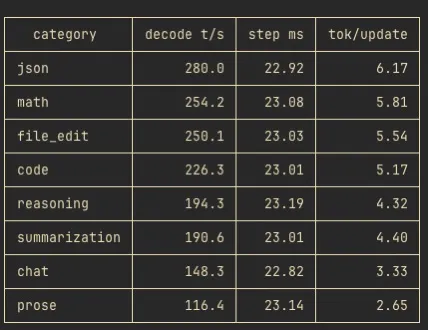
第三步换引擎,vLLM 加 MXFP4 补丁,权重位宽减半加投机解码,直接到 184.9。三步之间硬件一个没换,9.6 倍的差距全部来自软件配置。量化更激进还有空间,BetterBench 分类表上 json 类目跑出过 280 tok/s 的单类峰值,prose 只有 116,类目之间能差一倍多。
R9700 在 Ollama 里 GPU 发现超时 30 秒回退 CPU(issue #13236),目前没有官方修复;Windows 双卡则是自带的 ROCm 6.x 库缺 gfx1201 内核回退 CPU,设 OLLAMA_VULKAN=1 切 Vulkan 后双卡正常(issue #14686),0.12.11 起这是官方开关。验证系统栈用 rocminfo | grep gfx,能看到 gfx1201 就说明问题在应用自带的库。
双卡 64G 的价值在容量。70B Q4 双卡能全装下,生成 11.5 tok/s,速度仍归单卡的显存带宽管,第二张卡买到的是容量。R9700 国内上市价 10999 元起(2025 年 10 月零售口径),两张凑 64G 跑 70B 和大 MoE,是容量党的清晰买入;追单流速度和 CUDA 工具链,NVIDIA 还是那个答案。
读者的一些反馈
| 反馈 | 结论 |
|---|---|
| 7800 XT(RDNA3 16G) | 按 7900 XTX 的分化走,MoE 用 Vulkan、稠密用 ROCm |
| MI210 | 没有公开同卡对照,明标待补,CDNA 老卡暂按 ROCm 方案 |
| AI Max+ 395 | 生成端 Vulkan 略胜;#27952 合入后 gpt-oss 120B 输入处理涨 47% |
| W7900 掉速 | 先查上下文长度和量化档;单卡 MoE 归 Vulkan、稠密归 ROCm |
| 7900 XTX 双卡 | 多卡归 ROCm,65K 以上全面领先 |
| 70B 双 R9700 | 能跑,11.5 tok/s,买到的是容量 |
感谢这些留言,这张表有一半是留言点出来的。
写在最后
同一张卡换个后端能差出四成,A 卡跑得快不快,最后拼的是软件配置和负载的匹配。R9700 和 Strix Halo 的部署细节,下一篇单独展开,双卡显存分配、容器方案和功耗调优都会讲到。
过往公众号文章的心得、踩坑,还有副业折腾的记录,都整理在我的知识库里。知识库会持续更新。点个关注,在公众号后台回复"知识库"就能拿到。
觉得有用的话,欢迎点赞、收藏,或者转给身边同样在折腾 A 卡本地部署的朋友。
有需要交流AI信息的,AI编程,AI绘画,AI视频等等,都可以添加微信,备注:AI
我是寂寞的熊猫,程序员,职场努力升职,业余时间探索副业,寻找第二曲线,聚焦AI绘画、AI编程、智能体方向副业探索与变现。