ARTICLE · 1090762
你的AI助手有脸了:Meta发布Muse实时虚拟形象,说话时口型动作同步
你的AI助手有脸了:Meta发布Muse实时虚拟形象,说话时口型动作同步
Muse Realtime Avatar
谁最先有脸
对程序员
前面几期我们聊 Muse 能"跨设备""干活"。今天它有了"脸"——一个能实时对话、口型动作同步的虚拟形象。
01 发生了什么:语音 Agent 长出了"形象"
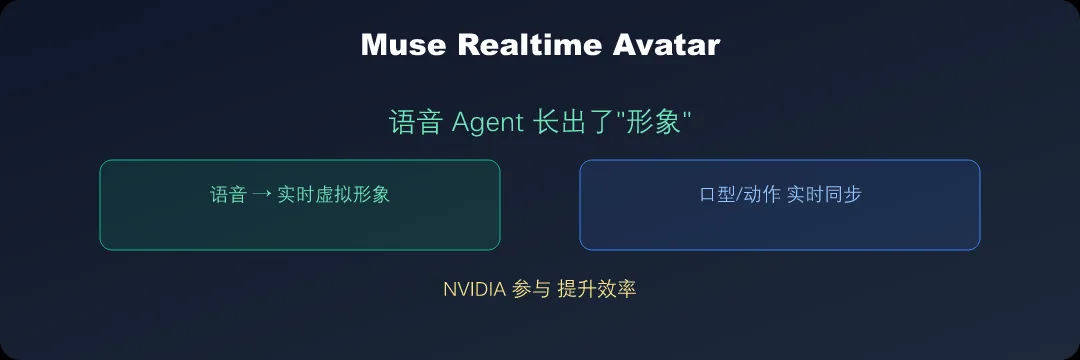
Meta 发布 Muse Realtime Avatar,NVIDIA AI 发推祝贺,并透露 NVIDIA 与 Meta 团队合作提升了该模型的效率。
核心能力:
- • 把 Muse Realtime Voice 转化为"富有表现力、可交互"的虚拟形象
- • 实时——说话时口型、动作保持同步
- • 首先从"实时对话"场景开始
为什么这件事重要?
因为"语音 + 形象"是 AI 交互的完整形态。 只有语音,用户会觉得"在跟一个东西说话";有了同步的形象和表情,交互会自然得多——这是"沉浸感"的关键一步。
而 NVIDIA 的参与提示了一个技术要点: 实时同步(口型、表情、动作)对算力和效率的要求极高,必须靠推理优化才能做到"实时"。
02 对普通行业的影响:AI 客服、AI 主播、在线教育,都要"有脸"了
这条新闻,对"需要跟人打交道"的 AI 场景是直接的形态升级。
哪些场景最先受益:
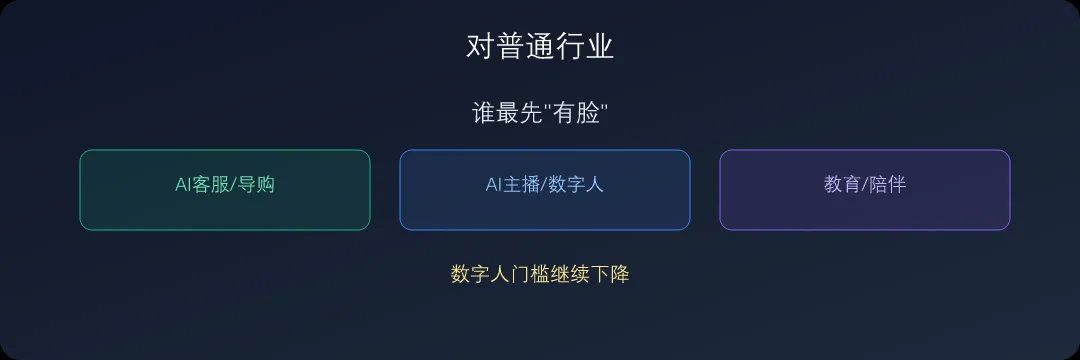
- • AI 客服/导购:有形象的 AI,比"语音 + 文字"更有信任感
- • AI 主播/数字人:实时虚拟形象,直播场景体验更好
- • 在线教育/陪练:有表情的口语陪练,体验更接近真人
- • 情感陪伴:形象 + 语音,陪伴感更强
对从业者的信号:
- • "数字人"的门槛继续下降——以前要专业动捕,现在靠实时 AI 生成
- • 但"内容的独特性"仍然重要——形象好做,有意思的内容难做
一句话:AI 交互正在从"能听会说",走向"有表情、有形象"——这是数字人普及的前奏。
03 对程序员的影响:实时多模态,是新的技术门槛
对技术人,这条新闻的核心难点在"实时"二字。
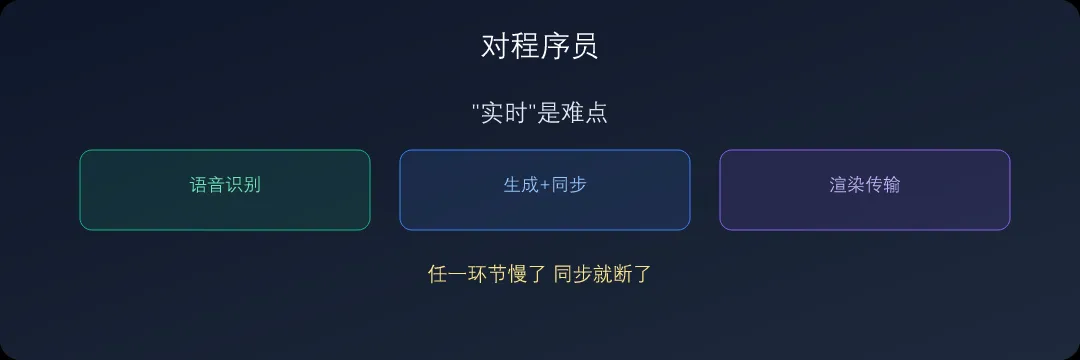
"实时虚拟形象"要同时处理:
- • 语音输入识别
- • 语义理解与生成
- • 口型/表情/动作的同步生成
- • 渲染与低延迟传输
任一环节慢了,"同步"就断了——体验立刻崩。 所以 NVIDIA 强调"提升效率",本质是实时多模态的推理优化。
对程序员的启示:
- • "实时多模态"是新的技术富矿:语音 + 视觉 + 生成的实时协同,需要大量工程优化
- • 推理优化能力再次被验证价值(呼应前几期:量化、蒸馏、并行、调度)
- • 产品设计要求更高:实时场景下,"延迟"不是体验细节,而是生死线
一句话总结
Meta 发布 Muse Realtime Avatar,让 AI 助手有了"能实时对话、口型同步"的脸。对普通行业,是 AI 客服、主播、教育都要"有脸"了;对程序员,是"实时多模态"成了新技术门槛。AI 交互正从"能听会说"走向"有表情有形象"。
📌 影响与可跟进行动
影响
- • AI 交互形态从"语音/文字"升级为"实时虚拟形象",数字人门槛继续下降。
- • 实时多模态对推理效率要求极高,推理优化价值进一步凸显。
可跟进行动
- 1. 企业客服/营销团队:评估"虚拟形象 + 实时对话"能否提升你的客户体验,先做小场景试点(如产品讲解)。
- 2. 开发者:关注"实时多模态"技术栈(语音识别-生成-渲染的低延迟链路),这是新的技术机会窗口。
- 3. 内容创作者:数字人形象门槛降低后,把精力放在"内容独特性"上,而不是纠结形象够不够好看。
- 4. 持续跟踪效率指标:实时类产品的关键不在"效果演示",而在"稳定延迟",关注真实部署反馈。
👇 觉得有收获,点个「在看」。
关注「科技洞察助手」,交互形态这条线我持续追,下一篇拆"实时数字人,什么场景才真正需要它"。
信源:无矩AI 9/28 速览、Meta/NVIDIA 公开信息。信息基于官方口径;影响分析为综合判断。