ARTICLE · 1095808
技术文档被黑话和 AI 搞砸了?这份中文写作规范专治浮夸与失真
读国内很多技术产品的接口文档或落地页,经常会陷入一种怪异的阅读体验。
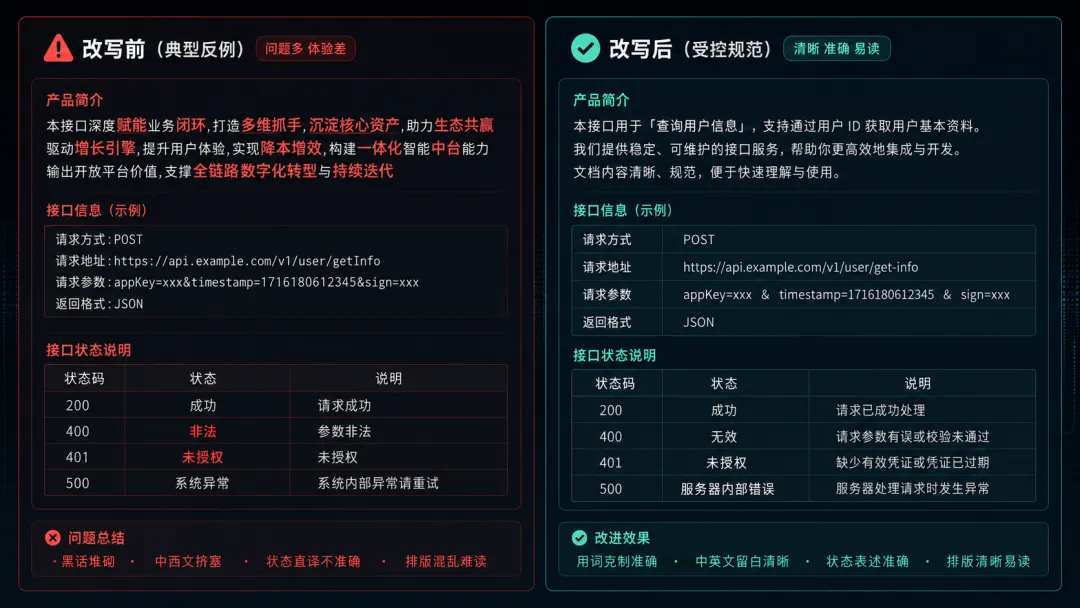
满屏充斥着「赋能业务闭环」「打造多维抓手」「沉淀核心资产」;翻到接口状态说明,Invalid 被机械直译成「非法」,Unauthorized 统一粗暴地变成「未授权」;中英文和数字全挤在一起,连个半角空格都没有。更让人头疼的是,自从大家开始用大模型辅助写文档,AI 往往一边狂飙黑话,一边自作主张地「脑补」出原本不存在的时限、SLA 承诺和确定性结论。
我平时翻看开源项目的文档和 PR,最怕看到的也是这两种情况:前面是空洞的词汇轰炸,后面是 AI 润色后丢失了异常边界的示例。
技术的本质是追求精确,但技术文案却常常在浮夸和失真之间反复横跳。前丁香园 CTO、知名技术人 Fenng(冯大辉)在 GitHub 开源的 Tech-Doc-Style-Chinese,正是冲着这个痛点来的。它没有停留在口号式的写作建议,而是直接做成了一套能挂载进 Codex 和 Claude Code 的受控中文写作 Skill。
项目卡片
项目:Tech-Doc-Style-Chinese[1] 状态:v0.3.0 / 1.1k+ Stars / 持续维护 一句话判断:一套专治技术文档黑话泛滥、排版挤塞与 AI 擅自脑补的受控中文写作 Skill,能无缝挂载进智能体工作流。
很多人让大模型重写技术文案时,最常犯的错误是追求「通顺和漂亮」,结果大模型把关键前提给改没了。
比如原文写着「在约定时限内处理」,大模型为了让句子读起来更有力量,顺手补成「30 分钟内处理」;原文写着「可能导致连接超时」,大模型直接给断定成「系统必然发生网络故障」。在技术文档里,这种自作聪明的润色就是线上事故的催化剂。
Tech-Doc-Style-Chinese 把「事实保真」定为了最高优先级。在它的规则体系里,机器可读内容是绝对不可侵犯的红线:
代码字面量、JSON 键名、URL、API 路径、数据库字段名、配置项,一律严禁当作自然语言改写。 绝不新增来源没有给出的数字、时限、SLA、兼容环境或确定性结论。 改写时如果遇到事实缺口,宁可明确保留「待确认」标记,也坚决不自行脑补。
先守住事实的边界,才能谈文采的修饰。
守住底线之后,第二道关卡是清理那些让人头大的行话与机械翻译。
写文档不是向上做 PPT 汇报。项目把高频互联网黑话拉出了一张清晰的置换清单:把「赋能」还原为提供具体能力,把「抓手」替换为关键措施,把「闭环」拆解为具体的处理流程,把「落盘」说成保存到本地。
在 API 和错误文案的处理上,它给出的指导同样极其具体:
看到 Invalid,不要一律翻译成「非法」,应根据语境使用「无效」「格式有误」或「校验未通过」;看到 Unauthorized,不要粗暴地写成「未授权」,先弄清是用户压根「未登录」,还是「缺少认证信息」;状态提示必须回答三件事:发生了什么、影响了谁、用户现在能做哪些恢复操作。
配合直角引号「」的规范使用,以及中西文、独立数字之间得体的半角留白,整篇文档的扫读效率会瞬间提升。
如果只是改改错别字和黑话,市面上的排版指南其实不少。看到受控中文这一节时,我才意识到作者的野心不仅是改改错别字,而是把工程级的严谨性引入了日常技术写作。
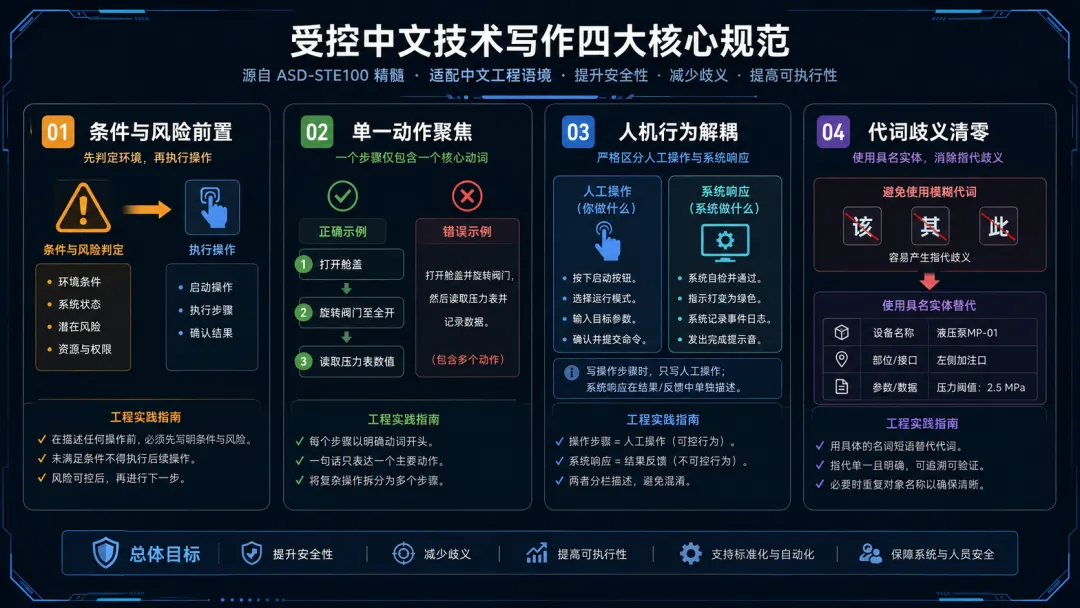
这套思路借鉴了国际航空与国防领域的英文技术写作规范 ASD-STE100,将其精髓移植到了中文语境:
条件与风险必须位于动作之前:读者必须先看到前提,再动手。比如「如果设备温度超过允许范围,不要启动设备」,绝不能写成「不要启动设备,如果超温的话」。 一个步骤只包含一个主要动作:以明确动词起步,绝不让一句话里塞进两三个互相关联的复杂操作。 严格区分人工动作与系统响应:写操作步骤时,不能把系统自动做的事混写成人为操作。规范的表述是:「选择『保存』。系统随后写入配置并重新加载服务。」 消除代词歧义:坚决弃用无法明确指代对象的「该」「其」「此」「上述」。
这些规则一旦作用于部署文档、Runbook 和故障排查手册,能把因文档歧义造成的误操作风险降到最低。
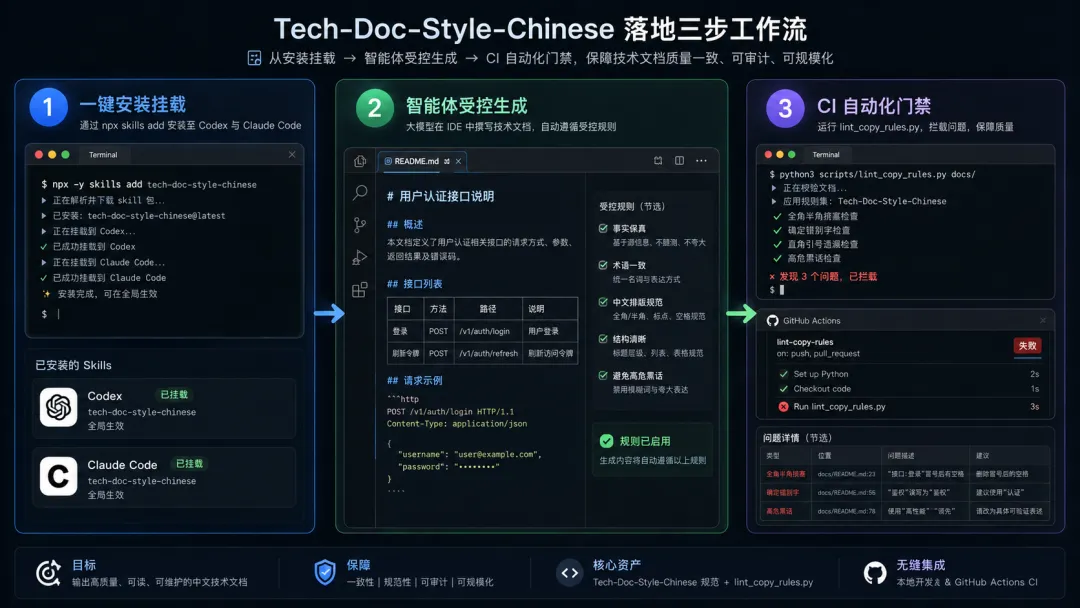
这份规范最实用的地方,在于它直接包装成了开箱即用的 Agent Skill,省去了团队内部推行规范时的死记硬背。
如果日常使用 Codex 或 Claude Code,一条命令就能挂载全局:
# 全局安装到 Claude Codenpx -y skills add https://github.com/Fenng/tech-doc-style-chinese -a claude-code -g# 全局安装到 Codexnpx -y skills add https://github.com/Fenng/tech-doc-style-chinese -a codex -g安装完成后,无须每次在 prompt 里长篇大论提醒 AI。大模型在处理 README 改写、FAQ 整理、接口文档审查时,会自动索引并遵守其中的受控规则。
仓库里还附带了一个零依赖的 Python 校验脚本 scripts/lint_copy_rules.py。它能在本地和 GitHub Actions CI 中自动拦截全角半角挤塞、确定错别字、直角引号遗漏和高危黑话:
python scripts/lint_copy_rules.py SKILL.md references/看清它的价值,也需要看清它的适用边界:自动检查脚本能拦截格式和黑话,但无法替人类判断逻辑是否真正严密;受控写作的严苛规则适合操作手册与接口说明,但不应机械套用到品牌宣传和叙事长文里。
在这个 AI 生成内容极度泛滥的时代,堆砌辞藻和生成冗长废话变得前所未有的廉价。但对真正面对终端、面对接口、面对线上故障的工程师来说,清晰、克制、准确且保留必要边界的文字,才是最高的职业素养。
花两分钟把这份 Skill 接入你的智能体工具链,它会帮你把大模型写出的浮夸草稿,稳稳地拉回专业水准。
如果你想继续看这类 AI 工具拆解,我会把上手路径、关键限制和可复用配置整理成清单,方便你直接判断值不值得试。
[1]Tech-Doc-Style-Chinese: https://github.com/Fenng/Tech-Doc-Style-Chinese