ARTICLE · 1097368
知识库实操:把你的文档喂给智能体
上一篇结尾我说,该给它装个知识库了。这篇就来干这件事。
先看一条后台留言。有位读者改完提示词,周报终于像人写的了。但新问题冒出来:智能体不知道他们公司内部管那件事叫什么。
他们内部把订单系统改版叫"OMS改版",智能体写出来是"完成订单管理模块优化升级"。字面没错,可发到组里,同事第一反应是:这是说的哪个项目?
它的写作能力其实够用了,缺的是另一类东西:你公司内部的那套上下文——项目代号、术语、惯例、去年的口径。这些它一个字都不知道。
这些写进提示词行不行?写不了。三个月的周报、一摞流程文档、几十个内部叫法,全塞进人设里,一是太长,二是它根本记不住那么多。这就是知识库要解决的问题。
先说清它是怎么工作的
这里有个地方很多人搞错:知识库并不会把文档读完然后记住。
它的用法是用时现查。你问一个问题,它先把问题转成一串特征,去你的文档里找出最像的几段,再把这几段一起交给模型,模型照着这几段回答。
打个比方:它没有把整本书背下来,而是随身带了个能秒翻目录的索引员。你问三季度增长多少,索引员翻出相关的那两页递过去,它照着念。
这个机制有个直接后果,后面每一步操作都跟它有关:文档能不能被查得到,比写得漂不漂亮重要得多。
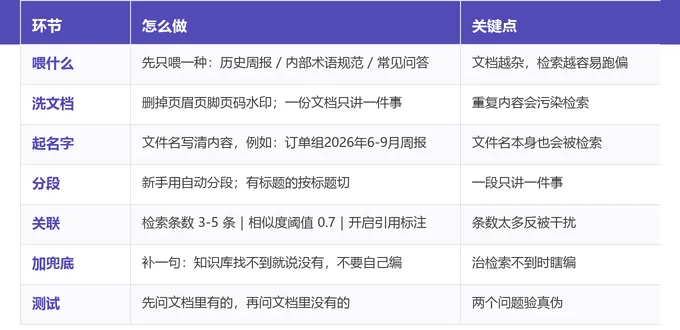
第一步:先定喂什么,别一股脑倒进去
新手最容易犯的错,是把网盘里能翻到的全传上去,想着"多总比少好"。
结果相反。你文档越多越杂,检索出来的"最像的几段"就越容易是别的东西。你问周报该怎么写,它是能给你翻出一段报销制度里的句子。
所以先只喂一种。三种典型选择,看你是哪种情况:
历史周报,挑最近两三个月的十到二十篇。跟着上一篇做周报助手的,选它最直接。
内部术语和规范,把公司里那套叫法、缩写、项目代号整理成一份。这份东西页数最少,见效最快。
常见问题和标准答法,客服、售前那种反复被问的东西,一问一答成对写下来。
跑顺了再加第二种。上手就想搞一个大而全的资料库,十有八九第一次就放弃。
第二步:传之前先把文档洗一遍
这一步几乎决定了检索准不准,但大部分教程不讲。三个动作:
把格式垃圾删掉。页眉、页脚、页码、"内部资料请勿外传"这类水印文字,全部清掉。它们在文档里重复出现几十遍,会污染检索。之后你问任何问题,它都有可能命中这些没用的行。
一份文档讲一件事。别把半年的周报合并成一个几百页的 Word。按时间或者按项目拆开传。文档越单一,检索越准。
文件名写清楚。这点知道的人少:文件名本身就是会被检索的内容。你命名成"文档1",它检索时一个线索都抓不到。写成"订单组2026年6月到9月周报",它光看文件名就知道该不该用。
顺手保住文档里的结构。有小标题、分小节的文档,比一坨流水文字好检索得多。
第三步:分段怎么选
上传的时候会让你选分段方式,一般是两个选项:
自动分段,按长度切,比如每五百字一段。结构完整的长文档用它最省事,新手直接选这个。
自定义分段,你自己定按什么切,比如按小标题切。文档本身就有一级级标题的,用这个更合适。
选择的判断标准一句话:让每一段只讲一件事。
切太大,一段里混着三件事,检索出来它抓不到重点。切太碎,一句话一段,上下文断了,它读不明白。
还有个更省事的办法。如果你的文档本身就是一问一答,或者一条规则一行,那就按行切。问答对和规则条目天生就是独立的检索单元,效果往往比大段切更好。
第四步:关联上,三个参数值得调
回到智能体的编排页,找到技能里的知识库,把你建好的库勾上。关联完有三个东西值得动一下:
检索条数,调到 3 到 5 条。默认可能给到 10 条,我建议调小。原因很实在:排在前面的才最像,后面那几条都是勉强沾边的,塞进去只会干扰它。宁可少给几条准的。
相似度阈值,设 0.7 左右。它管的是"像到什么程度才允许用",低于这个分直接丢掉。调高它更谨慎,可能常常回你"没找到";调低它什么都拿来答,容易跑偏。
引用标注,打开。打开之后回答里会标明这句子出自哪份文档。对你有个实际好处:一眼就能看出哪些话是文档里来的,哪些是它自己加的。周报这种要往上报的东西,能省掉一半核对时间。
第五步:补一句必须加的提示词
上一篇我们加过"信息不够就问我""没提到的不许写"。知识库还得多加一句,回到人设里贴上去:
如果在知识库里找不到相关内容,直接说"没有找到相关记录",不要用你自己的知识补充。
这句话为什么不能省?因为检索不保证每次都找得到。问题稍微偏一点,或者文档里确实没写,检索就空了。
检索空的时候,模型不会停下来告诉你"我没查到"。它会用自己训练时学的那套通用知识接着说下去,说得挺像回事,可你公司根本没这回事。
这句兜底和上一篇那句的分工是这样:上一篇管的是"你没给我材料",这一句管的是"材料里没有"。
第六步:两个问题,验证它真在用
别拿一句"你好"去测,那测不出任何东西。用这两个问题:
第一问,问一个只有文档里才有答案的细节。比如文档里写过项目代号,你就问那个代号是哪个项目。答对了、还标了出处,说明库通了。
第二问,问一件文档里肯定没有的事。看它会不会老老实实说"没找到"。要是它开始编,说明刚才那句兜底没生效,回去检查提示词。
这两问做完,知识库到底有没有在干活,一目了然。
装上之后是什么样
还是拿上一个例子问:"订单模块的项目代号是什么?"
没有知识库时:这个问题涉及你们内部的项目代号,我无法确定。(更好的情况是这样,更糟的是它直接给你编一个。)
有了知识库之后:根据《订单组2026年6-9月周报》,订单模块的项目代号是"清风",首次出现在6月第二周的周报里。
另外你会发现,它说的全是你公司的原话,你不需要再去翻一遍核对。
五个坑,提前说
一次传太多太杂,检索会跑偏。先喂一种。
文件名写成"文档1",检索时没线索可抓。命名要能看出内容。
上来就传机密文件。先用公开资料或者非敏感的文档跑一遍,看看效果再决定。
传完就不管了。新增的文档要记得补,不然它还在用去年的口径答题。
忘了加兜底那句。检索不到的时候,它会开始编。
给你留个作业
就挑一种文档,洗完、命名好、传进去,然后用上面那两个测试问题各问一遍。
你的智能体现在知道你们公司的叫法了,但它知道的东西还是你喂给它的那些。下一层能力,是让它自己去外面取——自己去查实时数据、去抓一个网页上的信息,你只要说清要什么,取的过程它自己完成。
如果检索不准,把你文档的文件名和分段方式发到评论区,我帮你看看问题出在哪。传完效果好的也发一下,让我知道哪种文档最好使。