ARTICLE · 1098985
文献综述AI工具选择:DeepSeek、GLM、MiMo真实使用差异
我用它们写了一篇文献综述。
三个模型的真实差异
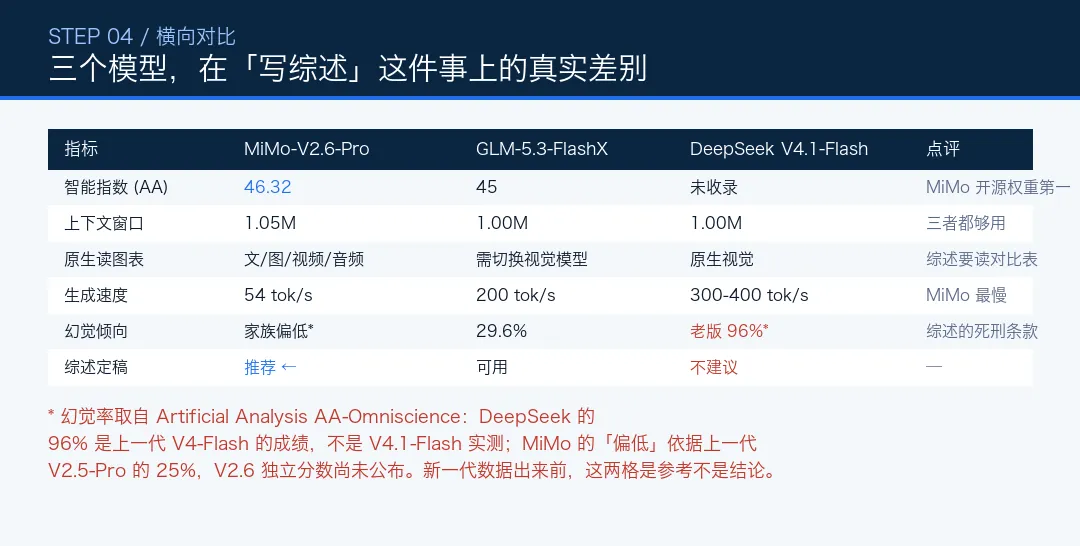
MiMo-V2.6-Pro:我最后用它定稿
不是因为它跑分最高,是因为它刚好把我前面踩到的三个坑都堵上了:
1M 上下文(实测能装下我 20 倍体量的文献池),写综述不怕撑爆 原生全模态——文、图、视频、音频进同一个上下文,配了 681M 参数的视觉编码器和 435M 参数的音频编码器。综述里最有价值的往往是对比表、趋势图、方法流程图,纯文本模型读 PDF 这些直接蒸发 幻觉倾向低。前代 MiMo-V2.5-Pro 在 AA-Omniscience 上是 25%,当时代榜上第二低。V2.6 训练里用了"Aligned RL":对抗筛查、验证者交叉复核、让模型重写自己跑偏的推理链,官方披露的 reward hacking 轨迹压在 2% 以下
它的毛病我也得说:慢,而且话多。 约 54 token/秒,比中位数低,出第一个字要等 2 秒多;跑一次标准评测它会吐 140M 输出 token,是同类里话最多的一档。写综述时它容易给你灌水。
GLM-5.3-FlashX:我拿它铺第一轮
200 token/s,比原版 Flash 快 5 倍,100 万上下文。这个吞吐的意义在于——它是"多步任务能自动跑完"的前提。
我不用它做判断,用它做覆盖:批量读摘要、按统一字段抽成表格(作者/年份/方法/样本量/结论)、拉三级提纲、排研究脉络的时间线。这类活儿快比准重要,跑得快就能多扫一轮。
DeepSeek V4.1-Flash:我把它调去做杂活了
说实话这个结论和我一开始的预期相反——我原本以为速度最快、原生带视觉的它会是最顺手的那个。
问题在于它和综述这个任务的失败模式正好重叠。有第三方实测:给 30 页文档提炼 5 个关键点,它漏掉了后三分之一里那条"访客临时授权到期后自动回收"。这不是偶发失误,是轻量模型处理长上下文的结构性代价——注意力开销分段消化,对中段关注度天然偏低。
而综述的核心价值,恰恰就在中段:第 17 篇的对照组设计和第 4 篇的结论互相打架,你要把它们拎出来对质。漏中段,等于综述里"研究之间的对话"整块塌陷。
它该去干的是短平快的活:信息抽取、格式改写、批量打标、意图路由。这些场景里它效率确实高。
我的推荐
综述定稿:MiMo-V2.6-Pro。 理由不是分数,是它同时满足了这个任务最要命的三条——装得下、读得懂图表、编引用的倾向低。
铺初稿:GLM-5.3-FlashX。 负责覆盖率和速度。
杂活:DeepSeek V4.1-Flash。 别让它碰定稿。
一句话分工:GLM 铺初稿,MiMo 写定稿,DeepSeek 干杂活。
最后,无论用哪个,这两步不能省
一、把原文喂进去,别让它凭记忆写。 检索增强(RAG)能把幻觉压掉大约七成,是所有降幻觉手段里效果最猛的一个,比换模型管用得多。
二、引用逐条过一遍。 让模型输出"每条结论对应的原文段落",你重点抽查支撑核心论点的那些。文献目录类事实的幻觉率在 10%–25%,这不是模型不够好,是当前架构的数学下限。
如果你在论文辅导、AI降重、数据复现、文献综述精细化打磨等方面有需求,自己拿捏不准模型用法、写作逻辑或查重标准,都可以私信我一对一沟通,帮你高效搞定学术写作难题。