ARTICLE · 1101468
马斯克:AI的下一步,软件工程vs现实工程
9 月 25 日,央视对马斯克做了一场约 26 分钟的专访。谈到 AI 的下一步,他在屏幕上划了一条线。
"What Anthropic did extremely well was make AI excellent at software engineering. But no one has yet made AI excellent at real-world engineering."
Anthropic 做得非常好的一件事,是让 AI 变得擅长软件工程。但到现在,还没有人让 AI 真正擅长现实世界的工程。
第一句其实是在夸对手。先承认你们赢下的那个战场确实有价值,然后指出那是个小战场。
一、软件工程赢在哪里
他列了五条:公开仓库提供了大量训练材料;编程语言有明确语法;编译器和类型检查器会立即报错;测试套件直接告诉 Agent 改动过不过;做错了能在沙箱里重跑,最后用版本控制撤回。
这五条指向同一件事:代码世界给 AI 准备了一个高频、便宜、可复现的试错场。
他没有说软件工程被解决了。需求理解、架构设计、上线责任,这些照样难。代码的优势在于它能给出清楚的失败信号,而这件事比「简单」重要得多。
二、现实世界的错误不可逆
代码跑错了可以发新版本。一台机器人撞倒货架以后,「回滚」修复不了现场的损失。
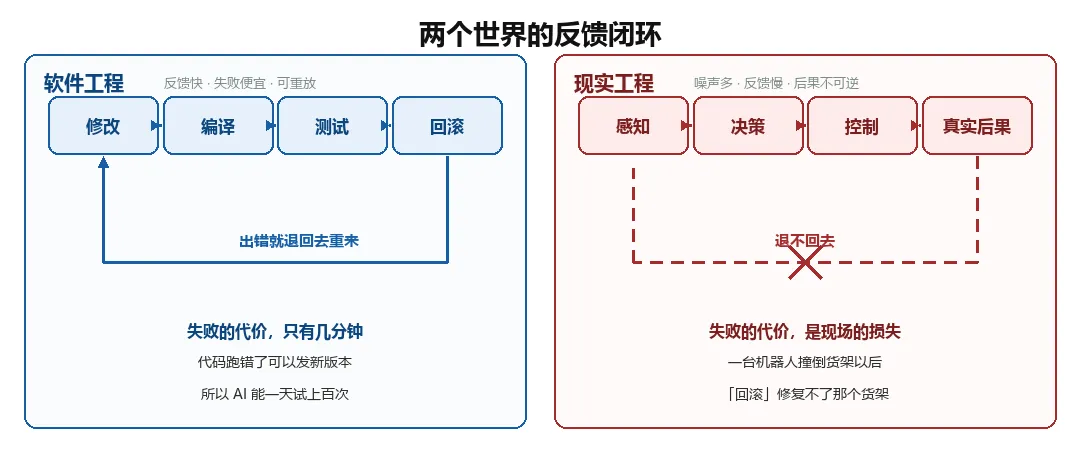
两个世界的反馈闭环:左边能退回起点,右边不能
不可逆会连锁出三件事。
一是不能靠试错学。软件一天能试一百次,机器人一天试几次,还要算上损耗和安全。这个差距不会因为模型变强而消失。
二是数据会稀缺。真实的极端故障本来就不多,而且不可能为了采集数据反复制造一次。
三是必须提前把边界条件想全,而你恰恰想不全。他自己的原话是:某个边界条件如果没进测试集,模型不会自动知道它存在。
三、他把解法押在了数据上
他给出的方案里,数据的分量明显重于模型本身:
"I think we've got a real opportunity with the SpaceX training data and maybe with the Tesla training data..."
我认为借助 SpaceX 的训练数据,也许再加上 Tesla 的数据,我们有机会让 AI 在现实工程上变得非常强。
这类数据稀缺在「过程与结果的关联」:设计改了什么、传感器读到什么、后来出了什么故障。模型要能看到工程师做了什么、系统随后发生了什么,才可能学到代码之外的因果。
这些东西,爬公开互联网是爬不到的。这是他的判断落点,也是他手里那张牌。
但他自己也没绕开那个老问题:真实故障稀少、极端情况无法反复制造、不同车型批次和软件版本让分布一直在变。仿真里跑得完美的方案,落到真机上可能因为一点摩擦、延迟或温度偏差就失效。
写在最后
AI 过去十年跑得快,是因为它挑到了一个可以无限重试的战场。下一个战场不能重试,速度会掉下来,而这件事由物理决定。