ARTICLE · 1103071
为什么 AI 会"失忆"?——读懂 Agent 的记忆系统(一)
你有没有过这样的时刻:上周刚跟客服机器人说过“我对花生过敏”,这周它又热情地给你推荐花生酱饼干;昨天让助手帮你订了靠窗的机票,今天再让它订票,它对你的偏好一无所知。我们对一个“人”会说“我不是说过吗”,却很少对 AI 说——因为它们大多数真的没有“上次”。
这是《深入理解 AI Agent:设计原理与工程实践》第 3 章的通俗版第一篇。书名听着吓人,要解决的问题却特别日常:怎样让 AI 在对话结束后,仍然记住你、记住知识。 我不打算堆术语,而是用订机票、预约保养这类场景,带你把整套记忆系统过一遍。读完这一篇,你会先有一副清晰的骨架;后面四篇,我们再把每根关节拆开来填细节。
一、AI 有两种“记忆”:一个关于你,一个关于世界
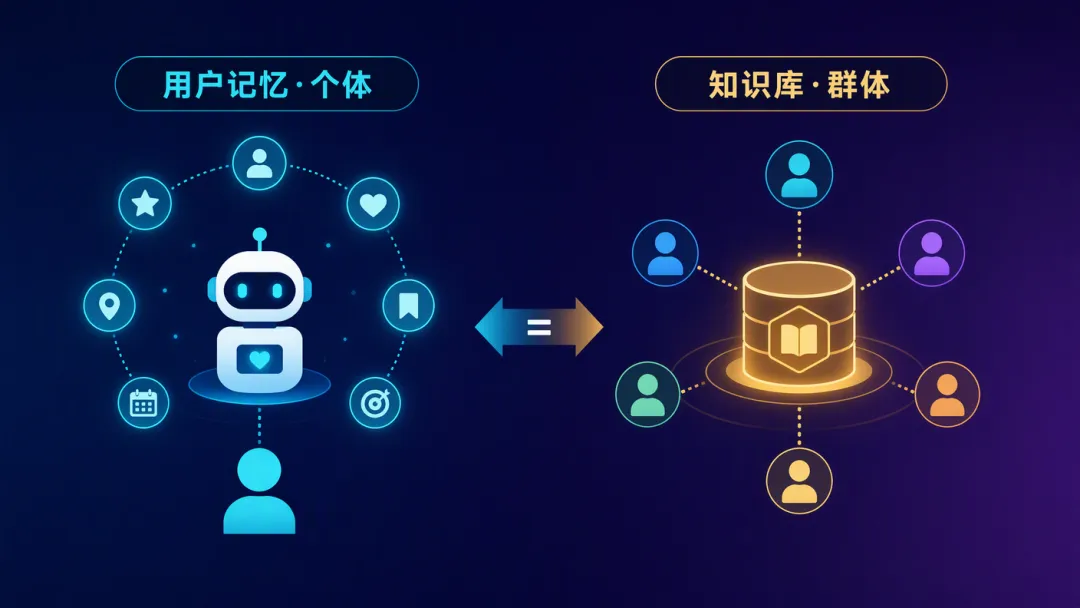
先分清最容易混淆的一点。当工程师说 Agent 有记忆,指的是尺度完全不同的两件事。
用户记忆是围绕“你这一个人”的。Agent 在一次次接触中逐渐了解你的偏好、习惯和身份,攒出一份专属档案——它让你从“一个用户”变成“一个被认识的人”。知识库恰恰相反,它是所有用户共享的集体知识:某行业的法规、某公司的内部流程、某领域的专业文档。前者让 Agent 成为“懂你的助手”,后者让 Agent 成为“领域专家”。
一个比喻:用户记忆像你的私人助理,记得你喝咖啡不放糖;知识库像一座图书馆,谁都能进去查资料。
耐人寻味的是,这两件事管辖的范围天差地别,却共用同一套底层技术——向量检索、知识压缩——也踩同样的坑:信息会互相冲突、知识会过期、检索会找不准。所以它们被放在同一章里讲:治它们的,往往是同一批药方。
二、“记忆”不是录音,而是提炼
很多人以为让 AI 有记忆,就是把对话一句句存下来。这么做的问题很直接:绝大部分对话是“废话”,全存下来既臃肿,又会干扰后续检索。
真正的做法,是在一段对话结束后,额外调用一次大模型,让它读一遍刚才的对话,挑出值得长期记住的东西。以书里订机票的对话为例:
用户:帮我订下周五去东京的机票。我偏好靠窗,另外我是素食者,需要特殊餐食。 Agent:好的,我来搜索下周五去东京的航班……(调用航班搜索工具,返回 3 个选项) Agent:这是结果。按你的偏好,我筛选了有靠窗座位的。要订 ANA 这班直飞吗? 用户:好,用我的美联航里程号 12345678。
对话结束后,框架会提炼出这样的记忆:
PLAINTEXT 提取到的记忆: - 用户偏好靠窗座位(偏好) - 用户是素食者,航班需特殊餐食(饮食限制) - 用户的美联航里程号:12345678(常旅客计划) - 用户近期有去东京的出行计划(近期活动)
关键在于,提取不是照抄,而要同时满足三条规则:选择性(“搜索返回 3 个选项”这类短期细节直接丢掉)、抽象化(把“这次要了靠窗”上升为“偏好靠窗”)、结构化(用可检索的字段存下来,而不是一段散文)。这三点看着朴素,却决定了记忆系统好不好用——存错了、存杂了,后面再怎么检索都是白搭。
三、什么样的记忆算“好”?三把尺子
动手设计之前,得先回答:怎样才算一个好记忆系统?没有标准,后面每种方案的优劣就无从评判。
学术界有个公认的长对话记忆基准叫 LoCoMo,它构造了平均约 300 轮、最多 35 个会话的超长对话,专门考验模型能不能记住并理解这么长的交流。书里综合这类基准和商业产品实践,把 AI 的记忆能力归成三个递进的层次——它会贯穿整个系列:
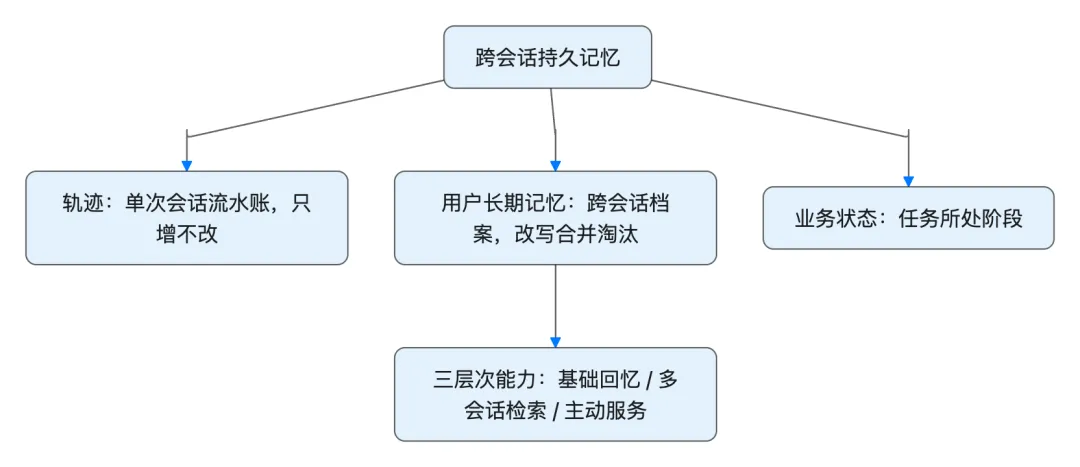
第一层,基础回忆。 存得准、取得回。你说“我的会员号是 12345”,需要时它能原样吐出来。听着简单,但这是地基。
第二层,多会话检索。 信息来自不同对象、不同时间,Agent 要把相关的都找齐再做判断。比如一个用户有两辆车,他说“帮我预约保养”,系统得翻出两辆车的全部信息,再主动问“要为哪一辆”——而不是随便猜一辆。
第三层,主动服务。 这是最高标准,相当于从“工具”升级为“助理”。它要在没有明确指令时,就把散落的信息串起来:订国际航班时主动关联几个月前存的护照,发现快过期就预警;手机坏了,主动把原厂保修、信用卡附加保修、运营商保险整合成一份完整清单。
这三层是一级一级往上搭的:地基不牢,就谈不上“主动”。
四、记忆也分“楼层”
有了标准,就能谈设计了。书里把记忆设计拆成三个维度:放哪里、怎么存、存什么。这一篇先讲“放哪里”。
就像人有“工作记忆”和“长期记忆”,Agent 的记忆也分层:
轨迹(Trajectory) 是一次运行过程中的完整流水账——你说的每句话、模型每次回复、工具返回的每个结果,按时间顺序一直追加,只增不改(计算机里叫 append-only)。它给 AI 提供“刚才发生了什么”的即时上下文。
用户长期记忆是跨会话沉淀下来的稳定信息,会被反复改写、合并、淘汰,通常以键值对的形式绑在某个用户 ID 上。
轨迹是流水账,长期记忆是档案:前者记录过程,后者保存结论。
小结
骨架已经搭好:AI 的记忆分“用户记忆”和“知识库”两个尺度;记忆不是录音,而是靠额外一次大模型调用提炼出来的;判断好不好,看它能不能从“基础回忆”走到“主动服务”;而存储上,它有“轨迹”和“长期记忆”两层。
骨架有了,剩下的问题是:一条“用户偏好靠窗”,到底该以什么形式存?存成便签、段落,还是一张带身份的卡片?下一篇《AI 该怎样“记笔记”?》就来回答。
延伸阅读(开源项目):想亲手验证“记忆好不好”,可以从长对话记忆基准 LoCoMo 入手;本系列对应的动手实验,都收录在开源项目 bojieli/ai-agent-book 的 chapter3 目录里。