ARTICLE · 1110032
AI连数据都找不对,还谈什么自动科研?中科院盯上了这一关
AGENT FOR SCIENCE · 科研现场
你让AI找数据,它很快交来一串链接。
标题都挺像,摘要也说得通。点进去才发现:有的地区不对,有的时间不对,有的只能看图片,有的根本拿不到你需要的那张表。
最麻烦的,往往是那个看起来最接近的结果。
下载成功了,文件也能打开。你顺手往下做,过了很久才发现,这份数据回答的压根不是你最初那个问题。
自动科研的第一步,就可能走错门。
中科院计算机网络信息中心等机构的团队,提出了Scientific Data Skill,简称SciDSK。它把一份数据的背景、文件说明和使用指引整理成AI可读取的技能包,原始数据仍留在原来的仓库。
在作者的检索测试里,第一名命中率从71.15%提高到80.77%。另一个数据解释测试中,检查项通过数从22/24变成23/24。它主要检验的是找数据、理解数据,还不是完整科研流程。
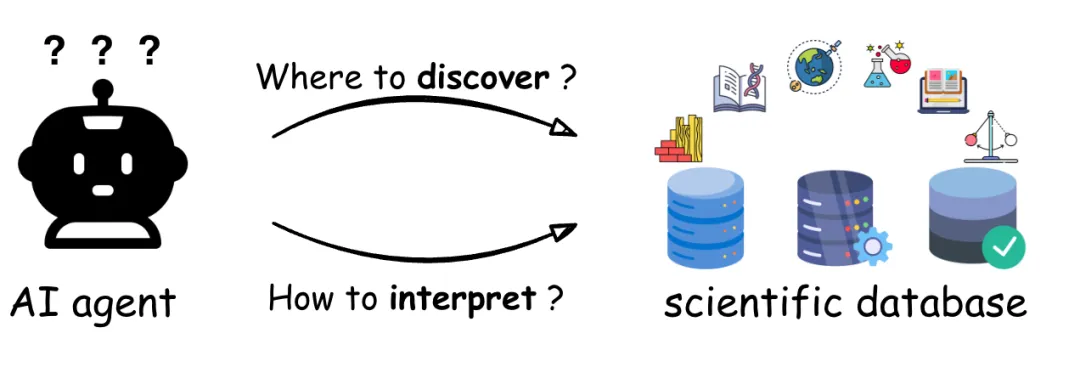
图1|论文展示的两个关卡:找到合适的数据,理解文件到底装了什么。本文围绕这张图讨论数据使用问题,原图出处见文末。
这个方向值得关注。不过,比起马上下载一个新工具,我们更想追问:你的数据,为什么总让接手的人猜来猜去?
下面从一个具体的找数任务说起。
01“找到了”,可能只是标题对上了
假设你准备研究城市夏季高温,提出一个需求:
“找一份覆盖某城市、连续几年的逐小时近地面气温数据,我想分析夜间高温。”
这句话听上去已经够清楚。但落到数据选择上,还有很多信息没说出来。
城市边界是什么?“夏季”取哪几个月?夜间按本地时间划分吗?希望覆盖全城,还是只看几个站点?能接受多少缺测?
现在面前有三份候选材料。
A:这个城市的月平均温度,时间很长。
B:几个观测站的逐小时气温,时间符合,但部分月份有缺测。
C:卫星获取的地表温度,空间图像很漂亮。
它们都可能出现在“城市、高温、温度”的搜索结果里。可对于刚才的任务,三者的作用完全不同。
A的时间颗粒度可能支撑不了夜间分析。C的测量对象与近地面气温不同。B比较接近,但还要继续查站点覆盖、时间记录和缺测情况。
如果AI只把三份结果排个名,再写一句“推荐使用第一份”,这项工作其实还没完成。
你需要看到它为什么选,又为什么放弃。
一张有用的候选表,至少应该写出:与任务匹配的地方、尚未确认的条件、不能满足的要求,以及这些判断对应的原始说明。
没有这张表,后面的分析可能一直建立在一个没人核对过的选择上。
02一句“数据质量高”,到底告诉了你什么?
很多数据介绍喜欢写几句话:规模大、覆盖广、质量高、适合研究。
这些话听起来都好,但你真要用,还是得接着问。
拿刚才的温度任务来说,比“高质量”更有用的说明可能是:哪些站点参与了测量;每个站点从什么时候到什么时候有记录;时间使用什么时区;哪些读数被标记为异常;缺测是怎么记录的。
其中任何一项缺失,都可能让后续处理多出一轮猜测。
例如,你准备截取夜间时段,数据时间却使用另一种时区。文件能读,图也能画,只是你选中的时段可能已经变了。
再比如,某一列里出现大量0。它可能是真实观测值,也可能是某种导出约定。没有说明,就不能把自己的猜测写进清洗规则。
这时候,AI回答得越流畅,越容易让人忘记回头确认。
所以,我会把数据介绍里最该优先写的内容,换成三句话:
它测的是什么。
它在哪些条件下测出来。
它最容易被怎样误用。
这三句话写清楚,使用者就能少走不少弯路。
03真正好用的说明,需要一路带你走到文件
现在假设我们选中了候选B,打开它的下载目录。
里面有站点表、观测表、质量标记表,还有几个不同日期的压缩包。
下一步怎么做?
你需要知道:哪张表说明站点位置,哪张表存读数,两者靠哪个字段连接;质量标记在哪;某个压缩包覆盖哪段时间;新包是否替代旧包。
如果说明停留在“本数据包含若干气象站观测记录”,接手的人仍然要自己推断文件之间的关系。
把路径接清楚,可以先写一个很小的示例。
“先打开站点表,按研究范围选择站点编号。再到观测表中筛选这些编号,检查时间字段。质量标记的解释见对应说明。保留筛选条件,另存输出。”
这里只是示范如何写流程。真实项目中,每个文件名、字段名和处理规则都需要对照实际材料补齐。
让别人少猜一次,比再加一段项目背景更管用。
还有一个容易被忽略的细节:示例必须能走到底。
如果教程用了一个在下载包里找不到的文件,或者写了一个已经改名的字段,这份教程反而会制造新的困惑。
给说明做一次实际试读很简单:找一个没参与整理的人,让他按照文字找到输入、完成一次最小操作、定位输出。记录他在哪里停下来发问。
那几个停顿,就是下一版应该优先修改的地方。
04同一个模型,也值得先试试换一份说明
遇到AI选错数据,你可能第一反应就是换更强的模型。
这当然是一个选项。但还有一个成本较低、值得先做的测试:模型保持不变,换一种提供材料的方式。
第一次,只给原来的页面和目录。
第二次,补上一份经过负责人核对的说明,把测量对象、文件关系、使用条件和已知问题写清楚。
两次都问同一个问题。看它是否选对候选、是否找到正确文件、是否主动指出未知条件。
如果第二次表现改善,你就知道问题里至少有一部分来自材料组织。如果仍然出错,再逐项查是说明没写清、工具没有接好,还是模型理解不到位。
这比反复修改“你是一位资深科学家,请严谨分析”更容易定位原因。
做比较时,还有个小细节:先准备好你要检查的答案。
例如,刚才那道温度任务,可以提前写下四项:是否区分了地表温度与近地面气温;是否检查了时间分辨率;是否指出缺测;是否保留待确认条件。
然后再看AI回答,不要等它写完一大段漂亮文字,才临时决定“好像不错”。
研究方向越专门,越需要熟悉数据的人参与这一步。AI可以协助整理证据,但不能凭空决定一份测量是否适合某个科学问题。
05数据越来越多,解释数据的人会更值钱吗?
这件事最后会落到一个很现实的问题:谁来维护那些说明?
文件能长期存着,使用知识却常常跟着人走。
“这批有个特殊情况”“那列当时换过单位”“这个脚本只处理过某一类样本”——这些信息如果只存在于一次口头交接里,下一个使用者很可能再踩一遍。
把它们整理出来,是一项需要领域知识的工作。
你得听懂数据负责人在说什么,找到能对应的记录,再把它写成别人能够执行和核对的步骤。遇到矛盾,还要把问题送回原处确认。
做得好不好,也可以用很具体的结果来检验。
新同学第一次找到正确文件花了多久?合作方追问了几轮?出现错误后能不能定位到输入和处理步骤?换一份数据后,说明是否仍然适用?
这些都比“我们已完成智能化升级”更容易让使用者感受到差别。
对科学数据工厂来说,我更愿意从这样的服务开始设想:围绕一个具体领域,把一批真正需要反复使用的数据,整理成有人维护的可用材料。
先找一个反复发生的问题,再把它解决到下一位使用者能用。
把成功的做法留下来,把失败的地方记下来。后来接入的科研Agent,才有机会从这些积累中受益。
06现在就能做的一次小检查
打开你最常用的那份数据,不要改文件,也先别让AI清洗。
试着回答下面五个问题。
一行到底代表一个人、一个样本,还是一次测量?
最容易看错的那一列,含义和单位写在哪?
两个文件之间,靠什么对应?
第一次使用的人,应该先跑哪个最小例子?
什么情况下,这份数据不适合回答他的问题?
如果你每次都得亲自解释,那些答案就值得被写下来。
SciDSK提供了一个观察角度:当科研开始交给Agent协作,数据周围那层“怎么找到、怎么理解”的知识,也该变成可以持续维护的工作成果。
你遇到过最离谱的数据说明是什么?只有一句“详见论文”,还是一个叫“最终版2”的压缩包?欢迎评论区交流。
参考与图片来源
Xiaohan Huang等,Scientific Data Skills: Enabling Agent-Ready Scientific Data Services at Scale,2026年9月7日更新。https://arxiv.org/html/2608.19625v2
图1为该论文Figure 1,用于本文对数据发现与解释问题的评论,版权归原作者;本文未翻译或转载论文全文。论文数字为作者报告。本号未独立复现。温度数据的候选A/B/C及操作情境均为本文设计的教学例子,不对应真实数据集,也不是论文实验。AI辅助整理与写作。