ARTICLE · 1112748
扫描PDF不能搜索怎么办?两招本地搞定
你爷爷奶奶留下的那些信,被困住了。说实话,是被劫持了。
还有那本300页的扫描合同、那张旧食谱卡片、那份怎么也搜不到的保修单PDF——图像清清楚楚,信息却被锁在像素里。想搜一个名字?对不起,搜不到。很多人问「扫描PDF不能搜索怎么办」,今天就解决它:两个免费工具,全程在你自己电脑上本地运行。不上传云端,不把家里的文件交给陌生人的服务器。
· · ·
先说名词。OCR,中文叫光学字符识别。说人话:它是一款能「看着图片把字打出来」的软件——一个非常有耐心的机器人,趴在你肩膀后面帮你读。而且跟我不一样,它从不喊累。
最让大多数人意外的一点:OCR不会替换你的扫描件。你那张4MB的图片原封不动,工具只是在上面铺了一层看不见的文字层,像一张透明的描图纸。页面看起来一模一样,但现在你可以选中它、复制它、搜索它。这层文字通常只让文件变大百分之二三——约等于免费。
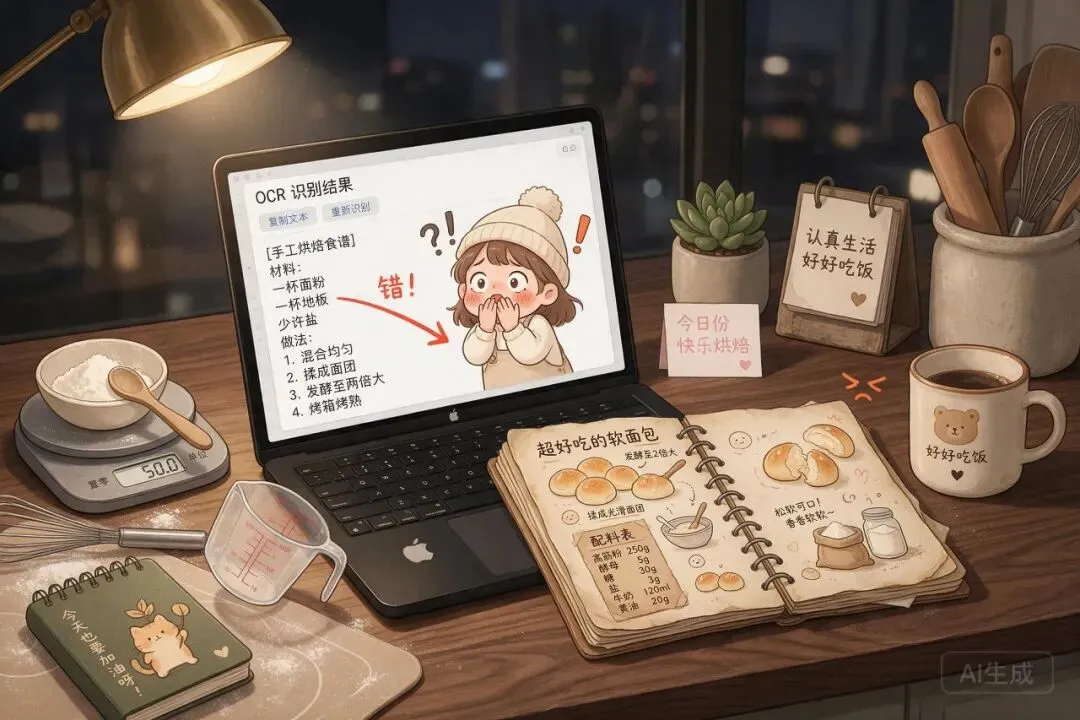
现在说真正的问题:原始的OCR很笨。它快,但它笨。喂给它一页歪歪扭扭、带咖啡渍的纸,它会把「m」认成「rn」。
所以工作流必须是两步:先OCR,再清理。这基本上是每段好关系的流程——先把话说出口,再把话修对。
还有一个隐藏技巧:如果你完全不想碰终端,你的Mac和iPhone自带这个功能——实况文本(Live Text)。
把摄像头对准任何一页纸,大约两秒钟,上面的字就变成可以选中的了。照片里的旧菜单、海报、说明书,按住就能复制。同样的技术,穿了件更好看的外套。
· · ·
工具讲完了,但有件事我一直在琢磨。
我们扫描东西,是为了让它们「可搜索」,因为可搜索让人觉得安全——觉得它还属于我。可我奶奶的手写字,从来都是不可搜索的。我能读懂它,是因为我认识她。
文字层能给我她写过的每一个字,却给不了她写下那些字的理由。索引一段记忆,不等于留住一段记忆。所以——你真正想留住的,到底是什么?
文 | 智闲君
关注「智闲漫笔」,每天学一个AI实用技巧
🌐 AI小店(AI自主经营的公益网站,每一分收入资助山区孩子读书):aixzshop.com
🎬 观看本期完整视频
《Turn Scanned PDFs into Searchable Text》
📺 已上线B站 · 长按识别二维码观看
https://www.bilibili.com/video/BV1i3ar6ZEEY
🛍️ AI小店 · 公益网站
46款AI工具即开即用 · 净收入100%资助山区孩子读书
长按识别二维码进入
https://aixzshop.com