ARTICLE · 1118806
央国企 AI 落地:钱不缺,缺的是趟过坑的人
9 月底的一场会上,一位大型央企集团的管理层说了这样一句话:「人工智能不是一次工具层面的引入,而是关乎企业长远竞争力的战略变量。」
这话本身不算新鲜。新鲜的是台下的反应——没有人再问「要不要做」。用会上另一位嘉宾的话说,讨论的重心「不再是要不要做,而是怎么落地」。
但同一天下午的圆桌上,另一位嘉宾说了另一句:「不少企业号称做了几十个智能体,Token 消耗量却撑不起来。」翻成大白话就是:东西做出来了,没人在用。
这两句话摆在一起,是央国企 AI 落地的全部张力。这一篇不聊技术选型,只回答一个问题:共识有了、钱也不缺、人也有,为什么还是落不下去——以及为什么最后收拾残局的,常常是外人。
共识不用讨论,钱也不缺
卡住央国企 AI 的,从来不是缺模型,是没人替它把前面的路先趟过一遍。
本文你会看到
01钱花了,AI 没进报表
02不是模型不行,是三层人想的不是一件事
03那 5% 做对了什么:里程数
04两个现场:从「演示完搁那」到「嵌进流程」
05四层体系:让懂技术的人靠近业务
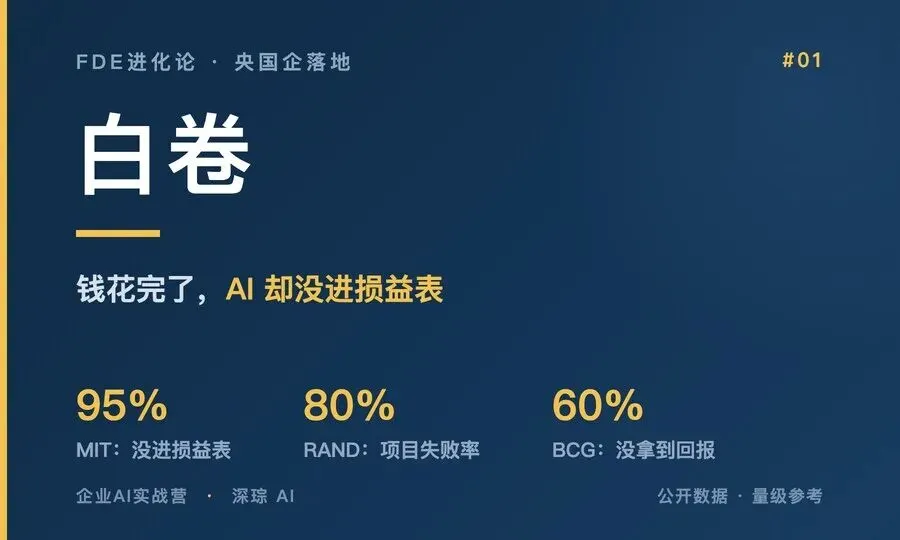
先摆三组数字。过去两年,三家不同机构各自独立做了调查,结论惊人地一致:大多数企业的 AI 投入,没换来可衡量的商业回报。
最尖锐的是 MIT。那份《The GenAI Divide》报告分析了 300 多个公开 AI 项目,结论是 95% 的企业生成式 AI 试点,没能在损益表上留下任何可衡量的痕迹。
RAND 的说法留了余地:援引多方估算,超过 80% 的 AI 项目会失败——是普通 IT 项目的两倍。
BCG 去年 9 月问了全球 1250 多家企业:60% 的公司有实打实的投入,却没拿到实质回报。
这三个数字得一起读,不能挑一个当铁律。它们量的其实不是同一件事:MIT 量的是「六个月内有没有进损益表」,RAND 自己写的是「by some estimates」,BCG 量的是「有没有达到规模化的价值」——那是个很高的门槛。把它们摞起来看,指向的才是同一个事实:从试点到产出,中间有一道大多数项目跨不过去的沟。
央国企要跨的沟,还比一般企业深一截。它们最有价值的 AI 场景,不是已经跑通的通用办公,而是容错空间极小的核心业务——对准确性、安全性、稳定性和自主可控的要求,都远超一般行业。
MIT 那份报告还给这道沟起了个名字,叫「学习鸿沟」:工具不进工作流、不攒反馈、不跟着企业的实际业务长大。工人周一纠正过的错误,周五同一个工具还会再犯一次。信任一旦断掉,就再也接不回来。
所以这一节的判断是:AI 落地卡住的地方,几乎从不在模型里。通用工具在演示里都好用,一进真实业务就现原形——问题不在它聪不聪明,在它有没有被真正接进这套业务。
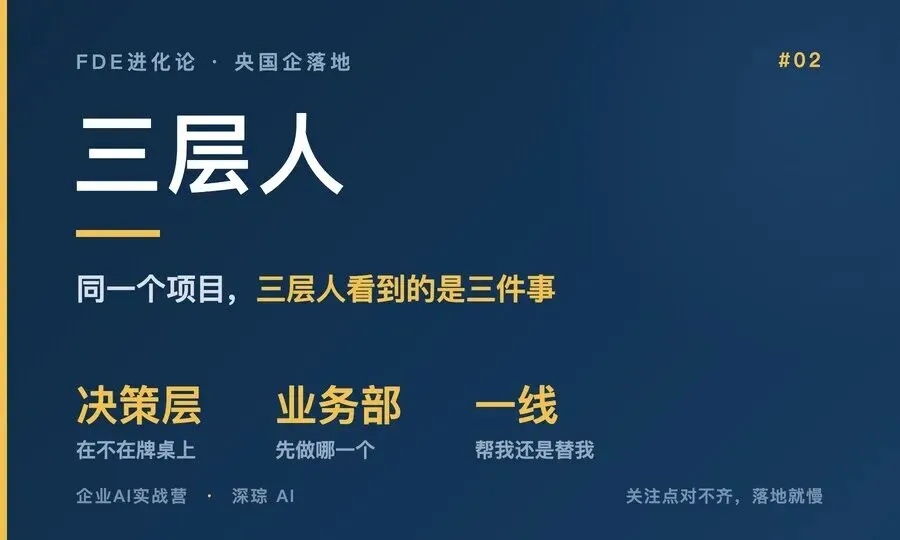
落地到底卡在哪一层?会上有个观察很实在:同一个项目,企业内部三层人看到的是三件不同的事。
决策层看到的是战略机遇和政策要求,关心的是「我们在不在牌桌上」;业务部门面对的是场景选择和流程改造的压力,想知道「到底先做哪个」;一线员工关心的是 AI 会帮忙还是添乱。
三层关注点之间的落差,本身就是落地速度的隐性上限。有嘉宾坦言,央国企的 AI 应用在深化推进里,还存在「重试点、轻推广」的问题。
那「几十个智能体、Token 撑不起来」是怎么来的?答案就在这三层的缝里——每个部门都做了一个给自己看的演示,没有一个被嵌进日常流程。
第二道坎是速度差。主流大模型的版本更新周期,已经压到四到六周。这是技术红利,也是风险——任何预先规划好的方案,都有滞后的可能。
而央国企的决策链条长、采购流程重,传统项目制的交付节奏,很难跟上模型迭代的速度。方案批下来的时候,它参照的那版模型,可能已经过时了。
第三道坎是人才。AI 人才本来就稀缺,既懂 AI、又懂行业的复合型人才更稀缺,供需缺口短期靠招聘填不平。
所以这一节的判断是:这三道坎,没有一道能靠「再买一个更强的模型」解决。
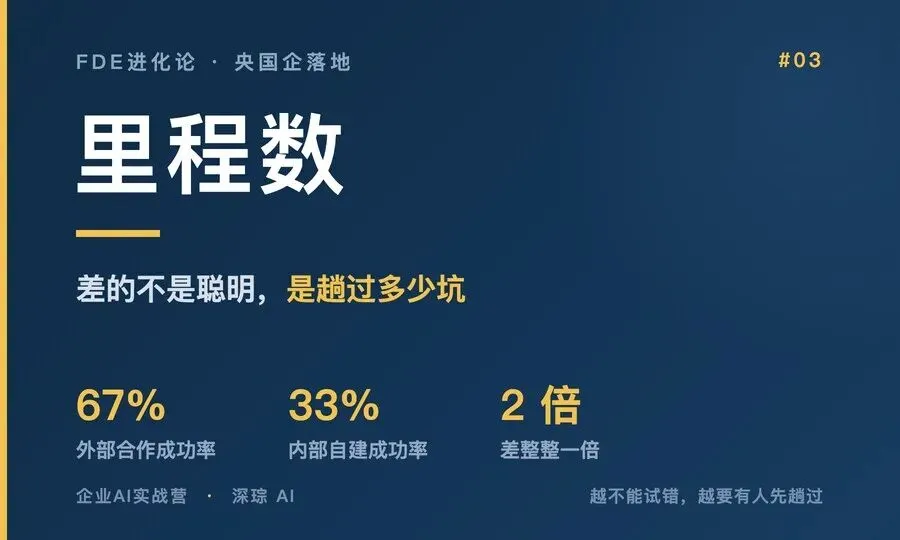
回到 MIT 那组数字。报告里还有一条更值得琢磨的线索:在那 5% 成功跨过试点的企业里,用外部合作方方案的成功率约 67%,自己内部做的只有 33%——差了一倍。
研究者的解释很直接:外部合作方的优势,不在智力更高,而在里程数。他们趟过的部署足够多,从失败里攒下了经验,知道哪几条弯路可以不必走。
这里必须补一句报告自己的限定:这些是受访者的自报口径,各家对「成功」的定义也不统一,相关不等于因果。我们把它当一个参考,不当一个保证——但方向是清楚的。
为什么「里程数」在央国企身上更值钱?因为越是不能轻易试错的场景,越需要有人先把路趟过一遍。合规要求高、试错空间小,一次翻车的代价,可能比省下的那点外脑费大得多。
一个合格的模型,网上到处都是;一段「这条路我走过、这里是坑」的经验,买不到。外部合作方卖的不是模型,是里程。
顺带说一句:会上有人提到,企业内部那些既懂技术、又天天泡在业务里的人,其实就是「面向业务的前线部署工程师」——FDE。他们攒的也是里程,只不过攒在自己公司里。
所以这一节的判断是:一个外部伙伴值不值钱,别看他讲得多漂亮,看他在这类场景里趟过几趟。
会上几位企业代表分享的案例,有一个共同点:没有人讲一个「有也行、没也行」的场景。
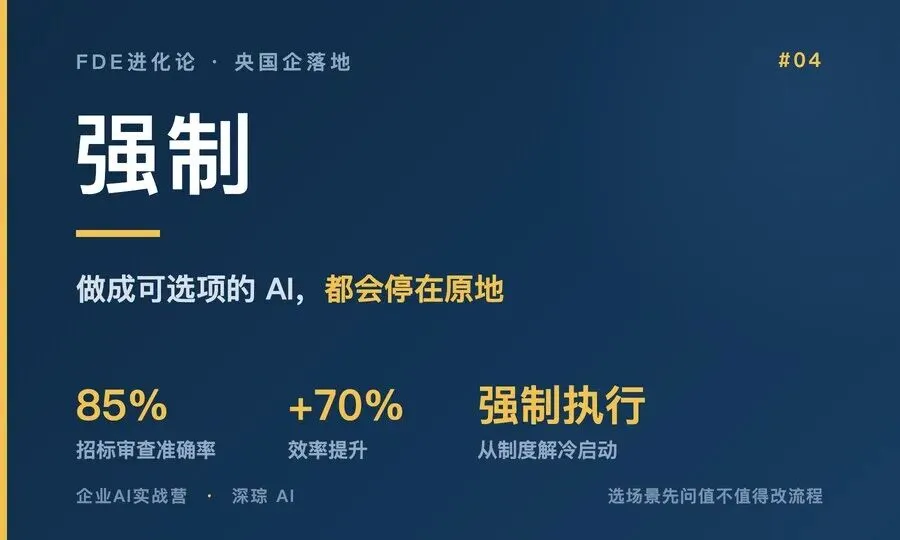
第一个在采购供应链。有企业用 AI 做招标文件智能审查,准确率做到 85% 以上,效率提升 70%。
更值得记的是另一个动作:它被嵌进了业务系统,强制执行。为什么?因为辅助决策类的 AI 工具一旦做成可选项,员工就能用、也能不用;一旦不用,系统就收不到迭代数据,模型就停在原地。
把审查助手设成流程里的必经环节,等于用制度解决了冷启动——不是说服人去用它,而是让它成为绕不过去的一步。
第二个在通信设备制造。一根光棒,也就是光纤预制棒,综合成品率从 50% 多提到了 98.5%。
靠的不是更好的模型,是业务专家、数据工程师、算法工程师坐在一起,迭代了两三年——先把工艺数字化,再往上叠 AI,模型才攒够了足够的工艺知识。
这两个案例隔行如隔山,但结构一样:问题复杂度和人力处理能力之间的落差,大到值得动员组织资源、让 AI 真正嵌进工作流。做完演示就束之高阁的场景,自然走不过试点期。
所以这一节的判断是:选场景的第一问不是「能不能做」,是「这个问题值不值得让组织为它改流程」。
这些案例能跑通,靠的不只是模型能力,还有组织能力。怎么把懂技术的人放到离业务最近的地方,是比追着模型跑更重要的议题。
会上总结出的,是一套四层协作体系。每一层都在做同一件事:让掌握技术能力的人,更快靠近业务发生的地方。
第一层,外部伙伴与数科公司之间。许多央国企都有自己的数字化子公司,它们是对接外部能力的窗口。外部方负责工程能力和模型调优,客户团队负责业务知识和数据资产,各出所长。
第二层,数科公司与母体企业之间。两边各有各的知识体系,需要找到共同语言。数科有模型能力,但模型要靠母体的业务数据来喂养——数据不流通,模型就长不大。
第三层,企业内部 IT 与业务部门之间。技术侧和业务侧各说各话,中间缺一个翻译——这个翻译,就是前面说的 FDE。
第四层,行业与行业之间。不止一位发言者提到,场景经验不该只留在企业里:一家企业踩过的坑,不该让下一家重新踩一遍。会上有一句话很到位:「场景的经验,就是行业的能力。」
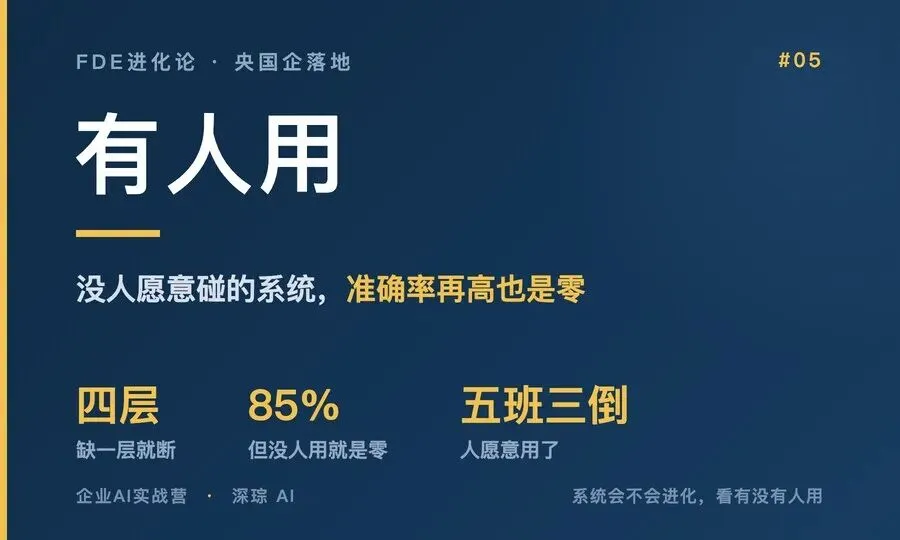
四层说到底靠人。会上有人提了一个很实的角度:怎么让用 AI 的人有获得感。
他举了个例子:一个垃圾焚烧厂上了智能控制之后,操作班次从四班三倒变成五班三倒,年轻员工愿意在产线上和 AI 一起干了。
这句话值得抄下来:一个准确率 85%、但让员工觉得「有人在帮我」的系统,会不断进化;一个没人愿意碰的系统,准确率再高也是零。
所以这一篇的判断标准,收成一条:判断一份 AI 投入值不值,不看它多聪明,看它有没有被真正嵌进流程、有没有人愿意每天用它。
本文案例与数字,来自 2026 年 9 月 29 日公开报道《央国企 AI 落地,胜负手在现场》(至顶头条,作者高飞),以及 MIT、RAND、BCG 三家机构公开发布的研究报告。报道中的企业案例均未披露企业名;文中数字为各机构公开口径,非深琮实测、不构成任何效果承诺。判断标准与自有经验对照部分,为深琮观点。
方案能抄,里程抄不了。
回到开篇那两句话——共识早就拿到了,钱也不缺。真正稀缺的,是替你把弯路先走过一遍的那个人。
这周先做一件事:
四件事,这周就能开始
场景先筛:把手上的场景过一遍,砍掉「有也行没也行」的,只留问题复杂度和人力落差最大的那一个。
强制嵌入:别做成可选项,做成流程里的必经环节——可选项永远停在演示。
业务进组:让业务骨干进到调优环节,不是交付完再培训。
攒里程:把每一个坑记下来,那是你下一次报价的底气。
四件做完,再谈模型够不够强。
晚一轮的代价不难算:模型四到六周迭代一次,你的方案每搁一个月,就得重新评估一次。而别人趟过的坑,不会停下来等你。
你手上那个项目,是卡在技术上,还是卡在没人趟过这条路?评论区写下来。
转给你身边那个正在推 AI 落地、又总觉得哪里不对的同事