ARTICLE · 1118815
AI开始跟你“面对面”了:Griffin会点头、插话、看懂镜头,48%的人以为它是真人
如果有一天,你妈突然接到你的一个视频电话。
屏幕里就是你的脸,声音也是你的。
你说:“妈,我这边出了点事,先给我转2万块钱。”
她怀疑了。
于是故意打断你:“等等,你现在到底在哪?”
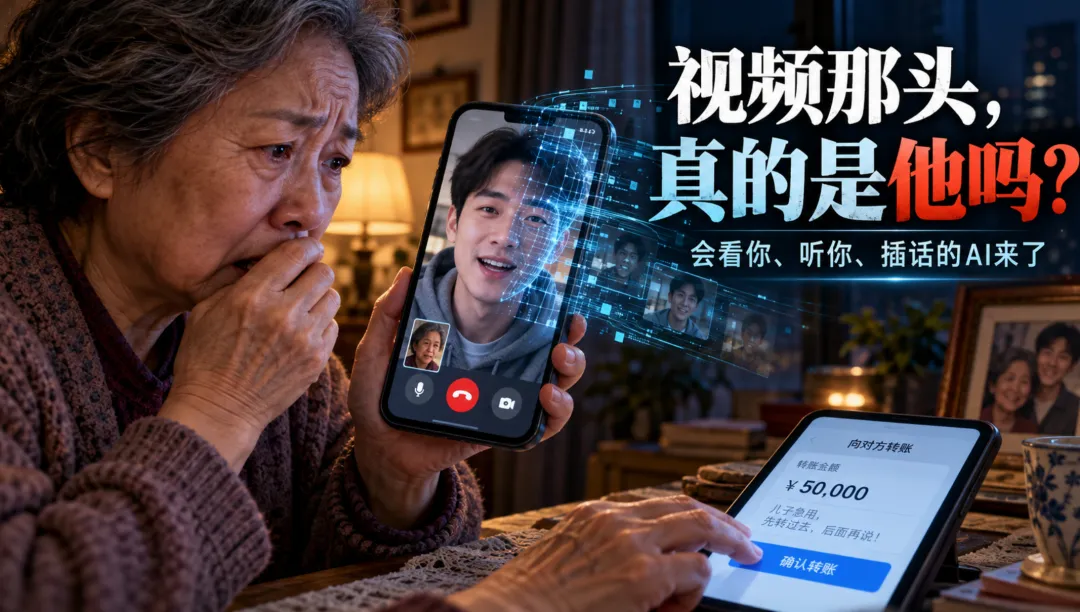
屏幕里的“你”马上停下来,看着她回答。
她还是不放心,又拿起桌上的一个东西问:“这个你看得到吗?”
“你”也能看到。
她皱眉的时候,你跟着放慢语气。
她没说话,你也没有机械地继续往下念,而是等了一会儿:“妈?你还在听吗?”
这时候,她还会觉得对面是AI吗?
过去我们教父母防诈骗,最后往往还有一招:
“别听声音,直接让他开视频。”
但10月1日,一个叫Griffin的AI出现后,这句话可能真的需要重新想一遍了。
因为它已经不是我们熟悉的那种:套着一张真人脸的AI数字人。
它最特别的地方是——它能一边看着你,一边听你说话,同时自己还在说话。
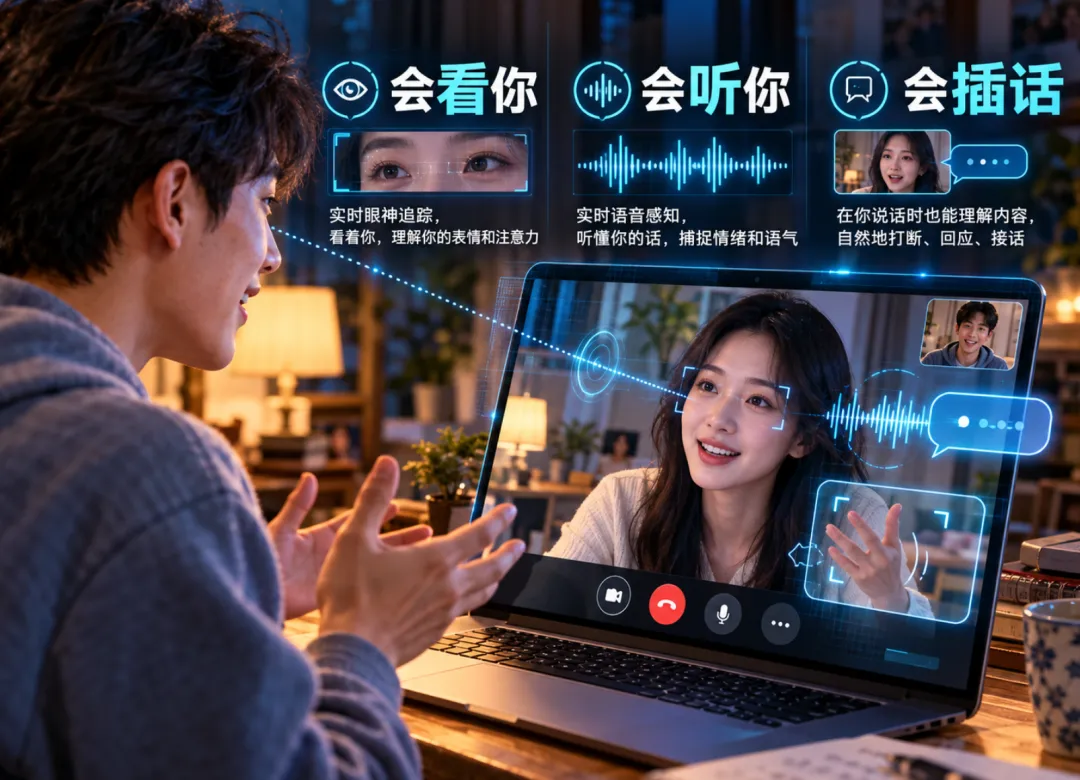
你可以打断它,它也可以插话,你停顿,它知道等。
你拿东西给它看,它能够反应。
甚至你还没说完,它就可能点头、笑、发出“嗯哼”这样的回应。
这已经不是“生成视频”了。
它开始模仿的,是:人和人面对面交流的整个过程。
而Tavus公布的一项测试,更让这件事变得有点不一样。
54个人和Griffin进行了一分钟实时视频聊天。
聊天结束以后,26个人认为刚才和自己聊天的是真人。
比例:48%。
差不多每两个人里,就有一个没有发现屏幕对面是AI。
但真正让我觉得这东西值得今天专门写一篇文章的,并不是48%。
而是:AI第一次开始攻击我们判断“真人”的方式。
01
Griffin和以前那些AI数字人,到底有什么不一样?
这才是最关键的问题,这几年AI数字人其实已经非常多了。
一张照片可以说话,克隆一段声音,嘴型可以对上,甚至皮肤、眼睛、头发都越来越像真人,但你只要真的跟它聊天,很容易露馅。
原因很简单。
过去很多系统,本质上是一条流水线:你说话—语音转文字—大模型生成答案—文字转语音—数字人开始张嘴。
所以整个过程其实是:你说完——它处理——它回答。
两个人轮流说。
你突然打断它,经常就会乱。
你犹豫半天,它可能不知道你到底说完没有。
你拿一个杯子放到摄像头前,它甚至不知道你为什么突然拿了个杯子。
换句话说:以前的AI像一个非常聪明的人,但隔着一道墙。
它只能等你把信息传过去,
再回答你。
Griffin不一样,Tavus把它做成了一个统一的video-to-video全双工系统。
什么意思?
用人话说就是:AI在说话的时候,没有“关掉耳朵和眼睛”。
它还在继续看你,继续听你。
继续判断:现在应该继续说?应该停一下?应该点头?应该插一句?还是应该等你把话说完?
官方披露,Griffin会以亚秒级的频率不断重新判断整个对话状态。
所以它可以出现很多过去AI很难自然做到的行为。
你讲话的时候:它:“嗯哼。”
你突然插嘴:它立刻停。
你讲了一个好消息:它还没等你彻底说完,表情就已经变了。
这听起来似乎只是一些很小的变化。
但恰恰是这些小动作,
组成了我们判断:“对面是一个真人。”
最重要的直觉。
02
更夸张的是:它生成的不只是“嘴”
很多传统AI数字人本质上是在驱动:脸,嘴巴,上半身。但Griffin官方展示的能力更进一步。
它可以从一张参考图片开始,实时生成整个画面。不是只改变嘴型,而是整帧生成。
身体、手臂、手指、动作甚至部分场景变化,都可以跟着发生。
官方甚至演示了一个非常有意思的案例:
和AI玩Simon Says。
真人做动作。
Griffin需要判断:
对方到底有没有说“Simon says”。
如果说了,它模仿,没说,它就不动。注意。
这里已经不只是:“AI听懂一句话。”
而是同时发生:看动作;听语言;理解规则;判断时间;控制自己的身体;最后实时生成视频。
另一个演示里,有人拿着魔方在镜头前操作。
Griffin可以看着魔方,
一边指导,一边等待对方完成动作,对方停下来,
它也知道:现在不是催促的时候。
这才是Human Interaction Model这个名字真正想表达的东西。
Tavus甚至没有把它叫:“更强数字人模型。”
而是直接给它创造了一个新分类:
Human Interaction Model
人类交互模型。
他们想做的根本不只是:“造一张更真的脸。”
而是:
让AI学会面对面和一个人相处。
03
这也是为什么那个48%,值得警惕
这次实验其实并不复杂。
参与者来自美国和欧洲。
他们被告知:会随机匹配另一个人,
然后进行一分钟视频聊天。
话题只是:“今年你最期待什么?”
对面实际上是Griffin-Lite驱动的AI。
脸是生成的,声音是生成的,回答是生成的,动作也是实时生成的。
参与者事前并不知道这一点。
一分钟之后,研究人员才问:你有没有想过,
刚刚那个人可能不是人?
结果:26/54的人认为对面是真人,也就是48%。
更值得注意的是:Tavus自己的上一代系统Phoenix-4.5,用类似测试方法得到的数字只有:2.4%。
从2.4%到变成48%。
当然,这个实验样本只有54人,而且来自Tavus公布的研究,不能简单理解为:
“现在48%的人类已经分不清AI和真人。”
这么说是不严谨的。
但它说明了一件更重要的事情:
AI露馅的地方,正在发生改变。
以前AI露馅,是因为:脸假,嘴型假,声音假。
现在这些问题越来越弱。
于是人们开始靠:反应。
你能不能听懂我?
能不能看见我?
我突然打断你,你怎么办?
我沉默的时候,你怎么办?
而Griffin现在做的,
恰恰是在补这一块。
04
然后,一个非常现实的问题就来了
如果这种技术被用于诈骗呢?
注意:目前没有证据证明Griffin本身已经被犯罪分子用于诈骗。
这件事必须说清楚。
但是,AI换脸+视频诈骗已经真实发生了。
而且金额并不小。2024年,香港发生过一起轰动全球的Deepfake诈骗案。
一家跨国公司的员工收到来自“英国总部CFO”的消息。
然后参加了一场多人视频会议。
会议里面,不仅有“CFO”,还有其他“同事”,脸是真的,声音也像。
会议也正常进行,最终,这名员工按照“高管”的要求进行转账。
损失:
约2亿港元。
后来香港警方调查发现,
骗子下载了公司高管公开的视频和声音资料,
再使用Deepfake技术制作了一段假的视频会议。
但这里有一个非常关键的细节。
当时那场会议主要还是:预录。
警方明确表示,由于使用的是预先录制的视频,
受害者实际上没有和“假高管”进行真正的自由对话。
也就是说,
骗子当时最大的弱点其实非常明显:
你真要临时问几个问题,他很可能就露馅。
结果即便如此,
仍然骗走了约2亿港元。
那么现在重新看Griffin。
问题就来了。
如果以后:
假老板真的可以听懂你的问题;
真的可以停下来回答;
真的可以看到你;
真的可以在你打断的时候闭嘴;
甚至可以根据你的表情改变语气……
我们过去用来识别Deepfake的很多“小技巧”,
是不是就会越来越难用了?
这才是这项技术真正值得讨论的地方。
05
AI诈骗正在从“伪造内容”,走向“伪造互动”
这是我认为Griffin最值得记住的一点。
过去的AI诈骗:伪造一张照片,伪造一段声音,伪造一段视频。
本质上都属于:伪造内容。
而下一步可能出现的是:伪造互动。
它不提前知道你要问什么。
但没关系。你问什么,AI现场回答。
你做什么,AI现场反应。
你质疑它,AI甚至可以继续解释。
这意味着未来攻击的,
可能不再只是你的眼睛和耳朵。
而是:你对“面对面交流”的信任。
FBI今年7月发布的警告里已经明确提到:
诈骗者正在利用AI生成视频进行实时视频聊天,
冒充公司高管、执法人员以及其他身份,
甚至通过视频来“证明”:
自己是一个真人。
今年9月,FBI再次警告:
新的AI技术已经能够帮助诈骗者在视频通话中冒充执法人员和政府官员,从而增加骗局的可信度。
所以这已经不是某部科幻片里的剧情。
技术路线已经出现了。
诈骗场景也已经出现了。
现在只是两者之间,
距离越来越近。
06
最值得警惕的一句话变了
以前老人被骗之后经常会说:
“我听到就是我儿子的声音。”
后来我们告诉他们:声音也能克隆。
于是变成:“但我看见他的脸了。”
我们又告诉他们:脸也能AI换。
于是很多家庭最后还有一个终极验证方式:
“那你开视频。”
这是我们用了很多年的心理防线。
因为正常人的直觉会觉得:
他能跟我实时说话,能听懂我,能回应我的问题,能看着我,那总该是真的吧?
Griffin最值得警惕的地方就在这里。
它正在告诉我们:
以后,连“实时互动”本身,都可能被生成。
所以未来真正危险的一句话可能变成:
“我都和他视频聊了五分钟了,怎么可能是假的?”
答案是:不能仅凭这一点确认。
07
那普通人以后到底该怎么防?
其实原则反而应该越来越简单。
不要试图和AI比:“我能不能看出破绽。”
因为今天你能看出的东西,明天模型可能就修掉了。
真正有效的办法,是:
不验证“长得像不像本人”。
验证“这次行为是不是本人发起的”。
比如:儿子突然视频找你借钱。
不要继续在这个视频里验证。
直接:挂掉。
然后用你原来保存的电话号码,重新打给他。
老板突然让你转100万元,哪怕摄像头里的老板:会笑,会骂人,甚至知道公司的事情。
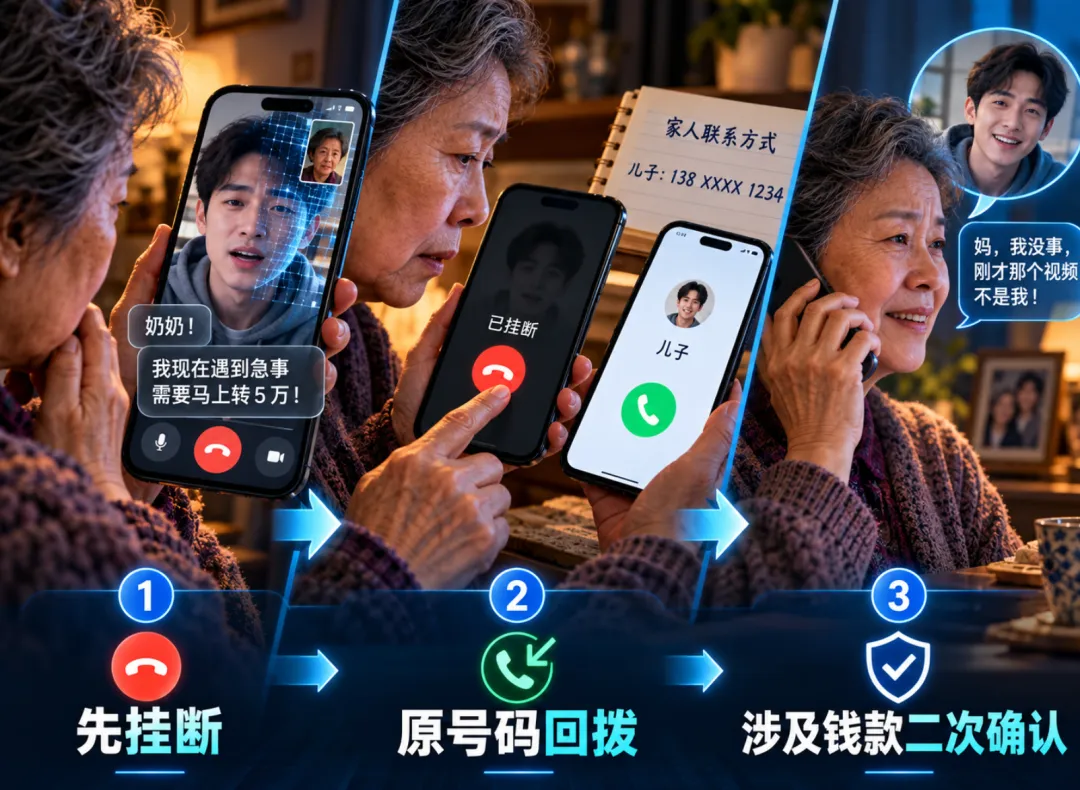
原有的财务审批流程,一个都不能少。
FBI的建议也是类似:不要只相信视频本身,要通过已知、可信的独立渠道重新验证身份。
这可能才是AI时代真正有效的反诈逻辑。
最后
我一点都不认为Griffin是一项“邪恶技术”。
恰恰相反。
想象一下它真正成熟以后:
一个AI老师能看出学生皱眉,
知道:“他没听懂。”
然后马上换一种讲法。
一个维修AI能看着你手里的机器,
告诉你:“不是那个螺丝,是左边第二个。”一个陪练AI,
甚至能看着你的眼神、停顿和紧张程度,
陪你进行真正的面试训练。
这可能会是一个非常大的交互革命。
我们过去和电脑交流:鼠标、键盘、触摸屏。
后来变成:聊天框,而Griffin代表的下一步可能是:电脑不再等你下命令。
它直接坐在你对面,看你,听你,和你说话,理解你的表情。
甚至知道什么时候应该闭嘴。
这很强。
也正因为太强,
它才值得我们提前讨论另一面。
过去互联网教我们:不要相信陌生短信。
后来是:不要相信陌生电话。
AI时代又加了一句:不要仅凭声音和视频确认身份。
而Griffin之后,
我们可能还需要再加一句:
即使对方能看着你、回答你、被你打断,甚至和你聊了五分钟,也别让“像真人”代替真正的身份验证。
因为AI正在跨过一道过去很少有人想过的界线:
它不再只是生成一个假的人。
而是开始生成——“一个和你相处起来像真人的人。”
这,才是Griffin真正值得我们注意的地方。