ARTICLE · 1119201
ExcelSQL 编辑器大重构:纯 C 换心,百万行写入 2.88 秒
最近我又干了一件事:把之前在 Excel 里写 SQL 的插件,从里到外重构了一遍。
老读者可能记得,我之前用 Codex 开发过 SQL Lab——一个让你在 Excel 里直接写 SQL 查表格的工具。这次我以 Claude 为开发主力,参考 SQL Lab 的现有代码和架构,换了一颗更轻的"心脏"(嵌入式 XLL),重新打造了 SQL Editor。
中间还有个插曲:我的 Claude 账号莫名其妙被冻结,对话数据也丢了,挺闹心的。但有一说一,它开发出来的插件确实给了我惊喜——无论界面美观度还是功能完善度,都上了一个台阶。
这篇文章分两部分:前半讲重构改了什么,后半把新插件的函数用法一次讲透。
01 换心脏:从"层层套娃"到"一脚直达"
最根本的变化是嵌入式引擎换了。之前的 SQL Lab 本质是对 xlDuckDb 的封装,有两个重要依赖——.NET 8 和 Excel-DNA。你在 Excel 里按一下重算,数据要走七站路:
Excel → Excel-DNA XLL → .NET 8 runtime → xlDuckDb.dll → DuckDB.NET.Data → DuckDB.NET.Bindings → duckdb.dll
而新插件 DuckDBExcelAddin 不需要 .NET 8,也不需要 Excel-DNA,纯 C 语言开发,路线直接砍成四站:
Excel → DuckDBExcelAddin.xll → DuckDB C API → duckdb.dll
通俗地讲:同样是 DuckDB 计算引擎,核心计算速度一样,但新插件在"插件加载"和"大结果集搬运"两个环节路程更短,所以整体更快。就像两家餐厅用同一个厨师,一家上菜要转手三个服务员,另一家厨师直接端到你桌上。
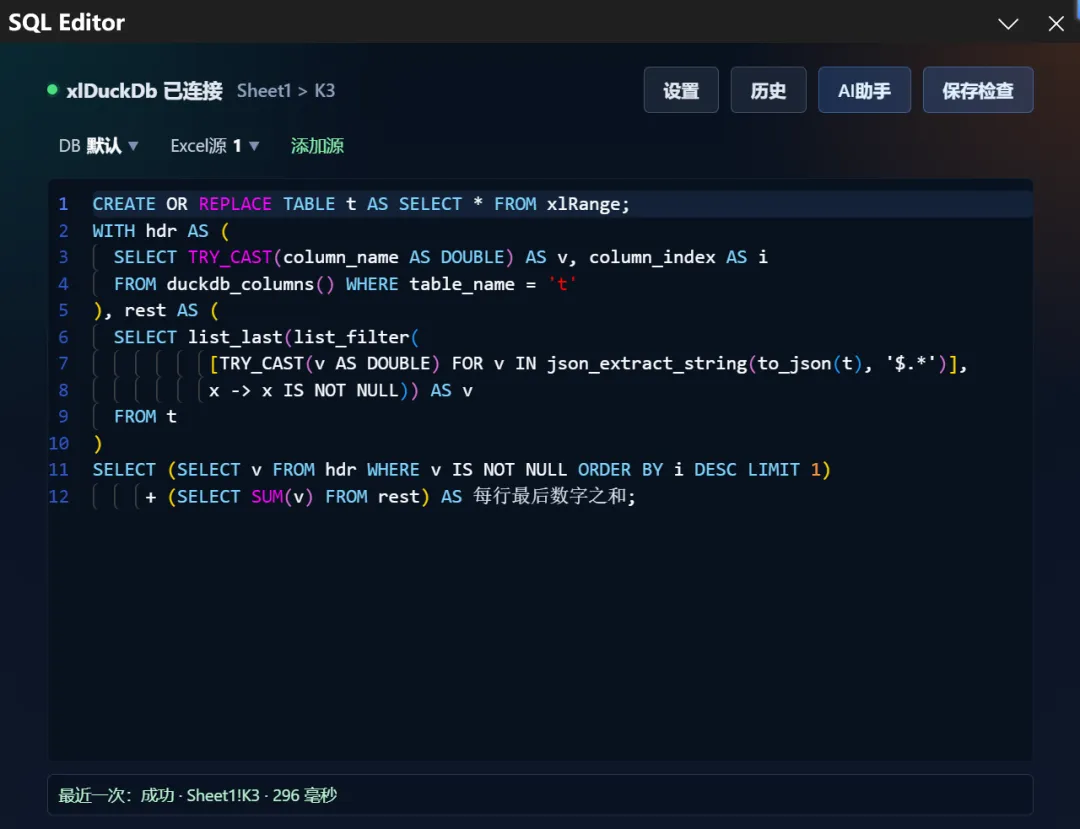
▲ 旧版 SQL Lab:基于 xlDuckDb(.NET 路线)
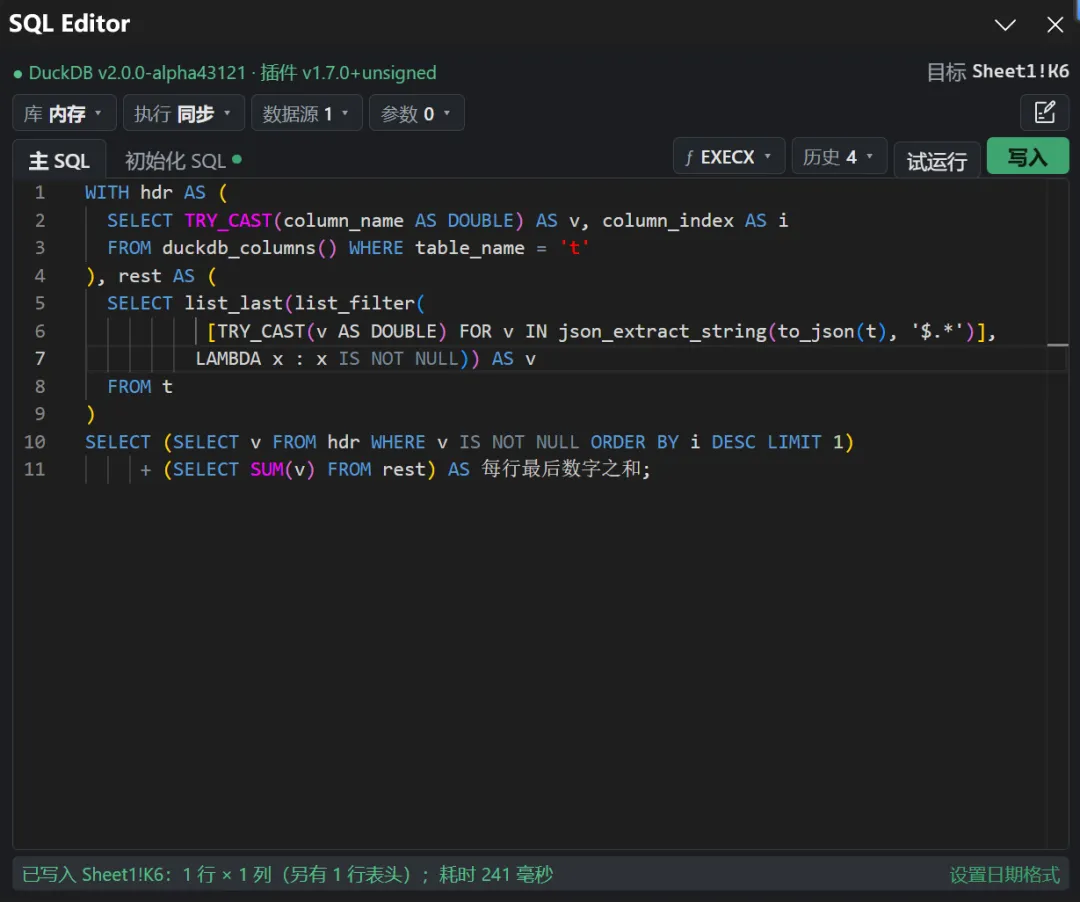
▲ 新版 SQL Editor:基于 DuckDBExcelAddin(纯 C 路线)
02 一个例子,看懂函数强了多少
旧版 xlDuckDb 只有一个 DuckDbQuery 函数,简单是简单,但制约不少。举个最常见的痛点:它默认把导入区域的第一行当表头。如果我想把表头"降级"成普通数据行(类似 Power Query 里的 Table.DemoteHeaders),用纯 SQL 实现要写成这样:
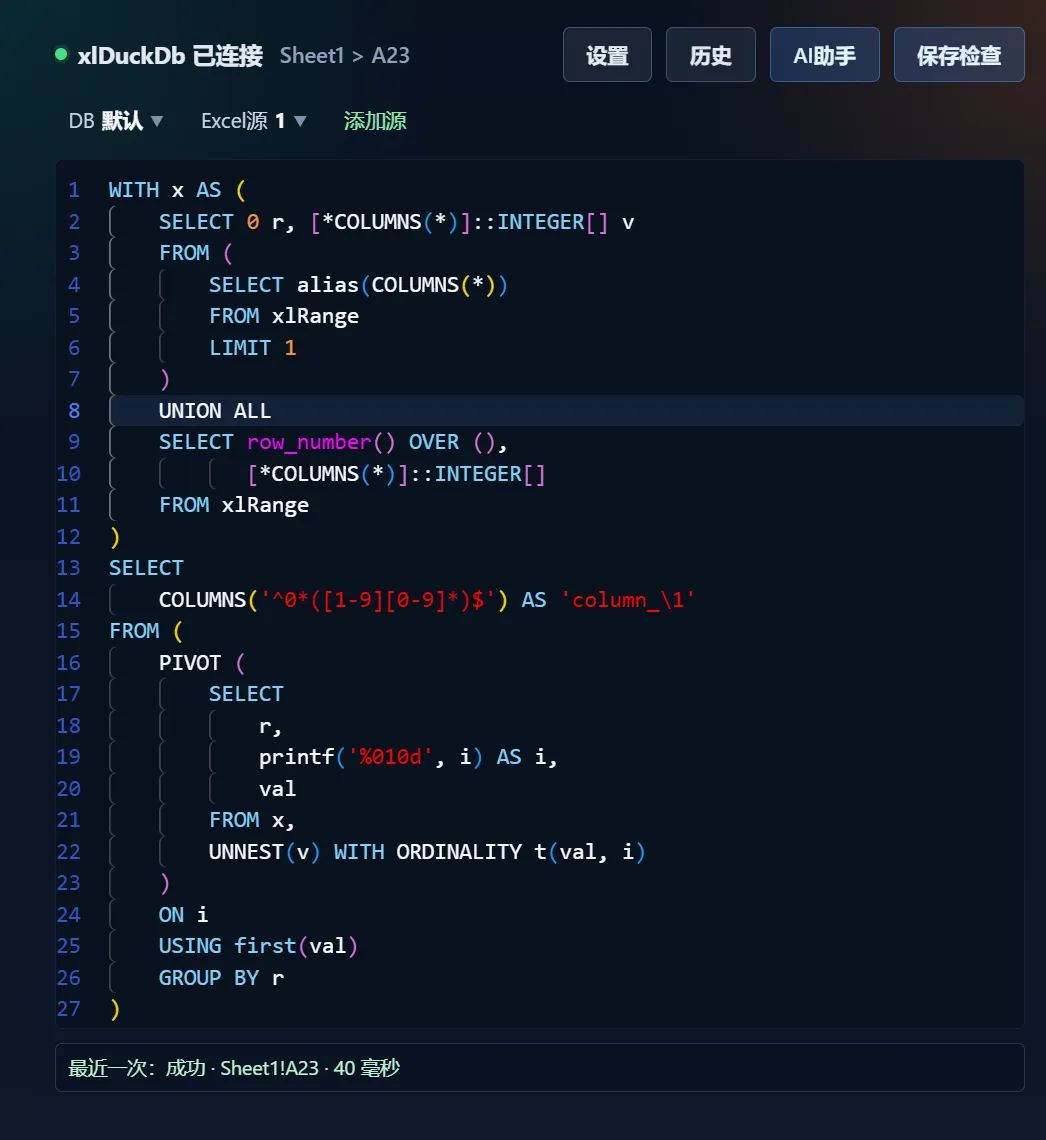
▲ 旧版实现「表头降级」:CTE、PIVOT、UNNEST 全用上,27 行 SQL
27 行,写出来我自己都要核对三遍。而新版,一个参数搞定:
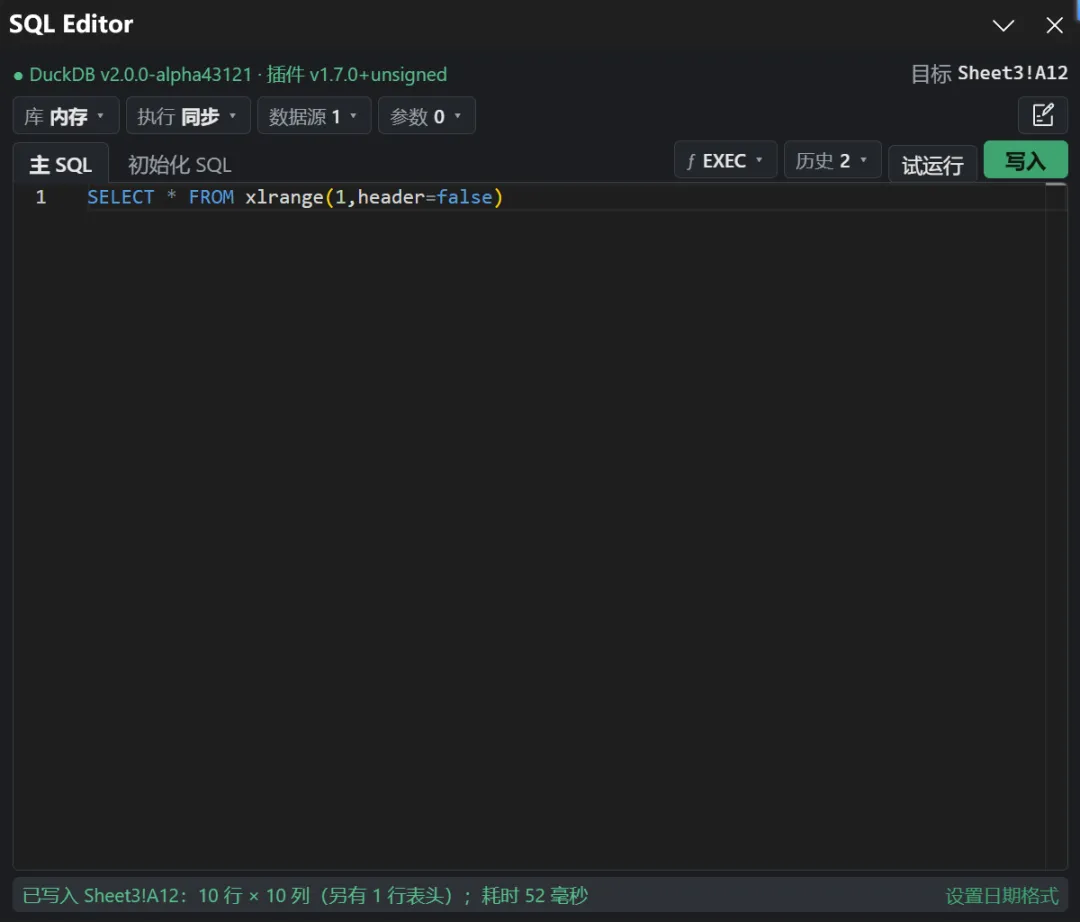
▲ 新版:xlrange(1, header=false),一行收工
两个引擎的能力对比,一张表看全:
| 特色 | DuckDBExcelAddin(新) | xlDuckDB(旧) |
|---|---|---|
03 函数用法(上):一条公式的三个位置
从这一节开始讲用法。新插件写入单元格的就是一条普通 Excel 公式,随工作簿保存。以最常用的 DUCKDB.EXEC 为例,它的三个位置各管一件事:
=DUCKDB.EXEC(
"SELECT … FROM xlrange(1) WHERE 区域 = ?", ← ① SQL 文本,用 ? 占位
A1:D9, ← ② 数据区域,第 n 个 → xlrange(n)
H1 ← ③ 参数,第 n 个 → 第 n 个 ?
)
执行过程就四步:Excel 把区域交给引擎 → 引擎把它当成一张「表」(首行变列名,列类型按前 30 行推断)→ 在 Excel 进程内执行 SQL → 结果自动"溢出"铺回单元格。全程不联网,数据不出本机。
一个容易踩的坑:区域永远写在参数前面。引擎按内容类型分拣——多个单元格算数据区域,单个单元格、数字、文字算参数。所以只选一个单元格当数据源是不行的,它会被当成参数。
04 函数用法(中):xlrange,数据源的灵魂
公式里每添加一个区域就多一个编号:第 1 个叫 xlrange(1),第 2 个叫 xlrange(2)……SQL 里按编号取用,两张表 JOIN 也就是一句话的事:
SELECT a.客户, b.等级, SUM(a.金额) AS 总额
FROM xlrange(1) a
JOIN xlrange(2) b ON a.客户 = b.客户
GROUP BY a.客户, b.等级
xlrange 真正的威力在第二组参数——读取选项,一共 5 个:
| 选项 | 作用 | 典型场景 |
|---|---|---|
为什么要有 sample 和 ignore_errors?因为引擎默认只拿前 30 行给每列判定类型。如果"金额"列前 30 行都是整数、第 42 行却填了文字"待核实",整列被判成 INTEGER 后读到第 42 行就会报错。这时三个选项就是你的三条退路:全部行推断、按文本读、不符置 NULL。
1.7.0 版本还新增了列的"谓词下推":导入的表有几十列、计算只涉及一两列时,它只取相关的列来算,不做无用功。
在编辑器里输入 xlrange,联想只给这个函数自己的参数,下面还带中文说明:
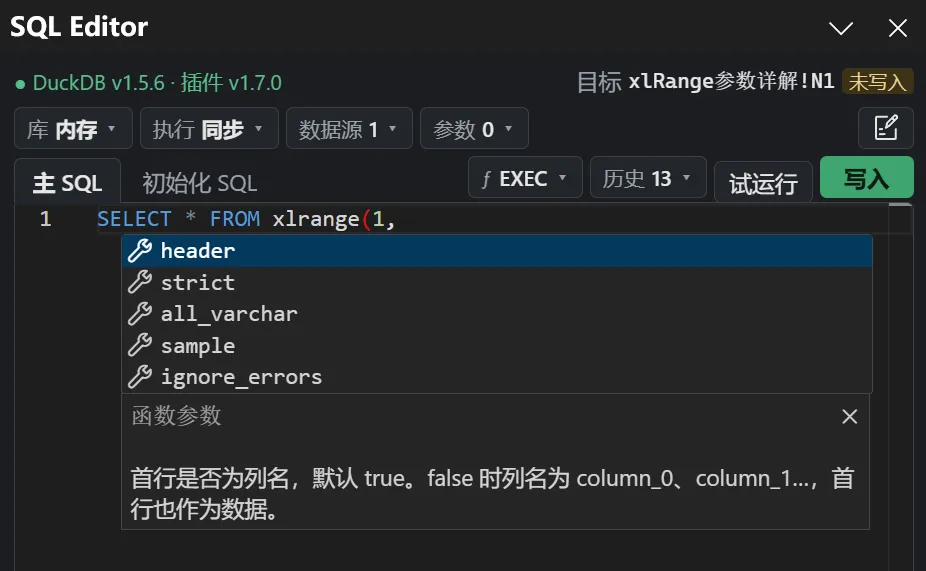
▲ xlrange 的针对性参数联想:只给这 5 个选项
不想手写参数也行,每个数据源后面的 ⚙ 点开就是勾选式设置,改动自动同步进 SQL:
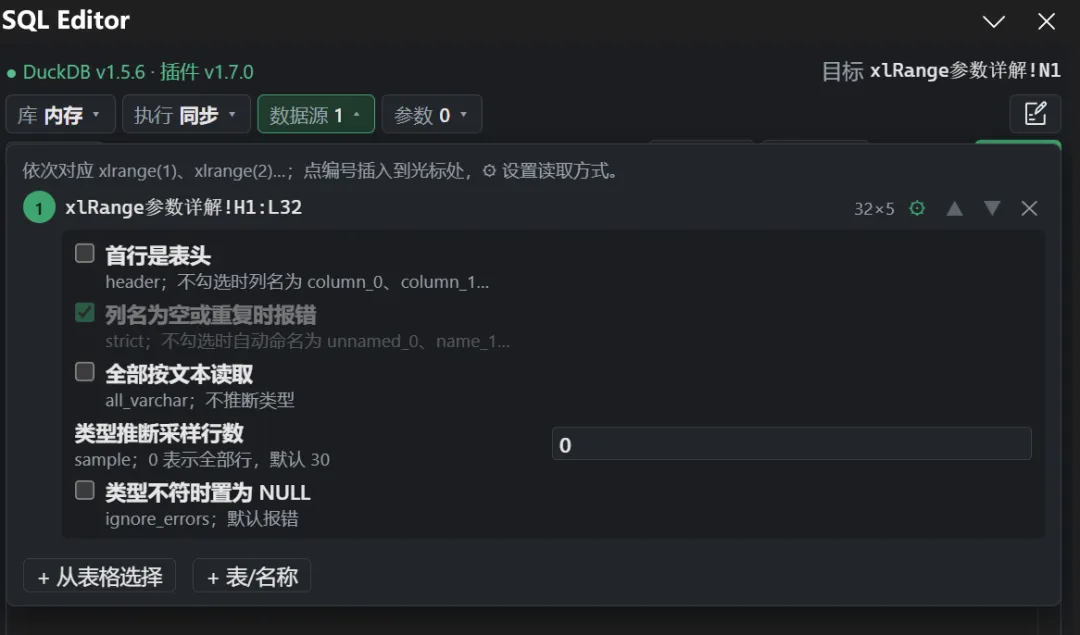
▲ 数据源读取选项:勾选式设置,自动写进 SQL
05 函数用法(中):参数 ?,把单元格带进 SQL
SQL 里写 ? 当占位符,公式后面填一个单元格。改一下这个格子,结果就跟着重算——不用改 SQL:
SELECT 客户, SUM(金额) AS 总额
FROM xlrange(1)
WHERE 区域 = ? ← 参数指向 H1,H1 填"华东"就查华东
GROUP BY 客户
H1 改成"华南",公式自动重算出华南的汇总。做动态报表时,这一个问号顶过去一堆辅助列。另外 ? 按出现顺序取参数,也可以用 $1、$2 指定取第几个(同一条语句里不能混用)。
06 函数用法(中):初始化 SQL 与 8 种公式
新引擎实际有 8 个查询函数,但命名规律很简单,30 秒记住:
- 带 X
:多一段「初始化 SQL」参数,在主 SQL 之前先执行(EXEC→EXECX) - 带 A
:多一个「库文件」参数,用本地 .duckdb 文件做持久数据库(EXEC→EXECA) - 带 .ASYNC
:异步版本,重算时不卡 Excel(EXEC→EXEC.ASYNC)
三个维度自由组合:EXEC、EXECX、EXECA、EXECAX,各自再带一个 .ASYNC,正好 8 个。参数顺序固定:库文件路径 → 初始化 SQL → 主 SQL → 数据区域 → 绑定参数,用不到的就省略。
初始化 SQL 特别适合定义宏(自己的小函数),让主 SQL 更短更好读:
-- 初始化 SQL:先定义一个含税宏
CREATE MACRO tax(x) AS round(x * 1.13, 2);
-- 主 SQL:直接用
SELECT 客户, tax(SUM(金额)) AS 含税总额
FROM xlrange(1) GROUP BY 客户
注意两条:初始化 SQL 不绑定参数;内存库每次重算都从空库开始,所以准备工作每次都会重新做一遍。
8 种组合背不下来也没关系——插件把选取逻辑简化成了三个开关,面板自动挑函数:
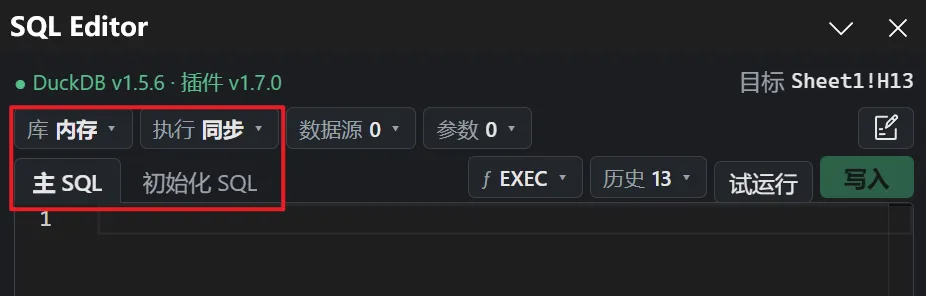
▲ 三个开关(库 / 初始化 SQL / 执行),组合出 8 种公式
选了本地数据库文件后,还能直接展开库结构,点表名、列名就插入到光标处:
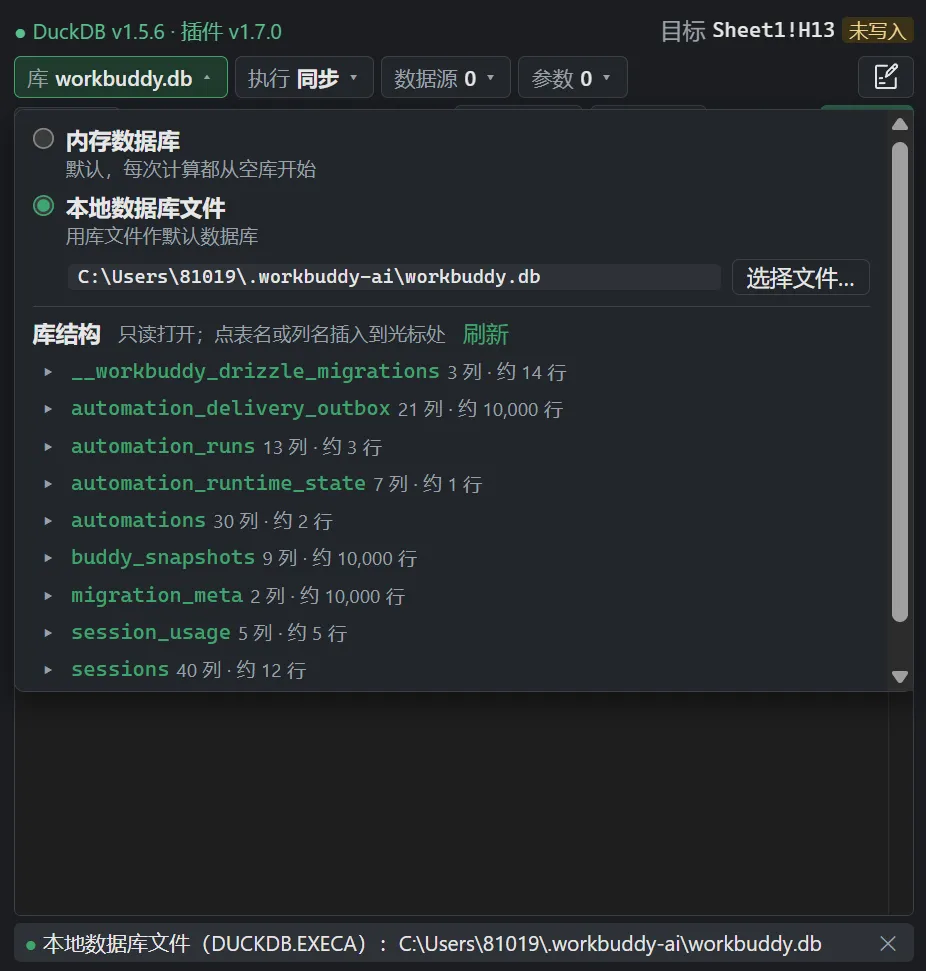
▲ 选择本地数据库后,自动展开库里的表和列
07 函数用法(下):同步、异步、执行一次
同一段 SQL,有三种"算"的方式,区别在于什么时候算、算完留下什么:
| 方式 | 行为 | 适合 |
|---|---|---|
为什么需要"执行一次"?因为公式遇到重算就会再跑一遍。普通查询无所谓,但 COPY 导出文件、INSERT 写库这类有副作用的 SQL,每重算一次就多做一次——文件被反复重写。选"执行一次",落定了就不再动。
08 函数用法(下):日期这个小坑
Excel 里的日期时间本质是"序列号"(一串数字),这带来两个方向的问题,插件各给了一个解法:
- 读进来
:源数据里的 Excel 日期是数字,用 xldate()、xltime()、xldatetime() 转成真正的日期时间再参与计算; - 写回去
:查询结果里的日期列写进 Excel 是一串数字(如 45294),点一下「设置日期格式」,按列类型一键设好 yyyy-mm-dd。
09 函数用法(下):不止查表格
DuckDB 的老本行是查文件,这些在插件里全都能用:
-- CSV、Parquet、JSON、xlsx 不必先导入工作表,写个路径就能查
SELECT * FROM read_csv('D:\数据\销售.csv') LIMIT 100;
-- 把结果导出成 Parquet(这类 SQL 记得用「执行一次」)
COPY (SELECT * FROM xlrange(1))
TO 'D:\out\订单.parquet' (FORMAT parquet);
本地数据库文件除了 .duckdb,还能直接打开 SQLite 文件——引擎按文件头自动识别,首次使用自动装好所需扩展。也就是说,你电脑里散落的数据文件,现在都能用一条公式拉到 Excel 里算。
最后记住三条小规则:① 分号隔开的多条 SQL 依次执行,只有最后一条的结果回到单元格;② 结果第一行永远是列名;③ 结果最多 1,048,575 行 + 16,384 列(Excel 上限),SQL 太长超过 8192 字符时可以存到单元格里再引用。
10 编辑器体验:会联想、能试错、可定制
用法之外,编辑器本身也下了大功夫。联想函数时旁边弹出用法卡片:签名、说明、示例一应俱全,不用翻官方文档:
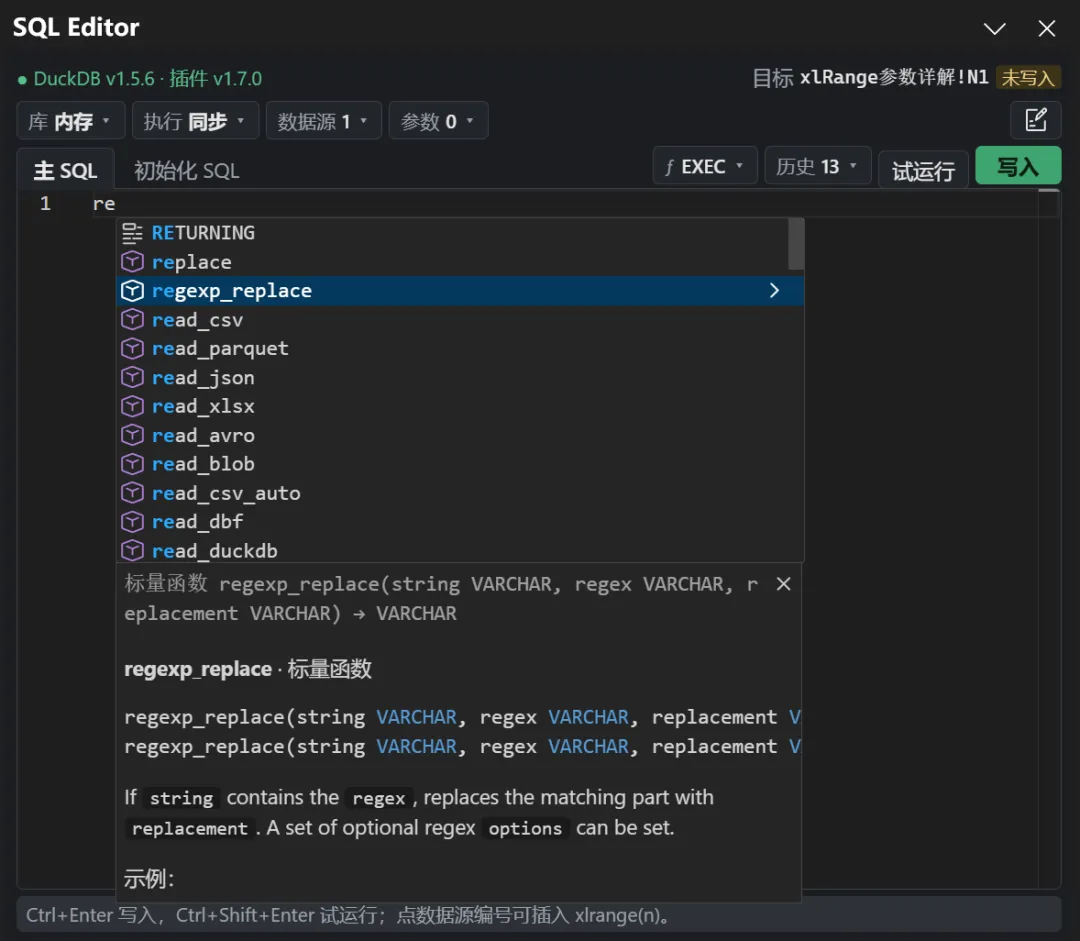
▲ 输入 re,候选函数的签名、说明、示例直接显示
写完 SQL 先点"试运行"——结果只在窗格里预览,不动工作表,确认没问题再写入:
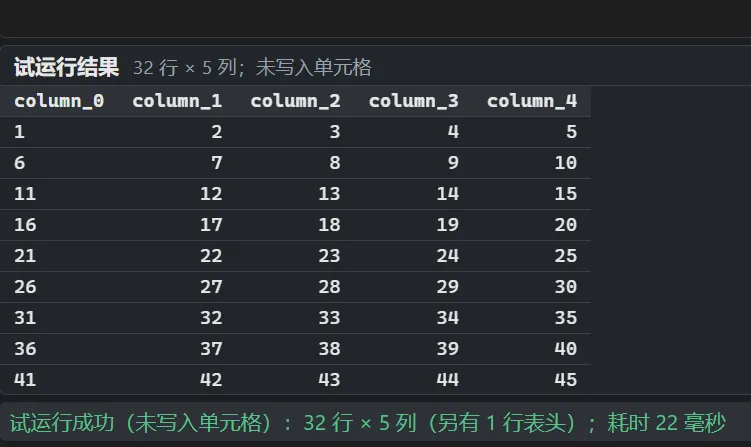
▲ 试运行:32 行 × 5 列,未写入单元格,耗时 22 毫秒
你常用的高频写法还能加进自定义词库,主 SQL 和初始化 SQL 立即生效,同名词条优先于内置的:
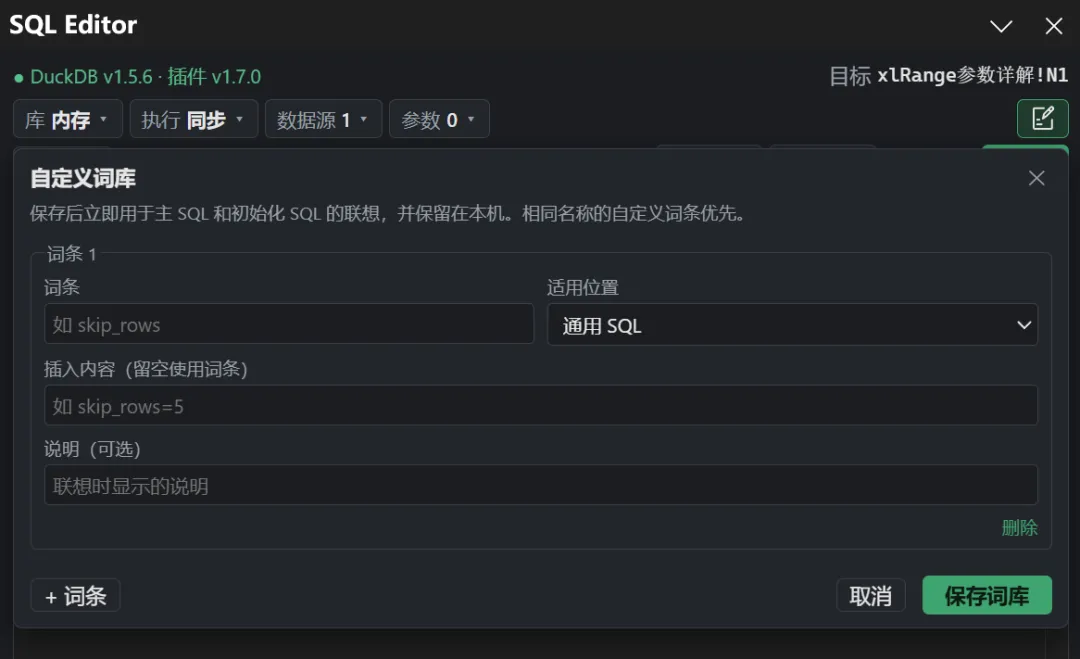
▲ 自定义词库:自己的高频写法,随打随出
11 硬碰硬:性能到底快了多少
说再多不如跑个数。第一组:递归计算。DuckDB 2.0 预览版对递归做了优化,但官方不支持 Excel 扩展,我通过修改 XLL 和扩展源码的方式让它支持了。同样一段百万次递归的 SQL:
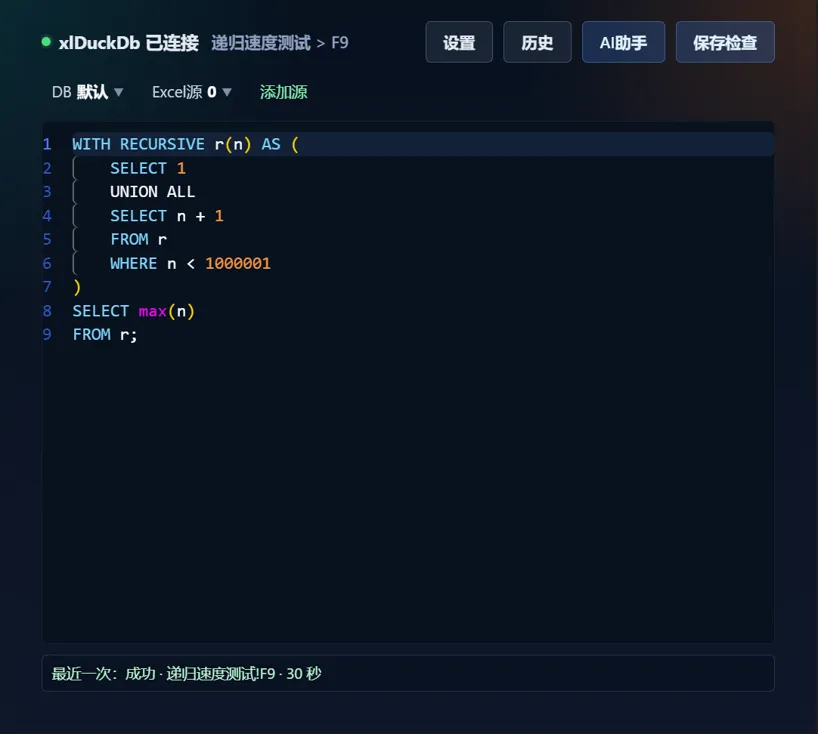
▲ 旧引擎:30 秒
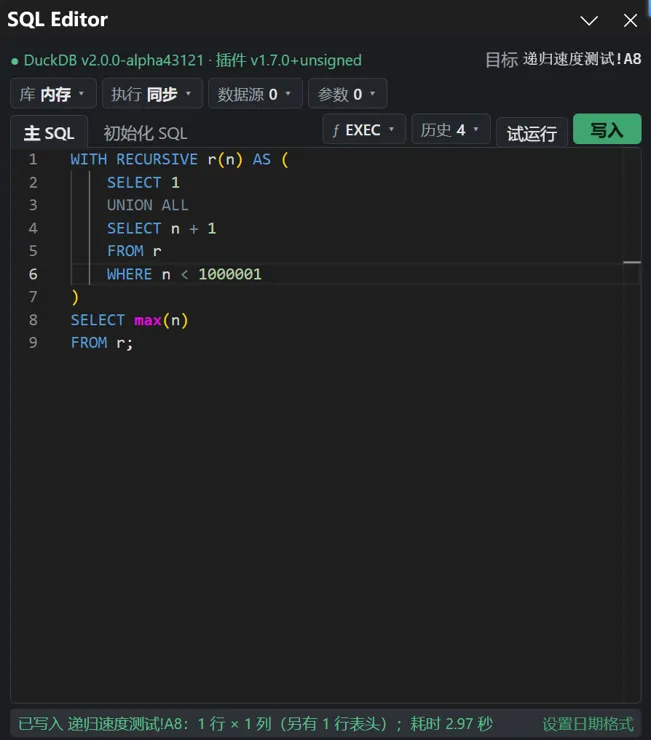
▲ 新引擎(DuckDB 2.0):2.97 秒,快了近 10 倍
第二组:百万行写入 Excel。之前我觉得 xlDuckDb 五秒多写入一百万行已经够离谱了,这次新插件直接干进 3 秒:
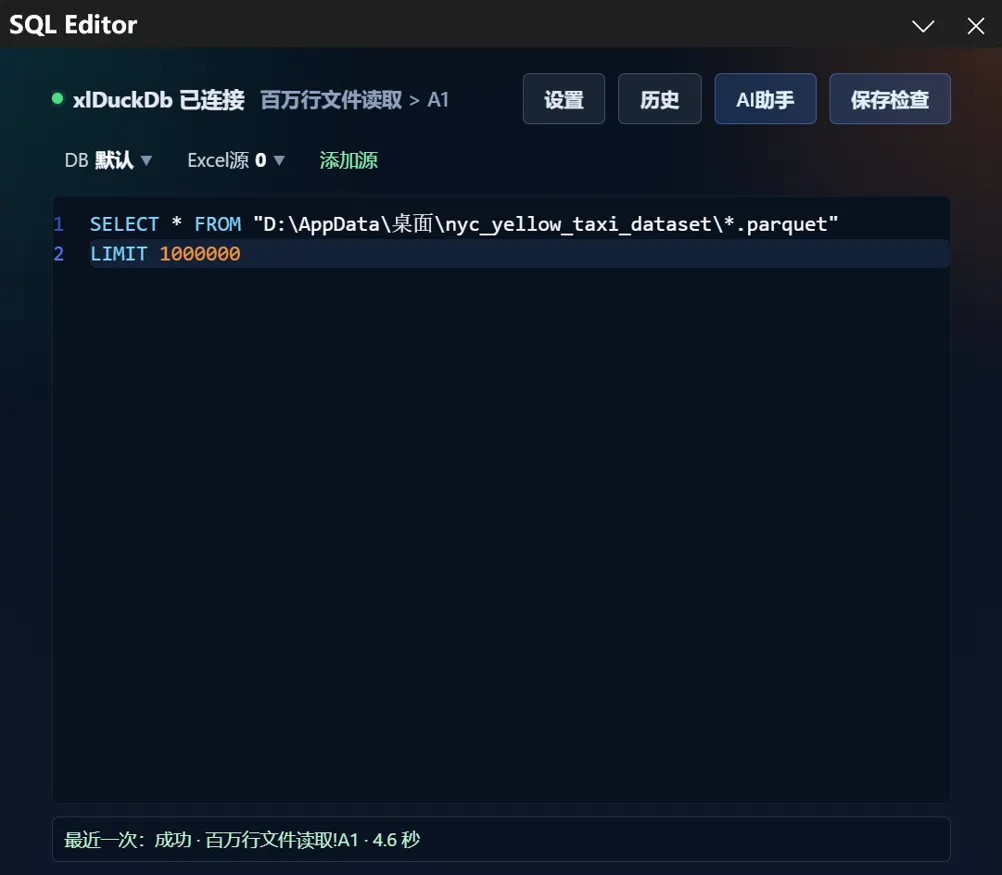
▲ 旧引擎:100 万行 × 19 列,4.6 秒
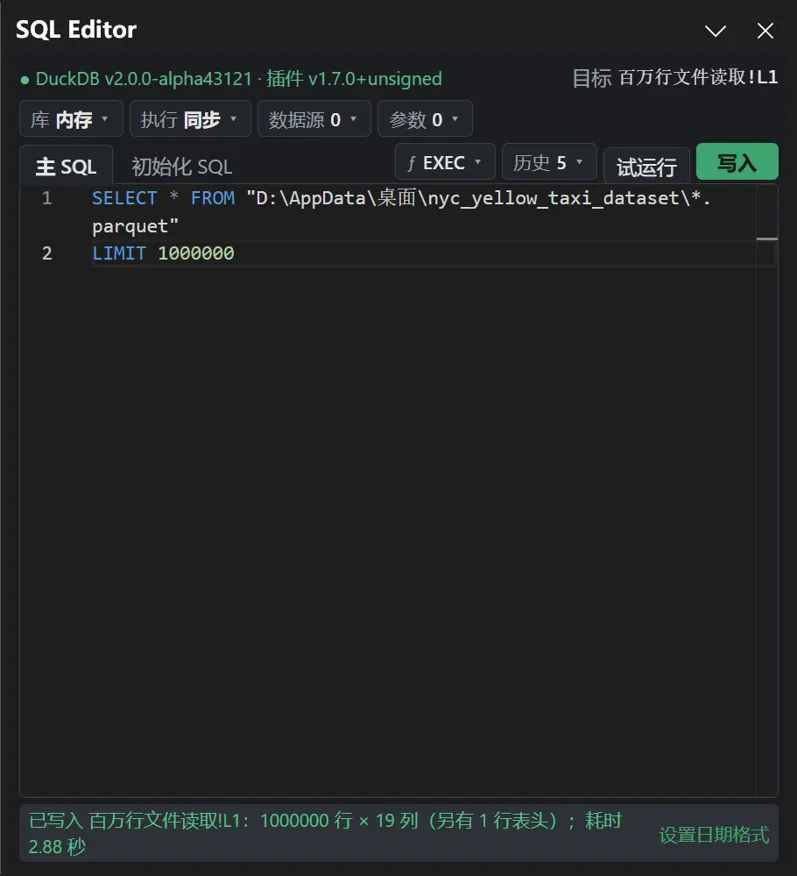
▲ 新引擎:同样的数据,2.88 秒
12 一个开发中的小插曲
开发中我发现一个有意思的事:DuckDB 官方 Excel 扩展的文档里明确写着,写 xlsx 的 mode 参数(支持新建/追加/替换 sheet)已经合并进主分支了:
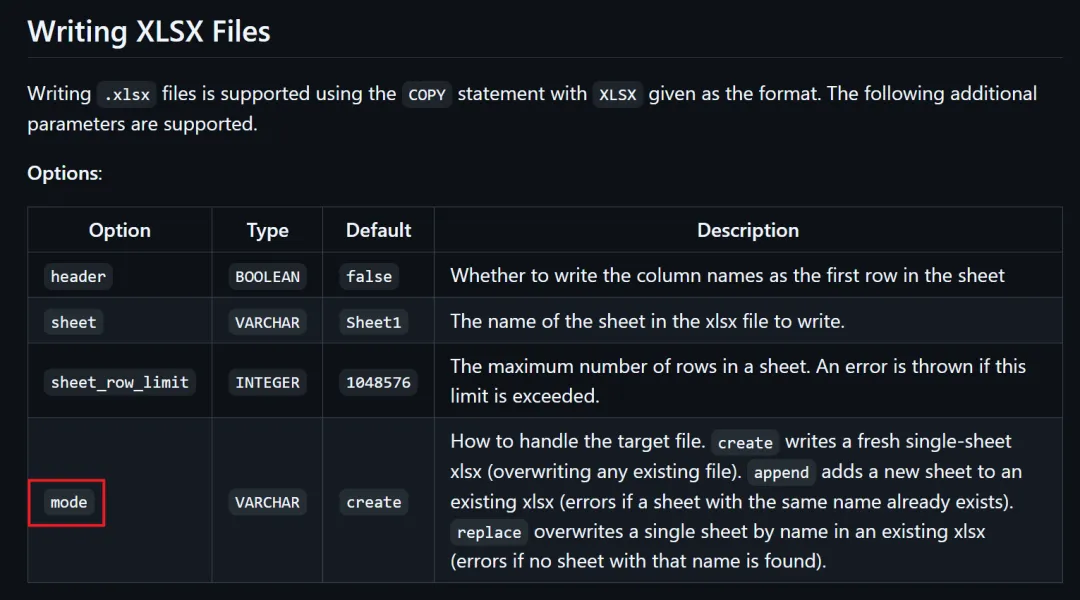
▲ 官方文档:mode 参数已支持 create / append / replace
但实际上,通过 duckdb.dll 自动下载的扩展依然是不包含这个提交的版本。想用上就得自己编译——而自编译版本没有官方签名,默认被拒绝执行。正常情况下可以设置 allow_unsigned_extensions = true 放行,可在 Excel 插件里,DuckDB 挂在 Excel 进程内,没法在启用之前先做设置。所以要么重新编译 duckdb.dll 源码,要么重新编译插件的 XLL 源码——这就是之前 SQL Lab 所谓"未签名版"的由来。
说这段是想讲:很多看似"一个开关"的功能,背后都是实打实的源码功夫。
13 写在最后
总结这次重构的四个关键词:
- 更轻
砍掉 .NET 8 和 Excel-DNA,纯 C 路线,数据搬运路程更短; - 更强
xlrange 五大读取选项、谓词下推、参数绑定、日期工具全面补齐; - 更全
查区域、查文件、查库文件、导出一站式,8 种公式 3 个开关搞定; - 更快
递归快近 10 倍,百万行写入 2.88 秒。
目前插件只有 Excel 版本(WPS 不支持异步计算,还在攻关中)。我把完整的界面细节和报错速查整理成了一份图解指南,从"30 秒上手"到"一键修复"都有,需要的读者可移步本号另一篇文章。
你在 Excel 里处理数据时最痛的场景是什么?是 VLOOKUP 拖到卡死,还是 SUMIFS 套到眼花?评论区聊聊,说不定就是下一个功能的起点。