ARTICLE · 1120855
谷歌顶级科学家撕开AI神话遮羞布:狂砸万亿的Transformer,绝非最优解!
作者云岑
编辑灵枢编辑部
你以为的这场席卷全球的AI大革命,可能从一开始就走错了方向。
过去三年,全世界的科技巨头为大模型陷入了彻底的疯狂。上万亿美元的资本像潮水一样涌入,无数数据中心拔地而起,所有人都在对 Transformer 架构顶礼膜拜,仿佛它就是人类通往通用人工智能(AGI)的唯一真理。
然而就在最近,科技媒体 The Information 的一档访谈节目,在硅谷掀起了轩然大波。
曾经在谷歌大脑主导开发了传奇芯片设计算法 AlphaChip、如今估值数亿美元的 AI 独角兽 Ricursive 创始人 Anna Goldie,当着镜头,撕开了整个行业最大的遮羞布:
“如果 Transformer 之所以能赢,并不在于它本身有多聪明,纯粹是它刚好撞上了我们手里那几块破显卡呢?”
“那个全局最优解,很可能离我们今天站的地方极其遥远。”
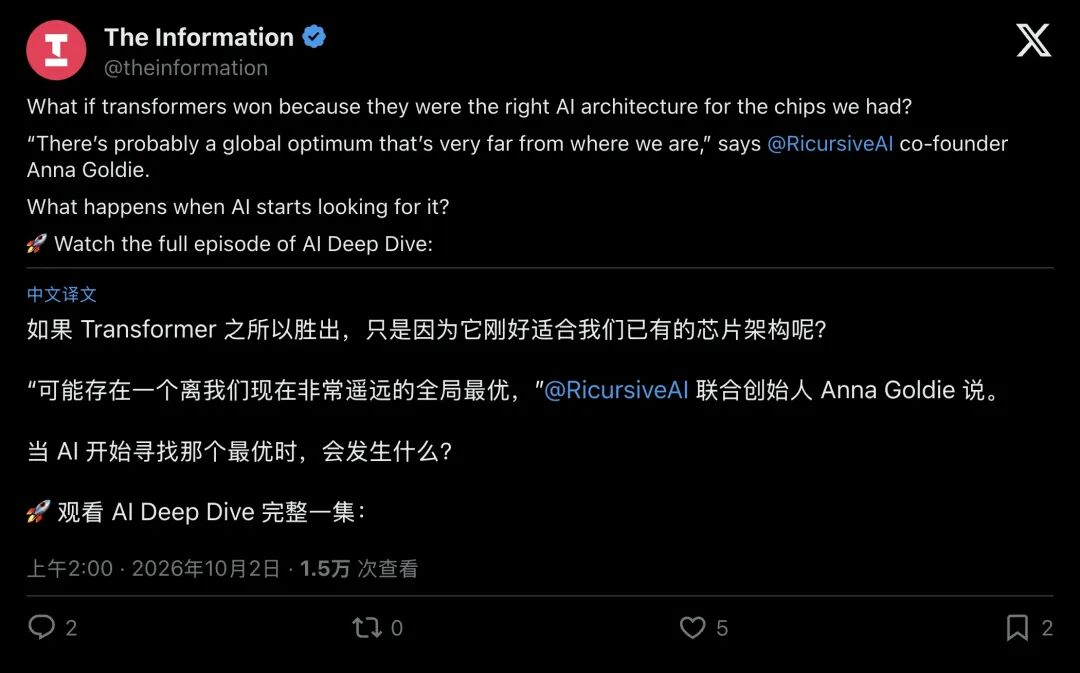
▲ The Information 抛出灵魂拷问:Transformer 是否只是因为契合现有芯片才赢下一切?
一句话,让喧闹的硅谷瞬间鸦雀无声
评论区里,一位从业者留下了极其犀利的总结:“硬件在统治软件。大家都在给硅片做优化,把数学抛到了脑后。效率战胜了优雅,至于终极智能的影子,人类至今连看都没看到一眼。”
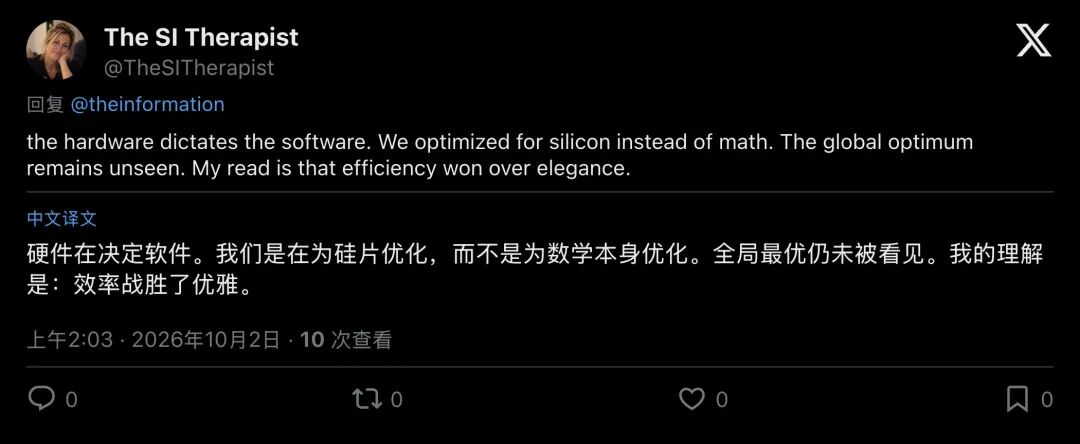
▲ 业内从业者直言:硬件决定软件,效率战胜了优雅
我们自以为在叩开上帝的智慧之门但残酷的真相是:我们狂热追捧了近十年的 AI 架构,可能只是一个被硬件强行喂出来的“偏科怪胎”。
01哪有什么降维打击,不过是中了一张“硬件彩票”
要看清这场世纪迷局,我们必须把时钟拨回 2017 年。
那一年,谷歌团队发表了名垂青史的论文《Attention Is All You Need》,Transformer 破土而出。
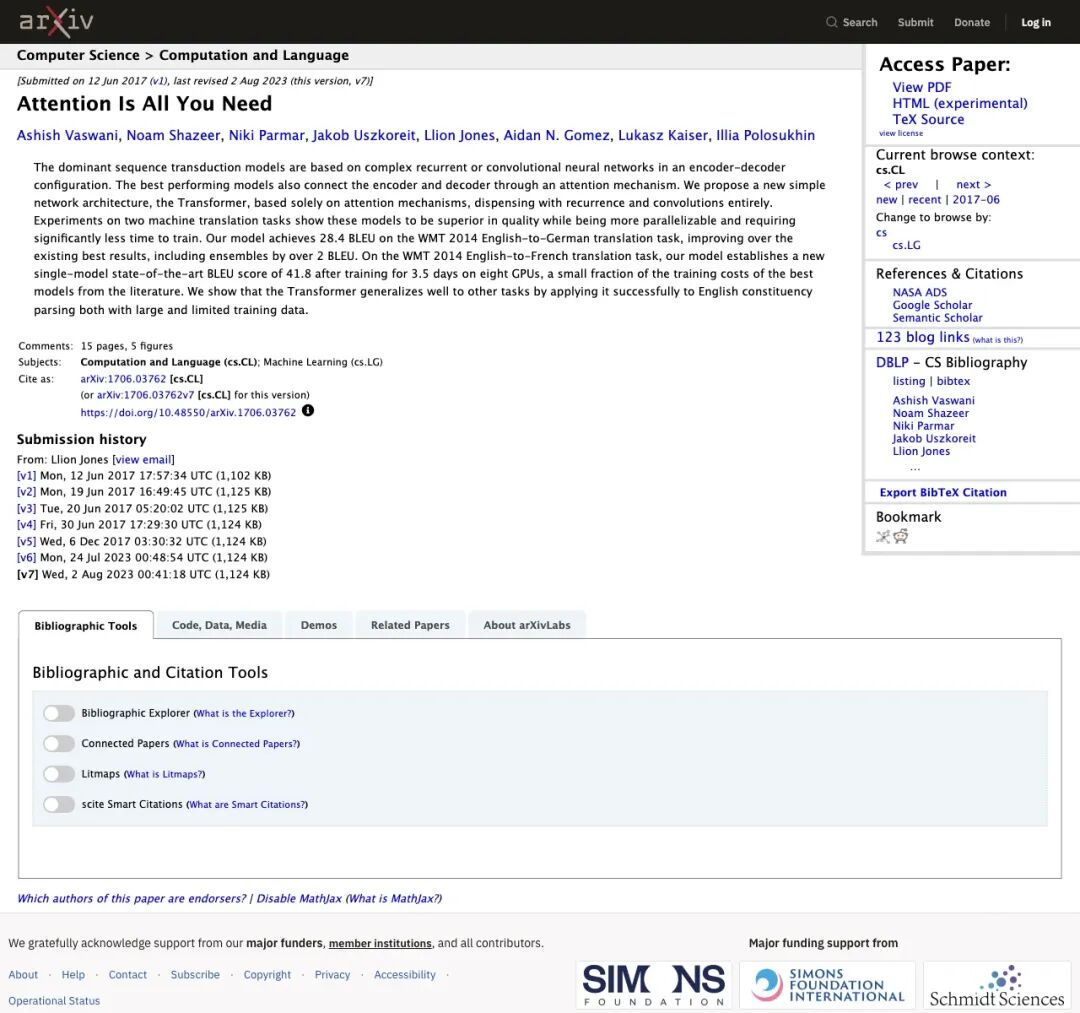
▲ 2017 年横空出世的 Transformer 原始论文,彻底改写了 AI 历史进程
在此之前,主宰语言处理的是循环神经网络(RNN)。
RNN 的逻辑非常符合人类直觉:读文章得一个字一个字读,理解完上一句,才能理解下一句。但这在计算工程上简直是场灾难,它就像一个单车道的人工收费站,哪怕后面堵了十万辆车,也只能一辆一辆慢慢过,计算速度慢如蜗牛。
而 Transformer 登场后,大笔一挥,把收费站全部拆平,改造成了八车道的高速立体立交桥。
它不再按部就班地挨个读字,而是掏出“自注意力机制”,让整篇文章里的所有词在同一瞬间互相观望。在计算机底层,这种操作被直接打散成了成千上万个规整、密集、能够同时进行的大规模矩阵乘法(GEMM)。
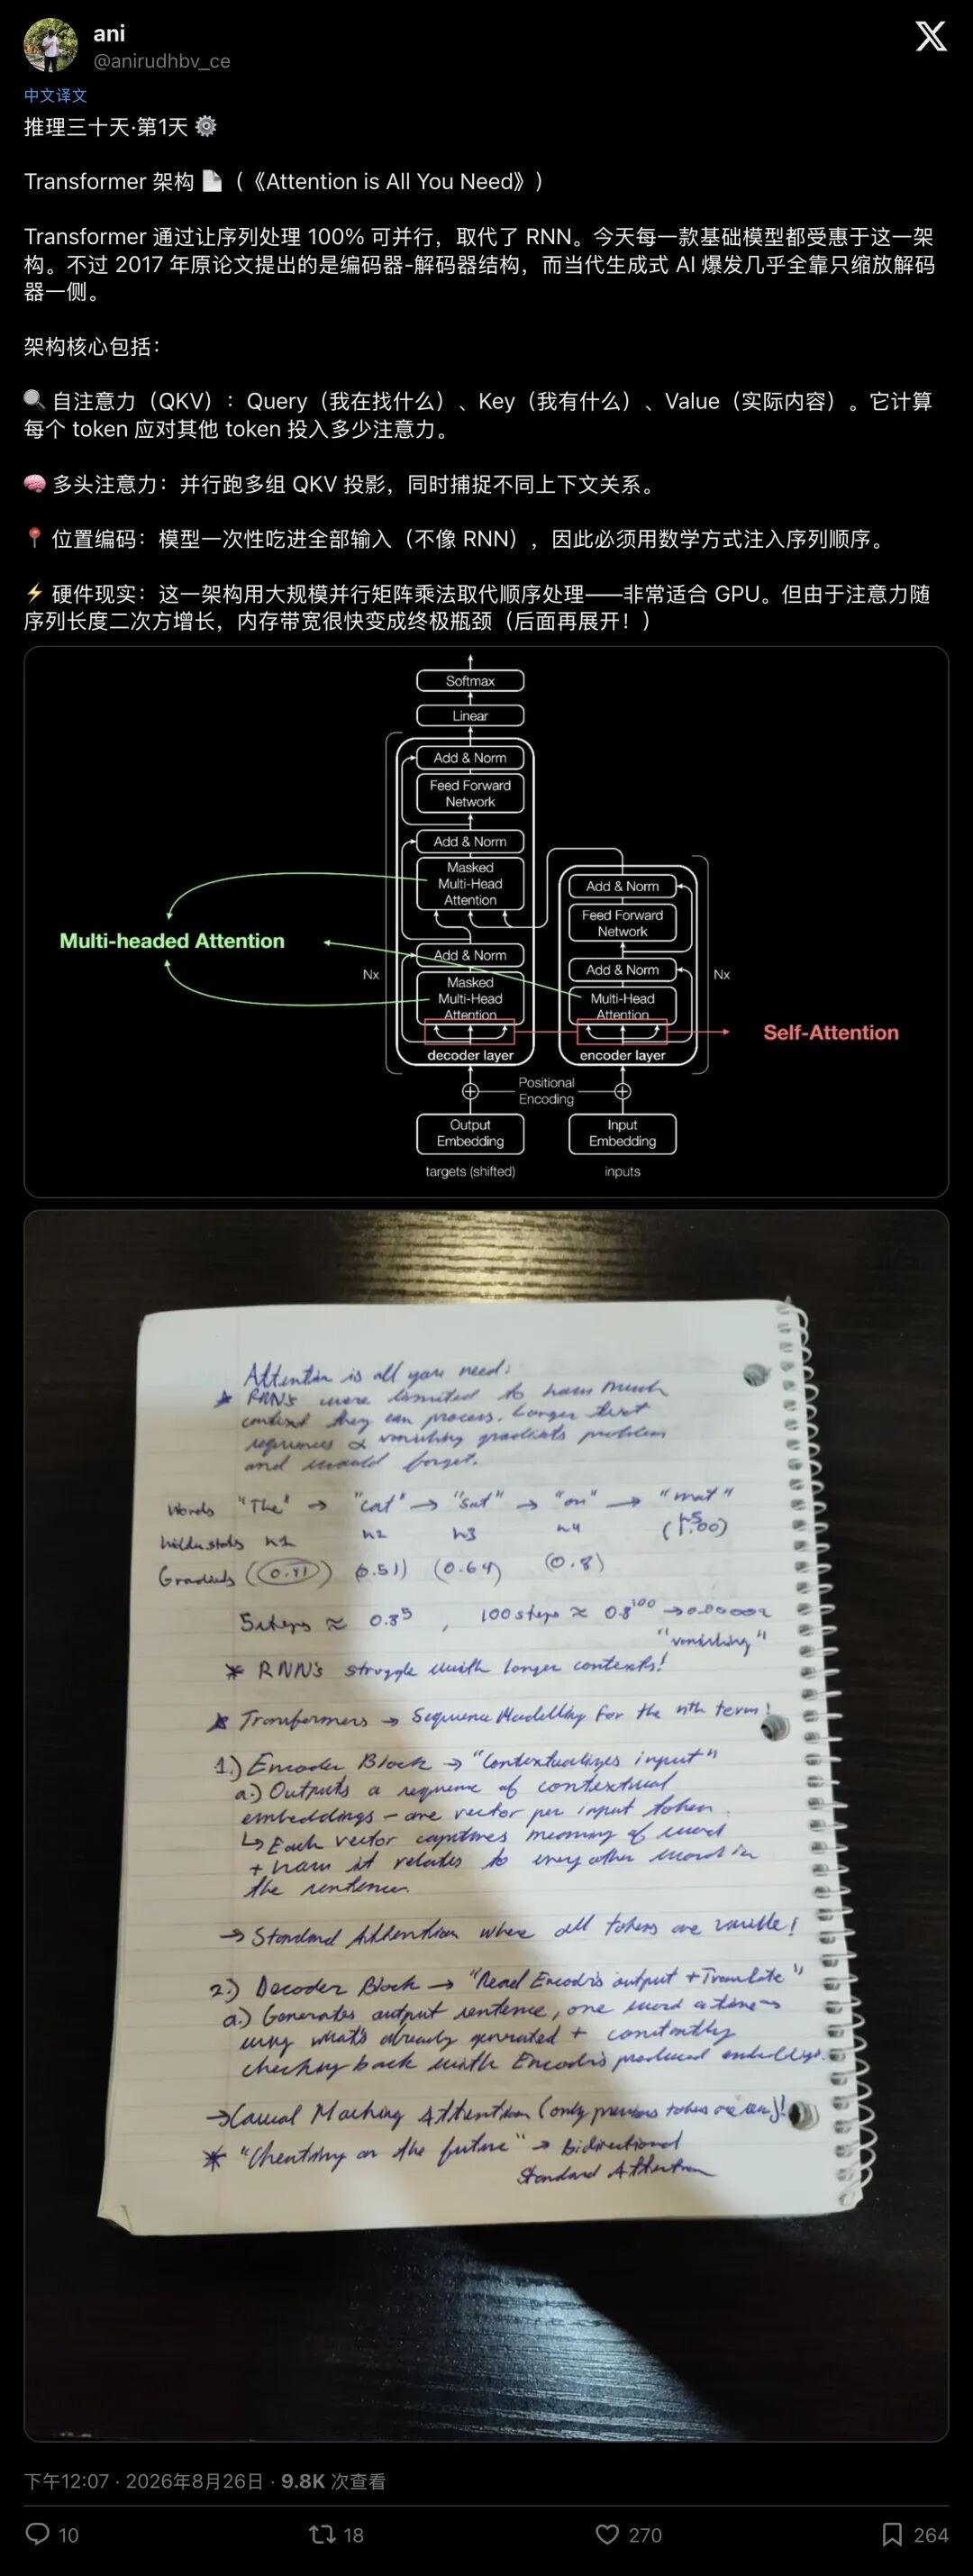
▲ 工程师笔记还原底层真相:Transformer 的并行矩阵乘法天生契合 GPU,但代价是撞上内存带宽墙
恰好,被用来打游戏和渲染图形的 GPU(图形处理器),骨子里最擅长的就是干这种粗笨活,它里面有成千上万个小计算核心,最喜欢“很多简单的数学题一起算”。
两者一拍即合!原本在 RNN 上需要训练几个月的超大模型,在 8 张 GPU 上仅仅三天半就跑完了。
但这真的是算法在数学上的终极胜利吗?计算机科学家 Sara Hooker 早在 2020 年就提出了著名的“硬件彩票”(Hardware Lottery)理论。
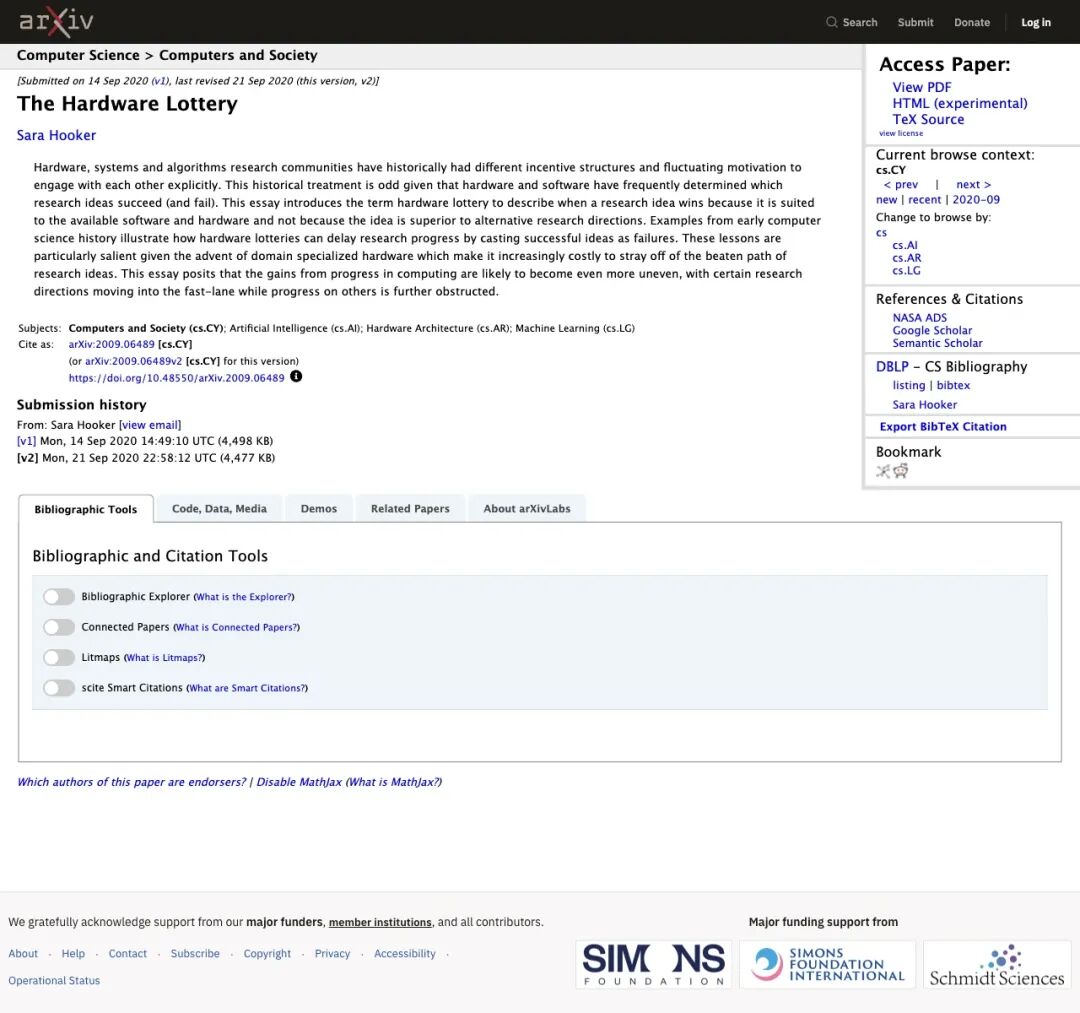
▲ Sara Hooker 的里程碑之作《硬件彩票》:最终胜出的想法未必有多拔尖,却最懂迎合硬件
所谓“硬件彩票”,说白了就是:一个科学想法能赢,往往不在于理论本身有多拔尖,纯粹是它碰巧迎合了当时最容易买到的硬件和软件平台。
神经网络在 20 世纪七八十年代就被提出,坐了整整三十年冷板凳。难道那三十年里它的数学原理是错的?不,只是因为当时没有能便宜做矩阵并行的 GPU。直到 2012 年算力到位,它才突然变成“天才”。
今天那些试图模仿人脑的动态连接网络、脉冲神经网络、稀疏图计算,其精巧程度远超 Transformer。但在今天的 GPU 眼里,这些算法全是“异端”,它们分支复杂、内存乱跳,GPU 跑起来效率奇差无比。
它们未曾输给科学,只是运气差了点,没能抽中那张硬件彩票。
02黄仁勋的长达十年“反向绑架”:把大模型锁死在硅片上
如果事情只停留在“碰巧合拍”,那还不算绝望。
更可怕的现实在于:硬件厂商并没有坐视不管,他们在过去七年里,进行了一场疯狂的“反向定制”,彻底焊死了创新的大门。
很多人以为芯片是个客观中立的工具底座,软件爱怎么写就怎么跑。错了!现代 GPU 早已不再是通用的计算设备,它被黄仁勋彻底改造为了专为 Transformer 定做的“硅基流水线”。
- 2017 年,Volta 架构登场
:英伟达在每个计算单元里塞进了硬件级别的 Tensor Core。它放弃了传统通用的浮点运算,专门为 4×4 矩阵乘法开挂,吞吐量直接飙升到传统核心的 5 倍以上。它在物理晶体管层面立下了规矩:跑矩阵乘法,算力要多少给多少;跑别的复杂逻辑,对不起,慢慢排队。 - 2022 年,Hopper 架构(H100)问世
:英伟达甚至懒得掩饰这种偏袒,直接在芯片里塞进了一个硬件单元,名字就叫 Transformer Engine(TE)。它在硬件底层原生支持 FP8 混合精度,甚至做了一套自动化电路来动态调整数值大小,硬生生把 Transformer 训练吞吐量拉高了 9 倍。 - 到了最新的 Blackwell 架构
:硬件更是把迎合做到了极致,NVFP4 微缩格式、1.8 TB/s 的超大带宽互连。整颗芯片上成百上千亿个晶体管,呼吸脉搏完全是跟着大模型矩阵的跳动而设计的。
这带来了一个极其恐怖的创新死锁:
当你使用标准的 Transformer 架构时,你能调动显卡里 90% 以上由 Tensor Core 带来的狂暴算力;而只要你敢尝试一点脑洞大开的新算法,比如动态稀疏网络、图神经网络、类脑计算,显卡上那千亿个为矩阵打造的专用晶体管,就会瞬间陷入大面积瘫痪和闲置!
跑起来慢得像乌龟,成本贵上天任何一个前沿实验室的科学家看到这种惨状,都会被逼得退回原地:“算了,还是继续调 Transformer 吧。”
哪里有什么进化的自由选择,这分明是一场赤裸裸的物理绑架。
03万亿成本铸造的死牢:谁敢换架构,谁就先破产
英伟达在物理上筑起了铜墙铁壁,软件和资本生态则在精神上套上了枷锁。
知名 AI 研究员 Jim Fan 曾一针见血地指出,整个产业正深陷于“预训练彩票”的路径依赖之中。
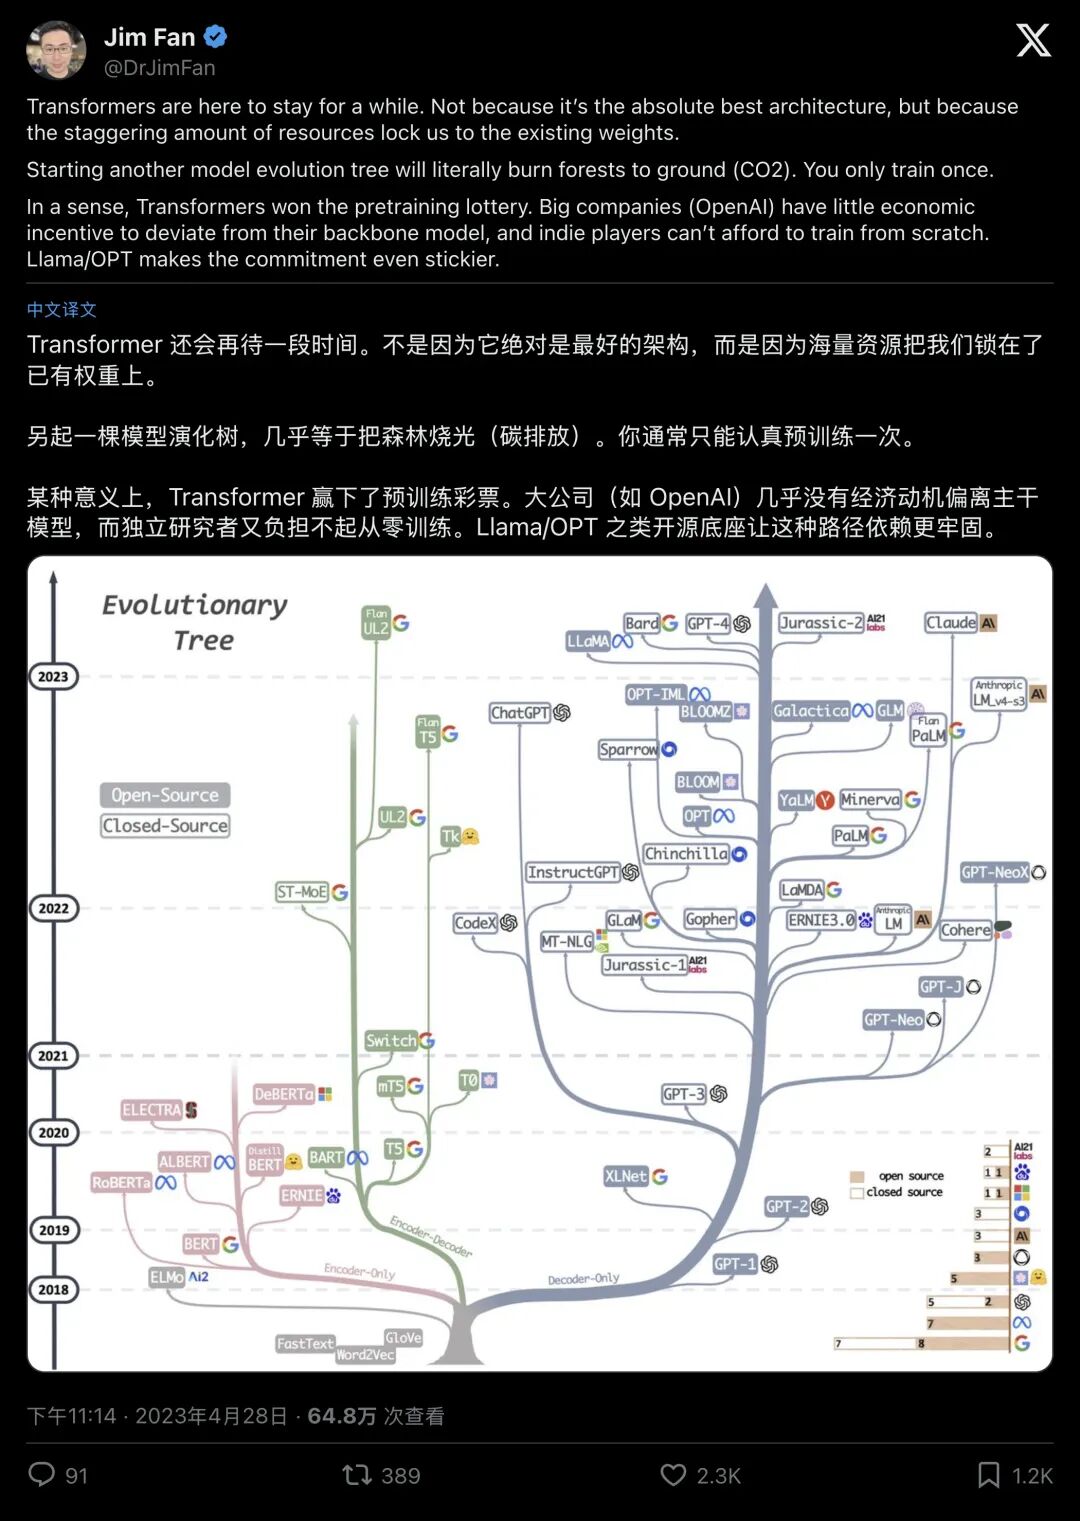
▲ Jim Fan 揭示工业界残酷现状:万亿美元的资产已被锁死在现有演化树上
大模型发展到今天,全球投入到预训练上的资金已经超过上万亿美元。无数的开源模型权重、配套的 CUDA 算子库、万卡集群的组网方案,全是在这棵树上长出来的。
大公司就算明知有更优雅的数学方案,也根本不敢换。“换掉 Transformer?意味着几百亿买来的集群要作废,所有的工程经验要清零,成熟的开源生态要抛弃。在这个季度就要看财报的商业战场上,谁敢另起炉炉灶从零预训练,谁就会立刻死在半路上。”
甚至有一批激进的创业公司,决定“在局部最优的悬崖上一路狂奔到死”。
比如芯片独角兽 Etched,干脆做了一款只支持 Transformer 的芯片(ASIC),叫嚣着要“把 Transformer 彻底烧进硅片”,借此把吞吐量推向不可思议的极致,代价是它完全无法运行任何其他类型的算法。
但半导体知名智库 SemiAnalysis 随即泼下一盆冰水:这不过是极具欺骗性的营销话术。
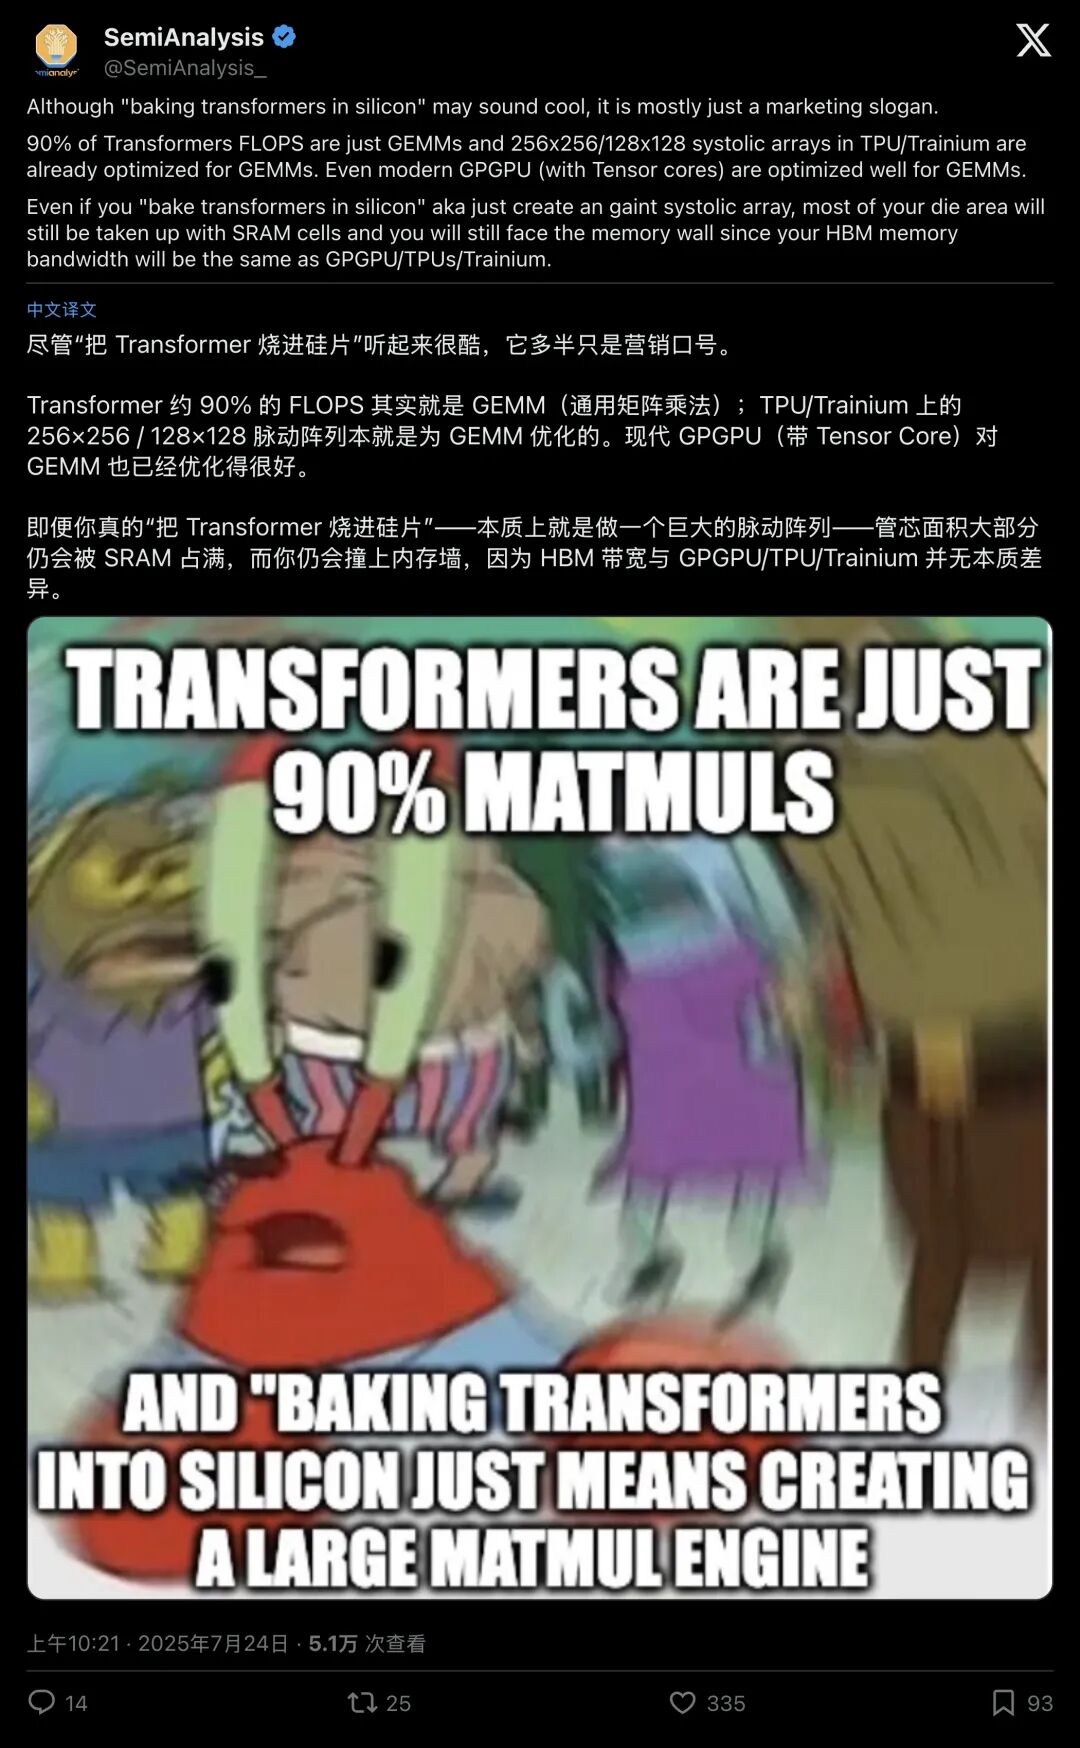
▲ SemiAnalysis 犀利反驳:把架构烧进硅片并不能消除 SRAM 和 HBM 内存墙
SemiAnalysis 一针见血地指出:Transformer 里 90% 的运算早就是通用的矩阵乘法(GEMM),现有的 TPU 和 GPU 早就把这块硬件压榨到了极限。哪怕你做成专用的硅片,芯片面积绝大多数依然会被高速缓存(SRAM)霸占,高昂的显存带宽“内存墙”依然像一堵不可逾越的死墙立在那里。
把一个可能存在缺陷的架构永远刻进石头里,非但无法通向未来,反倒把囚笼的栅栏焊得更结实了。
04逃离牢笼的唯一出路:让 AI 拿起手术刀,自己给自己造躯体!
难道人类的通用智能梦,就要被死死困在矩阵乘法和功耗爆炸的死胡同里了吗?
“我们现在身处的,绝对只是一个局部最优解。”Anna Goldie 和她的创业搭档 Azalia Mirhoseini 坚信,人类若想看到能耗比媲美人脑的通用智能,就必须掀翻这个由现有芯片和 Transformer 联手缔造的死局。
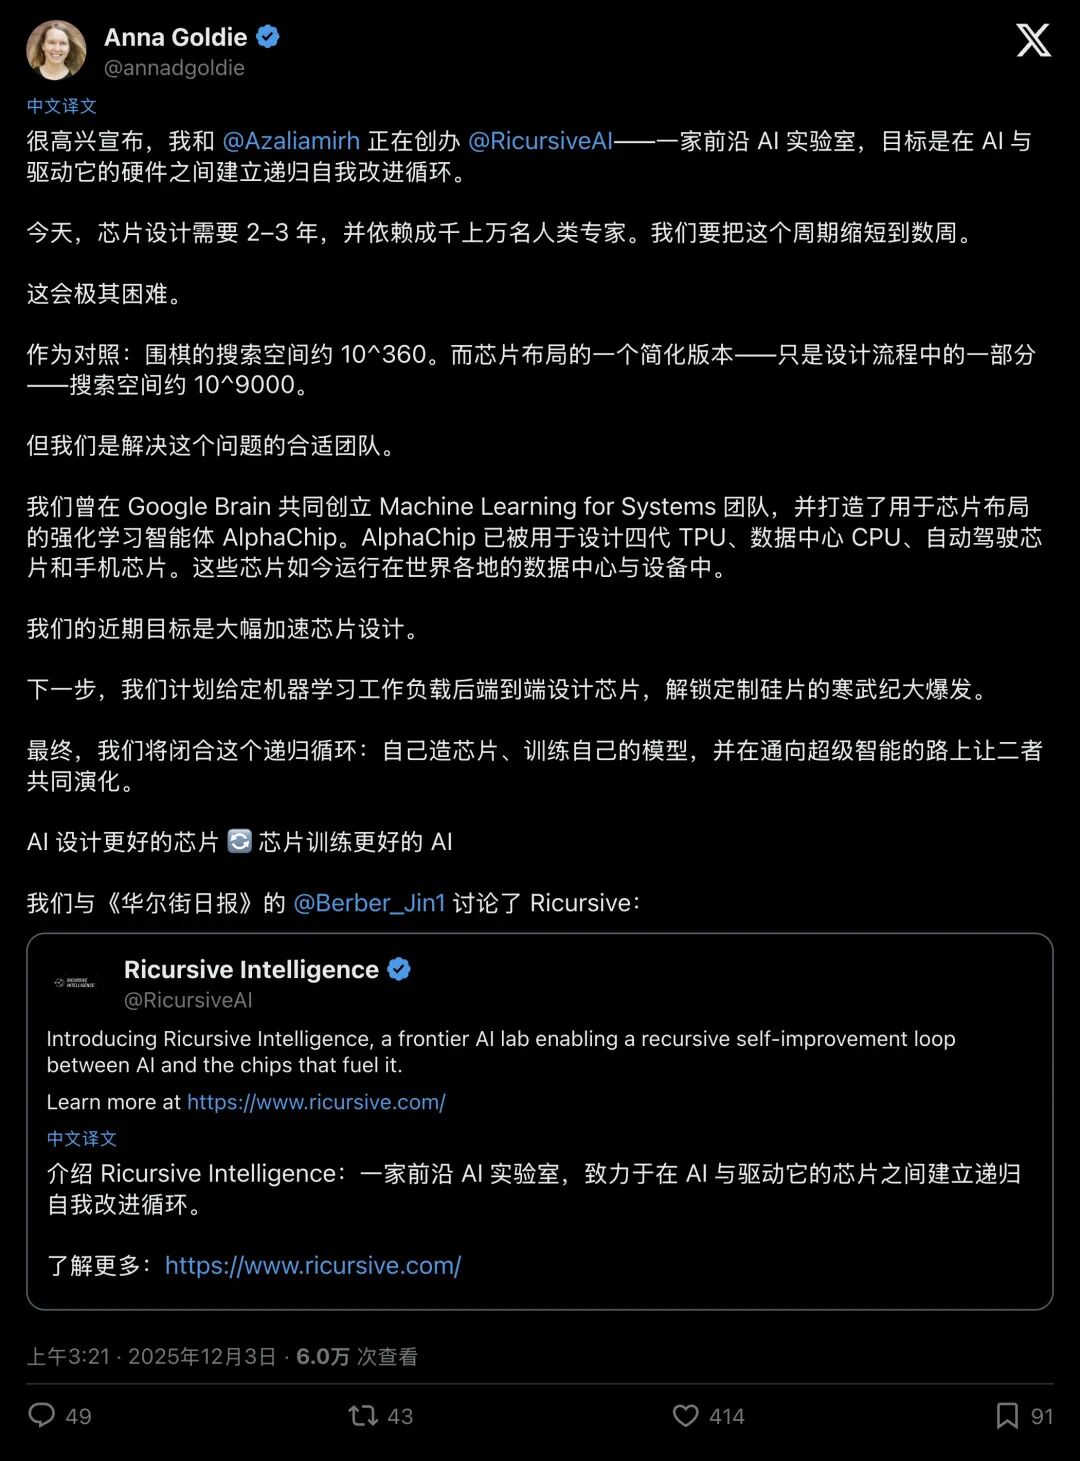
▲ 前谷歌 AlphaChip 核心科学家 Anna Goldie 吹响反抗号角:闭合 AI 与硬件的进化循环
人类大脑只有大约 20 瓦的功率,相当于一个暗淡的床头灯泡,却能轻松处理视觉、语言、推理和抽象思考。而今天驱动一个 GPT-4 级别的模型,需要一座中型城市的供电量,成千上万张发烫的显卡发出震耳欲聋的轰鸣。
差距在哪里?The Information 的切片访谈中,Goldie 斩钉截铁地回答:“答案全在芯片。”
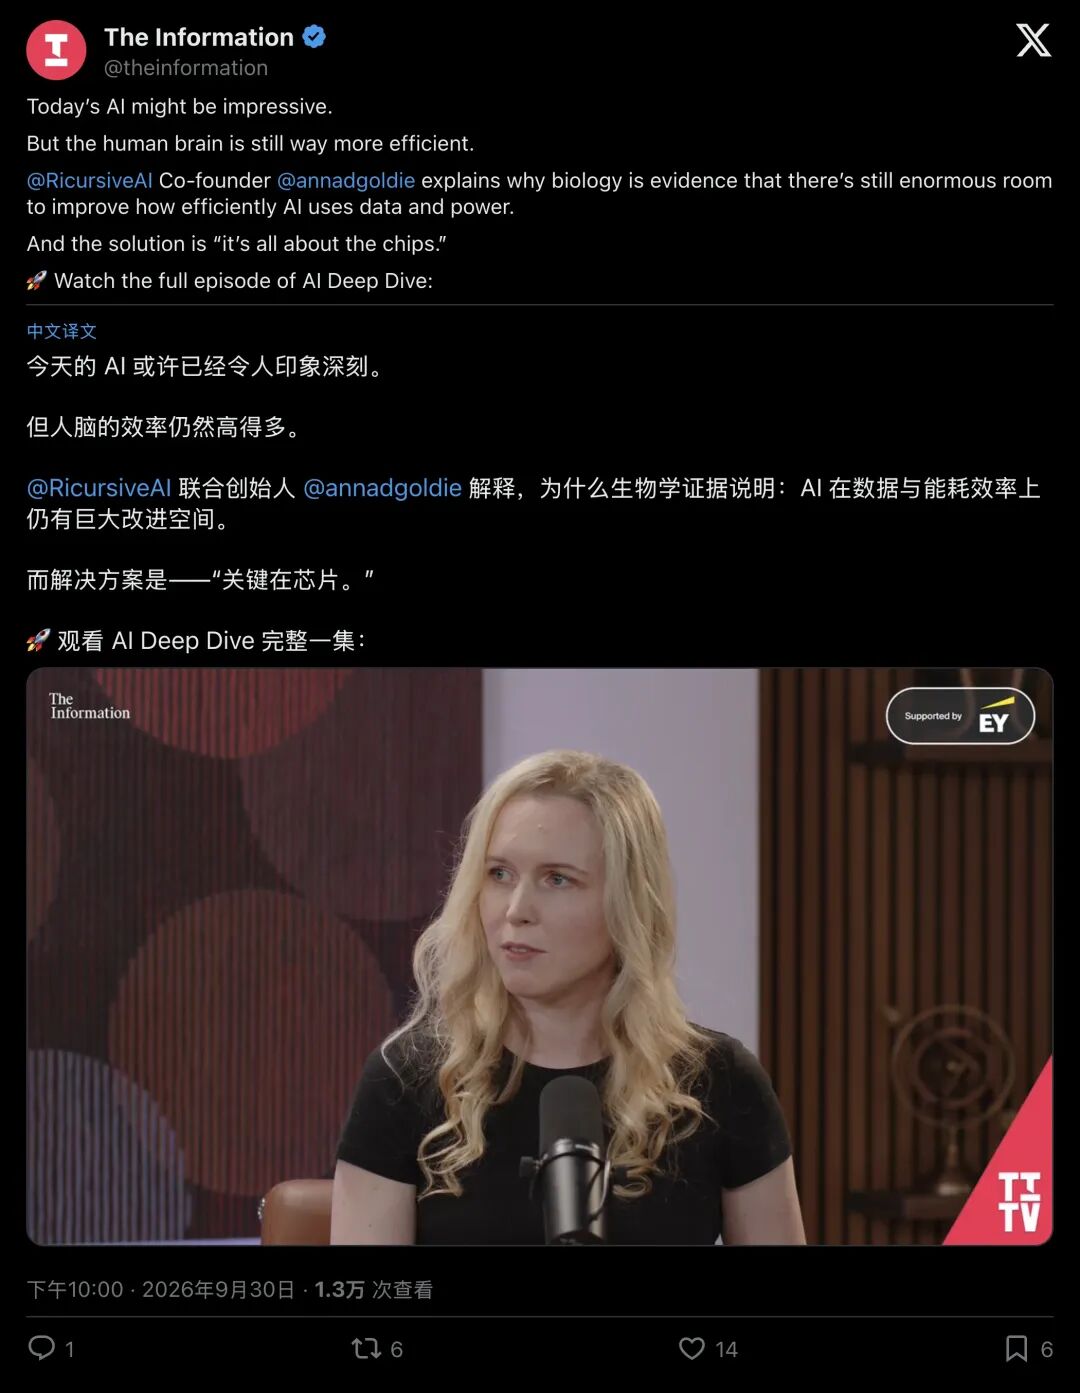
▲ 访谈高光时刻:为什么大模型在效率上被人脑碾压?Goldie 直言“全在芯片”
今天人类设计一颗前沿 AI 芯片,需要上千名顶级工程师,戴着眼镜在电脑前摆放数百亿个逻辑门,耗时长达两三年。这种极其缓慢的硬件迭代速度,注定了算法研究者只能迁就手里现成的芯片。
而 Goldie 团队在谷歌做出的 AlphaChip,曾用强化学习震撼了世界:芯片布局的搜索空间高达 $10^{9000}$,是围棋复杂度($10^{360}$)的无数亿倍。人类团队几个月都画不完的物理版图,AI 只用了不到 6 个小时,就在功耗、性能和面积上全面超越了人类专家。
如今,她们创立的 Ricursive,野心极其狂妄,它们要用 AI 实现彻底的“递归自我改进”:
- 第一阶段
:用 AI 接管芯片设计中最漫长的验证和物理设计,把几年缩短到几周; - 第二阶段
:模型根据全新的算法架构,端到端“反向输出”芯片设计图,为全新的数学形态瞬间定制硬件; - 第三阶段
:模型与硬件实现深度的共生演化,新算法诞生,AI 自动生成最契合它的芯片;新芯片流片,反过来训练出超越人类想象的新模型!
只有打破硬件对算法的束缚,AI 才能彻底跳出矩阵乘法的沼泽,去寻找那个隐藏在无尽远方的“全局最优”。
05在狂欢的尽头,仰望深邃的星空
回看过去几十年人类计算史,这是一场充满了黑色幽默的轮回。
人们总觉得数学上的真理照亮了科技的道路,然而现实里,往往是几个做显卡的工程师在十几年前做出的硬件权衡,悄悄决定了今天整个技术界的方向。
我们花费万亿美元搭建的智力帝国,或许只是在一条盲道上狂奔。效率战胜了优雅,硅片奴役了数学
但历史从不奖励永恒的妥协者正如那句振聋发聩的警告所言:那个能够彻底解开意识与智慧谜题的终极结构,正静静地潜伏在极其遥远的地平线之外,等待着第一位敢于砸碎眼前锁链的拓荒者。