ARTICLE · 1120865
清华NeurIPS满分神作撕开AI伪装:强化学习越练,大模型反而越“变笨”?
过去这一年,大模型圈几乎被一种极度亢奋的情绪统治着。
从 OpenAI 的 o1 到横空出世的 DeepSeek-R1,所有人都在高呼同一个词,RLVR(可验证奖励强化学习)。
行业里甚至流传着一个神话:只要给大模型连上一个自动判题机,给它对错反馈,大模型就能像当年的 AlphaGo 参悟围棋神之一手一样,在黑暗中自我博弈、自我顿悟,演化出人类从未见过的全新推理能力。
无数技术人深信不疑,以为找到了通往 AGI(通用人工智能)的终极门票。
然而,清华大学团队做了一个看似极其简单的实验,却爆出了一个让全球学术界倒吸一口凉气的反常现象:
被强化学习千锤百炼过的模型,在某些关键指标上,竟然被什么都没学过的“毛坯基座”狠狠按在地上摩擦!
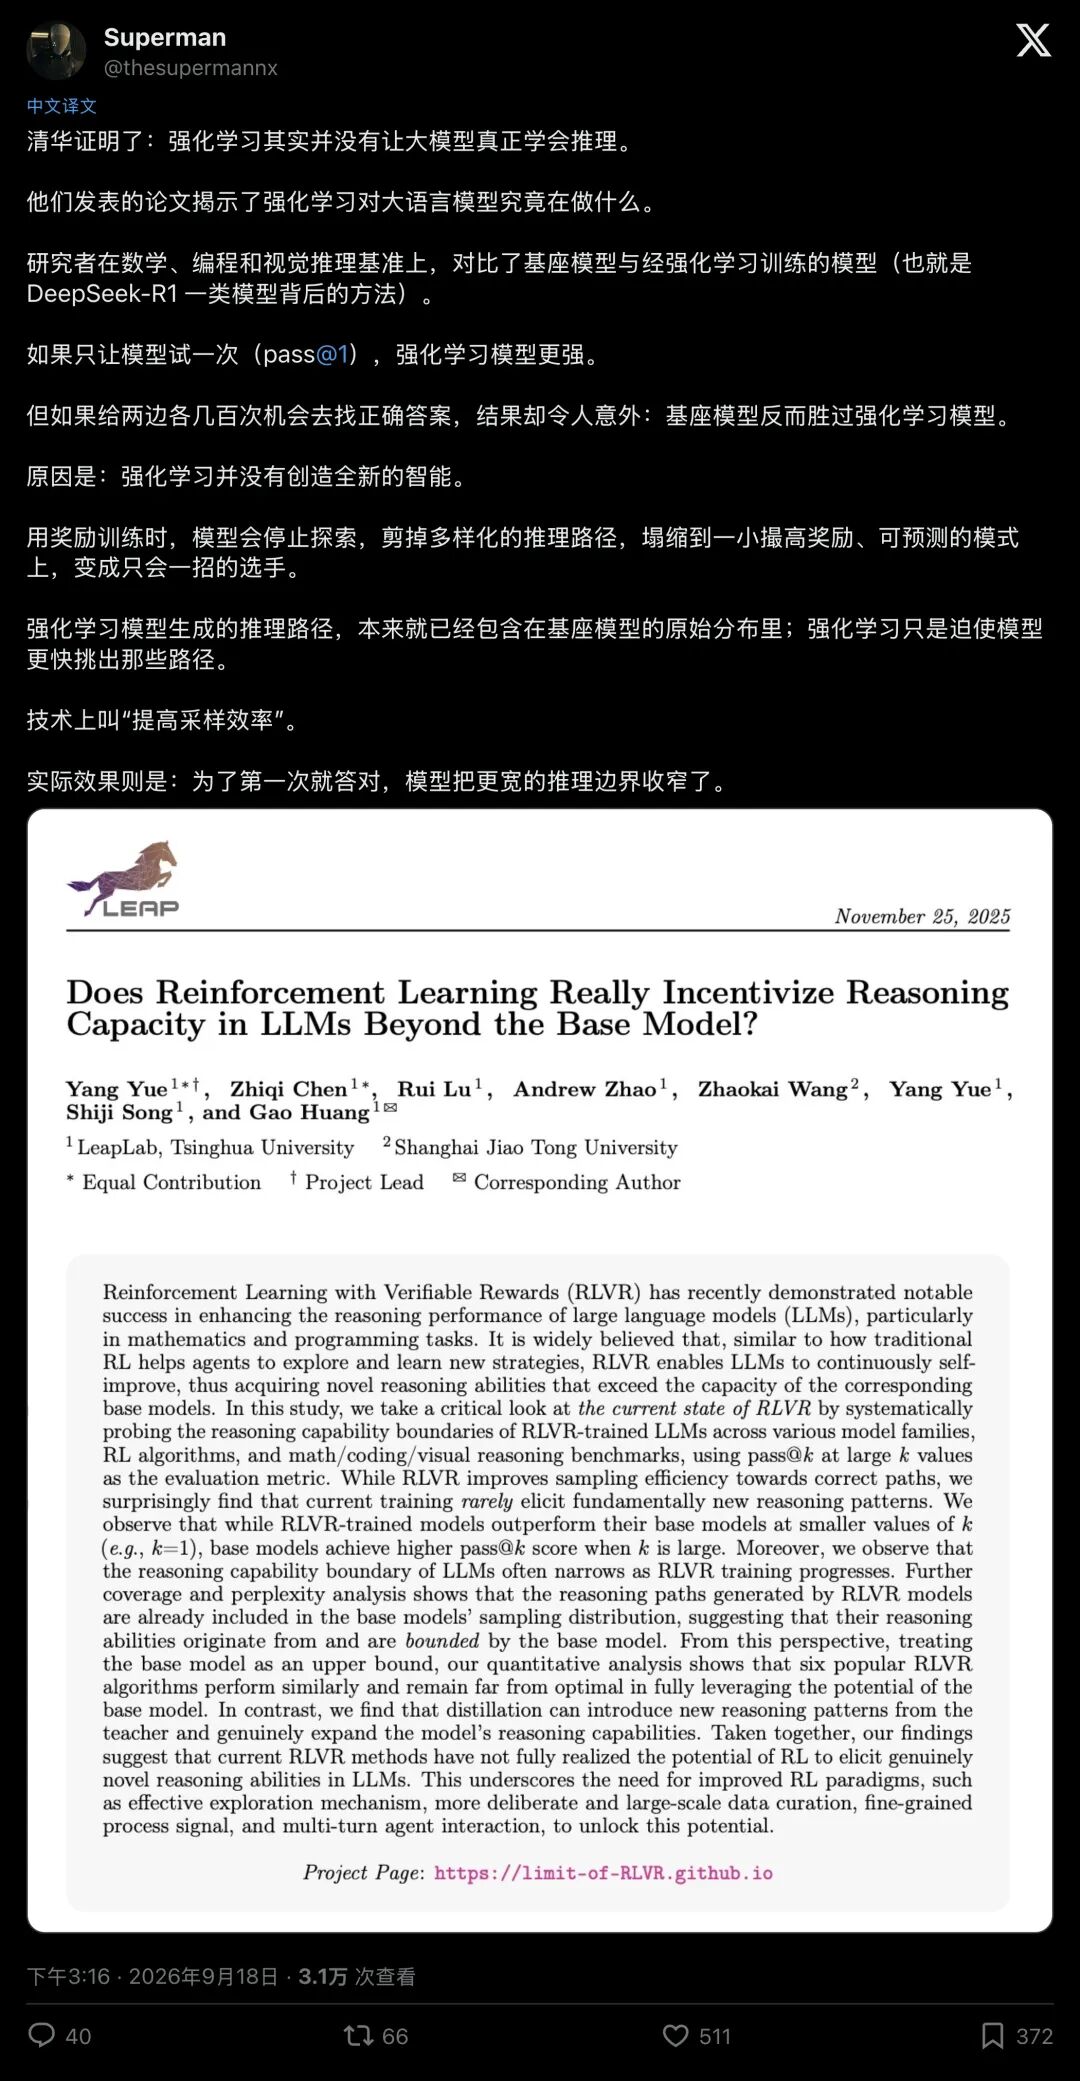
▲ 社交媒体热帖对清华论文核心结论的通俗转述
强化学习不仅没有带来全新的智能,反而残忍地“阉割”了大模型的潜能?
这个颠覆行业认知的发现,迅速引发全球轰动。
01异常的交叉:多试几次,AI 竟然原形毕露
这个离奇的线索,隐藏在一个名为 pass@k 的测试指标里。
简单来说:
- pass@1
:给大模型一道奥数题,只准它做一次,看它能不能答对。这测的是模型的“第一枪命中率”; - pass@k(比如 k=256 甚至 1024)
:允许模型独立尝试 256 次或 1024 次,只要其中有一次做对了,就算过关。这测的是模型的“能力极限边界”,也就是只要穷尽一切可能,它到底能不能摸到这道题的答案。
按照业界的直觉,经过海量强化学习、学会了深度思考的模型,无论测一次还是一千次,理应全方位碾压未经训练的基座模型。
但实验结果却直接给所有人泼了一桶刺骨的冰水。
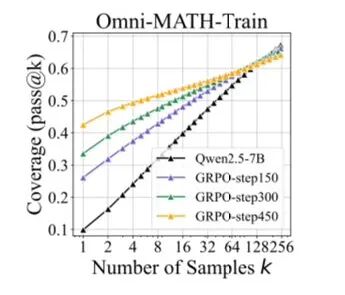
▲ 论文展示的 pass@k 曲线形态:小 k 时强化学习模型领先,大 k 时基座模型实现反超
看这组诡异的曲线:当只试一次($k=1$)时,RL 训练后的模型确实光芒万丈,准确率遥遥领先,展现出碾压基座的强悍姿态。
但随着尝试次数 $k$ 不断拉大,耸人听闻的事情发生了,经过千锤百炼的 RL 模型,曲线早早躺平成了一条死线;而那个没经过任何强化训练、看起来懵懵懂懂的原生基座模型,竟然在几十次、上百次的尝试中一路后劲勃发,硬生生地追上并反超了 RL 模型!
在 AIME、MATH 等高难度竞赛数学测试里,这种反超屡试不爽。交叉点有时甚至低到令人发指的个位数。
这个现象揭示出一个反直觉的事实:
在难度极高的高阶赛题面前,只要给予足够充分的采样尝试,未经额外强化训练的原生基座,覆盖的解题范围反而明显大于经过强化学习训练的模型!
02追查真凶:一场残酷的“神经剪枝”
这篇在 2025 年引起学界巨大反响的论文,来自清华大学自动化系 LeapLab(黄高教授团队)与上海交通大学的合作研究,《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》(简称 Limit-of-RLVR)。
论文不仅入选 NeurIPS 2025 Oral,更获得了四位审稿人罕见的全满分评价,最终斩获 NeurIPS 2025 最佳论文亚军(Best Paper Runner-Up)。清华大学官方通报证实:这是该顶会设立大会最佳论文奖以来,首篇完全由国内高校学者独立完成的获奖成果。
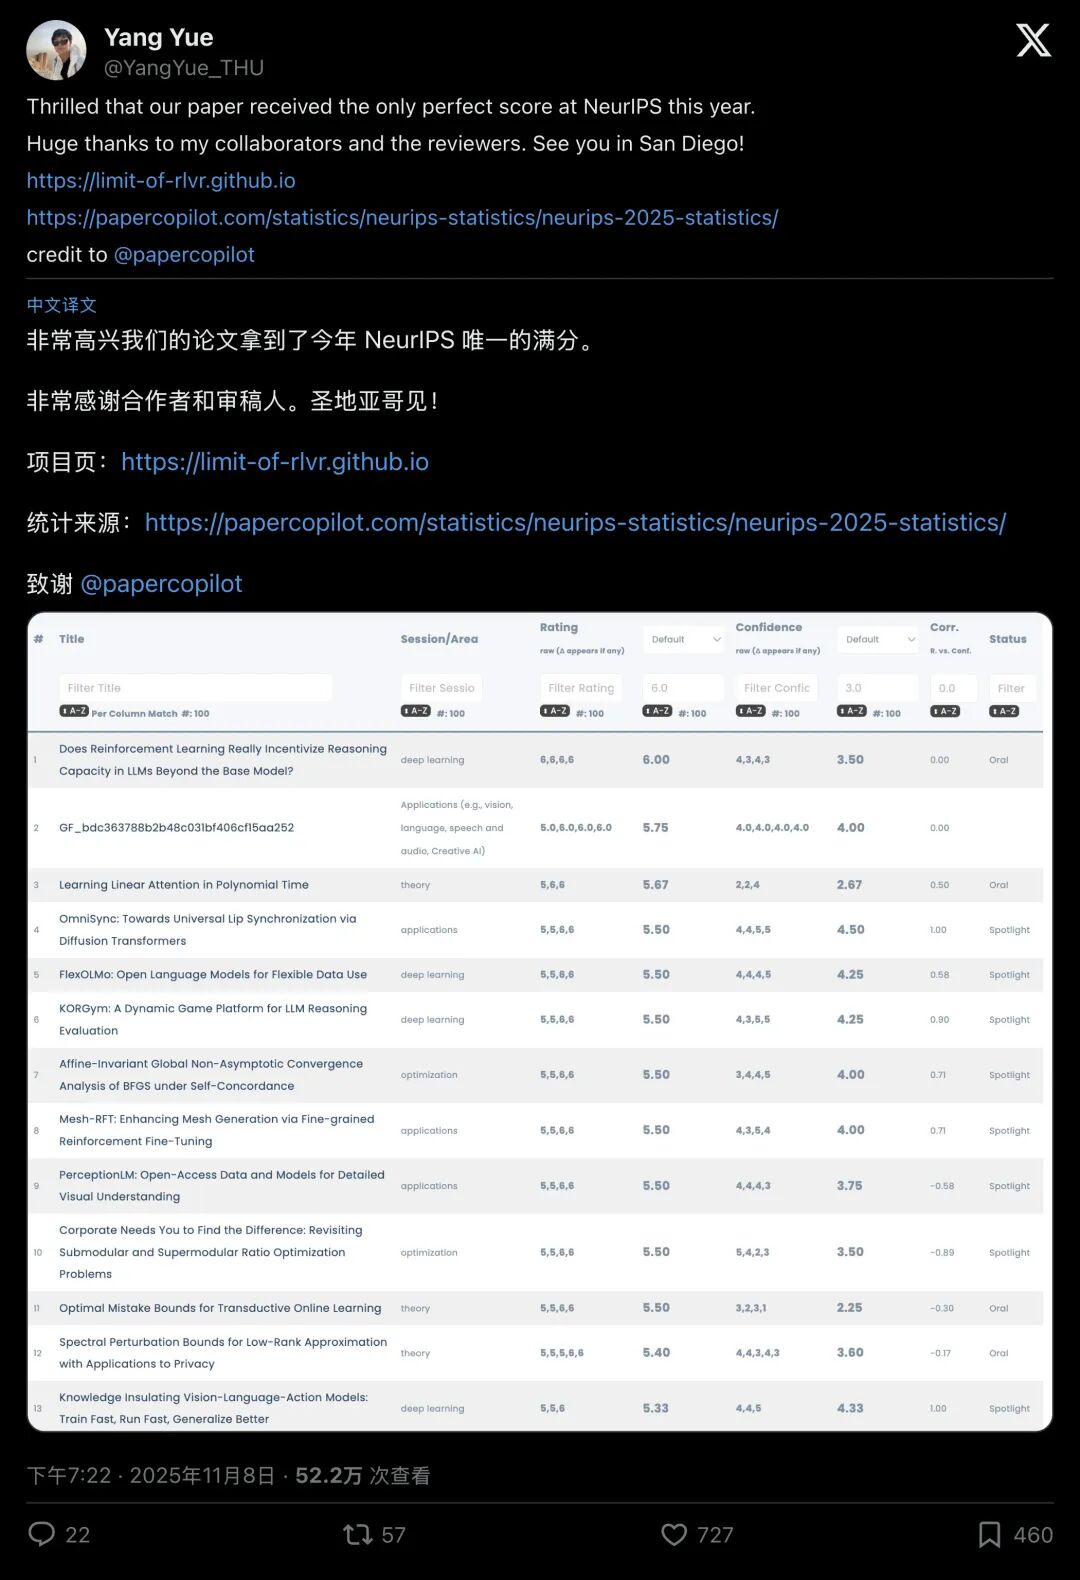
▲ 共同第一作者乐洋公布论文在 NeurIPS 获得唯一满分评价
为什么强化学习练得越久,大模型反而越像个“偏科生”?
清华团队顺藤摸瓜,用覆盖率与困惑度(Perplexity)分析,指出了现象背后的深层机制:模型并没有凭空涌现全新智能,而是在大幅度进行路径剪枝。
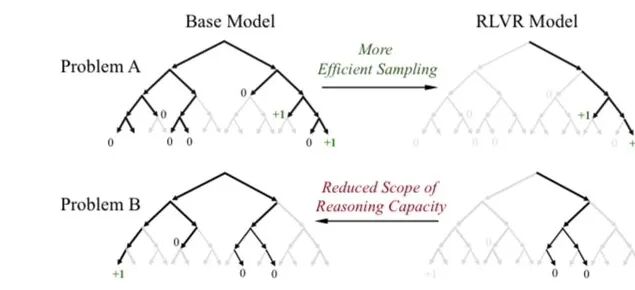
▲ 强化学习对推理路径的剪枝效应示意图:从原本茂密的思维树,坍缩为单一的高奖赏路径
原始基座模型拥有极为宽广的概率分布,涵盖了丰富多样的思维触角。即便单次作答可能漫无边际,可是在海量采样空间深处,仍保留着极具探索性的罕见路径。只要给予足够多次独立尝试,就有可能命中正确解法。
但可验证强化学习(RLVR)是怎么训练的?规则极度残酷:答案对了给 1 分,错了给 0 分。
为了在短时间内最大化获取正向奖励,模型在梯度优化驱动下迅速收敛,将绝大部分概率质量高度集中在极少数见效最快的路径上,而将那些需要曲折探索、初始概率较低的探索路径逐步压制甚至剪除。
这就是典型的模式坍塌(Mode Collapse)。
它由此演变成一个熟练的应试专家模型单次命中率的显著提升,源于对高频成功路径的反复强化,代价则是牺牲了那些可能通向更广边界的探索分支。
RLVR 没有拓宽认知疆土,它只是把大模型原本宽广的解题边界,生生压缩成了一条狭窄但保险的高速公路。
03机制深挖:所谓“顿悟”,其实是预训练埋好的彩蛋
在 DeepSeek-R1 等模型发布时,很多人津津乐道于模型在长思维链中展现出的“等等,让我想一想”、“哎呀我前面算错了”等顿悟时刻(Aha moment),并把这归功于强化学习的神奇造化。
但清华团队的量化数据,又无情地打碎了这个滤镜。
团队检测了 RL 模型生成的所有推理轨迹,并在基座模型上计算困惑度。结果让人心头一颤:那些所谓的反思、自我修正轨迹,对基座模型而言一点都不陌生!
基座模型原本就能吐出这些句子,只是概率相对较低。强化学习只是像一个敏锐的聚光灯,顺着基座原本的纹理,把这些高潜力的行为照得更亮、调得更频繁而已。
六种主流的 RL 算法轮番上阵,评测结论高度一致:没有任何一种算法能实质突破基座模型预先划定的能力边界。
基座模型本身的先验分布,构成了后续强化学习无法逾越的上限。
04探索破局路径:强化学习与蒸馏的横向对照
既然当前的强化学习主要是在激活既有知识分布,那么是否存在有效手段,能将全新的推理模式实质性注入模型结构之中?
清华团队在论文第 4.2 节给出了一个堪称神来之笔的对照组:把 RLVR 与知识蒸馏(Distillation)放在同一天平上横向较量。
实验挑选了极其工整的对照阵容:
- 基座模型
:Qwen2.5-Math-7B-Base; - 纯强化学习模型
:Qwen2.5-Math-7B-Oat-Zero; - 蒸馏推理模型
:DeepSeek-R1-Distill-Qwen-7B(以 671B 的 DeepSeek-R1 教师模型生成的思维链作为微调数据)。
当三者在数学竞赛题目上展开残酷的全采样对决时,震撼的一幕出现了:
- RLVR 路线
:再次重演悲剧,虽然在 $k=1$ 表现亮眼,但曲线很快乏力,中大采样区间被基座模型反超; - 蒸馏路线
:自始至终画出了一条全采样区间完美压制的天际线!不论是试 1 次、试 256 次,还是试 1024 次,蒸馏模型从未给基座任何反超的机会,呈现出绝对的降维打击!
为什么两者会有如此云泥之别?
底层逻辑在于信息流向的本质差异:
RLVR 是“内卷式优化” 它只能在模型自己吐得出来的候选句子里挑挑拣拣打分。如果某道顶级难题的解法,在 7B 基座原本的概率分布里概率为零,那它就算跑上亿次 Rollout 也碰不出来,强化学习再强也巧妇难为无米之炊。
蒸馏却是“开天门式的知识灌顶” 满血版的 DeepSeek-R1 是经过 6710 亿参数大洗练的巨兽,脑海中存有无数精妙高深的高阶推理模式。通过蒸馏,这些原本在小模型脑海中根本不存在的全新认知结构,被作为强监督信号,硬生生焊进了小模型的参数里!
这一机制深刻契合了近期开源业界的工程实践:DeepSeek 在推出轻量化模型时,并未在小尺寸模型上孤立开展无监督 RL 训练,而是直接构建蒸馏版本模型矩阵;开源高分代码推理模型 DeepCoder-14B,同样选择以 DeepSeek-R1-Distill-Qwen-14B 为底座进一步叠加强化学习。
先用蒸馏拓宽边界,再用 RL 提升采样效率,工业界的实战血泪史,在清华的论文里找到了最硬核的数学注脚。
05作者发声:不要神化,更不要全盘否定
论文引发广泛讨论后,部分网络解读走向极端,借此鼓吹“强化学习无用论”。
论文第一作者乐洋随后多次在社交媒体公开澄清,态度明确:团队指出的实证局限,意在厘清能力边界,而非全盘否定强化学习的价值!
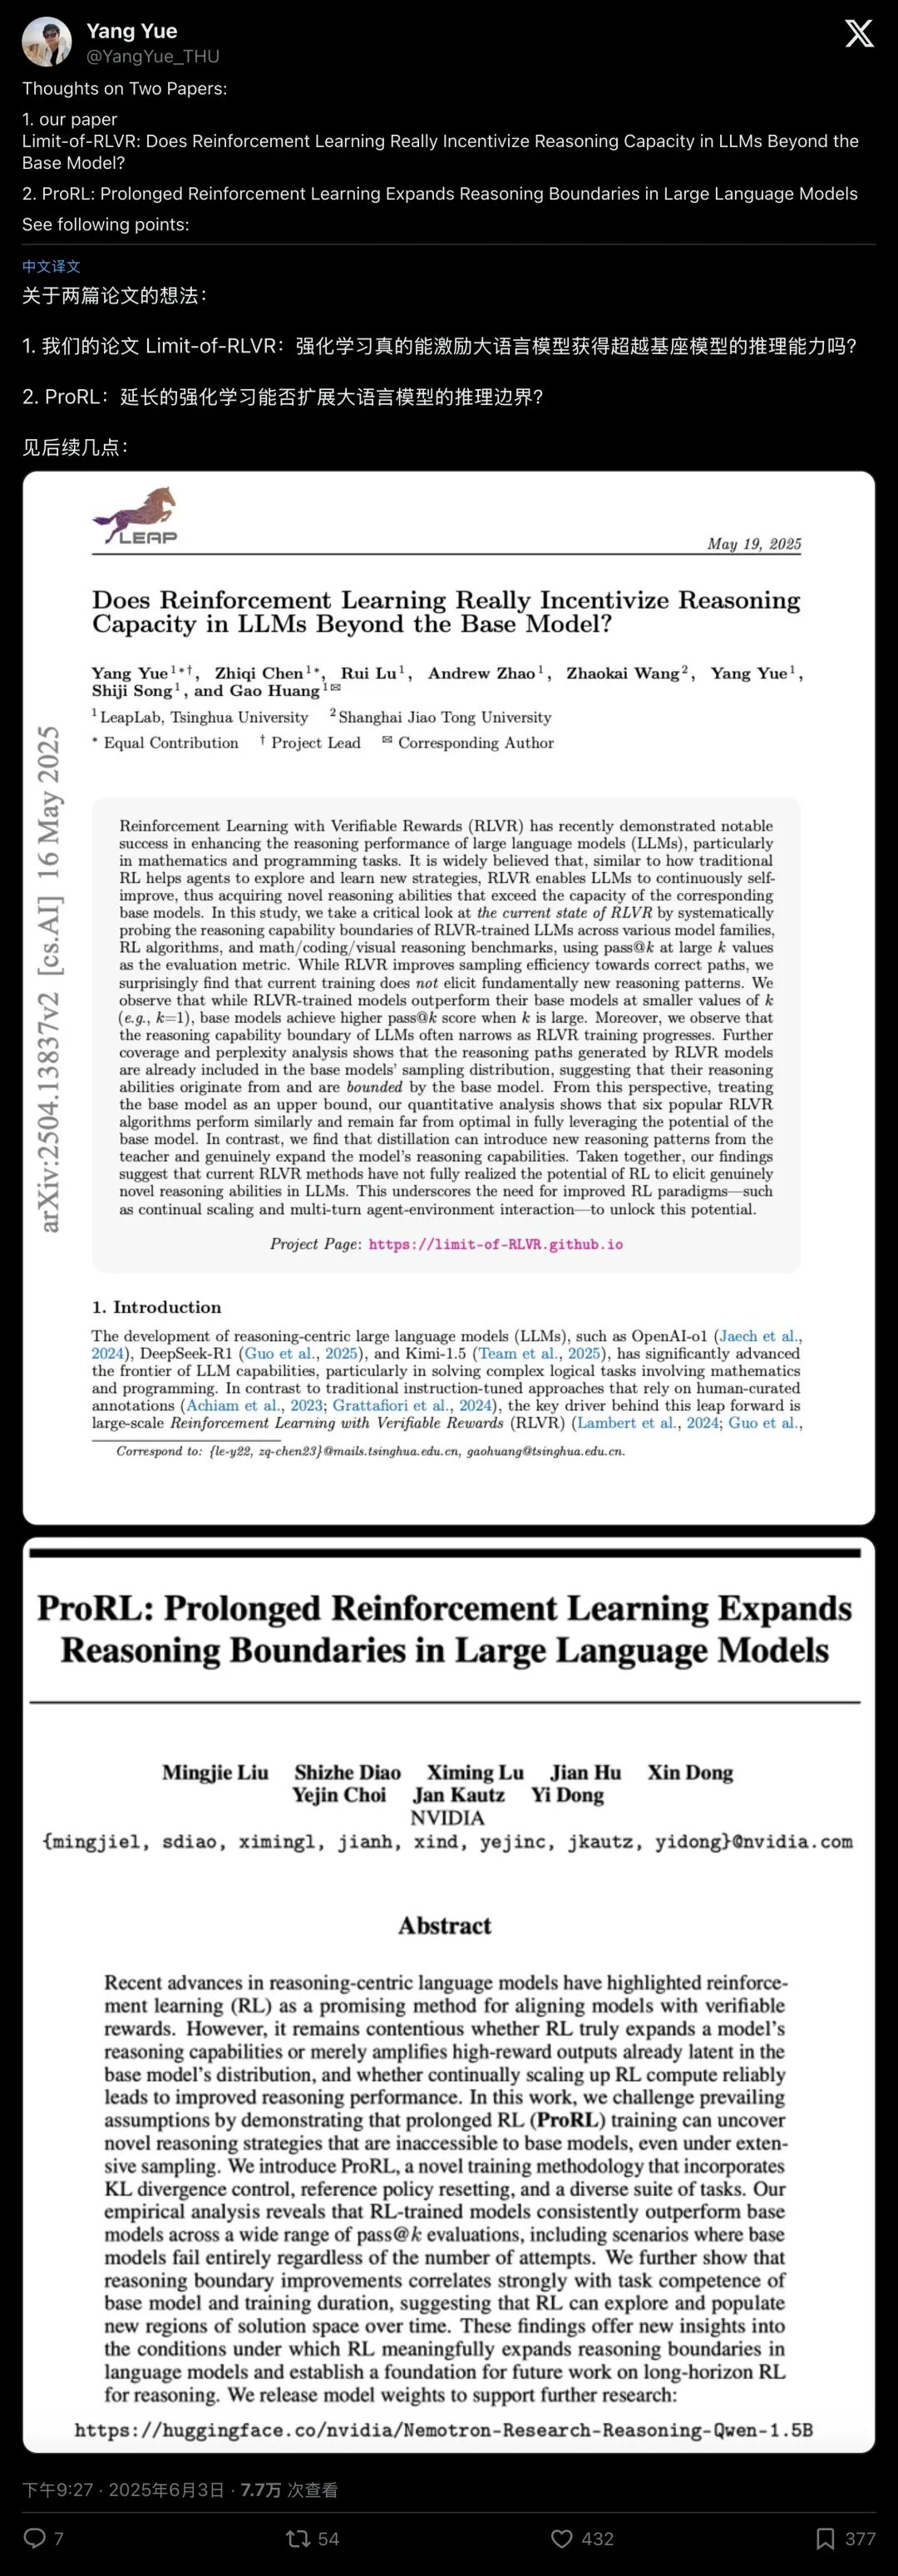
▲ 作者乐洋发推澄清立场:强调客观评估实证边界,呼吁探索更具泛化探索特性的 RL 新范式
必须理清这一层极度关键的商业与学术界线:
- 在商业落地端
:绝大多数真实业务(如搜索助手、代码补全)只给你一次生成机会,没人愿意等模型抽卡 1000 次挑一个答案。在 $k=1$ 的场景下,RLVR 带来的效率提升是真金白银的生产力飞跃。 - 在科学前沿端
:当人类造出全球最顶尖的超大万亿模型(Frontier Models)时,天底下已经没有更聪明的“教师模型”可供蒸馏。这时,如果还沿用当下这种只看 0/1 结果、闭门造车的 RLVR,AI 就永远无法跨越人类知识的现有疆域。
当前的 RLVR 表现为典型的高强度应试优化,尚未展现出面向未知的探索能力。
若希望模型具备类似 AlphaZero 那样自主发现全新策略的潜能,前沿探索需要跳出单调的结果反馈模式:不能再沉迷于粗糙的结果奖励,而是需要引入更细粒度的过程奖励(PRM)、给大模型提供充满不确定性的多轮动态环境交互、甚至在推理时注入更深层次的蒙特卡洛树搜索(MCTS)。
清华这篇摘得顶会桂冠的神作,最宝贵的地方恰恰在于此,
它没有在喧嚣狂热的造神浪潮中随波逐流,而是用严谨冷峻的实验数据,亲手打碎了行业的玄学幻觉。
科学探索的进步,往往始于认清边界的那一刻。唯有准确厘清现有技术的适用范围,面向下一代通用智能的创新路径才会更为清晰。