ARTICLE · 1123220
V4L2 源码深度解析(五):申请 4 个缓冲区,内核到底分配了什么?
上一节结束时,VIMC 的采集节点已经注册,队列也已经初始化。驱动知道自己支持什么格式、使用哪一种内存后端,以及以后收到缓冲区时应该调用哪些函数。但队列里还没有真正用来存放图像的缓冲区。
现在,应用发出一个很小的请求:
structv4l2_requestbuffersreq = {0};
req.type = V4L2_BUF_TYPE_VIDEO_CAPTURE;
req.memory = V4L2_MEMORY_MMAP;
req.count = 4;

int ret = ioctl(fd, VIDIOC_REQBUFS, &req);
这个结构体没有图像宽度,没有高度,也没有每个缓冲区的地址。内核却要据此准备好几组可以容纳图像的存储。大小从哪里来?一次分配会创建多少种对象?如果前三块成功、第四块失败,这次申请算不算成功?
本篇就沿着这次请求往下读。先把申请的含义讲清楚,再依次进入接口层、队列核心、驱动布局回调和 vmalloc 分配器。结束时,缓冲区池已经建立;查询和映射留到下一篇。
1. 申请的不是四帧图像,而是四个可重复使用的位置
1.1 先确定每个位置要有多大
延续 VIMC 的默认格式:640 × 480、RGB24,每个像素占 3 字节,行尾没有额外填充。驱动保存的格式信息为:
bytesperline = 640 × 3 = 1920 字节
sizeimage    = 1920 × 480 = 921600 字节
sizeimage 是这个格式所需的存储容量。请求 4 个缓冲区,就是希望准备 4 组这样的存储;后续采集可以轮流使用它们。buffer 0 用完以后还会再次使用,不是只对应第 0 帧。
如果四块都建立成功,仅像素区域的逻辑容量就是:
4 × 921600 = 3686400 字节 = 3.515625 MiB
这还没有计入缓冲区管理结构、分配器私有对象和页表等开销。这个例子采用固定大小的线性 RGB 布局;其他格式应使用驱动协商后的容量,不能一律按宽高乘每像素字节数计算。
1.2 REQBUFS 为什么不再传宽高
格式是在更早的阶段确定的。应用可以通过 S_FMT 协商,也可以通过 G_FMT 读取已经存在的默认格式。VIMC 将当前格式保存在 vcapture->format 中。
REQBUFS 负责的是“按照当前格式,建立多少个缓冲区”。如果它同时再携带一套独立宽高,就会产生两份需要保持一致的配置。这里的实现选择读取驱动已经保存的格式,由驱动的 queue_setup() 给出容量要求。
格式与申请之间因此有一项实际约束:申请过程中读到的格式必须稳定。VIMC 将节点操作锁和队列操作锁都指向 vcapture->lock,并在已有缓冲区时拒绝随意修改格式。锁与状态检查共同保证布局的一致性。
1.3 还需要一份记录每块存储的信息
只有像素内存,框架仍然不知道它属于哪个队列、编号是多少、有几个平面、每个平面多大。因此,每个缓冲区还需要一个管理对象。
对本篇选定的 vmalloc 后端,一块缓冲区建立后包含三类资源:
缓冲区管理对象:保存索引、状态、平面描述和驱动扩展。 平面分配器对象:保存这个平面的 CPU 地址、分配大小和存储引用。 实际存储:用于后续写入图像的内存页。
三者的大小不同,分配者不同,释放方式也不同。后面每经过一层函数,都要看清这次拿到的是哪一种对象。
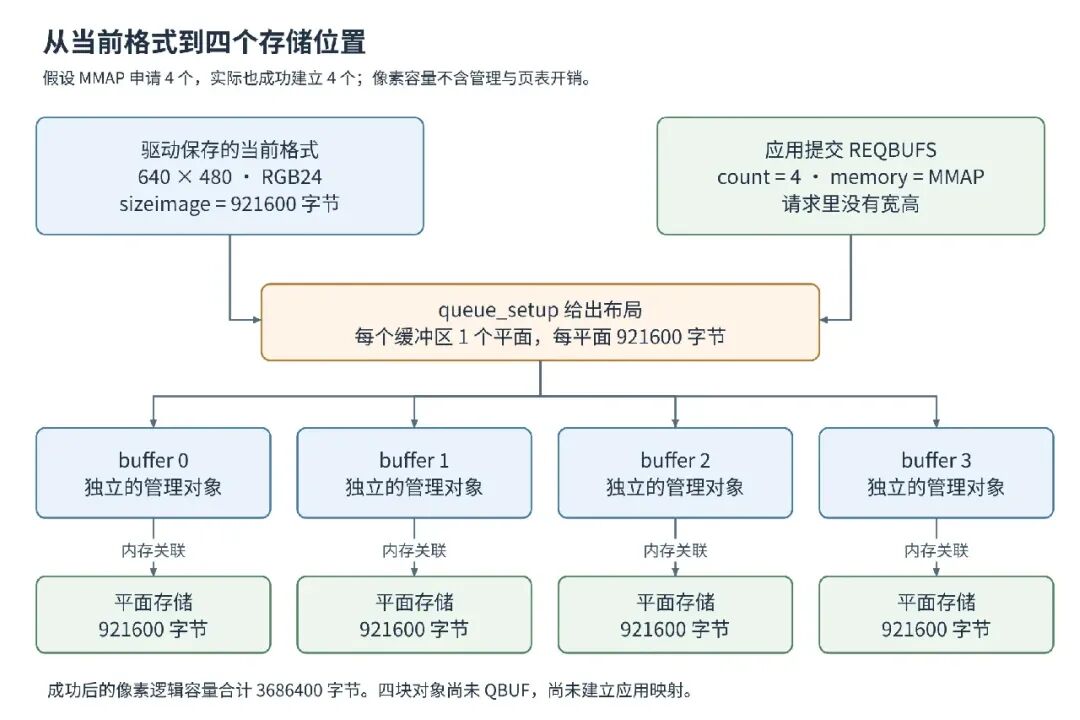
图 1:按分配结果组织的示意,不是逐函数调用图。假设请求 4 个且全部成功;尚未映射到应用,也没有采集结果。
本篇沿普通 CAPTURE、MMAP、vmalloc 分支分析,使用 min_buffers_needed 和固定 bufs[] 的这份实现。VIMC 也能选择其他内存后端;其余模式只在涉及分支时说明区别,不混入本次分配过程。
实现对照:vimc-capture.c 中的 fmt_default、vimc_capture_add()、vimc_capture_s_fmt_vid_cap()。
2. 六个函数不是一条不返回的直线
请求经过前面已经分析的标准 ioctl 入口,最终来到驱动提供的 vidioc_reqbufs。VIMC 将这个成员接到 vb2_ioctl_reqbufs()。
最适合阅读的调用关系是:
vb2_ioctl_reqbufs()
  └─ vb2_core_reqbufs()
       ├─ 调用 queue_setup 回调
       │    └─ vimc_capture_queue_setup()
       ├─ __vb2_queue_alloc()
       │    └─ 每个 MMAP 缓冲区:__vb2_buf_mem_alloc()
       │         └─ 每个平面:mem_ops->alloc()
       │              └─ vb2_vmalloc_alloc()
       ├─ 分配数量不足但达到下限时,再次调用 queue_setup
       └─ 接受实际数量,或回收本轮已经建立的对象
vimc_capture_queue_setup() 返回以后,执行位置回到 vb2_core_reqbufs(),由核心继续发起分配。它并不直接调用 __vb2_queue_alloc()。同样,分配器返回一个平面对象后,也要逐层返回,直到核心拿到完整成功的缓冲区数量。
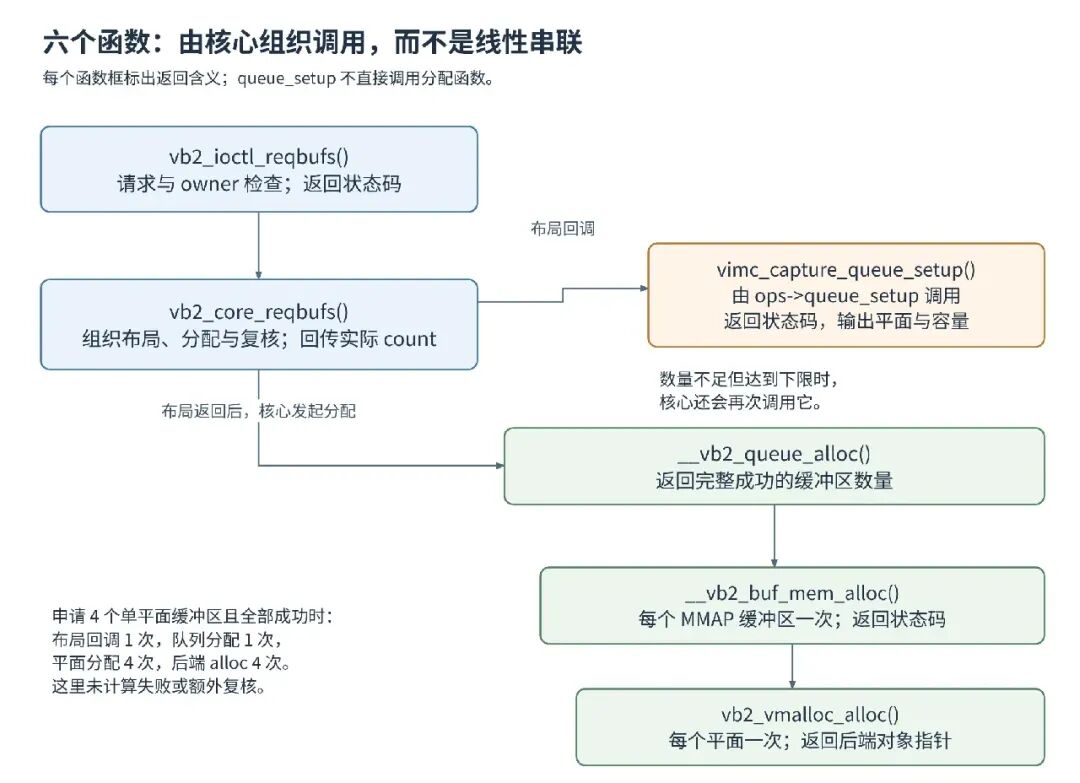
图 2:实线表示调用,返回值标在函数框内。布局回调与分配函数由核心在不同阶段调用;数量不足时可能再次进入同一个布局回调。
三个参数类别也要在入口处认清:
type 选择当前操作的队列类型;memory 选择这次采用 MMAP、USERPTR 还是 DMA-BUF;count 表示希望建立的缓冲区数量。一个双平面缓冲区仍只占用一个 count,平面数由另一组参数描述。
这一份接口辅助函数直接调用 vb2_core_reqbufs(),**不经过名称相近的 vb2_reqbufs()**。后者是另一条以队列为参数的辅助入口,没有当前这层基于 struct file 的 owner 检查。读调用链时必须以实际调用为准。
实现对照:v4l2-ioctl.c 的 v4l_reqbufs();vimc_capture_ioctl_ops;videobuf2-v4l2.c 的两个 REQBUFS 辅助入口。
3. vb2_ioctl_reqbufs:先判断这次请求能不能进入队列
下面保留完整函数的可执行语句,只去掉说明性注释并调整缩进。
intvb2_ioctl_reqbufs(struct file *file, void *priv,
              struct v4l2_requestbuffers *p)
{
structvideo_device *vdev = video_devdata(file);
int res = vb2_verify_memory_type(vdev->queue, p->memory, p->type);
    u32 flags = p->flags;

    fill_buf_caps(vdev->queue, &p->capabilities);
    validate_memory_flags(vdev->queue, p->memory, &flags);
    p->flags = flags;
if (res)
return res;
if (vb2_queue_is_busy(vdev->queue, file))
return -EBUSY;
    res = vb2_core_reqbufs(vdev->queue, p->memory, p->flags, &p->count);

if (res == 0)
        vdev->queue->owner = p->count ? file->private_data : NULL;
return res;
}
3.1 验证模式,也验证实际能力
vb2_verify_memory_type() 检查的不只是枚举值。它先确认 memory 是允许的内存方式,再确认请求的 type 与队列配置一致。
对 MMAP,它还要求队列声明 VB2_MMAP,并提供 alloc、put、mmap 三个内存操作。申请时虽然不会立即调用 mmap,框架仍然检查这是一套能够完成后续访问与释放的配置。少了其中一项,就不是完整的 MMAP 能力。
最后还会检查 read/write 辅助流是否占用了队列。这些检查发生在真正分配像素存储之前;对应失败通常是 EINVAL 或 EBUSY,不能一看到 REQBUFS 失败就判断“内存不够”。
3.2 capabilities 与 flags 分别表达什么
fill_buf_caps() 填写的是队列支持的缓冲区接口能力,例如 MMAP、USERPTR、DMA-BUF,以及是否支持释放队列后保留额外持有的存储。它不是图像像素格式列表。
validate_memory_flags() 则整理本次申请的内存提示。当前实现中,队列未开放缓存提示,或者不是 MMAP 时,会清零这些标志;其他情况下仅保留已知的非一致性内存提示。
本篇请求结构先清零,因此 flags == 0。不需要为了“优化性能”随意设置 V4L2_MEMORY_FLAG_NON_COHERENT。这个位不会替代后续 CPU 与设备之间的缓存交接。
函数在检查 res 之前已经填写了部分返回字段,但最终错误是否带回这些字段,还取决于外层 ioctl 回写规则。不能把“在内核里赋过值”当成“应用一定收到这个值”。
3.3 owner 只负责当前操作的归属检查
队列已有 owner,且它不同于当前 file->private_data 时,vb2_queue_is_busy() 会拒绝这次申请。独立打开和 dup 的关系已经在第三篇讲过;此处只需要把 private_data 理解成打开上下文身份。
检查通过以后,接口层进入核心。核心返回 0,才根据返回的 p->count 更新 owner:数量非零,记录当前上下文;数量为零,清空 owner。核心失败则不执行这次赋值。
这并不是“只有 owner 才能调用节点上的一切接口”。owner 检查由特定辅助入口执行,本篇只讨论它如何约束缓冲区申请。
3.4 为什么 count 要传地址
&p->count 使核心能把实际成功数量写回同一个请求对象。比如应用请求 4 个,核心可能建立 3 个,也可能根据最低要求把请求 1 个调整为 2 个。成功返回后,后续操作应使用返回数量。
这里修改的是外层 ioctl 已经准备好的内核参数对象,不是直接在驱动深处解引用应用地址。最终仍由外层完成回写。
实现对照:vb2_verify_memory_type()、fill_buf_caps()、validate_memory_flags()、vb2_ioctl_reqbufs();owner 的辅助判断见配套 videobuf2-v4l2.h。
4. vb2_core_reqbufs:先整理当前状态,再决定怎样分配
核心函数既能建立第一批缓冲区,也能释放或重建已有缓冲区池。为了理解后面的分配,先看它在前半段完成哪些准备。
4.1 正在采集时,不能直接换掉池
入口首先检查:
if (q->streaming) {
    dprintk(q, 1, "streaming active\n");
return -EBUSY;
}

if (q->waiting_in_dqbuf && *count) {
    dprintk(q, 1, "another dup()ped fd is waiting for a buffer\n");
return -EBUSY;
}
第一项拒绝 streaming 状态下的所有 REQBUFS,包括 count == 0。对这条实现,应先通过停止接口结束流,再释放或重建缓冲区池,不要用 REQBUFS(0) 无条件替代 STREAMOFF。
第二项检查是否存在正在等待 DQBUF 的执行路径。它只拒绝非零重建;不是统计打开了多少个 fd,而是防止在等待者仍使用当前队列时替换缓冲区安排。
4.2 第一轮申请与再次申请在哪里分开
随后有一个条件分支:
if (*count == 0 || q->num_buffers != 0 ||
    (q->memory != VB2_MEMORY_UNKNOWN && q->memory != memory) ||
    !verify_coherency_flags(q, non_coherent_mem)) {
/* 整理原队列、释放原有缓冲区的分支。 */
}
这是条件节选,花括号内的说明不是原函数的完整实现。
请求数量为零、原池非空、已选内存方式不同,或者内存一致性属性不匹配,都可能进入这个分支。分支中的主要动作是:取得 mmap_lock,取消已有排队安排,调用 __vb2_queue_free() 清理旧对象,释放锁并检查返回值。
这里还要取消“已经准备或排队,但尚未 STREAMON”的对象。未启动采集,不代表不存在需要收回的队列状态。
旧池清理成功后,如果请求数量为零,核心立即返回,不再进入布局回调和新分配。非零请求则继续建立新池。再次 REQBUFS 的含义是重新建立池,不是向旧池追加几个对象。
4.3 核心先给数量划定一个范围
在新一轮分配前,源码执行:
WARN_ON(q->min_buffers_needed > VB2_MAX_FRAME);
num_buffers = max_t(unsignedint, *count, q->min_buffers_needed);
num_buffers = min_t(unsignedint, num_buffers, VB2_MAX_FRAME);
memset(q->alloc_devs, 0, sizeof(q->alloc_devs));
这里的 num_buffers 是准备交给驱动的目标数量,还不是成功数量。
VIMC 把 min_buffers_needed 设为 2。因此请求 1 个时,核心首先按 2 个考虑;请求 4 个时仍按 4 个考虑,前提是没有超过当前实现的上界。min_buffers_needed 也参与后续启动判断,但在这里已经影响分配数量,不能认为它只与 STREAMON 有关。
VB2_MAX_FRAME 是当前内核实现的容量边界,不应把一个版本的数值写成永远固定的应用接口保证。
4.4 回调之前先设置 memory
接下来先在 mmap_lock 下更新 q->memory,再设置相应的一致性属性:
mutex_lock(&q->mmap_lock);
q->memory = memory;
mutex_unlock(&q->mmap_lock);
set_queue_coherency(q, non_coherent_mem);
这样,驱动在 queue_setup() 中读取 q->memory,看到的就是本轮申请模式,而不是上一次或初始的 UNKNOWN。
注意锁的范围:这几条语句不意味着整个核心函数始终持有 mmap_lock。布局回调和接下来的长时间分配,不在这一段内部锁里。具体锁范围在后文一起核对。
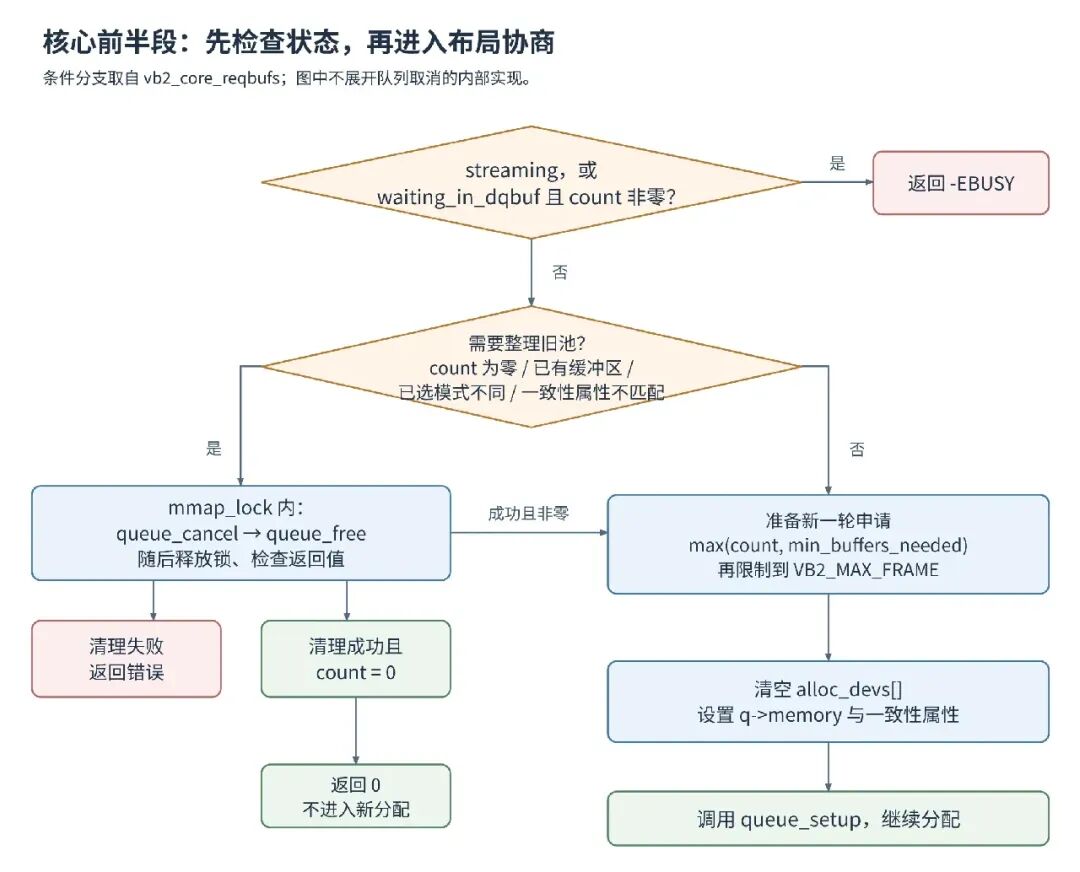
图 3:只画核心的前半段。清理错误必须先释放实际持有的锁;零数量成功返回接口层以后,仍会按规则清空 owner。
实现对照:vb2_core_reqbufs()、set_queue_coherency()、verify_coherency_flags()、__vb2_queue_free()。
5. vimc_capture_queue_setup:图像大小从当前格式里取出来
5.1 核心把需要确定的量交给驱动
第一次进入布局回调时,核心准备的 num_planes 为 0,plane_sizes[] 清零,然后调用:
ret = call_qop(q, queue_setup, q, &num_buffers, &num_planes,
              plane_sizes, q->alloc_devs);
在 VIMC 配置下,这次调用最终进入:
staticintvimc_capture_queue_setup(struct vb2_queue *vq, unsignedint *nbuffers,
unsignedint *nplanes, unsignedint sizes[],
                struct device *alloc_devs[])
{
structvimc_capture_device *vcapture = vb2_get_drv_priv(vq);

if (*nplanes)
return sizes[0] < vcapture->format.sizeimage ? -EINVAL : 0;

    *nplanes = 1;
    sizes[0] = vcapture->format.sizeimage;

return0;
}
call_qop 是调用包装。忽略可选的调试计数,实际连接来自 q->ops->queue_setup,并不是框架根据“vimc”这个名字自动搜索函数。
5.2 每个输出参数要回答一个不同的问题
nbuffers 指向目标缓冲区数量。驱动可以根据设备要求确认或调整它,但 VIMC 这段代码没有修改这个值。默认最低数量 2 来自队列配置和核心处理,不是这个回调偷偷把数量改成 2。
nplanes 指向每个缓冲区的内存平面数。首次 REQBUFS 以 0 进入,表示需要驱动给出布局;VIMC 设置为 1。
sizes[] 保存每个平面的容量要求。这里将 sizes[0] 设为 vcapture->format.sizeimage,所以当前默认格式会给出 921600 字节。
alloc_devs[] 允许驱动按平面指定分配设备。VIMC 不填写它,前面核心又已经将数组清零,因此后续选择默认的 q->dev。
这四种信息共同描述“应该怎样分配”,但回调里并没有分配像素页,也没有返回像素地址。
5.3 从 queue 找到当前格式的路径
vb2_get_drv_priv(vq) 取出队列的 drv_priv。初始化时,VIMC 已经把它设置为 vcapture。所以实际的数据路径是:
当前队列 q
  → q->drv_priv
  → vcapture
  → vcapture->format.sizeimage
  → sizes[0]
这里不通过 file->private_data 找格式。前者是设备级对象,后者是打开级上下文,刚好承担不同的任务。
5.4 为什么还有 nplanes 非零的分支
同一个 queue_setup() 也供其他建立路径使用。*nplanes 非零时,调用方已经提供了平面布局,VIMC 在这里检查 sizes[0] 能否容纳当前图像;容量不足返回 -EINVAL。
本次普通 REQBUFS 首次调用不是这条分支。稍后分配数量不足时,核心会再次将 num_planes 置零,因此第二次数量复核仍然保持 REQBUFS 的调用形式。不能把“第二次调用”自动解释成“进入 nplanes 非零分支”。
5.5 核心会检查输出,但驱动仍要正确计算
回调成功后,核心检查平面数非零,并逐项检查容量非零。正确驱动还必须保证平面数没有超过数组容量,尺寸计算没有溢出,整个布局与当前格式一致。
这份实现不能替驱动证明所有输出都安全;尤其不要假定非零检查会自动纠正过大的平面数,或者恢复已经在早期乘法中溢出的 sizeimage。
实现对照:vimc_capture_queue_setup()、vimc_capture_add();vb2_core_reqbufs() 的第一次 queue_setup 与返回检查。
6. __vb2_queue_alloc:先给每一块存储建立管理对象
布局确定以后,核心调用:
allocated_buffers =
    __vb2_queue_alloc(q, memory, num_buffers, num_planes, plane_sizes);
这个函数返回的是完整建立的缓冲区数量。它不以负错误码直接告诉外层某一次分配为什么失败,这一点会影响后面的错误处理。
6.1 外层循环负责缓冲区数量
先看从数量限制到登记槽位的连续节选:
num_buffers = min_t(unsignedint, num_buffers,
                    VB2_MAX_FRAME - q->num_buffers);

for (buffer = 0; buffer < num_buffers; ++buffer) {
    vb = kzalloc(q->buf_struct_size, GFP_KERNEL);
if (!vb) {
        dprintk(q, 1, "memory alloc for buffer struct failed\n");
break;
    }

    vb->state = VB2_BUF_STATE_DEQUEUED;
    vb->vb2_queue = q;
    vb->num_planes = num_planes;
    vb->index = q->num_buffers + buffer;
    vb->type = q->type;
    vb->memory = memory;
    init_buffer_cache_hints(q, vb);
for (plane = 0; plane < num_planes; ++plane) {
        vb->planes[plane].length = plane_sizes[plane];
        vb->planes[plane].min_length = plane_sizes[plane];
    }
    call_void_bufop(q, init_buffer, vb);

    q->bufs[vb->index] = vb;
节选到登记槽位为止,循环的 MMAP 分支接在后面。
函数再次限制数量,是因为它也会服务于追加对象等其他路径;不能让“已有数量 + 本轮数量”越过表容量。本次 REQBUFS 已经清理旧池,索引通常从 0 开始,而完整表达式仍是 q->num_buffers + buffer。
6.2 kzalloc 分配了多大的对象
q->buf_struct_size 决定这次小对象的大小。VIMC 设置的是:
q->buf_struct_size = sizeof(struct vimc_capture_buffer);
其中内嵌了 vb2_v4l2_buffer,再向内包含通用的 vb2_buffer。一次分配即可容纳这几层管理信息以及驱动自己的链表成员,不需要再分别分配三份管理结构。
这次分配的大小随结构布局而定,不随 640 × 480 的像素数量增长。真正需要 921600 字节的像素存储,还没有在这里建立。
6.3 新对象为什么是 DEQUEUED
新建对象尚未通过 QBUF 提交,所以初始状态是 VB2_BUF_STATE_DEQUEUED。这里的名字描述当前归属状态,不要求它以前已经出队过一次。
length 记录这次建立的平面容量,min_length 保存最低容量要求,供后续外部存储等路径核验。它们此时来自同一个 plane_sizes[p],以后承担的检查职责可以不同。
6.4 init_buffer 和 buf_init 不是同一个回调
call_void_bufop(q, init_buffer, vb) 进入接口适配层。V4L2 的这项回调将扩展对象中的 request_fd 设为 -1,属于接口初值准备。
后面可能调用的 q->ops->buf_init 则属于驱动,用于在像素存储建立以后准备驱动附加状态。名称相似,但调用位置、回调表和资源前提都不同。
VIMC 的队列操作表没有设置 buf_init,所以本篇实例在那个位置不执行一个额外的 VIMC 初始化函数。通用代码保留这项可选能力,不代表每个驱动都会用到。
6.5 MMAP 分支才继续申请像素存储
循环的后半段如下。说明性注释已去掉:
if (memory == VB2_MEMORY_MMAP) {
        ret = __vb2_buf_mem_alloc(vb);
if (ret) {
            dprintk(q, 1, "failed allocating memory for buffer %d\n",
                    buffer);
            q->bufs[vb->index] = NULL;
            kfree(vb);
break;
        }
        __setup_offsets(vb);
        ret = call_vb_qop(vb, buf_init, vb);
if (ret) {
            dprintk(q, 1, "buffer %d %p initialization failed\n",
                    buffer, vb);
            __vb2_buf_mem_free(vb);
            q->bufs[vb->index] = NULL;
            kfree(vb);
break;
        }
    }
}
USERPTR 和 DMA-BUF 也需要管理对象,但其存储来自外部,不在这段 MMAP 分支中统一调用 alloc。本篇不把三种模式混作同一种像素分配。
MMAP 平面存储成功后,__setup_offsets() 安排后续查询与映射使用的偏移标识;这一步尚未建立应用映射。下一篇再分析偏移怎样被 QUERYBUF 返回、被 mmap 使用。
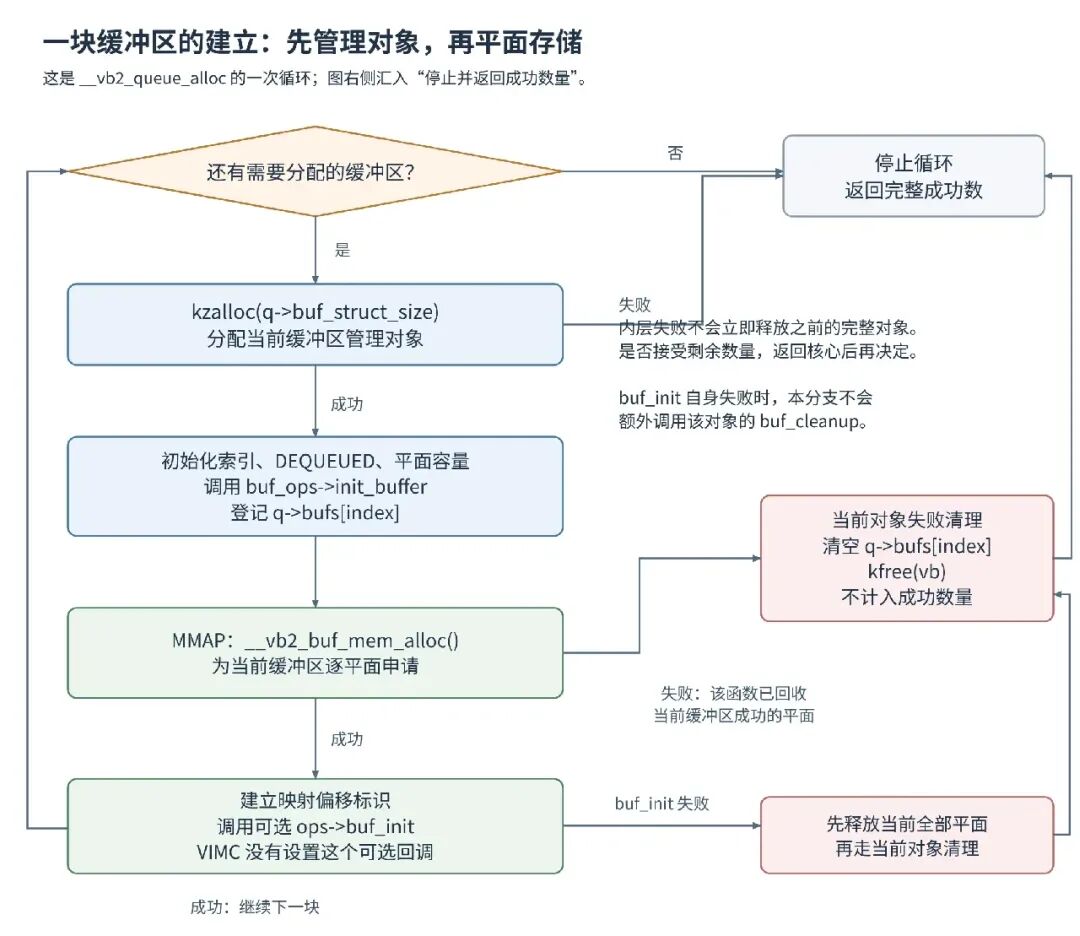
图 4:一个缓冲区只有全部平面成功、可选驱动初始化也成功,才会计入成功数量。发生失败后,外层循环停止,不跳过这个索引继续分配下一块。
实现对照:__vb2_queue_alloc()、__init_vb2_v4l2_buffer()、vimc_capture_qops。
7. __vb2_buf_mem_alloc:逐个平面申请,逐个平面回收
7.1 内层循环负责平面数量
一个缓冲区有几个平面,就在这里调用几次内存后端。完整可执行语句如下:
staticint __vb2_buf_mem_alloc(struct vb2_buffer *vb)
{
structvb2_queue *q = vb->vb2_queue;
void *mem_priv;
int plane;
int ret = -ENOMEM;

for (plane = 0; plane < vb->num_planes; ++plane) {

unsignedlong size = PAGE_ALIGN(vb->planes[plane].length);

if (size < vb->planes[plane].length)
gotofree;

        mem_priv = call_ptr_memop(alloc,
                      vb,
                      q->alloc_devs[plane] ? : q->dev,
                      size);
if (IS_ERR_OR_NULL(mem_priv)) {
if (mem_priv)
                ret = PTR_ERR(mem_priv);
gotofree;
        }

        vb->planes[plane].mem_priv = mem_priv;
    }

return0;
free:

for (; plane > 0; --plane) {
        call_void_memop(vb, put, vb->planes[plane - 1].mem_priv);
        vb->planes[plane - 1].mem_priv = NULL;
    }

return ret;
}
本篇 VIMC 只有一个平面,因此每个缓冲区进入后端一次。换成双平面驱动时,4 个缓冲区对应外层 4 次、内层每次 2 次;不是申请 8 个缓冲区。
7.2 为什么在这里做 PAGE_ALIGN
内存映射按页管理,所以传给 MMAP 后端的大小必须覆盖整页。PAGE_ALIGN(length) 将逻辑容量向上取整到页边界。
假定页大小为 4096 字节。一个用于说明对齐的 5000 字节平面,需要后端提供 8192 字节;平面描述的 length 仍然是 5000,不会因为后端收到 8192 就被这段代码改写。
本篇 RGB24 的 921600 字节恰好是 225 页,所以在 4096 字节页大小下,没有额外的页尾取整容量。四块像素区域合计对应 900 个基础页大小的容量;这不约束内存管理器内部采用哪种页分配组合。
逻辑容量、分配时的页对齐长度、管理结构大小,应分别记录。 映射篇还会在这个基础上解释 VMA 的范围。
7.3 页对齐也可能溢出
源码用 size < length 检查向上取整发生回绕的情况。如果一个错误尺寸接近类型上界,取整后反而得到很小的数,就不能继续按这个小尺寸分配。
这个检查只保护当前的页对齐运算。若驱动更早计算宽、高和字节数时已经溢出,最后得到一个看似正常的小 length,这里无法反推出原本应该多大。
7.4 怎样选择分配设备
表达式 q->alloc_devs[plane] ? : q->dev 使用 GNU C 的简写:当前平面有专用设备,就使用它;否则采用队列默认设备。
call_ptr_memop(alloc, vb, dev, size) 最终调用所选后端的 alloc(vb, dev, size)。不同后端可以根据设备的 DMA 限制工作;但本篇的 vmalloc 分配函数没有使用 dev 去建立设备 DMA 映射。不能把“传入了一个 device 指针”自动解释成“已经取得 DMA 地址”。
7.5 返回的是后端对象,不是像素地址
成功后,返回值保存到 vb->planes[plane].mem_priv。它是后端的私有管理对象。后续 put、mmap、vaddr 等操作再把同一个对象交回该后端解释。
错误可能表现为 NULL 或 ERR_PTR(-errno)。IS_ERR_OR_NULL() 同时识别这两种形式,PTR_ERR() 只在存在错误指针时提取错误码。不能只检查 mem_priv == NULL,否则可能把编码了错误值的指针当成有效对象。
7.6 当前平面失败,只先回收当前缓冲区
假设一个三平面缓冲区的 plane 0、plane 1 成功,plane 2 失败。free 分支先对已经成功的平面逆序调用 put,再清空 mem_priv,最后返回错误。
回到 __vb2_queue_alloc() 后,当前不完整的管理对象被释放,槽位清空,外层循环停止。更早完整建立的其他缓冲区暂时保留,交由最外层决定是否接受较少数量。
所以这是一种分层回滚:先撤销当前平面的半成品,再撤销当前缓冲区,最后才决定是否撤销整批。缺少一个平面的对象,绝不能计入“已经分配成功”。
实现对照:__vb2_buf_mem_alloc()、__vb2_buf_mem_free()、call_ptr_memop、call_void_memop。
8. vb2_vmalloc_alloc:像素存储终于在这一层建立
8.1 先看后端自己的管理对象
vmalloc 后端的对象定义如下:
structvb2_vmalloc_buf {
void *vaddr;
structframe_vector *vec;
enum dma_data_direction dma_dir;
unsignedlong size;
refcount_t refcount;
structvb2_vmarea_handlerhandler;
structdma_buf *dbuf;
};
这份结构也服务于该后端的其他内存路径,所以包含 vec、dbuf 等成员。本次 MMAP alloc 主要填写 vaddr、size、dma_dir、引用计数和 VMA 管理所需的 handler。
size 是前一层传来的页对齐容量,vaddr 是内核 CPU 访问这块存储的地址。结构自身只是记录这些信息的控制块,不是 921600 字节的像素区域。
8.2 完整分配过程
staticvoid *vb2_vmalloc_alloc(struct vb2_buffer *vb, struct device *dev,
unsignedlong size)
{
structvb2_vmalloc_buf *buf;

    buf = kzalloc(sizeof(*buf), GFP_KERNEL | vb->vb2_queue->gfp_flags);
if (!buf)
return ERR_PTR(-ENOMEM);

    buf->size = size;
    buf->vaddr = vmalloc_user(buf->size);
if (!buf->vaddr) {
        pr_debug("vmalloc of size %ld failed\n", buf->size);
        kfree(buf);
return ERR_PTR(-ENOMEM);
    }

    buf->dma_dir = vb->vb2_queue->dma_dir;
    buf->handler.refcount = &buf->refcount;
    buf->handler.put = vb2_vmalloc_put;
    buf->handler.arg = buf;

    refcount_set(&buf->refcount, 1);
return buf;
}
函数先分配 vb2_vmalloc_buf,再调用 vmalloc_user() 建立实际存储。第二次分配失败时,先释放刚才的控制块,再返回错误指针。
成功返回的仍是 buf,而不是 buf->vaddr。因此,前一层的 mem_priv 指向控制块;真正访问像素,需要通过后端的地址接口取得 vaddr。
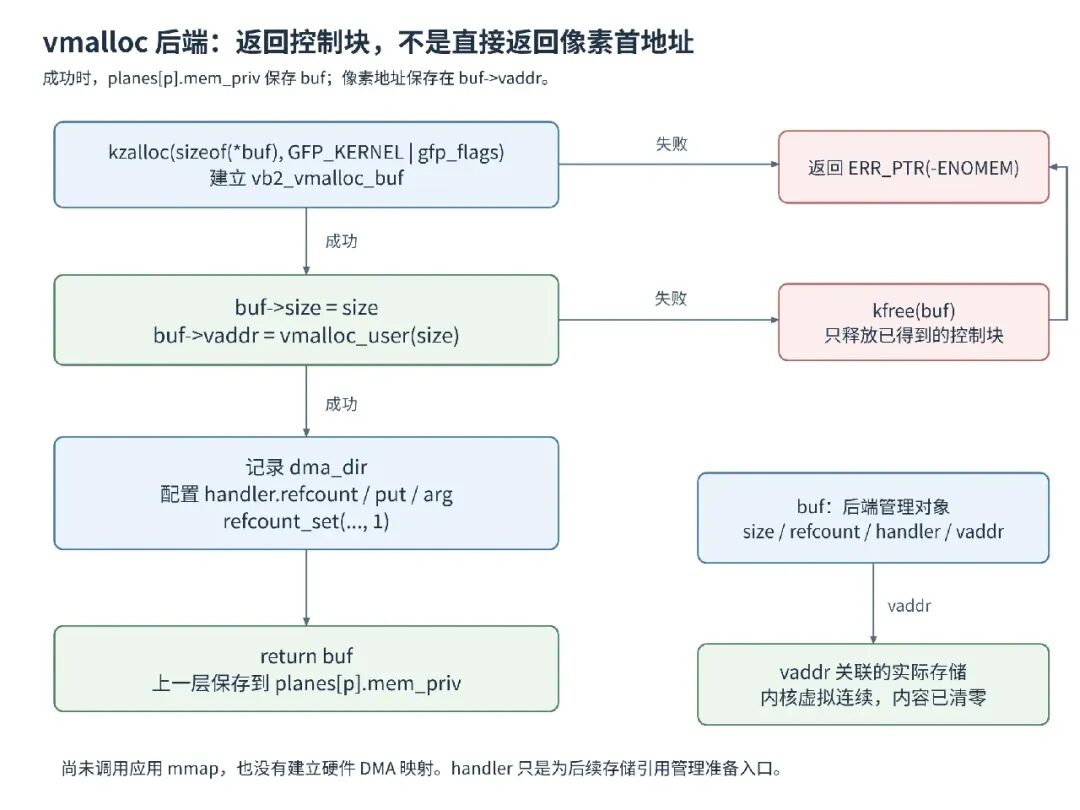
图 5:实线按执行顺序连接,右侧错误出口只回收已经得到的资源。handler 在申请时只是配置,尚未执行 VMA 的打开回调。
8.3 vmalloc_user 的三个特征
它为内核提供连续的虚拟地址区间,底层物理页不要求全部连续。CPU 通过这段虚拟地址按顺序读写,并不意味着设备可以直接使用同一个地址发起 DMA。
它还把申请到的存储清零,并标记为允许后续映射的区域,避免把未初始化的旧内容暴露出去。名称里带有 user,不表示它已经替当前应用调用 mmap;应用虚拟地址仍要通过后续映射获得。
最后,清零只是初始化存储。这个时刻并没有拍到一帧图像,bytesused 也没有因此变成一帧有效结果。真正填帧仍发生在启动之后的处理路径。
这些通用语义可对照 Linux v6.1 的 mm/vmalloc.c 中 vmalloc_user();本篇不继续深入通用页分配器。
8.4 gfp_flags 在哪里生效
后端私有对象使用 GFP_KERNEL | q->gfp_flags 分配。但实际图像存储调用的是 vmalloc_user(buf->size),这里没有把同一个 gfp_flags 作为参数继续传入。
因此,不应笼统写成“给队列设置一个 GFP 标志,后端所有分配都按它执行”。需要分别查看控制块、实际存储和所选内存后端。
8.5 refcount 初值 1 表示谁持有存储
后端设置引用计数为 1,表示本次 alloc 建立的一份存储持有关系。它不是文件描述符个数,也不是 v4l2_fh 引用计数。
handler.refcount、handler.put 和 handler.arg 为后续 VMA 引用管理准备好入口。将来映射等路径可以取得额外引用;申请阶段尚未发生这些动作。
配对的释放函数是:
staticvoidvb2_vmalloc_put(void *buf_priv)
{
structvb2_vmalloc_buf *buf = buf_priv;

if (refcount_dec_and_test(&buf->refcount)) {
        vfree(buf->vaddr);
        kfree(buf);
    }
}
最后一份引用归零时,才先 vfree() 像素存储,再 kfree() 后端对象。当前新建池还没有映射或导出者,失败回滚通常通过一次 put 就能结束本次平面存储;已有其他持有关系的情况,需要按引用生命周期处理。
实现对照:vb2_vmalloc_alloc()、vb2_vmalloc_put()、vb2_vmalloc_memops;通用语义对照 vmalloc_user()。
9. 分到三块、第四块失败,为什么仍可能返回成功
到这里,执行位置回到了 __vb2_queue_alloc()。循环变量 buffer 恰好记录前面完整成功的数量,函数最终把它返回给 vb2_core_reqbufs()。
9.1 外层首先检查最低可工作数量
假设目标数量为 4,队列最低要求为 2:
完整成功 0 块:返回内存不足。
完整成功 1 块:低于最低要求,回收这一块并失败。
完整成功 2 或 3 块:达到最低要求,继续询问驱动是否接受。
完整成功 4 块:满足本轮目标,不需要第二次数量复核。
这次接口不是“4 个独立的申请,任何一个失败就必须全部失败”。核心允许驱动在能够继续工作的前提下,接受较少的完整缓冲区。
9.2 第二次 queue_setup 不再发起分配
相关语句如下:
if (!ret && allocated_buffers < num_buffers) {
    num_buffers = allocated_buffers;
    num_planes = 0;

    ret = call_qop(q, queue_setup, q, &num_buffers,
                  &num_planes, plane_sizes, q->alloc_devs);

if (!ret && allocated_buffers < num_buffers)
        ret = -ENOMEM;
}
原函数在这些语句之间有说明性注释,此处去掉以集中观察控制流。
核心把实际成功数作为第二次的输入,询问驱动能否接受。驱动返回错误,或者仍要求比实际更多的数量,就不能保留这一批作为成功结果。
num_planes 再次置零,是为了继续表明 REQBUFS 场景。这个调用不会重新申请像素存储,也不会因为驱动重新写了 sizes[],就把已经分好的内存自动扩成新大小。两次调用之间,格式和布局要求必须保持一致。
还有一个细节:如果已经分到 3 块,第二次回调把数量降低成 2,核心这里不会再裁掉第三块;最终回传的仍是 allocated_buffers。这个检查关注“现有数量是否足够”,不是第二轮重新制定并执行一份分配计划。
9.3 VIMC 对数量的态度
VIMC 的 queue_setup() 不修改数量,也不会因数量是 2 或 3 而拒绝。因此,在当前最低数量为 2、其他条件正常的前提下,分到 2 或 3 块都能被接受。
-ENOMEM。 | ||
-ENOMEM。 |
表格是对控制流的推演,不是说实际运行必然在哪一块分配失败。内存分配结果与运行环境有关。
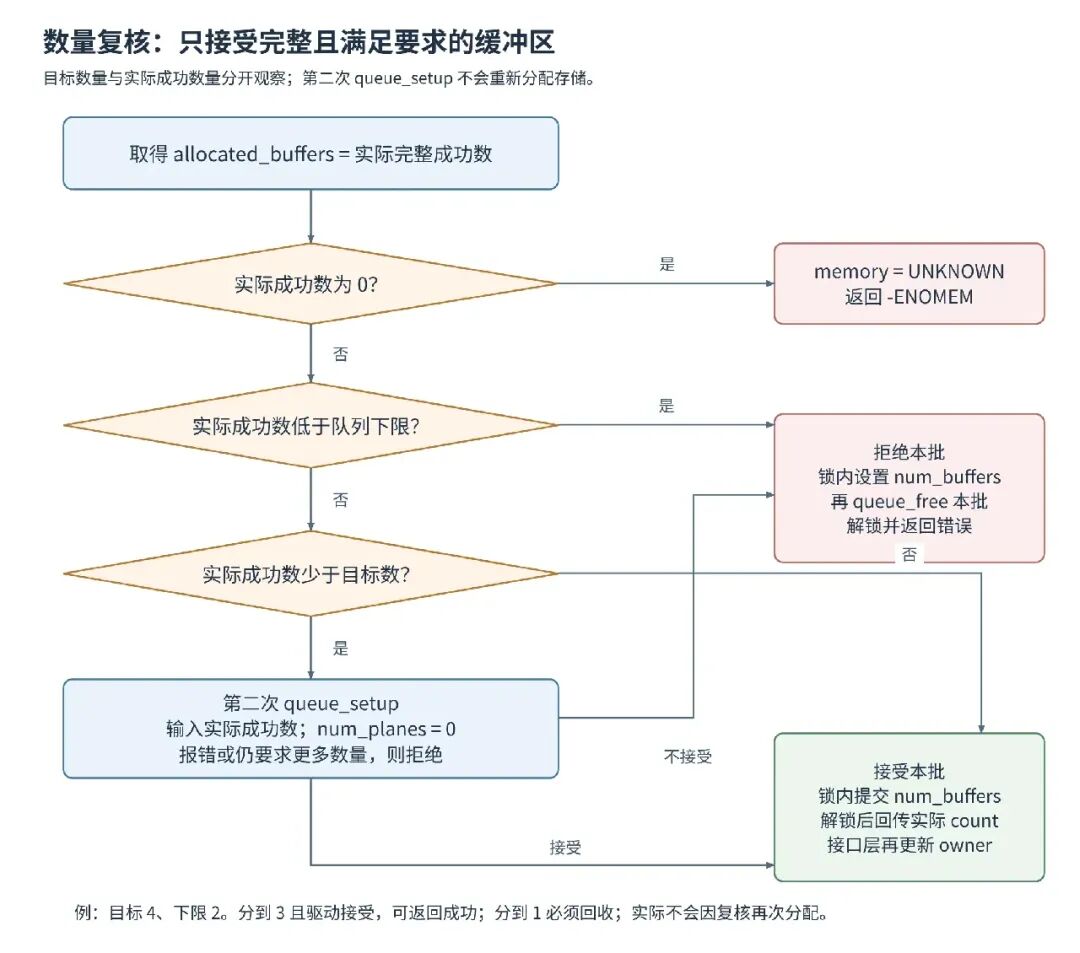
图 6:部分成功需要先满足队列下限,再通过驱动复核。失败清理前也要暂时设置 q->num_buffers,让释放路径知道本轮对象范围。
9.4 原始分配错误不一定原样传到应用
平面分配失败时,内层可以保存 PTR_ERR(mem_priv);驱动 buf_init 也可以返回其他错误。但 __vb2_queue_alloc() 交给最外层的是成功数量,不是那个原始错误码。
因此,同一个内层失败可能最终表现为“成功返回更少数量”,也可能因为达不到下限而变成 ENOMEM。调试时要同时看失败位置和最后成功数量,而不能只用最终 errno 反推唯一原因。
实现对照:__vb2_queue_alloc() 的返回值;vb2_core_reqbufs() 的最低数量检查及第二次 queue_setup()。
10. 最后一次提交:什么时候这批对象算真正建立成功
10.1 为什么失败清理前也要写 num_buffers
完成数量复核后,核心执行:
mutex_lock(&q->mmap_lock);
q->num_buffers = allocated_buffers;

if (ret < 0) {
    __vb2_queue_free(q, allocated_buffers);
    mutex_unlock(&q->mmap_lock);
return ret;
}
mutex_unlock(&q->mmap_lock);

*count = allocated_buffers;
q->waiting_for_buffers = !q->is_output;

return0;
赋值在成功与失败分支之前,这是释放函数的工作方式决定的。__vb2_queue_free() 根据队列总数确定需要清理的尾部范围;若本轮对象已经分配,却仍把数量留为 0,它就无法按正常范围回收它们。
这里的赋值不代表最终一定成功。数量不足并被拒绝时,核心会在锁内立即回收本轮对象,数量归零,并把内存模式恢复为 UNKNOWN。
10.2 数组槽位出现指针,比最终数量提交更早
分配循环中已经逐项写入 q->bufs[index]。但映射路径按 q->num_buffers 确定可遍历范围,并使用同一把 mmap_lock。
因此,分配中途的槽位指针与最终可用池不是同一状态。驱动扩展路径应遵守框架的锁和范围规则,不能绕过它们直接访问半初始化槽位。
10.3 两类互斥锁分别保护哪一段
在本篇 VIMC 的标准 ioctl 路径中,REQBUFS 是队列类命令,分发层会选择配置好的队列操作锁。VIMC 的队列锁与节点锁实际指向同一个 vcapture->lock。
核心内部另外有 mmap_lock,用于与映射、缓冲区释放等路径协调。它只覆盖若干关键片段,不包住全部 queue_setup() 和像素分配过程。
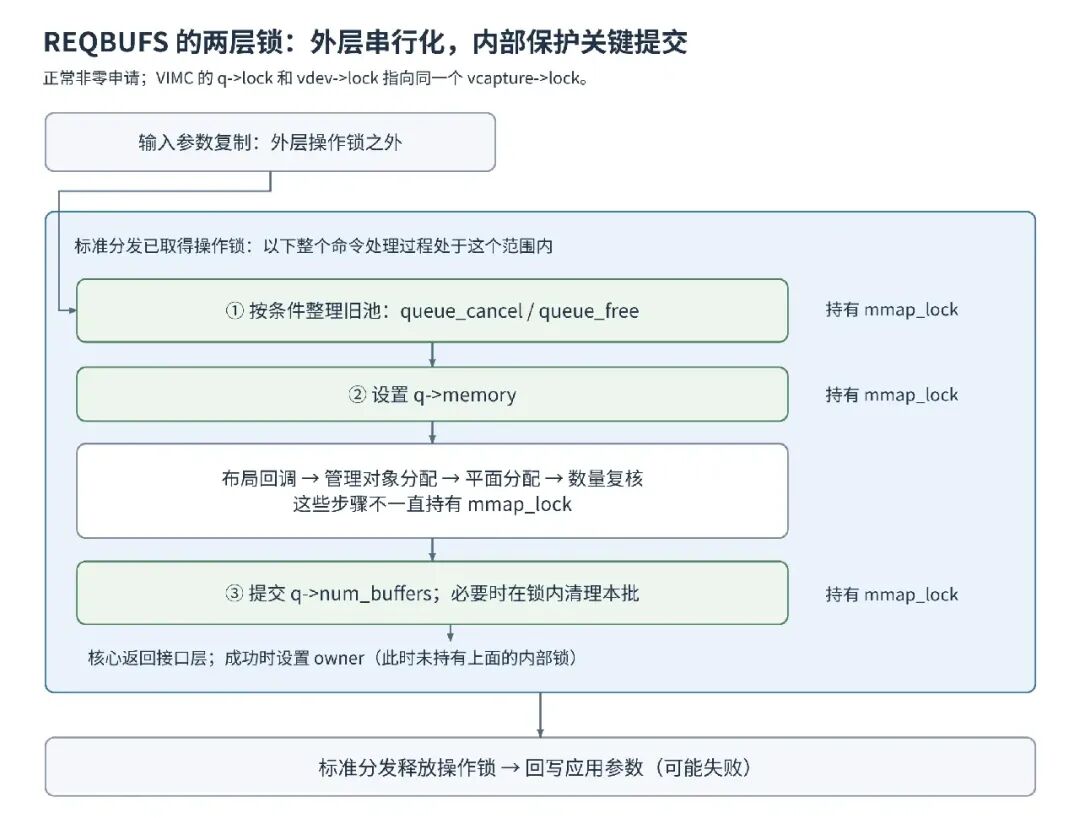
图 7:以 VIMC 正常的非零申请为例。三段内部锁区间彼此分开;owner 更新仍在外层命令处理内,参数回写则发生在标准分发解锁之后。
直接从驱动调用 VB2 核心接口时,需要自行满足相应串行化约定;不要因为图里存在外层锁,就以为核心函数在所有入口都会自动获取它。
10.4 成功返回以后,队列里有什么
假定本轮首次申请 4 个、全部成功,且没有额外并发操作:
q->num_buffers | |
q->memory | |
q->bufs[0..3] | |
num_planes | |
length / min_length | |
mem_priv | |
vaddr | |
DEQUEUED | |
waiting_for_buffers 对 CAPTURE 被设为真,表示后续仍在等待缓冲区提交;它不是“当前函数正在睡眠等一帧”的标志。
最后,外层 ioctl 还需把实际 count 等结果回写给应用。回写如果失败,应用可能得到 EFAULT,但已经成立的分配不会自动回滚。接口返回与设备状态更新仍要分开判断。
实现对照:vb2_core_reqbufs() 的数量提交;__vb2_queue_free();v4l2_ioctl_get_lock()、__video_do_ioctl()、video_usercopy()。
11. 失败处理要按资源层次看,不能只找一个 free
11.1 三层分配,三层回收
vmalloc 后端私有对象分配失败,直接返回错误指针;像素存储分配失败,后端先释放自己的私有对象。它不会替外层释放 vb2_buffer,因为那不是它创建的资源。
单个缓冲区中的某个平面失败,由 __vb2_buf_mem_alloc() 回收已经成功的平面。然后 __vb2_queue_alloc() 清空当前槽位并释放当前管理对象。
外层数量复核不接受剩余结果,才由 __vb2_queue_free() 回收已经完整成功的整批对象。这个顺序让每层只处理自己清楚的资源,再向上报告足够的信息。
11.2 可选 buf_init 自己失败时,要自己撤销半初始化资源
通用 MMAP 分配路径在平面建立以后调用驱动 buf_init。它若返回错误,核心释放当前平面与管理对象,**不会再针对这个失败对象调用一次驱动 buf_cleanup**。
因此,buf_init 内部先申请了附加资源、随后又失败时,必须自己回收这些半成品。已经完整初始化成功,后来因整批数量不足而被释放的对象,才走正常的 buf_cleanup 路径。
VIMC 本例没有设置这项回调,但分析通用核心时必须保留这个边界。否则照着文章新增驱动资源时,容易把失败回收寄托在一条不会执行的回调上。
11.3 重建失败,不会把旧池恢复回来
再次非零 REQBUFS 会先清理旧池。旧池已经解除,而新布局或分配随后失败,核心不会凭空恢复原来的缓冲区对象。
而且接口层只在核心成功时更新 owner,所以失败以后,也不能认为 owner、内存模式和数量全部被重置成“刚打开节点”的同一状态。应查看各字段的实际赋值位置。
这份实现支持把仍有映射或导出持有的存储与队列解除关联。旧存储可能继续存活,但它不再属于当前池,旧映射也不会自动变成新 buffer 0 的映射。完整映射生命周期在下一篇继续讨论。
11.4 REQBUFS 与 CREATE_BUFS 的边界
本篇的 REQBUFS 先处理旧池,再建立新池;CREATE_BUFS 可以请求增加缓冲区,并携带用于确定布局的格式信息。二者会复用某些内部函数,但不是同一个入口换了名字。
这也解释了 __vb2_queue_alloc() 为什么使用“现有数量 + 本轮索引”,以及为什么它再次检查剩余槽位容量。文章当前分析的是 REQBUFS 的这一次调用,不应把这里的“旧池已清理”前提套到所有调用者上。
实现对照:vb2_core_reqbufs()、vb2_core_create_bufs()、__vb2_queue_alloc()、__vb2_queue_free()、fill_buf_caps()。
12. 做一个只申请、不采集的观察实验
本篇的验证不需要提前实现 QBUF、STREAMON 或 mmap。使用已有格式,在空闲测试节点上请求数量,输出实际返回值,再释放缓冲区池,就能观察申请这一阶段。
配套 examples/reqbufs_probe.c 同时支持单平面和多平面采集类型,执行范围限定为 QUERYCAP → G_FMT → REQBUFS → REQBUFS(0) → close。它不设置新格式,不映射,不提交缓冲区,也不读取像素。
cc -std=c11 -Wall -Wextra -Werror -O2 \
   examples/reqbufs_probe.c -o reqbufs_probe

./reqbufs_probe /dev/video0 1
./reqbufs_probe /dev/video0 4
以上两次应分别在程序完成清理后运行。对应当前 VIMC 配置,请求 1 个而成功返回 2 个,是最低数量生效的表现,不是调用参数被错误修改。请求 4 个时,是否得到 4 个,仍以实际结果为准。
需要观察内部路径时,可以在测试内核中记录 queue_setup 的进入次数、输入数量、输出平面与大小、__vb2_queue_alloc() 的返回数,以及最终提交数量。分配减少的场景需要受控故障注入或模拟,不能通过随意耗尽系统内存来制造。
本程序会改变目标队列的缓冲区安排,不能在正在使用的采集链路上当作无副作用查询。没有实际设备测试时,编译成功只能证明程序通过编译,不能证明目标驱动运行正确。
三个问题检验是否读通
请求中没有宽高,921600 字节从哪里来? 来自驱动已经保存的当前格式,经 vimc_capture_queue_setup() 写入 sizes[0],再传给核心和内存后端。
为什么第四块失败,前三块不立即全部释放? 内层先回收第四块的半成品,把前三块作为完整成功数量交回外层;外层根据下限和驱动复核决定是否保留。
返回的 count 是 3,为什么不能继续按 4 次 QUERYBUF 循环? 因为池里实际只建立了三个可用索引,应用最初的期望不是成功数量。后面的查询和映射必须围绕返回结果组织。
13. 从请求到存储,把整件事连起来
现在回看这六个函数,就能看到一条有明确分工的过程。
vb2_ioctl_reqbufs() 处理请求是否合法、当前上下文是否可以申请,并在成功后记录 owner。vb2_core_reqbufs() 整理旧状态、确定候选数量,询问布局,组织分配和数量复核。vimc_capture_queue_setup() 从当前格式给出一个平面和所需容量。
接下来,__vb2_queue_alloc() 创建每个缓冲区的管理对象;__vb2_buf_mem_alloc() 逐平面计算页对齐容量并进入后端;vb2_vmalloc_alloc() 最终建立后端对象和真正的图像存储。结果逐层返回,核心只将满足要求的完整对象提交为新池。
vb2_ioctl_reqbufs() | ||
vb2_core_reqbufs() | count 回传数量。 | |
vimc_capture_queue_setup() | ||
__vb2_queue_alloc() | ||
__vb2_buf_mem_alloc() | ||
vb2_vmalloc_alloc() |
申请完成后,内核知道这些缓冲区在哪里、各有多大;应用目前只知道实际建立了几个。下一步需要通过 QUERYBUF 查询每个对象,再用 mmap 建立访问已有存储的映射。这是下一篇的起点。
实现与接口索引
本文直接展开 drivers/media/common/videobuf2/ 中的 videobuf2-v4l2.c、videobuf2-core.c、videobuf2-vmalloc.c,并结合 drivers/media/test-drivers/vimc/vimc-capture.c 中的布局与队列配置。命令入口和锁边界参照 v4l2-ioctl.c。