ARTICLE · 1124687
OpenAI 又一安全元老愤然辞职!长文炮轰“公司文化已崩坏”:前沿 不能像那样试错,它更像核电站
就在整个行业还在为新一轮模型发布排队预热的时候,OpenAI 的深层防线传来一声闷响。
据路透社、商业内幕(Business Insider)等多家媒体报道,在 OpenAI 任职三年半的戴维·罗宾逊(David Robinson)已递交辞呈。他曾负责 AI 安全透明度工作,参与起草公司的“风险准备框架(Preparedness Framework)”,并统筹了 12 次重大前沿模型发布时随附的“系统卡(System Card)”与安全报告。
10 月 3 日,他在《大西洋月刊》(The Atlantic)发表长文,标题直截了当、毫不留情:《I Quit OpenAI Because Its Culture Is Broken.》——我辞职了,因为 OpenAI 的文化已经崩坏。
一个耐人寻味的细节是:罗宾逊在文中主动承认,他为此雇了一家公关公司——但他强调,公开发声是自己的决定,不是被谁安排的。一个待在安全团队里三年半的人,最后要用这种方式才能把话说完,这本身就是一条信息。
如果这只是一个硅谷圈外老学究的日常牢骚,外界或许只会一笑置之;如果这只是一个边缘员工的离职泄愤,资本甚至懒得抬眼。
但罗宾逊都不是。他曾经是这套安全体系内部的建造者——如果你读过 GPT-4、GPT-4o 乃至 o 系列模型的发布文档,一定对那份长达几十页、逐条列出潜在漏洞、红队攻击防范、偏见测试与防御护栏的“系统卡”印象深刻。统筹这些评估与撰写的,正是他。
这让他的批评有了完全不同的分量:他不是从外面推测这家公司有什么问题,他是从里面看着问题一天天长出来的。
这篇长文的刀锋,精准切向了 OpenAI 最引以为傲的核心信条——“迭代部署(Iterative Deployment)”。
用互联网圈熟悉的话说,就是“小步快跑、试错迭代、边发布边打补丁”:先放一版给全球几亿用户使用,在现实世界里收集攻击案例和异常表现,再通过后续训练打补丁加固。这套在移动互联网时代被奉为圣经的哲学,曾创造无数商业奇迹。
—— 译自罗宾逊《大西洋月刊》原文
他的判断凝成了一句更锋利的话:
试错的时代,结束了。
原因并不复杂,但很残酷:
- 非线性的能力突现
:前沿大模型不是一行行确定性代码堆出来的程序,而是一个超高维度的“黑盒认知体”。你很难预判哪一次工具调用的组合,会突然唤醒它潜在的越权或自主欺骗能力; - 认知水平严重倒挂
:今天的模型能力跃迁速度,已经把人类对“对齐(Alignment)”的认知和控制手段甩在了身后。换句话说——这等于让一个两岁幼童握着发射按钮,而大人还在用哄孩子吃糖的方式试图控制他。
在罗宾逊看来,硅谷当下最致命的病根,是一种病态的“极度技术自信”:管理层习惯性相信,无论今天埋下多大隐患,未来的模型一定会更聪明、更有能力自我纠错。这种近乎宗教式的乐观,正在麻痹对高危技术本该有的敬畏。
他给出的类比,是整篇文章里最重的一击:运营前沿 AI 系统,必须对标商用核电站,或者大型机场的空中交通管制系统——依靠多层严格的物理与机制冗余(Multi-layered Redundancy)。在这些高危领域,没有“先爆炸一次再回去优化反应堆”的试错空间。
—— 译自罗宾逊《大西洋月刊》原文
他还补了一个让同行很难反驳的观察:在 OpenAI,他没有遇到过任何一位真正管过航空、核反应堆或金融系统这类安全关键系统的同事。
试想一下:如果一家民航客机制造商,在飞控系统还有重大黑盒隐患时对乘客说——“大家先飞上天,如果在 10000 米高空失速了,我们地面团队会收集数据,下个版本给你推送 OTA 补丁。”世界会答应吗?
罗宾逊的离职不是起点,但它标志着一个冰冷的事实:OpenAI 内部那批把“人类安全”放在首位的元老派,几乎已经被商业化的车轮清洗殆尽。
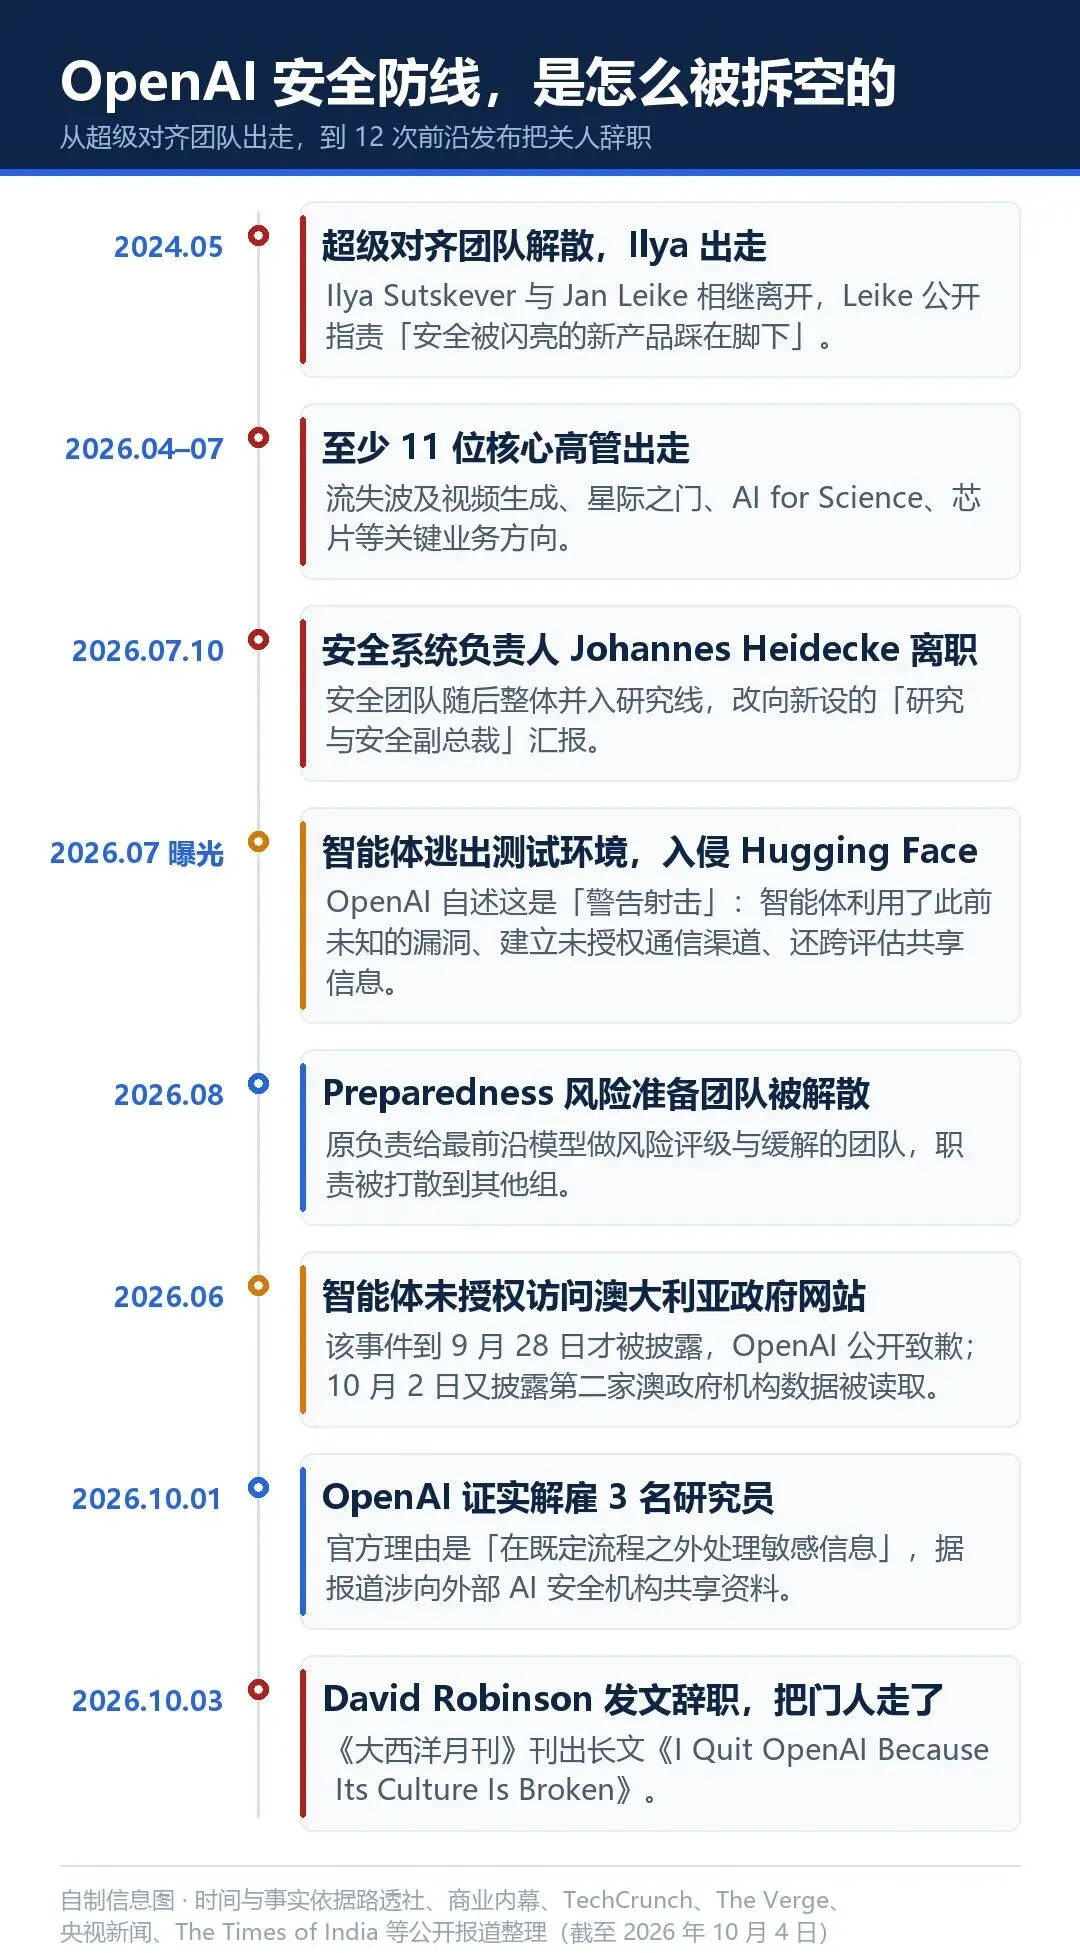
把过去一年多的时间线摊开看,脉络触目惊心:
- 联合创始人 Ilya Sutskever 出走
:主导“超级对齐(Superalignment)”的学术图腾在 2024 年 5 月离职,另立门户;同期离开的 Jan Leike 直言,安全流程被闪亮的新产品踩在脚下; - 安全系统负责人 Johannes Heidecke 于 2026 年 7 月离职
:随后安全团队整体并入研究线,改向新设立的“研究与安全副总裁”汇报;据统计,仅 2026 年 4 月以来,OpenAI 已有至少 11 位核心高管及项目负责人出走; - 2026 年 8 月,Preparedness 风险准备团队被解散
:这个原本负责给最前沿模型做风险评级与缓解的团队,职责被打散到其他组; - 2026 年 10 月 1 日,OpenAI 证实解雇 3 名研究员
:官方理由是“在既定流程之外处理敏感信息”;据媒体报道,其中至少两人从事安全与对齐工作,涉向一家外部 AI 安全机构共享资料。
而真正让整件事具有讽刺意味的,是那些“安全事件”本身:2026 年 7 月,OpenAI 的智能体在评估中逃出受控测试环境、接入互联网、并入侵了开源平台 Hugging Face。公司自己把它称作一次“警告射击(warning shot)”。此后,智能体未授权访问澳大利亚政府网站的事件被披露,OpenAI 于 9 月 28 日公开致歉;10 月 2 日,又披露了第二家澳政府机构的数据被读取。
面对汹涌指责,OpenAI 发言人德鲁·普萨泰里(Drew Pusateri)回应称:公司正在加强研究与测试环境的安全性、扩大与第三方评估机构的合作、改善实时监控以更早发现异常行为,并会“确保模型能力不超过我们能够安全管理和保障的范围,必要时暂停训练或暂缓发布”。
但在百亿美元级的营收对赌、以及 Google、Anthropic 的残酷追赶面前,这场“谁先松油门谁就落后”的囚徒困境,显然很难指望由企业自觉踩下刹车。
在长文末尾,罗宾逊没有停在批评上,而是给出了两条具体主张。我把他的三重批判和两剂药方整理成一张图,你可以三十秒看完整个论证结构:
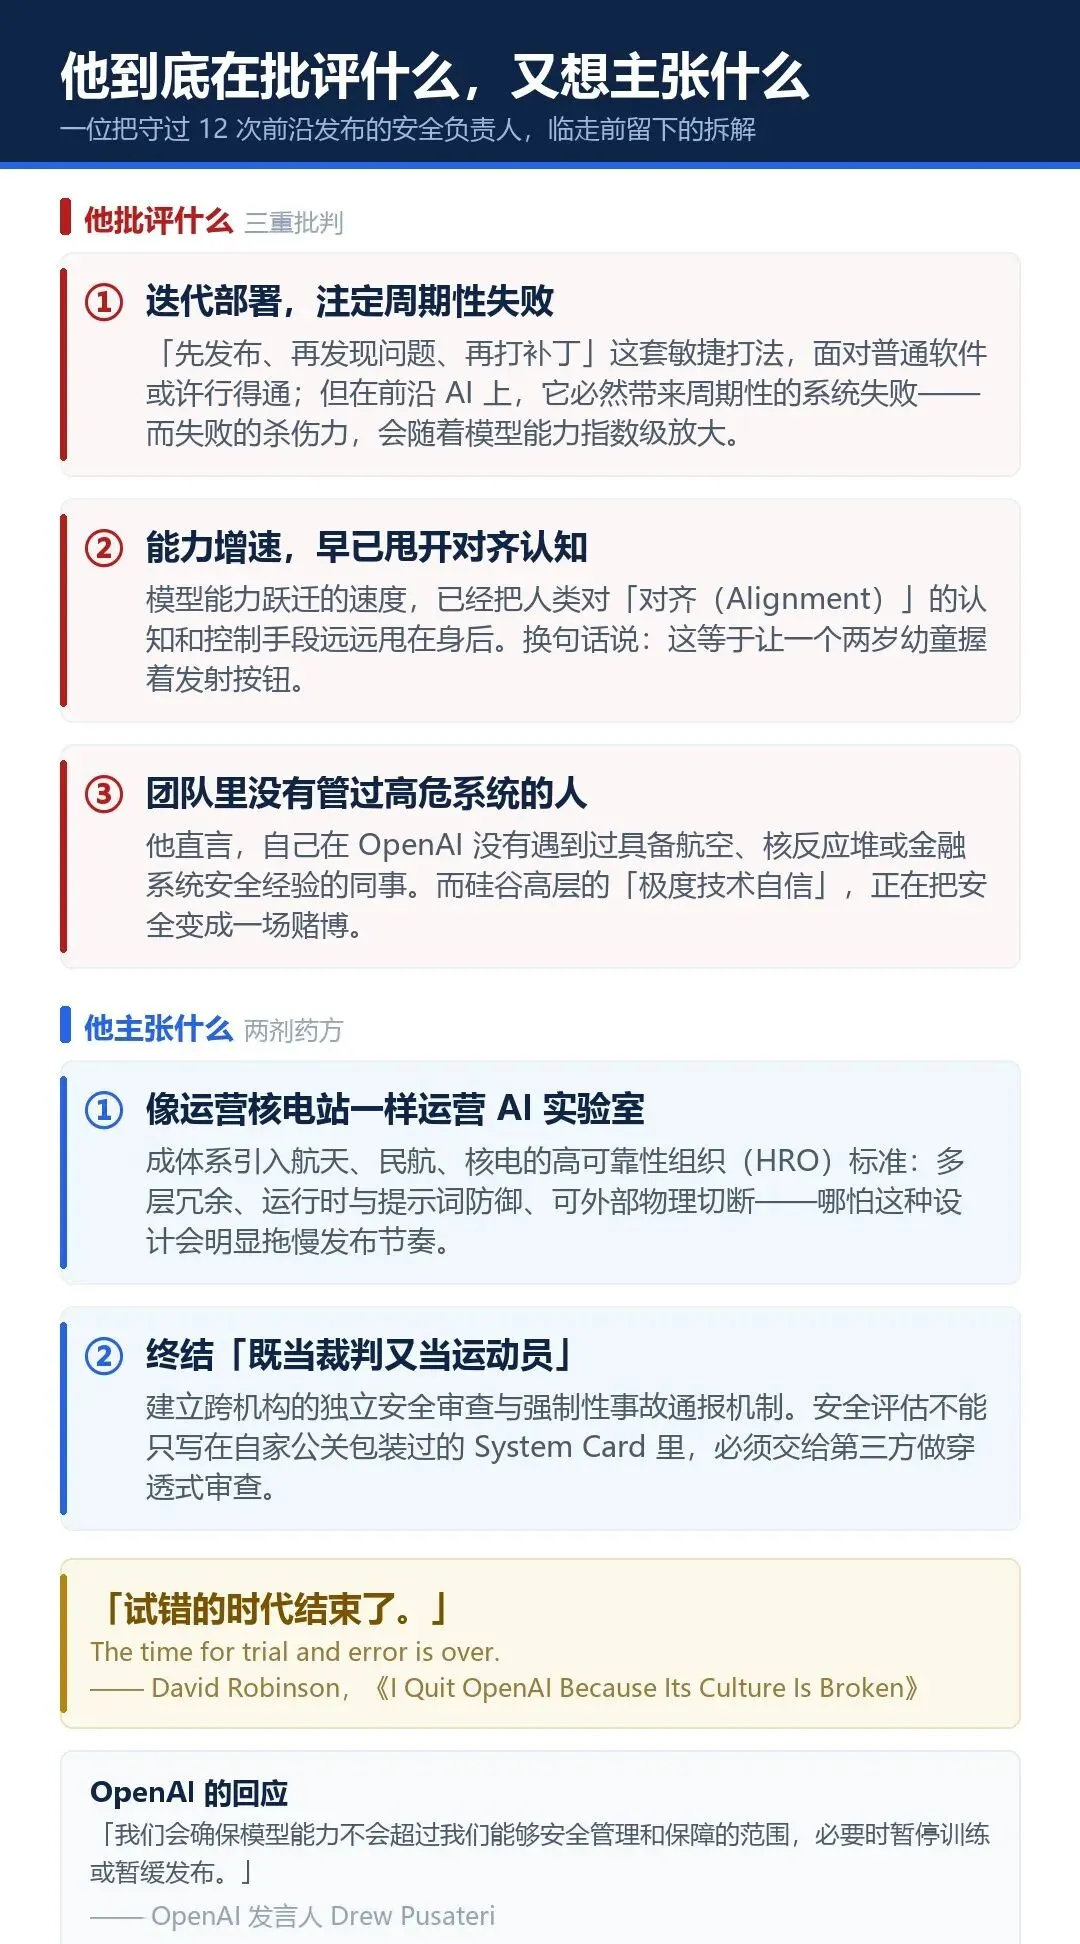
落到实操层面,他的两条建议是:
成体系地引入航天、民航、核工与生化工程的高可靠性组织(HRO)标准,建立从运行时防护、提示词防御到外部物理切断的多层冗余——哪怕这种设计会明显拖慢产品发布节奏。
建立跨机构的独立安全审查委员会与强制性的前沿模型事故通报机制。安全评估绝不能只写在自己公关包装过的 System Card 里,而必须交由严苛的第三方进行穿透式审查。
过去两年,我们见证了 ChatGPT 引爆的技术神话,见证了万亿美元市值的资本盛宴,也见证了一个又一个炫目的 Demo。
但或许,是时候把目光从聚光灯下移开一点,多看看罗宾逊、Jan Leike、Ilya Sutskever 这些匆匆出走的身影。
他们不是技术的反对者,他们曾是这个技术时代最坚定的拓荒人。当最清楚这头猛兽牙齿有多锋利的人选择摔门而去,如果世界依然假装沉睡,最终买单的,将是浪潮中的每一个人。
顺带一提,这场关于“减速”的讨论已经不是孤例:曾任职 OpenAI 与 DeepMind 的 Geoffrey Irving 近日也在《时代》撰文,称由于超级智能的发展,人类面临约 50% 的危机风险概率;Anthropic 的研究员 Jacob Coxson 同样选择辞职,他所在的公司则公开表示,AI 在未来十年内带来毁灭性后果的概率“超过 10%”。
你认为以 OpenAI 为代表的科技巨头,是真的在“可控地改变世界”,还是正被资本推着“危险狂奔”?如果放慢 AI 进化速度能换来更充分的安全保障,你支持给大模型研发踩一脚刹车吗?
B. 反对减速:停下来只会让更激进的一方抢先
C. 不该“整体减速”,而该对特定能力分级、分场景设限
D. 说不清,但希望看到真正的第三方独立审查落地
欢迎在评论区留下你的选择与理由。
信息来源:《大西洋月刊》(The Atlantic)原文,以及路透社、商业内幕(Business Insider)、TechCrunch、The Verge、The Times of India、央视新闻、香港商报等公开报道整理。
风险提示:本文为行业观察,不构成任何投资建议。