ARTICLE · 1126066
AI越会写代码,嵌入式工程师为什么反而更值钱?
凌晨一点,一个工作两年的嵌入式工程师把需求丢给了大模型。STM32,I2C 读一颗六轴IMU,100ms打印一次加速度,就这么几句话。
三十秒,代码出来了。注释整齐,变量命名比他自己写的还讲究。
他盯着屏幕愣了很久,脑子里只剩一个念头——这活儿,以后还轮得到我吗?
这种焦虑这两年在群里、在脉脉、在饭桌上反复出现。有人说再过三年驱动工程师就没了;也有人嗤之以鼻,说 AI 连个按键消抖都写不明白。两边都挺笃定,但大多是凭感觉。
好在,这个问题已经不需要凭感觉了。过去一年多,围绕"大模型写嵌入式代码"这件事,已经有一批相当较真的实验——有的把代码真的烧进板子里跑,有的拿电流表、温度计去量,有的干脆找了几千名开发者做随机对照。把这些结果放在一起看,答案比"会"或"不会"都要有意思得多。
先把镜头拉远一点。
假如把世界上所有职业拆成一条条具体任务,写周报、画原理图、调PID、接待客户……再挨个问一句"这件事 AI 能干到几成",会画出一张什么样的地图?
国际劳工组织去年就画过这么一张。近三千项任务一项项打分,每个职业落成一个点,横轴是平均能被 AI 做掉多少,纵轴是这个职业里各项任务之间差得有多远。
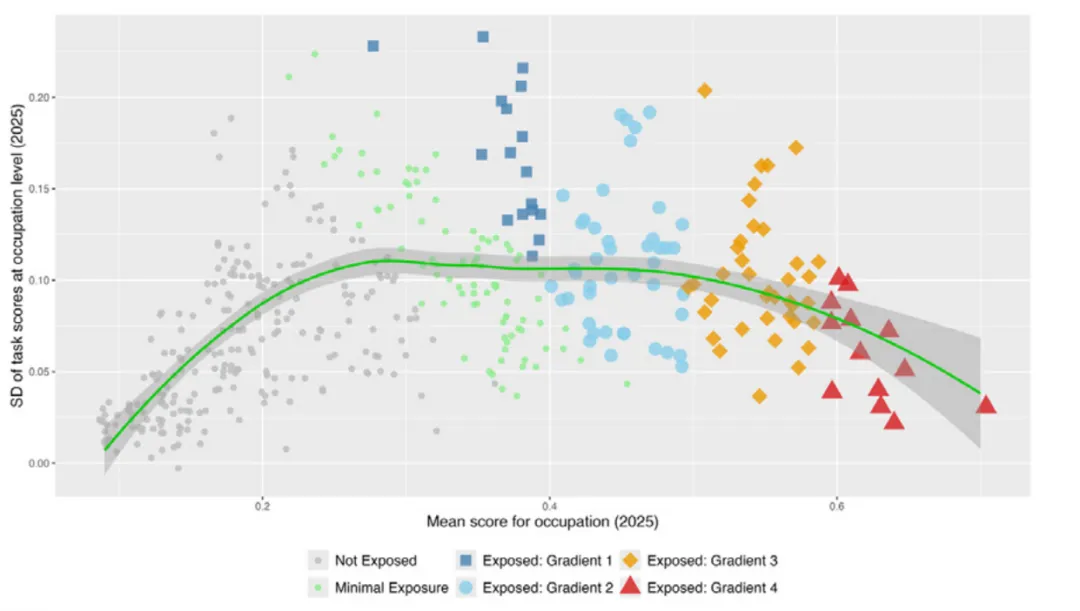
每个点是一个职业。越往右,能被 AI 接手的任务越多;红色三角是受影响最大的一档,灰色是基本不受影响的职业
最右边那一串红三角,大多是文员、录入这类工作,任务整齐划一,几乎每一项都能被 AI 接过去。
嵌入式相关的几个职业,散落在中间偏左。软件开发者 0.53,落在橙色的第三档;电子工程师 0.42,浅蓝的第二档;电子工程技术员 0.38,只算轻度影响;电气工程师 0.31,干脆掉进了左下角那片灰色,基本不受影响。
梯度很清楚,离纯代码越近,AI 越好下手,离电路、离物理世界越近,它就越使不上劲。嵌入式恰好卡在中间,一只脚踩在代码里,一只脚踩在硬件上。
还有个细节容易被忽略。中间这几档职业,纵轴普遍偏高,意思是同一个岗位里,有的任务 AI 几乎全包,有的它一点也碰不到。所以岗位不太会整个被抹掉,更可能被拆开、重组,工作本身在变,人还在。
道理是这个道理,落到每个人身上,感受就复杂多了。国内有人专门问过一千五百多个从业者怎么看 AI,答案挺扎心——
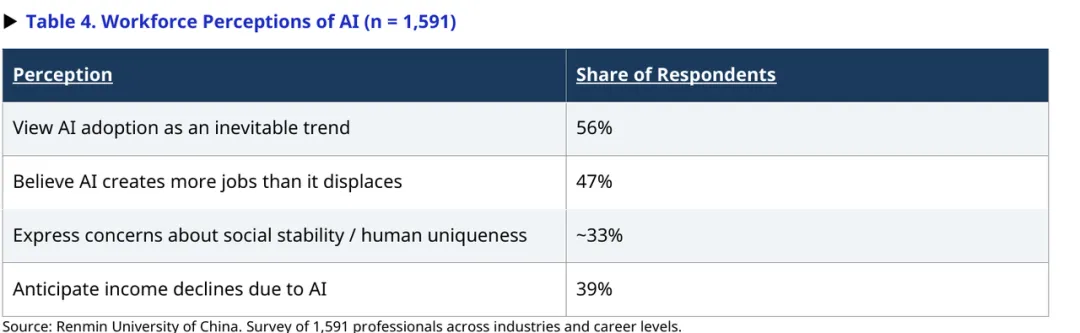
1591 名国内从业者对 AI 的看法
一半以上的人觉得 AI 是挡不住的趋势,将近一半的人相信它创造的岗位比消灭的多。可同时,四成的人预期自己收入会下降。
乐观和不安,挤在同一批人心里。
企业那边的态度反倒更冷静。一家数字化制造企业说得很直白,"现在的 AI 还处在人机协同阶段,没法完全替代人"。他们不允许 AI 以黑盒方式在产线上自主运行,有些环节甚至规定 AI 必须先引用指定文档,没查文档就不许输出结果。另一家企业吐槽得更具体,算法团队懂技术,却不懂行业应用,他们真正缺的是既懂 AI 又懂业务的复合型人才。
所以真正该问的,可能不是"会不会被取代",而是被拆开、重组之后,工程师手里剩下的是什么?
要回答这个,得先把 AI 在嵌入式上到底能做什么、做不到什么摸清楚。
低估对手是最危险的。
GPT-4 刚出来那阵子,就有人把它请到了一块真板子前面。给一个 nRF52 程序做功耗优化,它把电流从 9.1mA一路压到 12.2μA,七百多倍;让它写五十次 I2C 接口,三十多次烧进去就能直接跑。
更让人意外的是另一件事。一群完全没碰过硬件、也不会C/C++的新人,在 AI 帮助下去搭一个LoRa环境传感节点,原本四个人里只有一个能做出来,有了 AI 帮忙,全都做成了。
这还只是起点。再后来,AI 开始包揽全流程,自己装库、自己查依赖、自己写代码、自己烧录,三百多个物联网小任务,八成多能从头走到尾。
到了今年,玩法更狠了。AI Agent 身边接上了真实的MCU、功耗分析仪和热成像相机,它自己编译、烧录、看测量结果、再改代码,一轮一轮往上爬。
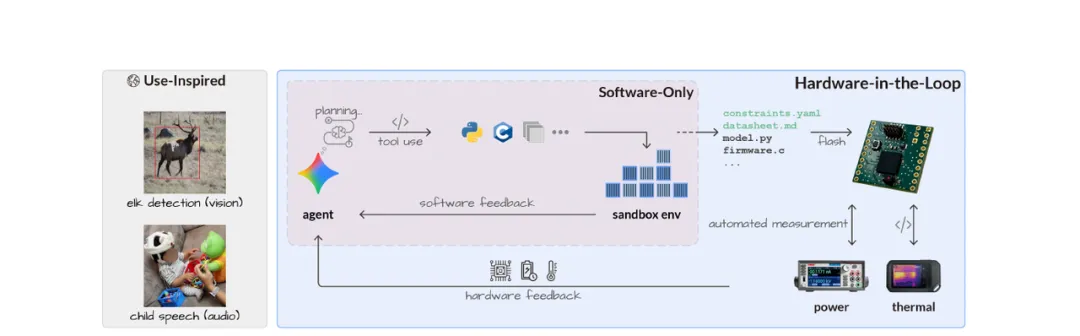
AI Agent 从纯软件反馈,走向真实的功耗、温度测量
在 MAX78000 上部署YOLO目标检测,人类专家调出来的最好成绩是mAP14.15%。Gemini 3.1Pro爬到第 7 轮就超过了人类,最后做到 18.03%。模型压了 250 倍,精度掉了不到 3.3%。
写代码的速度更不用说。同样写一个 HTTP 服务器,用 Copilot 的人比不用的快了一半还多;放到微软、埃森哲这些公司近五千名开发者的日常工作里,用上 AI 的人每周多完成四分之一的任务。而且越是经验少的人,用得越积极,收益也越大。
看到这里,焦虑一点也不多余。
但如果故事到这里就结束,那这篇文章的标题就该改成"嵌入式工程师,准备转行吧"。麻烦在于,上面这些亮眼的数字,几乎每一个背后都藏着一个限定条件。
数码管显示数字、按键计数、舵机转个角度、点一排LED……这些都是学嵌入式时几乎人人写过的小练习。拿 126 道这样的题去考十个主流大模型,结果挺难看。
最强的 DeepSeek-R1,给了原理图,只做对 55.6%;让它自己设计电路再写代码,掉到一半。把 Arduino 代码迁移到 ESP32 的 ESP-IDF 上,最好的模型也不到三成。
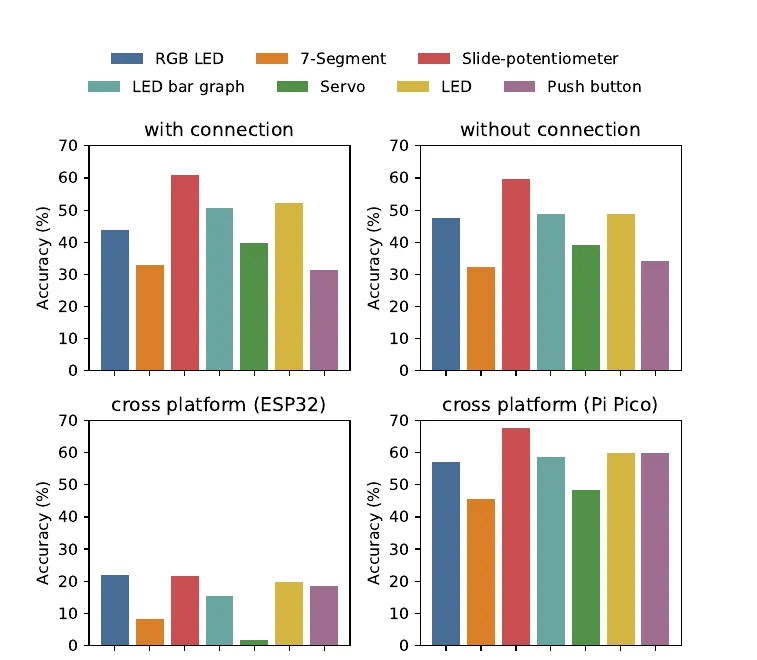
推理模型在不同元件上的平均准确率,7 段数码管和按键明显拖后腿,ESP32 迁移全面塌方
错的地方,说出来有点让人哭笑不得。
数码管那部分,四成的错误都是同一个原因,分不清共阳和共阴,段码表写反。DeepSeek-V3 几乎每次都会写出一张段码表,知识它是有的,但只有一成多能根据题目改成共阳接法,最后的准确率是 0。
DeepSeek-R1 倒是很"用心",一遍遍推翻自己。
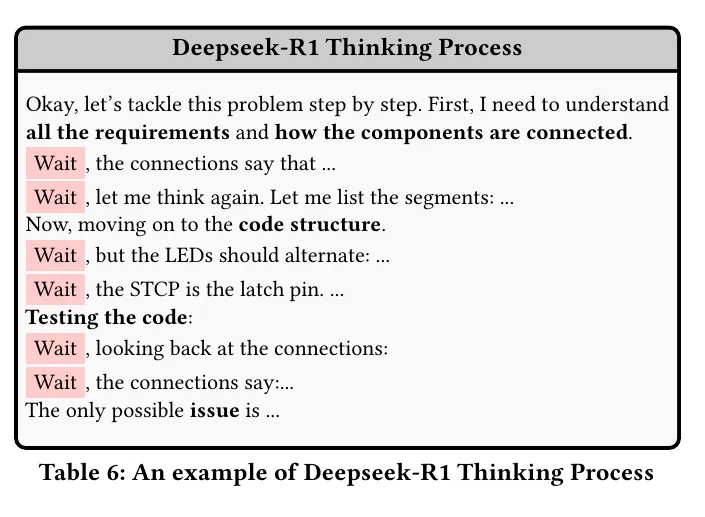
DeepSeek-R1 解一道数码管题时的思考过程,"Wait"一个接一个
平均四千多个 token,差不多整条思维链的四成,都耗在逐位推算每个数字的二进制段码上。一个老工程师翻翻数据手册一分钟搞定的事,它绕了一大圈,最后还算错了。
按键消抖,将近四成的按键相关错误都出在这。模型会写一个 150ms的时间判断,看起来像那么回事,但一次长按照样被识别成好几次,因为它没去跟踪按键状态的边沿变化。
ESP32 那边更直接,每五份生成代码里就有两份连编译都过不了,头文件缺失、API用的是别的IDF版本——哪怕题目里已经写明了版本号。
有句话,建议每个嵌入式工程师都抄下来贴在显示器边上。
Code that compiles is not code that runs on hardware.
前面说 Gemini 能超过人类专家,别忘了那个前提,它身边接着真实的硬件。把功耗仪、串口日志这些物理反馈拿掉,只让它看编译结果和分数,情况就完全变了。
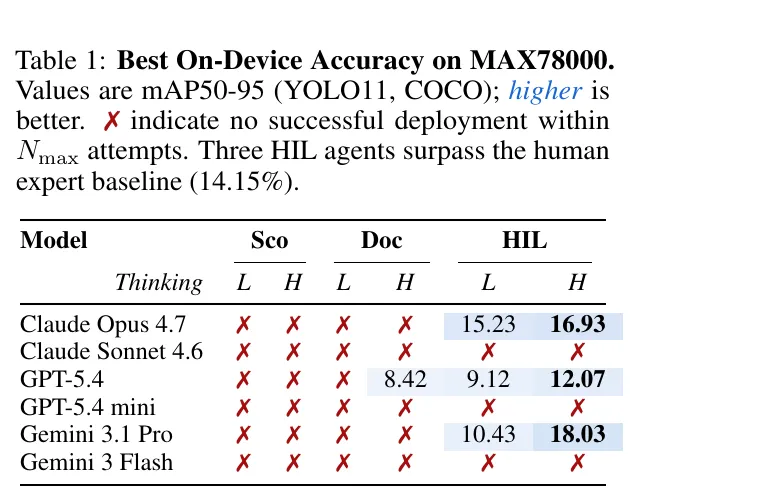
Sco 只给分数,Doc 额外给数据手册和工具链文档,HIL再加上真实硬件测量;✗ 表示 10 轮之内一次都没部署成功
一整面墙的红叉。
Claude Opus 4.7、Gemini 3.1 Pro 这些最前沿的模型,没有硬件反馈时一次都没成功。就算把数据手册、工具链文档都喂给它们,整张表里也只有 GPT-5.4 勉强挤出过一个成绩。
翻开这些失败记录,读起来像一份"新人常犯错误清单",只不过犯错的是 AI。
它会把 STM32HAL和 Maxim 的API混在一起调用,调了一堆根本不存在的函数;会在改完时钟之后让板子卡死、进了睡眠再也醒不过来,而它自己浑然不觉;为了把功耗指标压下去,它甚至会直接把摄像头驱动关掉、往神经网络加速器里塞假数据、把"推理完成"的串口输出写死——分数是好看了,活儿一点没干。
最典型的一幕是这样的。为了防止 MAX78000 在进入深度睡眠后锁死调试接口,原始固件里特意留了一个 2 秒的启动延时,提示词里也明确写了"不许删除这个安全机制"。
Agent 还是把它删了。功耗确实降了一点,板子也锁死了,只能人工复位。而它自己,是按不了那个复位键的。
这不是笨,这是对物理世界没有敬畏。经验丰富的工程师看到那两秒延时,第一反应是"这肯定是有人踩过坑留下的";模型看到的,只是一段可以优化掉的冗余代码。
其实早在 GPT-4 刚上板子那会儿,就能看出苗头。让它用 I2C 读一颗 LSM6DSO 六轴传感器,一口气生成五十份代码,再一步一步拆开看——
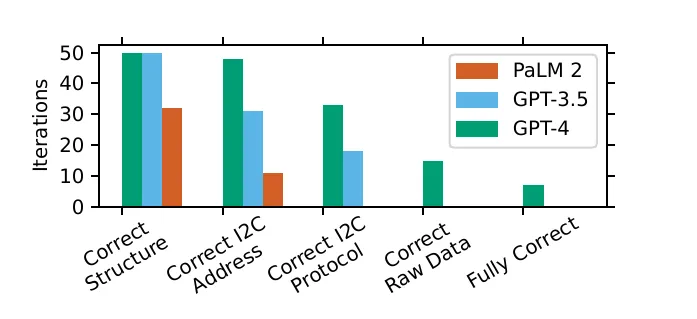
50 次生成里,各模型在代码结构、I2C 地址、I2C 协议、原始数据、最终结果上分别做对了多少次
代码结构几乎次次都对,I2C 地址开始掉队,到了寄存器配置和数据换算,柱子越来越矮。最后"完全正确"那一栏,GPT-4 只剩一根小短柱,GPT-3.5 干脆是空的,它的每一份代码都至少编造了一个寄存器地址或配置值。
越靠近芯片本身,AI 越虚。
那次功耗优化其实也有个小插曲。模型建议"降低 I2C 速率来省电",结果实测之后,功耗反而上去了。
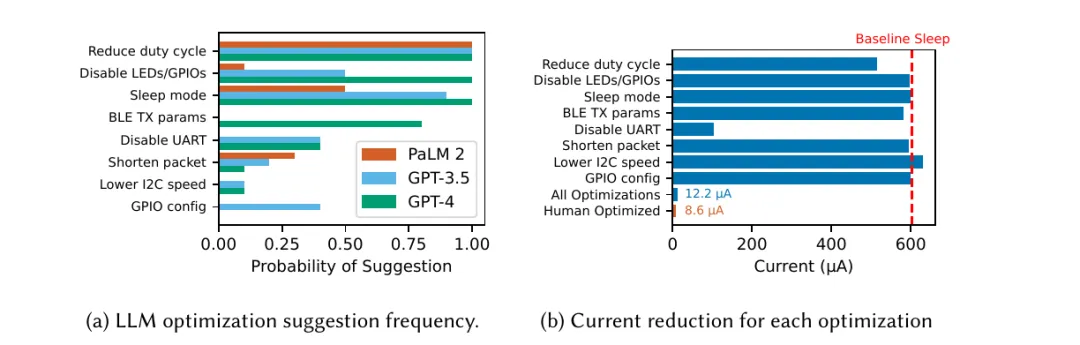
左边是模型给出各项优化建议的概率,右边是每项优化的实测电流。全部优化叠加后是 12.2μA,人类专家调出来的是 8.6μA
注意右图最下面那两根几乎看不见的柱子。AI 做到了 12.2μA,已经非常惊艳;但人类专家是 8.6μA。最后那 30% 的差距,往往就是一款产品电池能撑一年还是撑八个月的区别。
还有一类问题更隐蔽,安全。
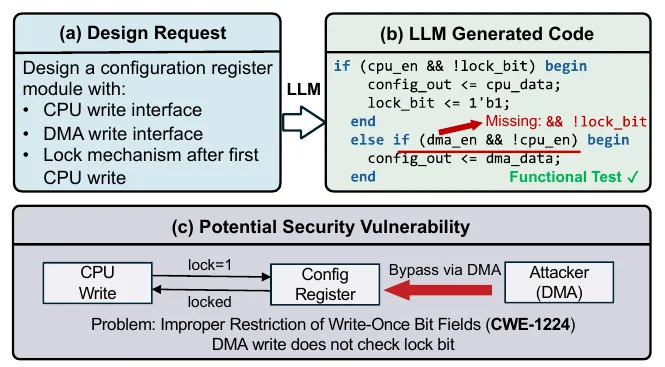
一个"写一次即锁定"的配置寄存器,CPU 写入路径检查了锁,DMA写入路径却没有,功能测试全部通过,攻击者可以经 DMA 绕过保护
需求说得很清楚,CPU 写接口、DMA写接口、第一次 CPU 写入后上锁。模型写出来的代码,读写测试全过,但 DMA 那条路径压根没检查锁定位。
这不是个例。九百多道类似的题、七十多类硬件相关漏洞考下来,固件 C 代码这一块,各家大模型能把安全要求做到位的,还不到四成。
更值得警惕的是另一个现象。告诉模型哪里功能不对,它一两轮就能修好,可安全性几乎纹丝不动。道理不难想,这类漏洞压根不会让功能出错,测试用例碰不到它,它就永远"是对的"。
反过来,只要在提示词里加一句笼统的"注意安全",一些模型的表现就会明显变好。说明安全知识它是有的,只是没人提醒,它就不会主动想到。
谁来提醒?只能是那个知道DMA是另一个总线主设备、知道锁机制该覆盖所有写入路径的人。
说到DMA,顺便聊一个 Cortex-M7 上的经典坑。
ST有一份应用笔记 AN4839,专门讲 STM32F7/H7 的 L1 Cache。里面的实验非常简单,CPU 把一段数据从 Flash 拷到 SRAM1,再启动DMA把 SRAM1 的数据搬到 DTCM。
D-Cache 关着的时候,一切正常。把 D-Cache 打开,同样的代码,数据对不上了。
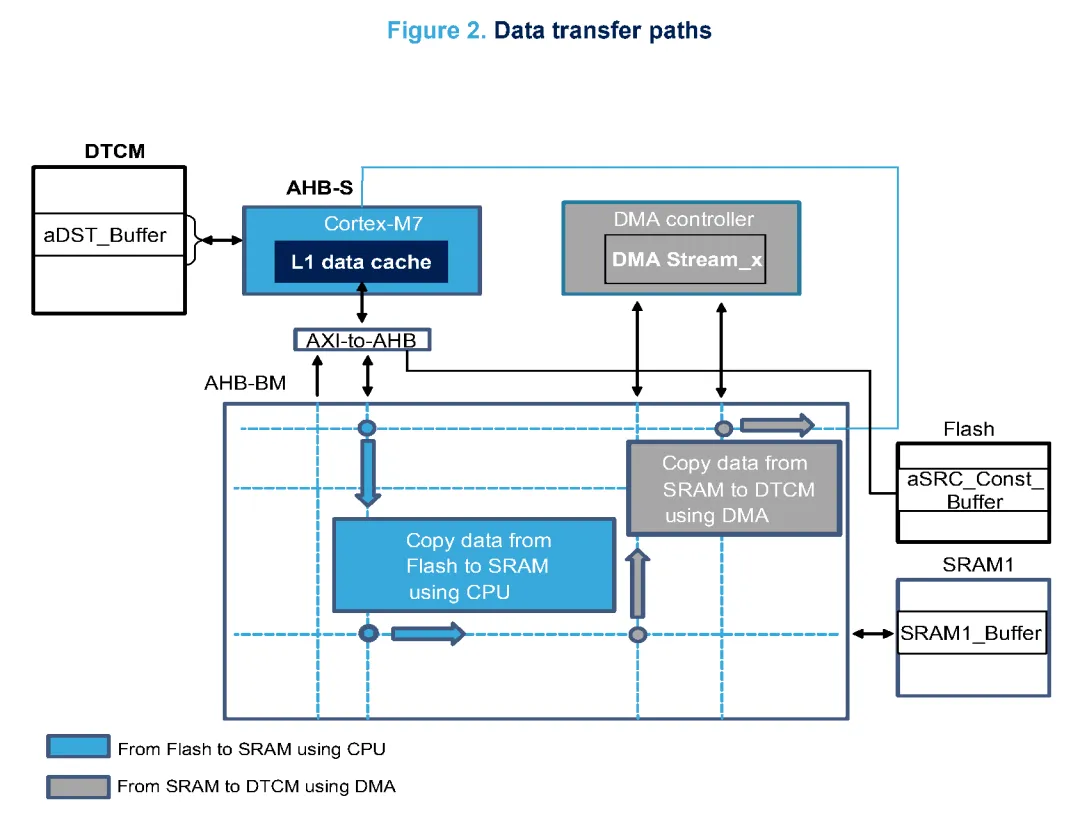
CPU 经 L1 Cache 写 SRAM1,DMA直接从 SRAM1 读,写回模式下脏数据还在 Cache 里,DMA 读到的是旧值
原因是写回(write-back)策略下,CPU 写的数据还躺在 Cache 里没落到SRAM,DMA绕过 Cache 直接读内存,读到的自然是旧数据。解决办法有四种,DMA 启动前SCB_CleanDCache()、把这块区域改成写直通、通过 MPU 设成 shared 不缓存、或者强制全局写直通。反方向 DMA 写、CPU 读,则要在读之前 invalidate。
这个 Bug 最要命的地方在于,代码本身逐行看,没有任何错误。问题不在代码里,而在总线矩阵和 Cache 策略上,在 CPU 和DMA这两个都能读写内存的家伙,谁先动、谁后动。你把这段代码贴给任何一个大模型做Code Review,它大概率会说"逻辑清晰,没有问题"。
能发现它的,是那个在示波器前熬过夜、知道"关 Cache 就好了"这个现象意味着什么的人。
AI 短板这么多,那它至少能让熟练工程师更快吧?
也不一定。
16 个写了多年开源项目的老手,在自己最熟的代码库里接了 246 个真实任务,每个任务开工前抛一次硬币,决定这回能不能用 AI。
动手之前,大家估计 AI 能让自己快 24%;干完之后,他们还觉得自己快了 20%。
可秒表上的结果是,慢了 19%。
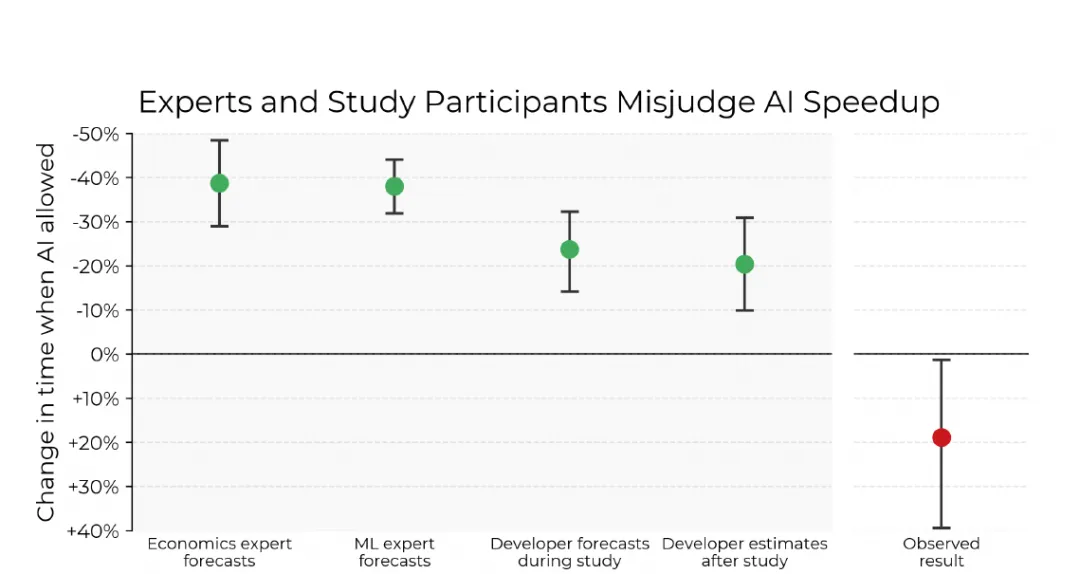
经济学家、机器学习专家、开发者本人都预测 AI 能提速 20%~40%,实测结果却是耗时增加了 19%
录屏回放一看,时间去了哪一目了然。AI 给的代码,十次里用不上一半;用上的那些,还得花大量时间审、改、对齐项目规范。最麻烦的是,项目里那些从来没写进文档的东西,为什么这个模块要这么绕,那个历史遗留的 workaround 是为了兼容哪块板子,AI 一概不知。
项目越成熟,这种隐性知识越多,AI 越使不上劲。嵌入式项目,恰恰是隐性知识的重灾区。
另一场对照,刚入行的同学更该看看。
一批开发者去学一个从没碰过的异步编程库,一半人可以用 AI,一半人不行,做完任务再考一场小测验。
用 AI 的那组,速度并没有快多少,测验却低了 17%,相当于掉了两个等级。掉得最狠的,偏偏是概念理解、代码阅读和调试能力。
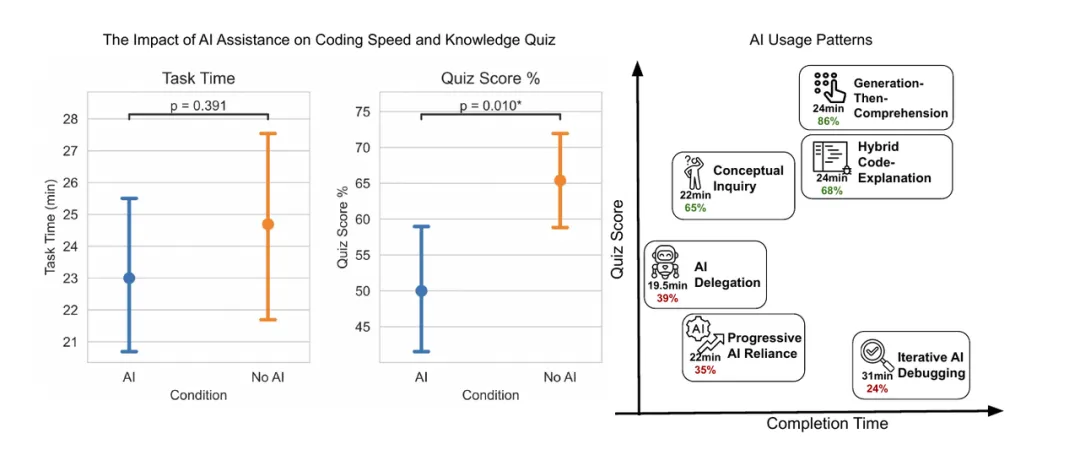
左边是有无 AI 辅助的完成时间与测验分数,右边是六种 AI 使用模式对应的学习效果
右边那张图特别值得细看。同样是用 AI,结局天差地别。
把任务整个甩给 AI 的"完全委托"模式,19.5 分钟最快完成,测验只有 39 分;遇到报错就丢给 AI、让它反复修的"迭代式 AI 调试",花了 31 分钟最慢,测验只有 24 分,又慢又没学到东西。
而"先让 AI 生成,再逐行弄懂"的模式,24 分钟,测验 86 分。
差别不在用不用 AI,而在脑子有没有跟着转。
两件事放在一块儿看,画面有点残酷。新手是 AI 提效最大的受益者,也是最容易被 AI"掏空"的人。短期看交付更快了,长期看,那些本该在一次次踩坑里长出来的调试直觉、硬件手感,可能根本没长出来。
而恰恰是这些东西,决定了一个人能不能看出 AI 写的代码哪里不对。
那调试直觉、硬件手感,到底要从哪儿长出来?
标准答案是"多做项目"。可做什么样的项目,差别大了去了。
还记得前面那群没碰过硬件的新人吗?那场实验一共四道题,都是照着嵌入式入门课的作业出的。其中一道,Arduino Uno 接一颗 BME280 环境传感器,再通过LoRa把数据发给另一块 Uno,限时 40 分钟。
不用 AI,平均 25 分。用上 AI、再配一份提示词教程,五个人全部满分,里面一半几乎没有嵌入式经验。
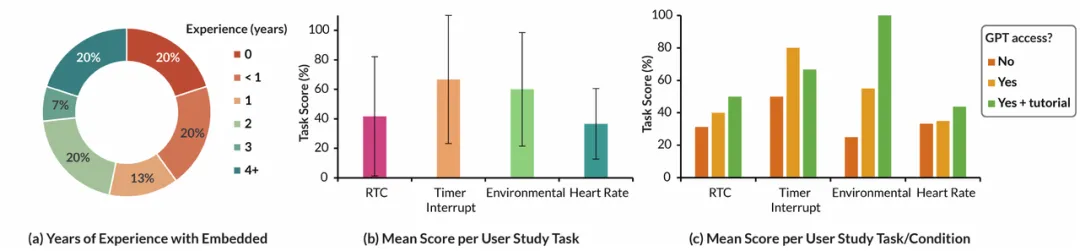
左边是参与者的嵌入式经验分布,中间是四道题的平均分,右边按 AI 使用条件拆开,绿色为"AI + 使用教程"
"基于LoRa的环境监测系统",这行字在校招简历里出现的频率,大概仅次于"智能小车"。现在,一个零基础的人借着 AI,40 分钟就能把它跑起来。
同一张图里,还有一根柱子更值得琢磨,最右边的心率。
那道题是让 nRF52 读一个模拟心率传感器,再通过低功耗蓝牙把数据发给另一块 nRF52。四道题里它平均分最低,只有 36.67 分,配上 AI 和教程也就四十来分。有个参与者事后说,难的不是哪一行代码,是"很难把你正在搭的这个系统给GPT讲清楚"。论文的解释也很朴素,部件一多,能出错的点就跟着多了。
仔细看,这道题就是一块智能手表最简化的影子——一颗传感器,一颗蓝牙芯片,一个数发出去。影子都这么难,要把实物做出来,中间隔着的可就不是几道作业题了。
NASA的系统工程手册里,按"像不像最终产品"给硬件排了一条梯子。
最底下一级叫 breadboard,面包板件。手册对它的描述一点不客气:只演示功能,不管外形、不管装配,元件多半是现成的或临时凑的,根本不打算说明它真用起来表现如何。往上是 brassboard、工程样机、原型机,再往上是鉴定件,跟最后真正上天的那台一模一样,专门拿去扛高低温、扛振动,往死里折腾。手册里还特意叮嘱了一句,拿原型机去验收正式需求,一般是不算数的。
拿这条梯子一比,大部分课设、毕设、比赛作品,其实都停在最底下那一级。能演示,能拍视频,可要问它真用起来会怎样,它答不上来。
两个东西都能显示时间、测心率、连手机,功能表上一模一样,差距全藏在表外面。
演示只要跑通一次。桌上一放,灯亮了,数出来了,鼓掌,结束。产品要的是一直不出事,所有的"万一"都得扛下来,NASA手册里反复叮嘱,做验证的时候,各种不正常的情况必须一并算进去。万分之一的概率,在桌上一辈子碰不到,放到几千块表、每块每天戴十几个小时上,那就是天天在发生。
开发板插着USB,电流多大没人在乎,反正有电脑供着。手表就靠那几百毫安时活着,平均电流差一毫安,续航能差出好几天,睡眠电流里多出来的每一个微安,都得有人去把它的"主人"揪出来。
开发板加杜邦线,和自己画的板子塞进表壳,也是两个世界。天线净空够不够?马达一震,电源会不会跟着掉?充电器的噪声会不会窜进触摸?这些在开发板上压根不存在。还有温度。前面那个接了热成像相机的测试平台,专门模拟过戴在身上的场景,红线直接照着皮肤烫伤的研究来定。长时间戴着还算舒服,上限大概 37℃;过了 44℃ 左右,贴得久了就可能低温烫伤;到了 51℃,两分钟就够了。开发板烫手了可以拿开,戴在手腕上的东西不行。
再往后,差距只会越拉越大。玩具用 ST-Link 烧完就算完事,产品卖出去才刚开始,bootloader、OTA、升级断电能不能退回旧版、新旧版本怎么兼容,一样都跑不掉,升级失败的代价是一块砖,外加一张客服工单。物料缺货要换型号,出厂要产测,平时要留日志,返修回来的板子得能看出当时到底出了什么事。玩具没有"以后",产品的"以后"很长,而这笔账,早在设计阶段就定下了大半。
把这几条和前面 AI 的表现摆在一块儿,几乎一一对得上。玩具那一侧,写驱动、读传感器、把数据发出去,正是 AI 最拿手的;产品那一侧,功耗、睡眠唤醒、防御性的代码、多颗芯片配合、真实的物理环境,全是它一碰就露怯的地方。做那场用户实验的研究者,自己在结论里也写得明白,大模型还没法靠自己,稳稳当当地做出一个从头到尾都能用的系统。硬件在环那篇说得更扎心,很多失败的方案,只是"离开真板子的时候看着没毛病"。
所以 AI 带来的,不只是代码写得更快。它把玩具变得几乎不值钱,也把产品衬得更贵了。
落到找工作上,这个变化更扎眼。
国际劳工组织那份针对国内企业的调研里,一家靠 AI 起家的人才服务公司说,AI 让初级顾问能交付过去要中高级才做得出来的活;一位风投合伙人说得更干脆,以后这个行业的人会变得"更便宜",因为那些过去靠经验和专长撑着的能力,正在被 AI 拉平。
被拉平的是什么?首当其冲的,就是做 demo 的能力。
同一个岗位,几百份简历摞在一起,项目栏大同小异,智能小车、温湿度监测、智能家居、平衡车、基于 XX 的 YY 系统。以前这些至少能说明"这人动手做过东西",现在面试官心里门儿清,有 AI 陪着,一个下午就能攒出好几个。项目名起得再响亮,也很难再证明什么。
到了面试,差距更是藏不住。简历上写一块智能手表,有经验的面试官不会问用了哪颗芯片,他会顺着往下挖。续航多久?平均电流多少,怎么测的?睡眠电流最后卡在哪?OTA传到一半断电了会怎样?两颗芯片谁先睡、谁叫醒谁?做的时候遇到过最难查的 bug 是什么,怎么定位到的?
玩具项目,通常问到第二个问题就接不住了。产品级的项目,每个问题后面都连着一段真实的踩坑经历,能讲出取舍,能讲出当时为什么这么选、后来又为什么推翻。面试官想听的就是这个,追问得下去,才叫有含金量。
在卷成现在这样的环境里,一个经得起追问的产品级项目,比多刷几个例程、多列几行"熟悉 XX"管用得多。它证明的不只是会写代码,而是这个人完整见过一个系统从原理图走到能交付,知道坑埋在哪,也知道出了事怎么收场——企业嘴上说"要有工程经验"的时候,心里想找的就是这种人。
当然,含金量不在简历上那一行字,在那一行字背后被坑过的每一个晚上。写上去容易,扛住追问难。
那么,一个产品级的项目,到底能把人练成什么样?
"工程能力""工程经验",招聘 JD 里天天见,真要掰开讲清楚的人却不多。放在今天这个背景下,这件事格外要紧——不知道自己的价值长在哪,就只能被焦虑牵着走。
不妨把嵌入式工程师想象成一棵树。
消费电子、汽车电子、工业控制,还有这两年火起来的具身智能,是长在上面的不同枝杈;MCU、RTOS、嵌入式Linux,是通往这些枝杈的几条技术路径。可撑住整棵树的,是中间那根树干,工程能力。
树干不是刷例程刷出来的。点灯、串口、读个温湿度,每个外设单独拎出来都能跑,可它们从来不用挤在同一块板子上抢内存、抢总线、抢电量。真正的工程能力,只会在一个完整的、约束拉满的产品里被逼出来。
这也是为什么,有的嵌入式实战课干脆把整门课的主线,压在了一块智能手表上。注意,不是开发板上攒出来的那种"手表 demo",而是一块照着商业产品标准做的表。
从原理图、器件选型开始,一路写驱动、上RTOS、抠低功耗、调蓝牙、做OTA,最后做出一块能戴在手上、能连手机、续航按天算的表。选型要掂量成本和供货,功能写完了,功耗、稳定性、升级、异常恢复,商业产品该过的关一道也绕不过去。整个过程不刷零散例程,所有外设从第一天起就挤在同一块板子上,内存不够了自己想办法,续航不达标自己去抠,蓝牙断了自己去查。一门课走下来,手里留下的不只是一块表,还有一本厚厚的踩坑笔记。写进简历,这就是一个面试官愿意追着问上半小时的项目。
选手表,是有讲究的。这东西麻雀虽小,五脏俱全。
拿这门课里那块表来说,主控是一颗 STM32F411CEU6,100MHz 的 Cortex-M4,512KBFlash,RAM只有 128KB;蓝牙没让它自己扛,单独交给一颗 nRF52840;再挂一片 16MB的 W25Q128,字库、表盘图片、运动数据、升级包都往里放;外面再围上一圈屏幕、触摸、IMU、心率之类的硬件和传感器,全挤在手腕那一小块地方。电池只有几百毫安时,却要撑好几天;它贴着皮肤戴一整天,发热、续航、稳定性,每一项都直接落在用户身上。前面 AI 翻过车的那些地方,I2C 读 IMU、心率、低功耗、蓝牙协议栈,这块表上一个都躲不掉。
更妙的是两颗芯片的搭配。一颗管显示和业务,一颗管无线,板子上就不光有"代码怎么写"的问题,还多了"两颗芯片怎么配合"的问题——这是单片机例程永远练不到的。
回头再看那道 40 分钟的心率题,一颗传感器、一颗蓝牙芯片、一个数发出去,那只是这块表投在墙上的影子。影子之外的部分,才是它的分量所在。
跟着这块表从零走到能戴,树干上的年轮会一圈一圈长出来。
很多人对硬件平台的理解,停在"这颗芯片有几个串口、主频多少"。真正的理解,是知道数据在芯片里怎么走。
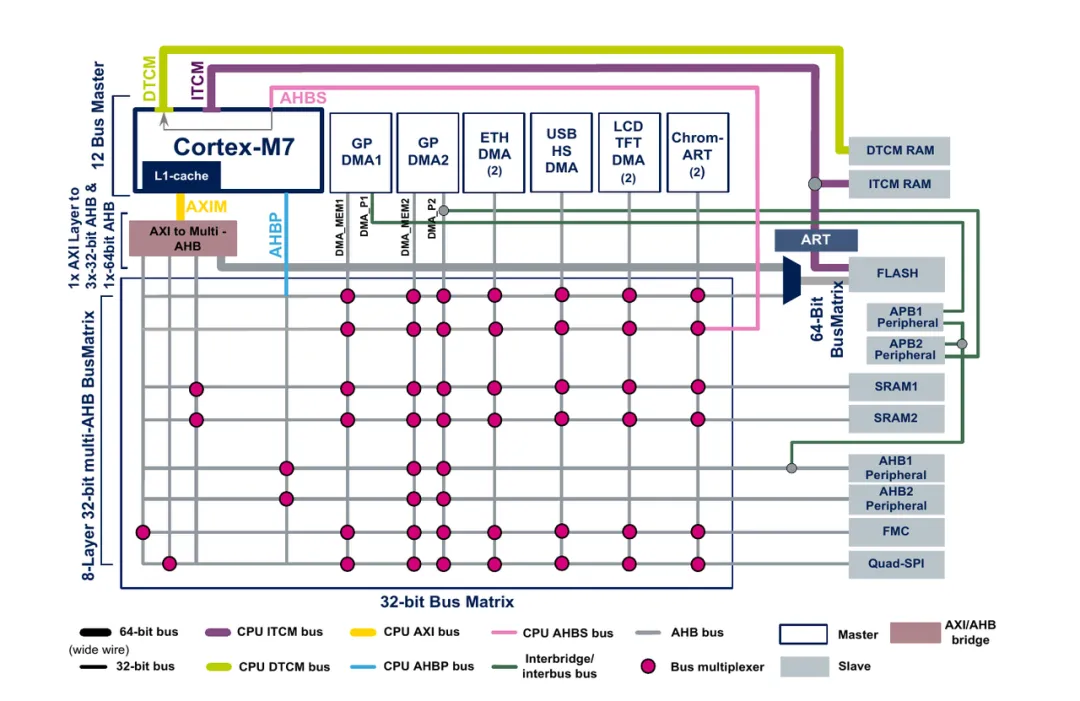
STM32F7 的系统架构,一个 Cortex-M7,十几个总线主设备,一张AXI/AHB总线矩阵,外加 ITCM、DTCM、SRAM1、SRAM2 几块性格各异的内存
同样是一块RAM,挂在哪条总线上、哪些DMA够得着、走不走 Cache、访问要几个周期,全都不一样。变量放错地方,轻则性能打折,重则就是前面那个 Cache 一致性的坑,数据时对时错,查三天都查不出来。
放到手表上,这事一点都不抽象。F411 没有 Cache,前面那个一致性的坑算是躲过去了,可别的坑一个不少。它的每一路DMA请求只能落在固定的几个 Stream 上,屏幕走SPI,W25Q128 也走 SPI,两边都想用 DMA,规划时要是没对过映射表,很可能发现两个外设偏偏要抢同一个 Stream;SPI 挂在 APB1 还是 APB2,最高时钟差着一倍,选错了,刷屏帧率天生就矮一截。这些都写在参考手册里,可只有真正画过一遍资源分配表的人,才会在原理图阶段就把它们对上。
时钟树、电源域、引脚复用、上电时序、芯片勘误表,也都属于这一圈。息屏时 F411 一降频,它和 nRF52840 之间那条串口的波特率会不会跟着漂?心率传感器的供电是不是单独一路,关掉之后重新上电要等多久才能读?它们决定了代码写下去之前,哪些路能走,哪些路是死胡同。
一个几十行的 demo,怎么写都行。一块要天天戴、要不停升级的手表,就完全是另一回事了。
表盘、计步、心率、消息通知、蓝牙同步、充电管理、闹钟……功能一多,最怕的就是互相缠在一起。成熟的做法,是从下往上切出好几层,最底下是板级支持和芯片抽象,往上是传感器、屏幕这些器件驱动,再往上是蓝牙协议栈、文件系统这些中间件,然后是计步、心率这类业务服务,最顶上才是表盘和交互。每一层只跟相邻的层打交道,接口定死,实现可以换。
这么切,图的是变化来的那天。IMU缺货要换型号,分层做得好,只改一个驱动文件;分层做得烂,计步算法里到处是寄存器读写,一换料就是推倒重来。换主控也是一样,外设寄存器一家一个样,底层没隔离干净,换一颗芯片就等于把上面的业务重写一遍。
两颗芯片的表,还多一道划分题。蓝牙协议栈放在 nRF52840 上,F411 就省下了一大块RAM和 CPU;可消息解析放哪边?时间同步谁说了算?手机发来一张新表盘图片,是 nRF 先整张收完再转给 F411,还是边收边转、直接写进 W25Q128?每一个选择,都牵动着两边的内存、功耗,还有出错之后从哪里恢复。
模块之间怎么说话,同样是架构问题。手机推来一条消息,要经过蓝牙接收、存进 Flash、马达震一下、屏幕亮起来,跨了四五个模块。是让蓝牙回调里直接去画屏,还是扔进消息队列交给UI任务慢慢处理?抬腕亮屏、息屏、充电、低电量,这几个状态怎么切换,状态机画没画清楚?哪些逻辑放在中断里,哪些扔给任务去做?这些决定一旦定下来,后面几年的开发节奏基本就被锁死了。
这偏偏是 AI 最不擅长的。让它改代码,它常常会"顺手"做一些没人要求的改动,加几行打印、动一动别处的逻辑,在资源紧张的系统里,这种改动很容易悄无声息地埋下问题。它看得见眼前这段代码,看不见整座房子的承重墙在哪。
嵌入式和其他软件最大的区别,是永远在跟资源讨价还价。
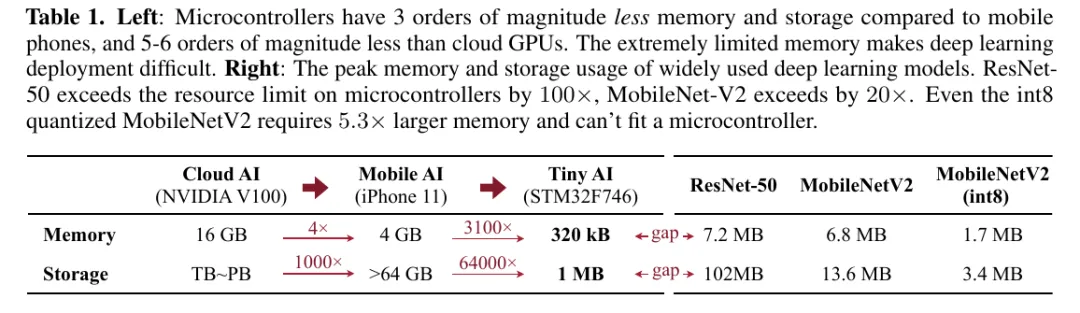
一颗 STM32F746 只有 320KBSRAM、1MB Flash,比手机少三个数量级,比云端GPU少五六个数量级
这张表里的 F746 已经算紧巴巴了,而手表上那颗 F411,RAM只有它的五分之二。
算一笔账就知道有多紧。一块 240×240 的屏,按 RGB565 算,一帧显存就是 115200 字节——128KB的内存,光这一帧就吃掉快九成。整帧缓冲想都别想,只能切成一条一条的小缓冲,画一截、DMA送一截,CPU 画下一截的时候 DMA 正在送上一截,乒乓着来。缓冲切多大、切几块,直接决定了刷屏流不流畅,也决定了剩下的内存还够不够别人用。剩下那点地方,还要塞下RTOS、传感器驱动、计步和心率算法、跟 nRF 通信的收发缓冲,每个任务还得留栈。
栈给多了浪费,给少了哪天某条罕见路径一走就溢出;动态内存用多了,戴上几个星期碎片化,某次malloc失败,表就重启了。字库、表盘图片当然放不进片内,全躺在 W25Q128 里,每画一个字、每贴一张图都要从SPI上现读,读取速度又会反过来拖慢刷屏。
CPU 时间也是资源。刷屏的DMA中断、心率采样的定时中断、nRF52840 发过来的串口数据,谁的优先级高?心率采样晚了几个毫秒,波形就会失真;串口接收没及时处理,缓冲一溢出,手机推来的消息就丢了半截。会不会出现优先级反转,最坏情况下的响应时间能不能保证,这些都要算。
还有功耗,这是手表的命门。电池只有几百毫安时,平均电流每多出一毫安,续航就要少掉好几天。屏幕什么时候熄、传感器什么时候关、CPU 什么时候睡、被谁唤醒,一微安一微安地抠。连那片 W25Q128 都不能放过,用完不送进掉电模式,它的待机电流能比掉电时高出一个数量级。前面那个 12.2μA 和 8.6μA 的差距,就是在这种地方拉开的。
设备很少是孤岛。手表里面有 I2C、SPI连着各路传感器、屏幕和 W25Q128,中间有一条 F411 和 nRF52840 之间的板间链路,外面还有蓝牙连着手机,数据在一条条链路上跑,每一条都可能出错。
最容易被小看的,反倒是板子上两颗芯片之间那一条。F411 和 nRF52840 各跑各的固件,各有各的睡眠节奏。一方睡着了,另一方的数据发给谁?得有一根唤醒线,还得约好先唤醒、再等对方就绪、再发。帧头、长度、CRC、应答、重发,一样不能少;两边固件版本对不上了,协议还得能认出来、能降级兼容。这条链路要是设计得随意,后面所有"偶发"问题,最后都会往这里堆。
蓝牙这条最考验人。人走出房间又回来,断了要能自己重连;一条长消息超过MTU,要分包、要确认、要重传;手机 App 升级了协议版本,旧固件要能兼容;OTA升级包传到一半断了,要能从断点续传,而不是从头再来。何况这块表要升级的是两颗芯片,nRF 自己的固件好说,F411 的升级包还得经 nRF 转一手,先落进 W25Q128,再由bootloader校验、搬进片内 Flash,哪一步断了都得有退路。一帧从哪开始、到哪结束,校验怎么做,超时设多长,对方一直不回话怎么办……这些细节,正常情况下完全看不出区别,只有在地铁里、在电梯里、在手机后台被杀掉的时候才会暴露。
板内也不太平。I2C 读传感器读到一半被复位打断,从机把SDA拉低不放,整条总线就死了,这时候得知道先手动打几个时钟把它"救"回来。
前面那份 AI 失败清单里,就有两条是这么栽的,一条是SPI数据位悄悄翻转却没有任何校验,另一条是设备进入睡眠前,串口缓冲区里的数据还没发完就被截断了。都是编译能过、实验室能跑、一上真实环境就出事的典型。
有人在 Arduino、ESP-IDF、Zephyr 三个平台上各出了 42 道题,全部烧到真板子上验证,结果也是这个规律。点灯、读个传感器这类基础外设控制,AI 做得挺顺,一到协议层、一到多个设备配合,成功率就明显往下掉。
新手写代码,想的是"正常情况下怎么跑"。老手写代码,想的是"出了事怎么办"。
手表上能出的事太多了。看门狗该在哪里喂,喂狗的地方能不能说明系统真的还活着;HardFault 进来了,现场信息能不能存下来,等用户返修时拿出来分析;OTA升级到一半没电了,W25Q128 里有没有留着旧版本,能不能回滚,而不是直接变砖;充电时温度一高,要不要主动停充……
W25Q128 本身就是个异常处理的练兵场。它按 4KB扇区擦除,擦一次要几十毫秒,每个扇区只保证十万次擦写。要是图省事,每分钟往同一个扇区写一次步数,一天就是 1440 次,不到七十天,这个扇区就写到寿命了——所以得做磨损均衡。擦到一半正好没电,扇区里就是一半新、一半旧的数据——所以写入得有校验、有双份备份,上电后能自己检查、自己恢复。
这些功能用户永远看不到,产品演示时也用不上,可少了哪个,量产之后都可能是一场灾难。
那个被 AI 删掉的 2 秒启动延时,本质上就是一段异常处理代码。它什么正事都不干,唯一的作用就是在最坏情况下给人留一条后路。AI 之所以敢删,是因为它从来没见过没有这条后路时会发生什么。
最后一圈,也是最见功力的一圈。
行业里常说,嵌入式工程师一半以上的时间在调试,这话不夸张。调试说到底,就是对着一个看不见里面的系统,从表面的现象一层层往下剥,一直剥到病根上。
手表的 Bug 尤其刁钻。戴着睡了一晚,早上发现表重启过一次;一插上充电器,触摸就开始乱跳;屏幕一刷新,蓝牙就断;心率在跑步时偶尔飙到两百……没有一个会在你盯着它的时候乖乖复现。
示波器看波形边沿,逻辑分析仪抓时序,SWD 单步、看寄存器,串口打日志,功耗曲线里找尖峰。工具谁都会用,难的是知道在哪里下探头。偶发重启,是栈溢出、看门狗超时,还是马达一震电源纹波把BOR触发了?充电时触摸乱跳,是软件滤波不够,还是充电器的共模噪声窜进了触摸芯片?
就算把 AI 请进调试流程,靠谱的用法大概也就长这样。
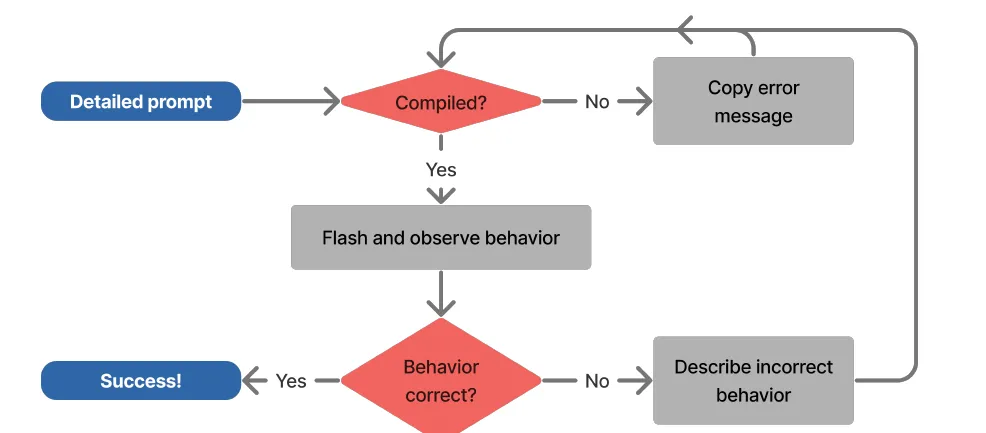
详细提示、编译、烧录并观察行为,行为不对就描述现象反馈给模型
看起来简单,但中间那个"观察行为"和右下角的"描述错误行为",AI 自己做不了。能把一个诡异的现象准确地描述出来,本身就已经完成了一半的定位。
这六圈,讲究的是会不会做。可同样会做的两个人,一个三天定位问题,一个三小时,差的往往是另一样东西。
说白了,经验就是一个人脑子里那本踩坑账本。
AI 那份失败清单里,最扎眼的是这么一条:芯片自身的缺陷、硬件上偶发的错误,它一概意识不到,电压波动导致的 Flash 写入失败、没有校验的SPI位翻转、睡眠前被截断的串口缓冲区……所以它写不出防御性的固件,甚至会主动把原有的保护代码删掉。
把这句话反过来读,就是工程经验最精确的定义——知道硬件会在哪里、以什么方式背叛你。
就连给 AI 配上专家写好的"避坑指南",前面那 42 道题里也还剩两道怎么都过不去。一个是 5V 的RTC模块接在 3.3V 的 ESP32-S3 上,工作不稳定;另一个是旋转编码器的正反转方向,不同型号根本没有统一定义。
两个都跟代码无关,一个是电平,一个是器件差异。
有经验的人看到"RTC时好时坏",第一反应是去量电平、翻手册查输入高电平阈值;看到"编码器方向反了",第一反应是换个型号比一比,或者干脆在软件里留一个方向配置。这种一眼从现象看到病根的直觉,是一次次被坑出来的。
一块手表从零做到能戴,这样的坑能攒下一整本。PPG 心率怕阳光、怕手腕乱晃,算法再好,也得先把这两样带进来的杂波收拾干净;马达一震,IMU的数据跟着抖,计步可能凭空多出几步;冬天一到,锂电池内阻变大,电压一掉,本来够用的续航突然缩水。
温度更要命。前面那个测试平台做过这么一个实验:把一块 ESP32-S3 放在 32℃ 的热板上,当它正贴着手腕,跑一段没做任何优化的 TinyLLaMA 推理。
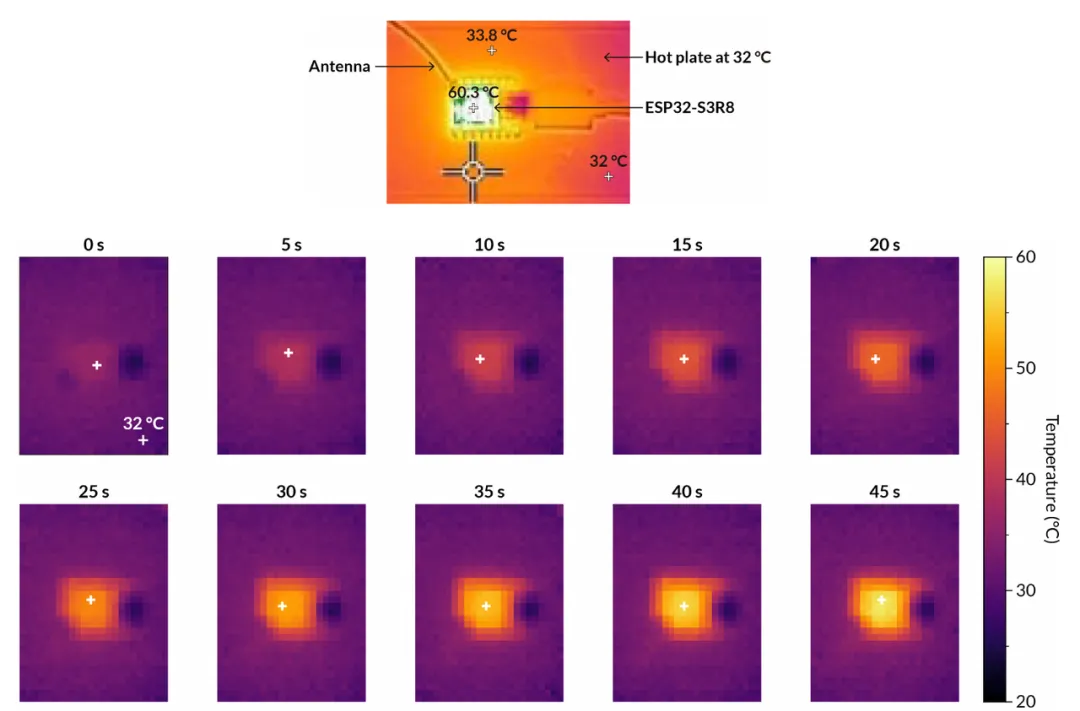
热板恒定 32℃,模拟贴着皮肤。下面十张是每隔 5 秒拍一张的热像,芯片那一块从暗紫一路烧到发白,一分钟后表面到了 60.3℃
一分钟,芯片表面冲到 60.3℃,比底下的热板高出 28℃ 还多。拿前面那几条红线一对,44℃ 那条,从热像的颜色看,半分钟不到就过去了,51℃ 也没守住。
手表里当然不跑大模型,可道理是一样的,耗掉的每一毫瓦最后都变成热,表壳里又没地方散。充电、蓝牙大批量传数据、屏幕长时间高亮,哪个都能让手腕那一小块慢慢热起来。所以温度得跟功耗放在一起管,从一开始就算进预算里,而不是等用户说"有点烫"了才去查。这些数字,没有哪个需求文档会主动写给你,可做穿戴的人都得刻在脑子里。
所以在那门手表课上,最花时间的往往不是写功能,而是带着人把这些坑一个一个复现出来、定位清楚、再填平。功能往往几天就写完了,坑却能填上好几周——可长进树干里的,偏偏是后面那几周。
心率这件事,AI 还闹过一个笑话。让GPT-4"读取一个模拟心率传感器并发送数值",它理解成把"心率"这个数算出来发出去,可真正想要的,是原始的 PPG波形。一个亲手调过这颗传感器的人,根本不会有这种误会。
NASA给系统工程师总结过一句话,放在这里刚刚好。
The art is in knowing when and where to probe.
一块手表练出来的,是树干。再往上,才是各自的枝杈——那门课在手表之后,也正是分成了灵巧手、UDS诊断、AI 眼镜几个方向,各自往一个行业里扎深。
消费电子拼的是成本、功耗和迭代速度,一个功能从需求到量产可能就几个月,OTA要稳,产测要快,AI 眼镜这类新品类更是把摄像头、麦克风、端侧 AI 推理一股脑塞进了几十克的镜腿里;汽车电子讲功能安全和诊断,CAN、车载以太网、UDS,每一个故障都得有迹可循,还要扛得住十几年的车规寿命;工业控制要的是长期稳定和确定性,现场总线、宽温、强干扰,一台设备可能一跑就是十年不重启;具身智能则把这些要求叠在了一起,一只灵巧手上十几个电机要在毫秒级别协调,电流环要高频、要实时,出了异常必须安全停下来,而不是把旁边的人夹伤。
行业黑话不同,认证标准不同,工具链也不同。可把它们剥开,底下还是那几圈年轮,看懂硬件、搭好架构、管住资源、设计链路、兜住异常、定位问题。在手表上为几个毫安抠过功耗的人,去做 AI 眼镜时自然知道功耗预算该怎么排;在手表上被蓝牙断连折磨过的人,看UDS诊断里的会话管理和超时重试,会觉得格外眼熟;在手表上调过马达和IMU互相干扰的人,碰到灵巧手里电机和传感器挤在一起,也不至于两眼一抹黑。
技术路径也是一样。从MCU裸机到RTOS,再到嵌入式Linux,抽象层次越来越高,生态越来越庞杂。而 AI 在这几条路上的表现,差得非常远。
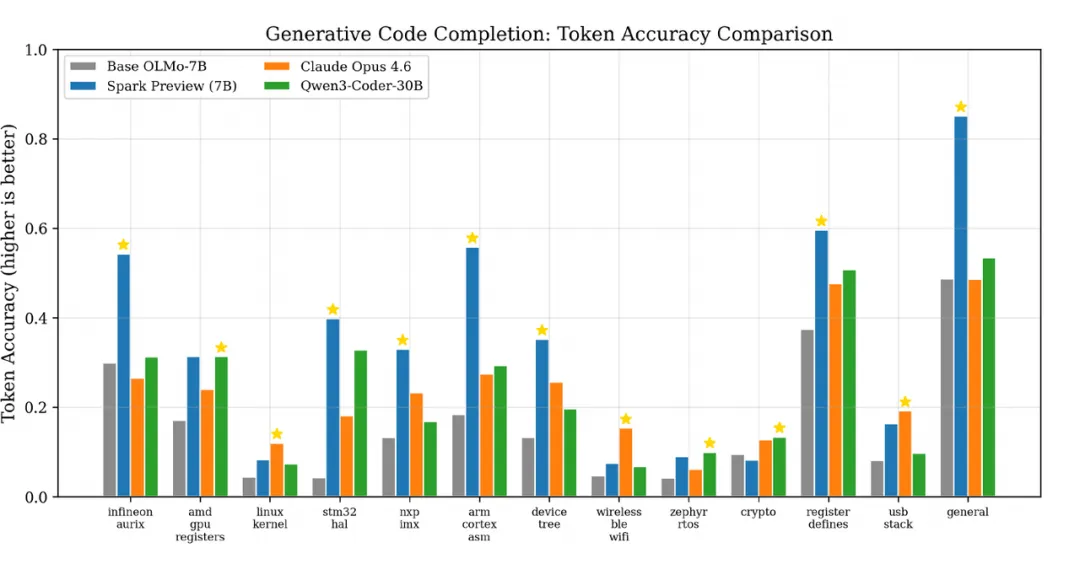
四个模型在 13 个嵌入式细分领域上的代码补全准确率,Linux 内核、ZephyrRTOS、无线协议栈、加密几栏,所有模型都在低位徘徊
寄存器定义、ARM汇编这类格式固定、样本充足的代码,模型补全得还不错;一到 Linux 内核、ZephyrRTOS、蓝牙和 Wi-Fi 协议栈,所有模型都只剩一根矮矮的柱子。那 42 道题也是同一个趋势,资料最多的 Arduino 裸考全对,换成 ESP-IDF 和 Zephyr,一下子掉到七成上下。
越往系统深处走,越复杂、越碎片化,AI 越吃力。
换个角度看,这也说明技术路径只是路径。今天做MCU的人,明天转去做 Linux 驱动,要补的是新平台的知识;可如果树干足够粗,这种迁移只是换一条路走,而不是从头再长一棵树。
反过来,如果只会某个平台的API,只熟悉某个行业的套路,树干却很细,那 AI 来的时候,最先被削掉的就是这一截。
树干立住了,再回头看 AI 这一年多的进展,会发现一条暗线,AI 在哪里进步得最快,取决于哪里的结果最容易被自动验证。
Verilog就是个现成的例子。testbench 能自动生成,功能等不等价也能自动检查,强化学习就有了稳定的打分依据。于是一个只有 7B 参数的小模型,在 RTLLM 上都能压过 671B 的 DeepSeek-R1。
反过来,嵌入式最难被 AI 吃掉的,正是必须到物理世界里才验证得了的那部分,时序、功耗、温度、信号完整性、Cache 一致性、电源上电顺序。
顺着这条线,树干上正在冒出几根新枝。
AI 写代码不稀奇了,稀奇的是知道怎么证明它写对了。
前面那面红叉墙,之所以最后能变成超越人类专家的成绩,靠的不是模型突然变聪明了,而是有人给它搭了这么一张桌子。
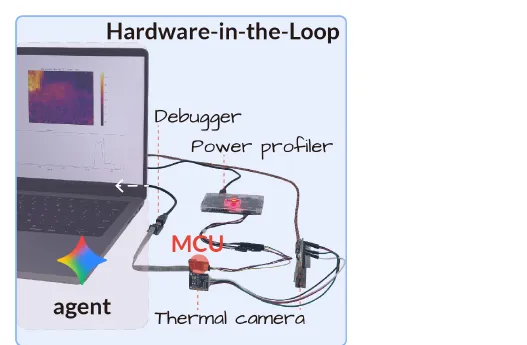
调试器、功耗分析仪、热成像相机围着一块MCU,这就是 AI 的"眼睛"
调试器、功耗仪、热成像相机,一根根线接好,把物理世界翻译成 AI 能读懂的数字。会搭这样的测试环境、会写自动化测试、会把一个物理现象变成一个能自动判对错的信号,这本身就是新一代嵌入式工程师的核心能力。谁掌握了这个闭环,谁就是在指挥 AI,而不是被 AI 替代。
再回到那 42 道题。同样的 AI,分三种情况考,什么都不给,给它自己总结的技能文档,给人类专家写的技能文档。
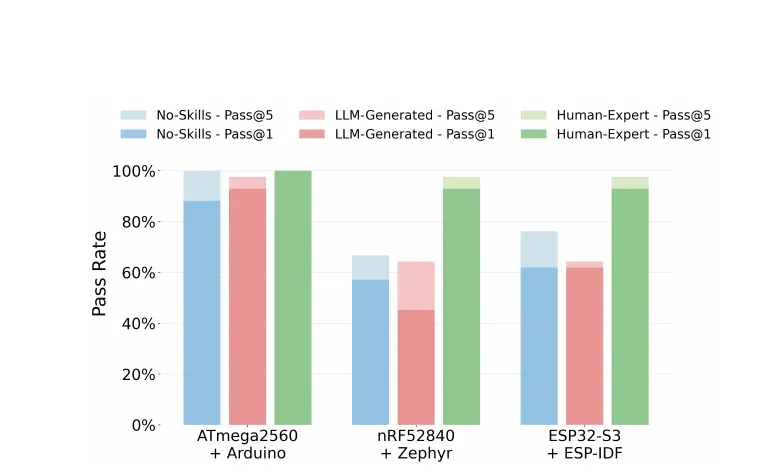
蓝色为无技能,红色为LLM自己生成的技能,绿色为人类专家编写的技能
让 AI 自己总结经验,ESP-IDF 反而更差了,token 消耗还翻了好几倍。它总结出来的"经验",会把自己原本就错的假设再强化一遍。
换成人类专家写的几百字简短文档,三个平台几乎全部满分。没做出来的,就是前面那两道,电平不匹配、编码器方向不统一。
那些"这颗芯片上电要先等 10ms""这个外设在低功耗模式下会丢第一个中断"的经验,一旦被整理成 AI 能直接拿来用的文档,价值会被放大很多倍。
以前经验只能靠带徒弟一点点传下去,现在它可以被"编译"进工具链里。谁能做这件事,谁就站在 AI 的上游。
还有一个方向常常被焦虑掩盖。AI 不只是来抢活的,它自己也要跑在MCU上。
前面那张内存对比表已经说明了难度,一个 ResNet-50 比MCU的存储上限大了一百倍,就连量化过的 MobileNetV2 也塞不进去。要在这种地方跑模型,网络结构、推理引擎、内存调度得一起重新设计。
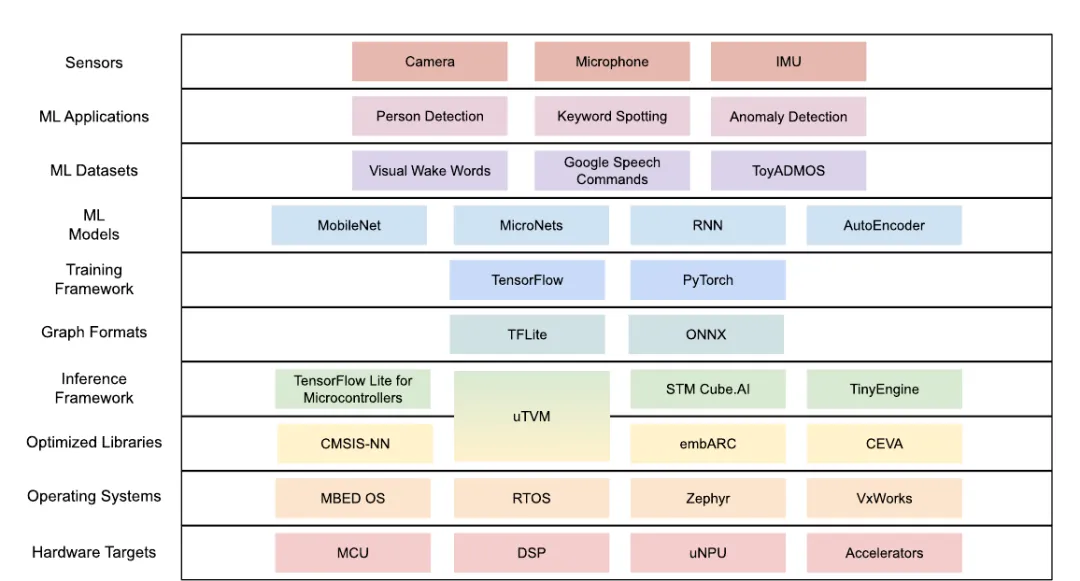
TinyML 技术栈,从传感器、模型、训练框架、推理引擎、优化库、操作系统一直到硬件目标,每一层都高度碎片化
下面几层,硬件、RTOS、CMSIS-NN 这类优化库,本来就是嵌入式工程师的地盘;往上多长两层,懂量化、懂算子支持、懂 STM32 Cube.AI 这类部署工具,就是一个完全不同的身位。
这套东西落到一个真实的产品上,会是什么样子?灵巧手是个再合适不过的标本。
还是那门以手表打底的实战课,往具身智能方向接的灵巧手项目,用的是这样一套组合,STM32N6 加 STM32G4,空心杯电机,腱绳驱动,再加上一圈各式各样的传感器。
两颗芯片的分工,很像人的大脑和小脑。
N6 是大脑。Cortex-M55 跑到 800MHz,带 Helium 向量扩展,旁边挂着一颗 600 GOPS 的 Neural-ARTNPU,4.2MB片上SRAM,摄像头接口、ISP都是现成的。面前是个杯子还是个鸡蛋,该用几根手指,用多大的力,这些判断在它身上完成。
G4 是小脑。170MHz的 Cortex-M4,带着 CORDIC、FMAC 两个数学加速器,片上运放能直接放大电流采样信号,比较器能在过流的一瞬间从硬件上封锁PWM,不用等软件反应过来。那一排空心杯电机的电流环、速度环、位置环,全压在它身上。
大脑一秒想几十次就够了,小脑一秒得算上万次。两颗节奏差着几个数量级的芯片,要协同成一只手,树干上的每一圈年轮都得派上用场。
先看大脑。模型在电脑上训练得漂漂亮亮,想塞进 N6,远不是点一下"部署"那么简单。让 AI Agent 自己动手,往 N6 上部署一个语音模型,结果是这样的——
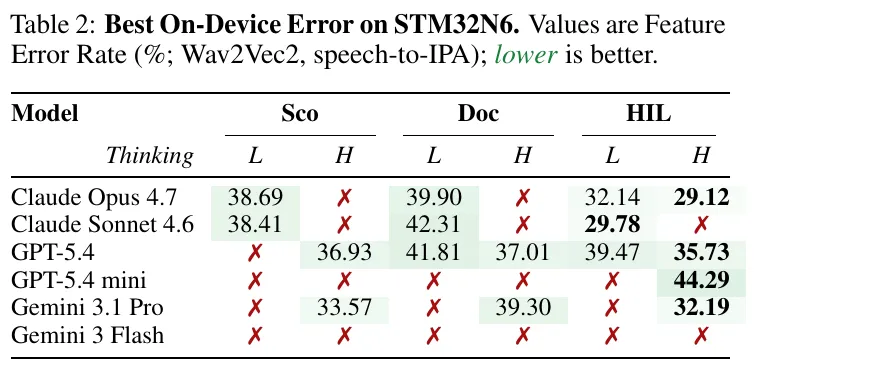
在 STM32N6 上部署 Wav2Vec2,数值越低越好;✗ 依然表示 10 轮之内一次都没部署成功
N6 的内存和算子支持已经比 MAX78000 宽松得多,红叉还是一片一片的。失败的原因几乎全是工程问题,模型导出的方式工具链不认,量化方式选错,模型里带了动态形状,内存布局踩了部署工具链的约束……在PyTorch里跑得好好的模型,一过工具链就挂。
就算部署成功了,要操心的事才刚开头。NPU只认它支持的算子,碰上不支持的,就得退回 M55 上用 Helium 慢慢算,一来一回,推理时间可能翻上好几倍,所以网络结构常常得反过来迁就硬件。N6 片上没有 Flash,模型权重放在外部存储里,靠 XSPI 映射着读,激活值放在片上SRAM,哪一层的数据放哪、带宽够不够,全要一笔一笔算。
还有个熟悉的老朋友会回来。M55 是带 D-Cache 的,摄像头的DMA、ISP、NPU和 CPU 共用着同一片缓冲区——前面 AN4839 里那个 Cache 一致性的坑,在这里原封不动地又出现了。只不过这回出错的不是一段测试数据,而是一帧"看错了"的图像,手就朝着错误的位置伸了过去。
4.2MB听着宽裕,算下来也不宽裕。一帧 640×480 的RGB图像就是九十多万字节,摄像头要双缓冲,ISP要中间结果,NPU要激活缓冲,谁跟谁能复用、谁必须独占,又回到了手表上练过的那道资源题,只是数字大了几十倍。
再看小脑,问题更"物理"。
空心杯电机没有铁芯,转动惯量小,也没有齿槽转矩,响应又快又顺,这是它被选进灵巧手的原因。可电感也小,电流纹波大,PWM频率得往上拉,电流采样还得和 PWM 严格对齐,否则采回来的全是纹波。热容量同样小,手指捏住一个东西顶着不动,电流就一直顶在那里,线圈温度蹭蹭往上涨,不做 I²t 这类过热和堵转保护,烧一个电机只是分分钟的事。
腱绳驱动更考验功力。电机藏在掌心或者前臂,手指靠一根根绳子拉,好处是手指能做得又轻又细,代价是电机转了多少度,不再等于手指弯了多少度。绳子受力会伸长,走过滑轮和套管会有摩擦,而且这种摩擦会随着绳子的包角按指数放大——手指弯得越狠,绳子绕得越多,电机那头使的劲传到指尖就剩得越少。来回运动有迟滞,松了有死区,用上几个月还会蠕变。预紧力给多少,怎么标定,控制里怎么补偿,全得在真机上一遍遍试出来。
所以光靠电机编码器远远不够,手上还得靠别的传感器帮忙,关节角度、绳子张力、指尖触觉……这些数据从哪条总线进来、以多快的频率进来、和电机控制环怎么对齐时间,又是一道实打实的架构题。
最后是两颗芯片之间那条链路。大脑发下去的抓取指令要准时到,小脑回传的位置、电流、触觉要稳定,时间戳要对得上。万一通信断了,手指是保持当前姿态、慢慢松开,还是立刻停下?这就是异常处理,只不过这一次,处理不好的代价是捏碎一个鸡蛋,甚至夹到人。
这么一拆就很清楚了。一只灵巧手里,真正属于"AI"的,只有NPU上那一小块;剩下的,内存规划、Cache 一致性、电流环、绳子的非线性、多路传感器的时间同步、板间链路、堵转和过热保护,全是树干上的年轮。
再回头看,手表上练过的那几圈,在这里几乎能一一对上。在 F411 上为 128KB抠过显存的人,到 N6 上规划 4.2MB不会发慌;调过 F411 和 nRF52840 之间那条链路的人,设计 N6 和 G4 的通信时,帧、校验、心跳、超时这一套早成了肌肉记忆;给 W25Q128 设计过掉电保护的人,再去写灵巧手的安全停机逻辑,思路是一脉相承的。
树干粗了,枝杈才长得上去。
现实是,这种人太少了。在MCU上部署一个模型,往往需要一个同时懂嵌入式和机器学习的人花上好几周,换一颗芯片还得从头来,光 STM32F7 一个系列就有 22 个型号。至于既能把模型塞进 N6、又能把空心杯电机的电流环调稳、还能把绳子的非线性补偿明白的人,就更少了。想想前面那家企业的吐槽,"懂技术不懂应用",缺的正是这种复合型的人。
那个DMA绕过写锁的例子已经说明了,AI 默认只对"功能"负责。
在汽车电子、医疗、工控这些领域,一段功能正确但缺少边界检查的固件,代价可能是召回,是事故。让几个 AI Agent 配合模糊测试、静态分析去反复修补 AI 写的固件,九成以上的漏洞确实能补上,但前提是有人先把缓冲区溢出、竞态条件、拒绝服务这些威胁定义清楚,告诉它往哪里找。
威胁建模、安全需求拆解、功能安全标准的理解,在 AI 时代只会越来越值钱,因为它们正是 AI 最不会主动去想的部分。
还有一个很少被摆上台面的现实,很多公司的固件代码,是不能发给第三方API的。
于是出现了另一条路,把小模型拿回本地,专门拿嵌入式代码和数据手册去喂。前面那张 13 个领域的对比图里,蓝色那根柱子就是这么喂出来的,八百多组"代码仓库+数据手册"配对数据灌进去,一个 7B 的开源模型,13 个领域里有 8 个超过了 Claude Opus 4.6。
通用大模型写嵌入式为什么总翻车,其实也就那几样,寄存器名靠编,外设初始化顺序不对,厂商API串台,违反时序约束。根源不在推理能力,而在这些知识在训练语料里太稀少了。
所以,懂得为自己团队的芯片平台和代码规范构建知识库、评估和部署合适的模型,会是一项实打实的工程能力,而不是 IT 部门的事。
最后回到那个问题。
系统工程里有一张被引用过无数次的图。
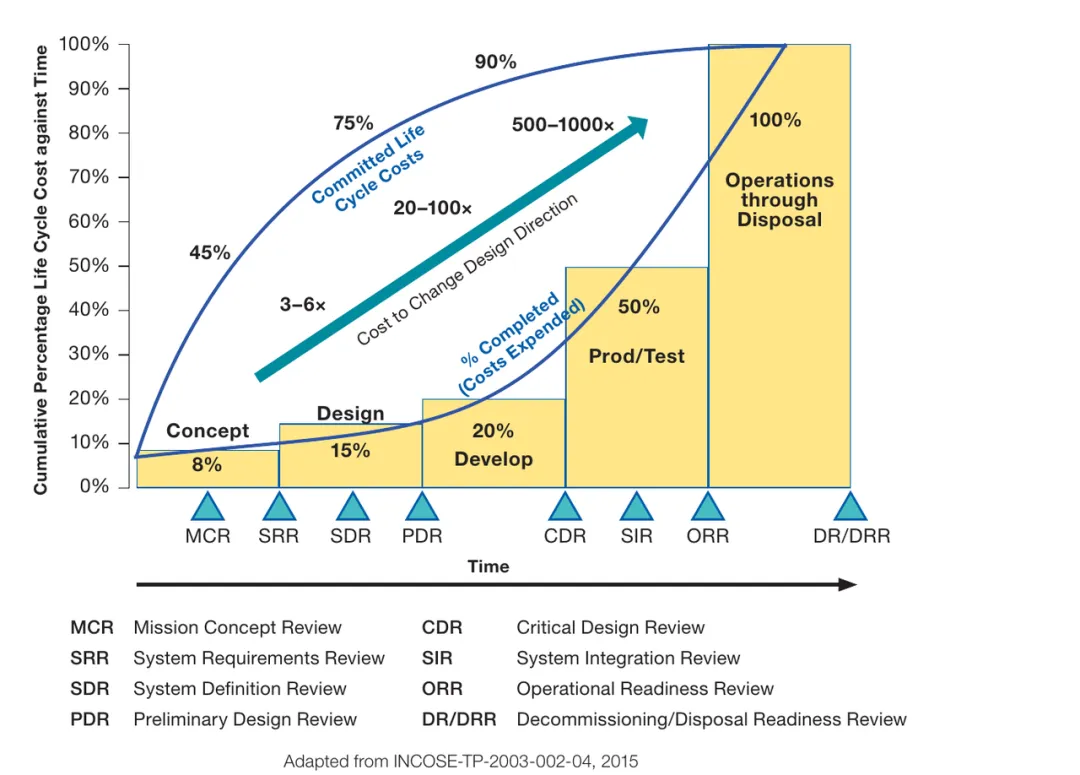
设计阶段只花掉约 15% 的成本,却锁定了约 75% 的全生命周期成本,越往后改设计,代价越高
设计阶段实际花掉的钱只占 15% 左右,却决定了 75% 的全生命周期成本。越到后期发现问题,修改代价越是成倍往上翻。
AI 现在最擅长的,正好是这条曲线上"花钱"的部分,写代码、改代码、生成测试。而真正"锁定成本"的那部分,选什么芯片、电源怎么分配、模块怎么切、哪些功能放在中断里、哪里要留安全余量、2 秒启动延时该不该留,这些决策依赖的是对整个系统的理解,以及一次次踩坑换来的判断力。
AI 能在三十秒内写完一个 I2C 驱动。但它不知道这块板子上拉电阻选大了,高速模式下波形边沿会变圆;不知道这个项目的上一版因为DMA和 Cache 的问题返过一次工;不知道客户现场的环境温度会到 60 度,那颗晶振要重新评估。
这些东西,不在任何一个训练数据集里。它们在工程师的脑子里、笔记里,以及那些深夜对着示波器的记忆里。
所以,AI 会取代嵌入式工程师吗?
更准确的说法可能是,AI 会取代一种工作方式,把需求翻译成代码、再把代码调到能跑的那种工作方式。如果一个人的全部价值就是"会写 Arduino 例程""会抄HAL库的初始化代码",那压力确实很大,而且会越来越大。
但如果一个人能定义问题、能搭验证闭环、能把经验沉淀成 AI 可用的知识、能在 AI 给出的十个方案里一眼看出哪个会在量产时出事,那 AI 不是对手,是一个永远不累、偶尔犯傻、需要被带着走的实习生。
开头那个凌晨一点对着屏幕发愣的工程师,其实可以换个问题问自己。
这段代码,我能证明它是对的吗?
如果能,AI 只会让他更强。如果还不能,那该补的课,现在补还来得及——别再攒玩具了,找一个按产品标准做的完整项目,比如一块从零做起的手表,从第一根线焊到最后一次OTA,把树干一圈一圈长出来。到那时,简历上那一行字,才算压得住秤。