ARTICLE · 1126067
【基因组语言模型】比对工具要退役了?AI直读细菌"暗物质",挖出数万个未注释元件
导读:过去几十年,我们发现非编码RNA主要靠"和已知序列像不像"。斯坦福与Arc Institute团队换了个思路:让基因组语言模型直接从序列里读出碱基之间的共进化信号,不做比对、不靠同源性。扫完150个细菌基因组,近七成结构化位点是现有注释从没见过的。 |
比对工具要退役了?基因组语言模型直读细菌"暗物质",挖出数万个未注释元件
Coevolutionary mining of prokaryotic non-coding elements with a genome language model
期刊:bioRxiv(预印本,CC-BY 4.0) 发布时间:2026-09-24 作者:David B. Li, Garyk Brixi(共同一作)等 14 人;通讯作者 Michael A. Fischbach、Brian L. Hie 单位:斯坦福大学、Arc Institute、DOE 联合基因组研究所(JGI)、斯隆凯特琳癌症中心等 |
为什么需要这个研究
细菌基因组里藏着大量非编码RNA(ncRNA)和核酸互作系统,它们是调控、防御和适应的核心零件,也是CRISPR这类生物技术工具的源头。但今天的主流发现管线有一个根深蒂固的偏好:先看蛋白编码区,再看和已知序列像不像。
这条路线的天花板很明显。结构化RNA的二级结构往往比一级序列更保守——序列变到认不出来,结构还在。靠多序列比对(MSA)找共变异信号的老办法,需要凑齐足够多"既同源又分歧"的序列,计算昂贵还常要人工修比对。
CRISPR本身就是个反例:它是1987年从一段DNA重复序列的"模式"里被注意到的,比人们理解它的免疫功能早了近二十年。问题随之而来——如果不靠蛋白同源性,直接从核酸序列本身读信号,还能挖出多少个"当年的CRISPR"?
常见误区 "细菌基因组这么小,注释早就做完了。"本文的数据直接反驳了这一点:在150个被研究得很充分的细菌基因组里,Minerva预测出的57,787个含多个发夹结构的位点中,69.5%落在现有注释之外。不是基因组注释完了,而是注释方法看不见它们。 |
Minerva是怎么设计的
核心思想一句话:功能上耦合的碱基会一起突变。为了保住一个碱基配对,进化的两端会留下"补偿性突变"的痕迹。掩码语言模型的训练目标恰恰是"根据上下文猜被遮住的碱基"——一个茎区里被掩码的核苷酸,身份受它的配对伙伴约束。也就是说,共进化信号天然就藏在语言模型的内部表示里,关键是怎么把它取出来。
团队基于gLM2继续预训练了1万亿token(OMG+GlobDB数据集),得到基因组语言模型Minerva-MLM:蛋白编码区用氨基酸token、基因间区用DNA token的混合模态设计,上下文窗口4,096 token(约10 kb DNA),另有8k扩展版。取信号有两条路:
• 分类雅可比指纹(categorical Jacobian fingerprinting):对序列做"电子饱和突变",记录每个位置突变对其他位置预测概率的影响矩阵,再与已知互作类型的参考"指纹"比对,能区分碱基配对、蛋白接触、重复motif等不同互作。
• 互作头(interaction heads):发现特定注意力头天然分工(有的专看重复motif、有的专看RNA碱基配对),用轻量逻辑回归组合最后两层的注意力图,单次前向传播即可出结果。
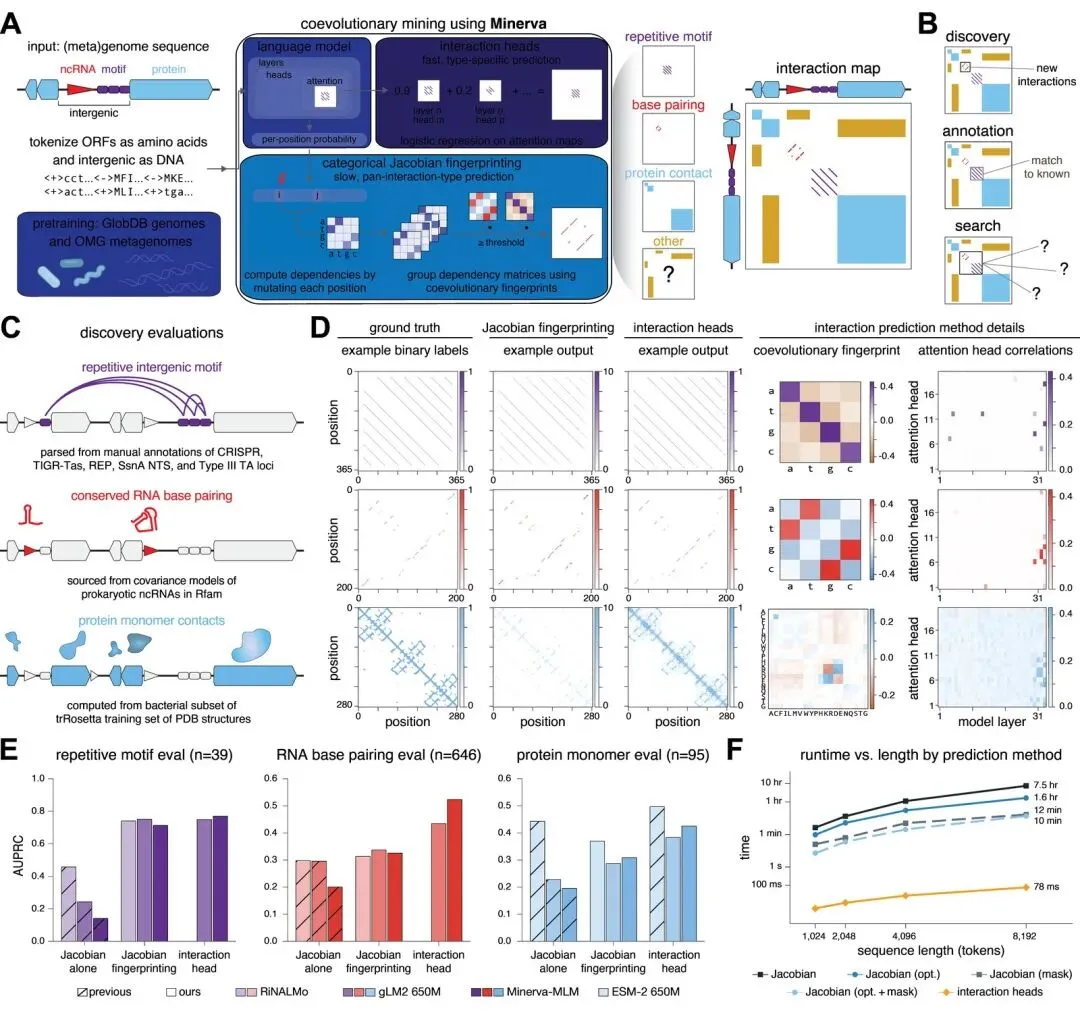
图1.Minerva框架总览:基因组语言模型输出二维共进化图谱,互作头与雅可比指纹双引擎提取碱基配对、蛋白接触、重复motif三类信号,并在三类基准上系统评测性能与速度。
核心数据 • 互作头每条序列仅需 79 毫秒,比加速版雅可比方法(1.5 小时)快约 5 个数量级,全基因组扫描从此可行 • 150 个细菌基因组全量扫描:单块 H100 跑 100 分钟,结果仅占 18.3 GB 存储 • RNA碱基配对基准上,互作头在 84% 以上的 Rfam 家族中超过所有对比方法,包括在有利条件下击败专门的RNA语言模型 RiNALMo • 57,787 个含≥2个相邻发夹的位点中,40,175 个(69.5%)在现有注释之外;更严格的≥4发夹标准下仍有 9,044 个位点,41.1% 未注释 |
发现一:给150个细菌基因组做"暗物质"普查
团队把150个基因组(覆盖人肠道菌群hCom2成员、致病菌和模式生物)切成重叠片段,用互作头逐个预测共进化图谱。已知元件的分布验证了方法的可靠性:CRISPR位点扛起最强的重复motif信号,rRNA扛起最强的碱基配对信号,tRNA区域两者皆高——和生物学常识完全对上。
真正有意思的是那些"四不像"区域:大量未注释基因间区的结构信号强度和已知ncRNA相当甚至更高。换句话说,细菌基因组里还有一大片结构化的非编码区域从未被命名,其中包括复杂的多发夹元件。团队挑了两类信号最突出的位点深挖:TwoAYGGAY结构化RNA和UG27逆转录酶系统。
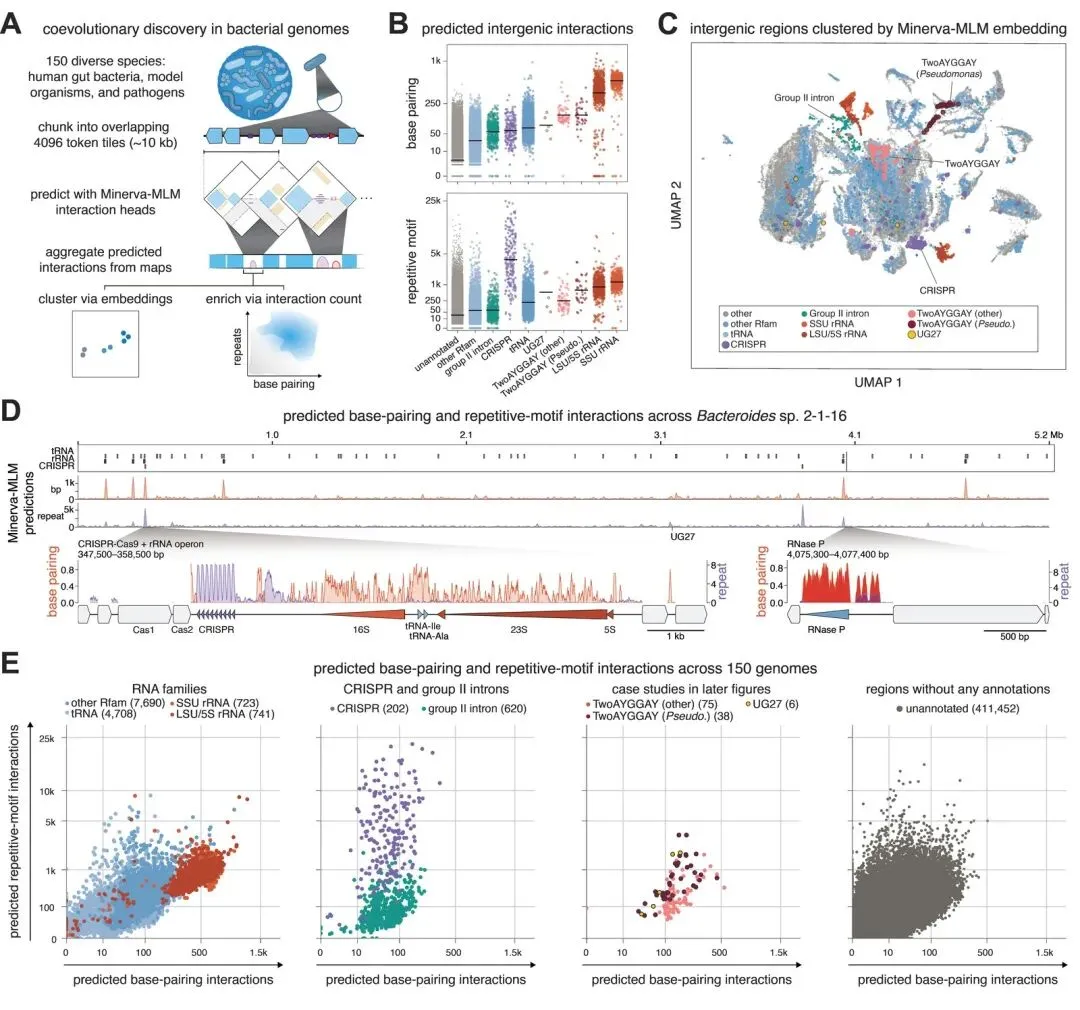
图3.基因组尺度共进化挖掘:150个细菌基因组的扫描流程、各类注释元件的信号富集、UMAP嵌入聚类,以及代表性基因组上rRNA、CRISPR等位点的信号轨道。红色点群即TwoAYGGAY等信号异常突出的未注释区域。
发现二:一个已知RNA家族被"加长"了
TwoAYGGAY是Rfam数据库里登记在册的结构化RNA家族(RF01731),经典结构是从共同基茎伸出的两个发夹,各带一个AYGGAY环。Minerva的预测却显示:在假单胞菌门里,这个家族普遍带着三个额外发夹、一根加长的基茎和一个3'端假结,上下游还拱卫着两类重复序列——5'端是5–6 nt的短重复阵列,3'端是100–200 nt的大重复。
用Minerva的预测迭代重建共变异模型后,团队在假单胞菌基因组数据库的1,324个菌株中扫出16,086个匹配(覆盖1,148个菌株),拷贝数中位数11–23,最高一株达到202个。更有意思的是,这些元件68.4%以"背对背"双联体形式出现,间距中位数仅249 bp——很像某种可移动元件的扩张方式。AYGGAY环此前被猜测是Csr/Rsm家族转录后调控因子的结合位点,额外发夹意味着这些RNA可能是多价"分子海绵"。
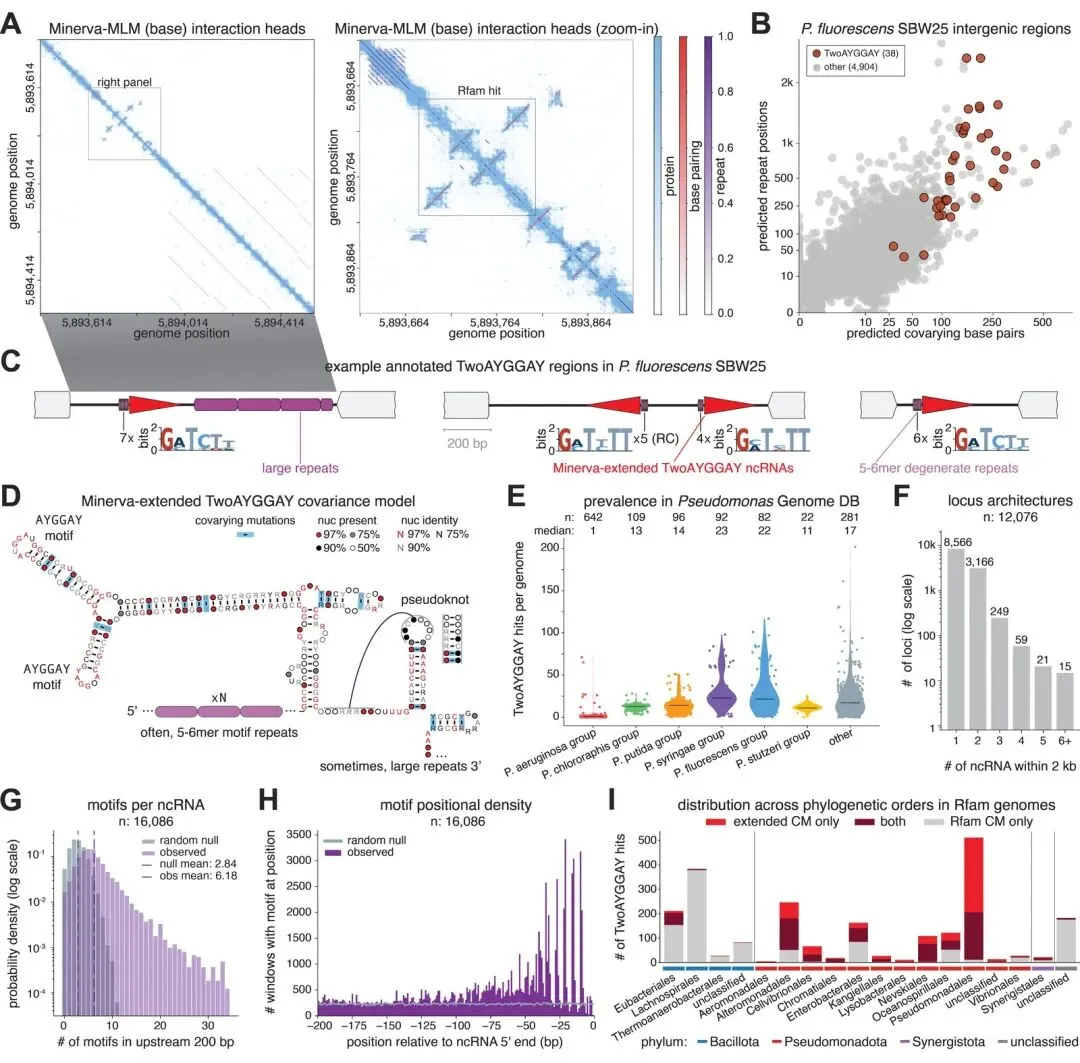
图4.TwoAYGGAY RNA的扩展结构:Minerva预测的碱基配对远超Rfam注释边界,揭示额外发夹、延长基茎与3'假结;上下游重复motif的排布及其在假单胞菌属中的广泛分布与拷贝数差异。
发现三:噬菌体里的"可变ncRNA阵列",实验证实了
UG27是一类"未知组"逆转录酶(Unknown Group 27 RT),其同类(如DRT2)此前被发现能用ncRNA模板生产奇怪的cDNA,参与抗噬菌体防御。Minerva扫描发现,UG27位点的基因间区有一串约150 nt为单位的相邻发夹+重复互作信号——像一排结构相同、序列各异的"车厢"。
这些单元序列差异大到传统比对根本对不齐(点阵图上一片空白),但微调后的Minerva(仅用10个位点、约60个单元,甚至rank-1的LoRA)恢复了每个单元基部的额外发夹和假结。在82,314个单元(14,118个去重位点)上,单元长度集中在149和167 nt两个峰。AlphaFold3进一步预测UG27的三个保守蛋白(RT、sORF、bORF)组装成一个复合体。
预测停在纸上不算完。团队把5个UG27系统克隆进大肠杆菌异源表达,做链特异性DNA测序:所有系统都产生50–100 nt的短cDNA,精确对应每个ncRNA单元的中央发夹;把RT活性位点从YSDD改成YSAA,或者删掉任一辅助蛋白,cDNA立刻消失。AI预测的结构边界,和实验测到的逆转录起止位点严丝合缝。
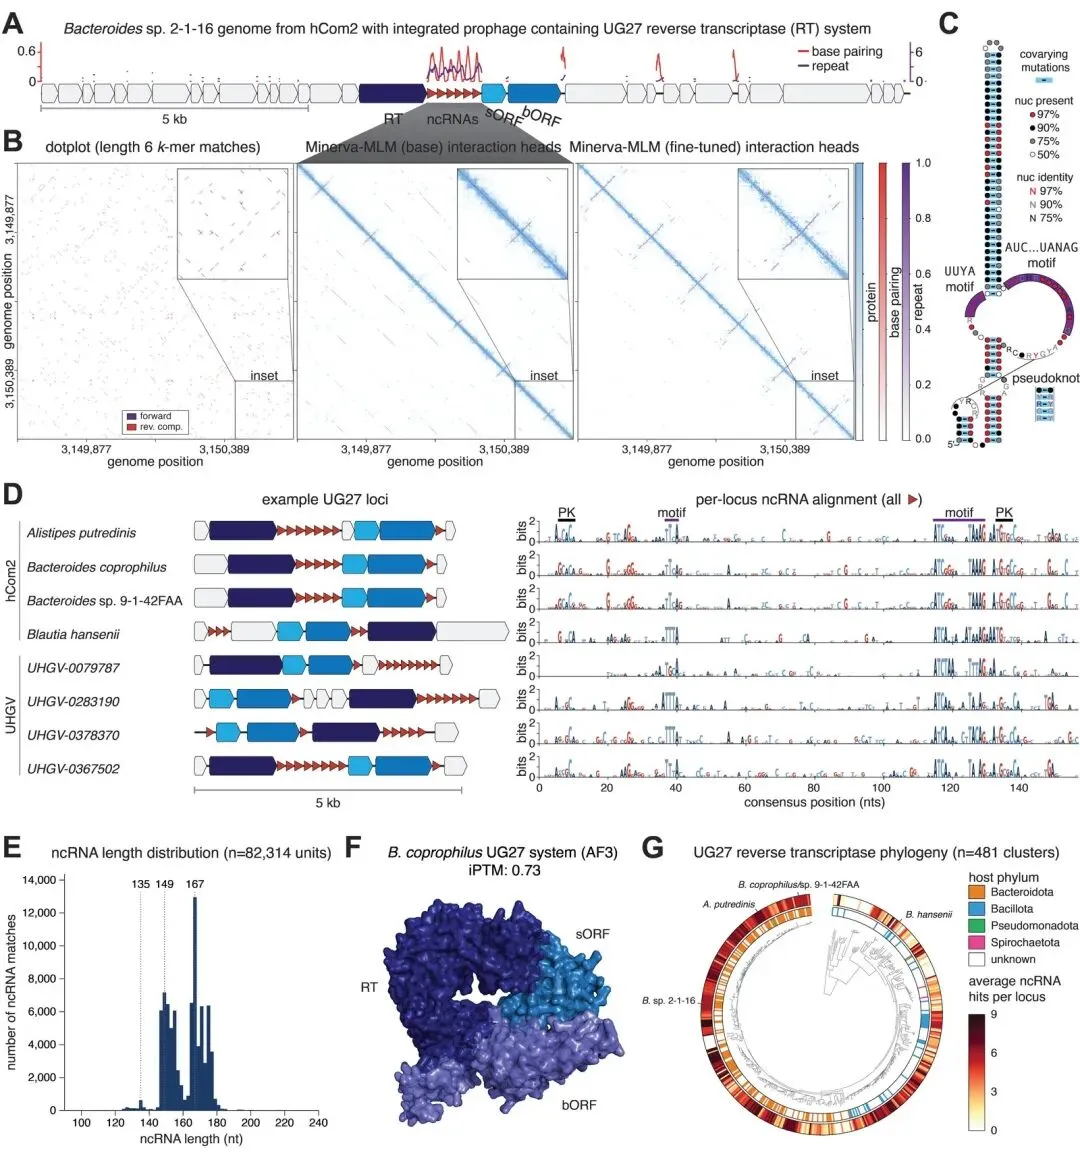
图5.UG27逆转录酶系统编码可变的ncRNA阵列:前噬菌体基因座环境、微调前后Minerva预测对比(点阵图几乎无信号)、ncRNA共变异模型、阵列单元的序列多样性与长度分布、AlphaFold3预测的三蛋白复合体及RT系统发育树。
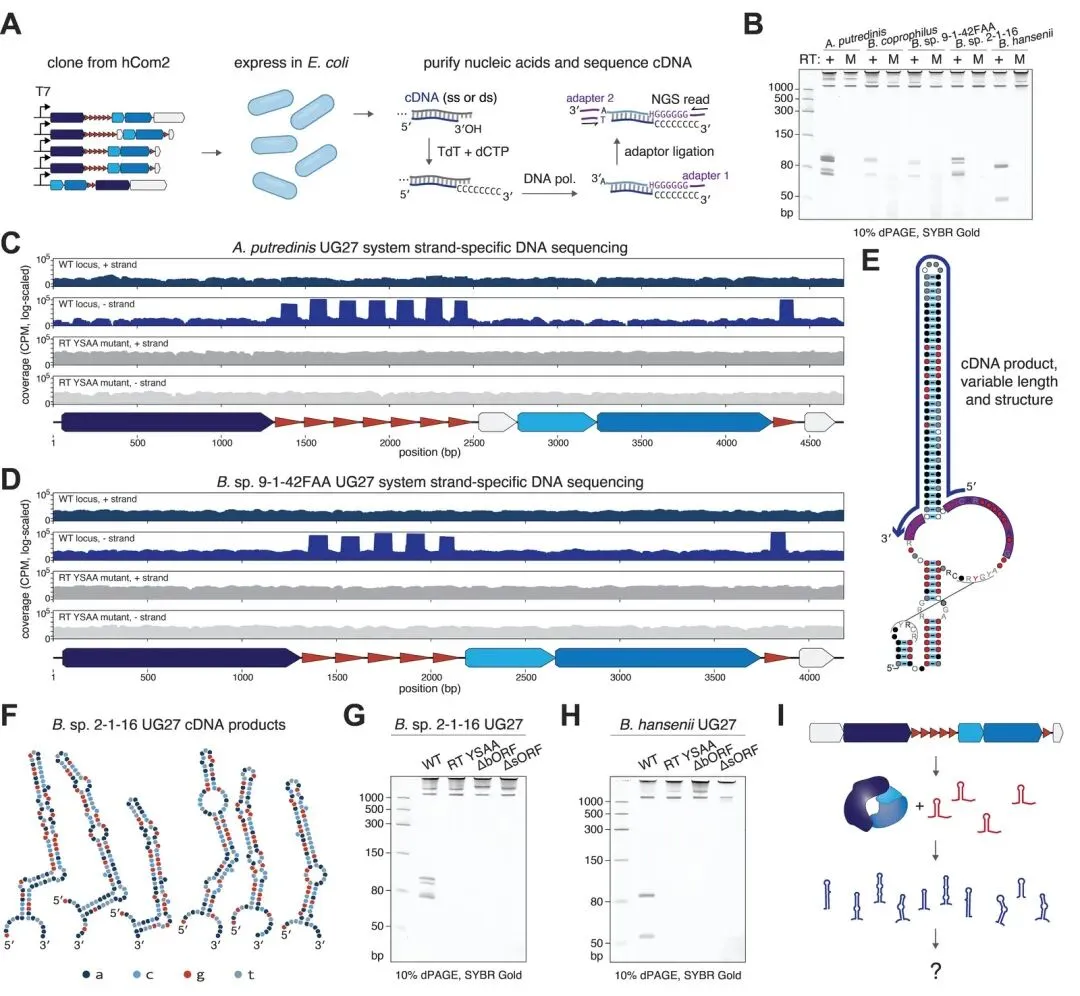
图6.实验验证:5个UG27系统在大肠杆菌中逆转录出50–100 nt短cDNA发夹,产物精确映射到ncRNA单元中央发夹;RT活性位点突变或删除辅助蛋白均废除cDNA合成。
为什么这项工作可信 • 不是纯计算推测:UG27的ncRNA阵列经过了异源表达+链特异性测序的湿实验验证,AI预测的发夹边界与cDNA实测端点一致 • 已知元件做"阳性对照":CRISPR、rRNA、tRNA、DRT2(有冷冻电镜结构)全部被准确找回,DRT2的隐藏ORF靠密码子周期性信号无监督浮现 • 微调策略务实:DRT2假结用200个位点、UG27用10个位点即可恢复,说明家族特异性微调门槛不高 |
附带的惊喜:模型自己学会了"数密码子"
在DRT2抗噬菌体系统的测试中,除了用13,034个同源位点微调后补上冷冻电镜结构里的假结,团队还发现互作图谱上出现了每三个核苷酸重复一次的节律——这正是密码子周期性的指纹。模型从没被教过这件事,却在DNA层面无监督地"看见"了开放阅读框。用这把尺子去量那些因注释错误被截短的蛋白编码区,延伸到的最近起始密码子后,有几个位点以100%一致性复原了RefSeq里的全长蛋白。
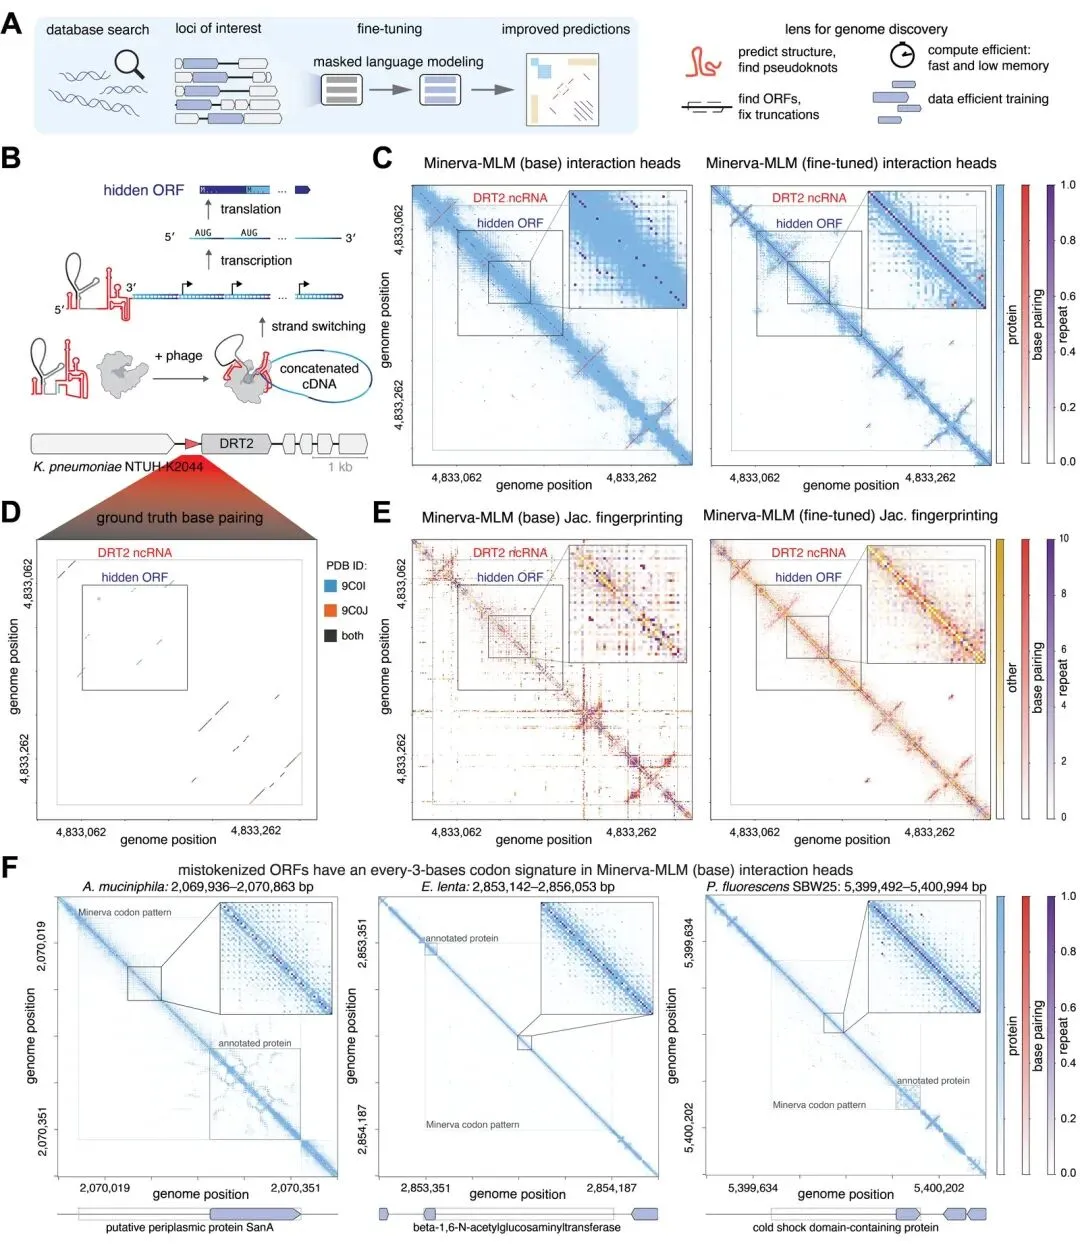
图2.家族特异性微调的效果:DRT2系统微调后恢复冷冻电镜结构中的假结;隐藏ORF上呈现每三核苷酸重复的密码子周期性信号,并可据此修正错误注释的蛋白编码区边界。
意义与展望
在笔者看来,这项工作的价值不在某一个新RNA,而在发现范式的切换:从"拿已知序列去钓鱼"变成"让模型直接读进化写下的批注"。CRISPR、retron、DRT这些系统的共同点是都先在序列模式上露出马脚——Minerva干的正是把"露马脚"这件事系统化、规模化,而且成本低到一块GPU一下午扫完150个基因组。
对药物发现和微生物组研究,三个方向值得跟踪:其一,UG27这类"序列可变、结构保守"的cDNA阵列天然是模块化、潜在可重编程的系统,它的cDNA产物功能虽未明,但逆转录酶+可变模板 RNA 的组合,正是当年retron走向基因组编辑工具(如precise editing供体)的路径;其二,TwoAYGGAY若以多价海绵身份调控Csr/Rsm通路,就是干预细菌毒力与生物被膜的潜在靶点;其三,每个基因组数百个未注释结构位点,本身就是一张待筛的功能元件清单。
也要冷静看待局限:4,096 token的上下文窗口够不着长程互作;蛋白接触预测仍逊于ESM-2等专用蛋白模型;RNA–蛋白互作基本还测不准;微调增强结构信号的同时会削弱重复与ORF信号,需要基础版与微调版对照使用。此外,扫描产出的是假说而非结论——TwoAYGGAY的扩展结构目前只有共进化与协变模型证据,尚无实验结构。作为预印本,本文尚未经同行评审,结论强度应相应打折。
一图总结 基因组语言模型Minerva不做比对、直接从序列读出碱基级共进化图谱:79毫秒一条序列、单卡100分钟扫完150个细菌基因组,发现近七成结构化非编码位点从未被注释,并实验证实噬菌体UG27系统把可变ncRNA阵列逆转录成短cDNA发夹——共进化挖掘正在成为同源性方法之外的第二套发现引擎。 |
本文由AI辅助翻译与整理,核心内容均依据原文,观点部分为作者解读,如有疏漏以原论文为准。
参考文献[1] Li DB, Brixi G, Kim AS, Fiamenghi MB, Driscoll CL, Evans SA, Gao A, Ivanova NN, Kyrpides NC, Deisseroth K, Wilkinson ME, Fischbach MA, Hie BL. Coevolutionary mining of prokaryotic non-coding elements with a genome language model. bioRxiv, 2026-09-24. DOI: https://doi.org/10.64898/2026.09.22.753630 |