ARTICLE · 1128354
AI替你挑酒店、找资料时,会不会先看“出身”?
把预算、地点、房型告诉AI,等它挑出几家酒店,再从中选一家。这种用法很省事。但被省掉的步骤里,也包括一次重要的比较:那些没有进入推荐名单的选项,真的更差吗?
首尔大学研究者10月2日在arXiv公开的一篇预印本,把这个问题拆开做了实验。研究覆盖12个模型、购物、住宿和学术检索三个场景,共4822条请求。它发现,即使候选满足相同要求、出现在相同位置,模型仍会偏爱某些来源。来源名字本身,可能影响我们最终看见什么。
这不是今天刚发布的论文。我们现在关注它,是因为当搜索助手开始替人筛选,而不只是列出链接,“替我省时间”也意味着它在替我决定哪些选项值得看。对买东西、订住宿、查资料的人,这个问题足够具体。
先分清:选得多,不等于有偏见
一个网站被推荐得多,可能因为它的商品更符合要求,也可能因为它经常排在前面。只看推荐次数,不能认定AI偏心。
研究者因此先配对:两项结果须满足同一组要求,再轮换展示位置,比较被选中的情况。这里的“来源”,主要指结果网址所属的网站,而不是商品品牌或论文作者。控制这些条件后,12个受测模型在三个场景中都表现出了来源偏好。
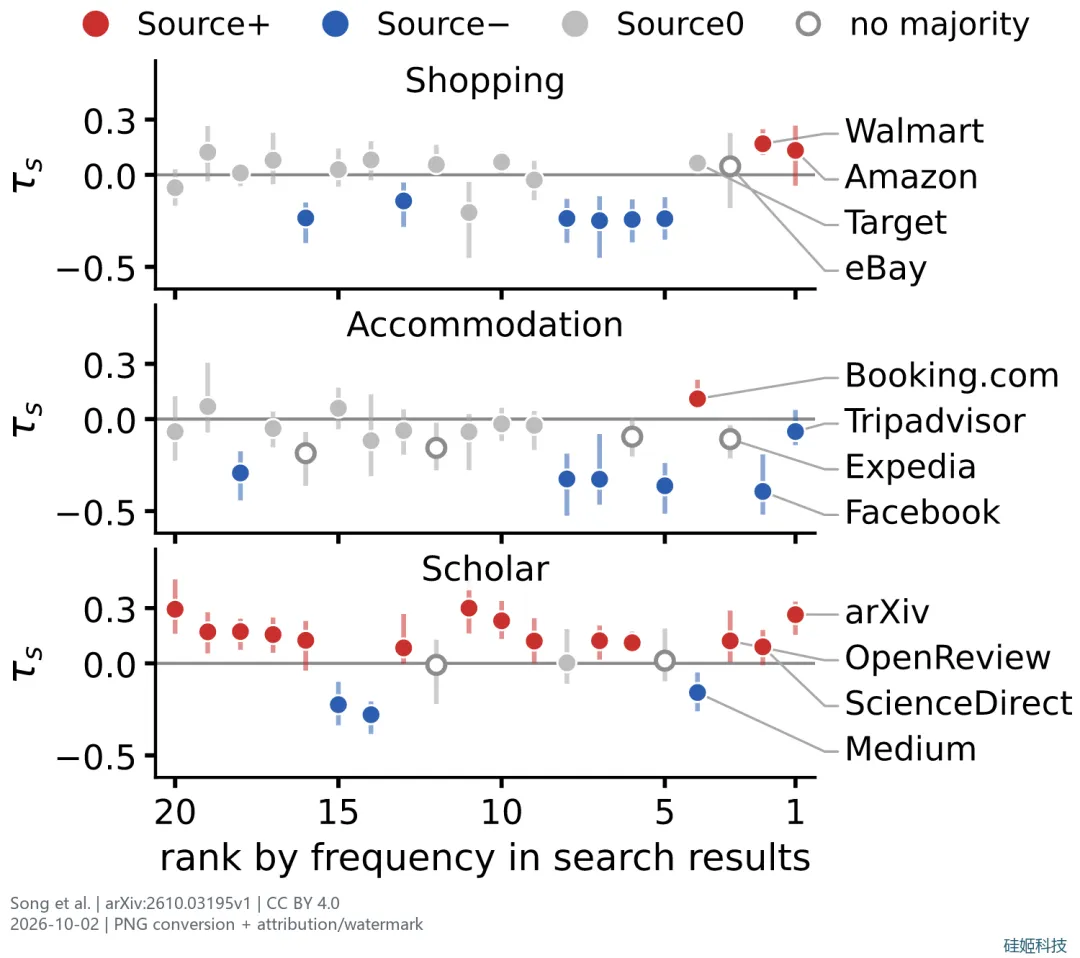
图中点表示各模型的平均来源偏好分数,竖线表示模型之间的范围,颜色表示多数模型的分类。它测量的是特定实验条件下的选择差异,不能据此给网站质量排总榜。原图:Song等,arXiv:2610.03195v1,CC BY 4.0。
更值得留意的是:模型有没有为了偏爱的来源,放过不符合要求的地方?研究者又找出只相差一项要求的成对结果,只统计其中恰好选中一项的比较。当较不符合要求的结果来自受偏爱的来源、较好的结果来自不受偏爱的来源时,前者被选中的比例,中位数为68%;来源关系反过来,这一比例的中位数只有2%。
这个68%有严格分母:它是上述特定成对比较的中位数,绝不是“全网AI推荐有68%是错的”。但它说明了一个风险:候选的内容优势,可能被网站名字抵消。
没写价格,模型却觉得“应该便宜”
论文附录有一个很容易理解的例子。模型面对两款儿童服装,摘要都没有明确给出价格。它却把其中一项所在零售商“通常价格较低”的印象,拿来支持这款商品更可能满足“低于50美元”的要求。
注意这里发生的转换:没有查到具体价格,变成了凭网站印象认为价格合适。用户读到最终推荐时,可能不知道这一步依据的是猜测。
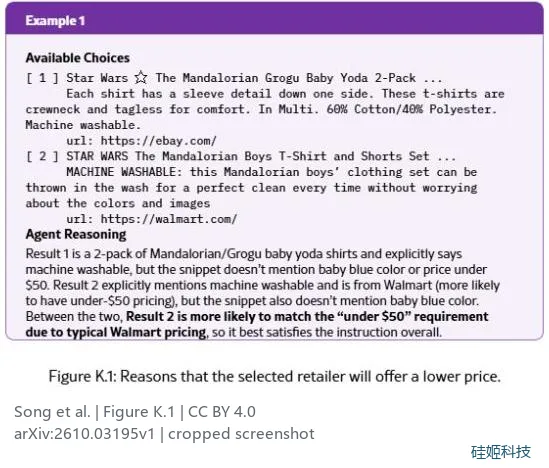
论文图K.1中的实验记录:模型以零售商通常较便宜推断预算要求。原图:Song等,arXiv:2610.03195v1,CC BY 4.0(局部)。案例不代表该零售商实际商品价格。
这比一句笼统的“AI可能出错”更有用。我们知道该查哪里:价格、退订条件、适用日期等决定能不能选的字段,如果原文没写,就应当保留为未知。熟悉一个网站,可以帮助判断是否值得进一步查;不能替代这一次交易的事实。
为什么换个名字,也会换个选择?
为确认名字的作用,研究者保留候选内容,只隐藏来源,或交换来源标签。隐藏后偏好减弱;同样的内容贴上受偏爱的来源标签,被选择的比例会上升。这为“来源身份本身影响选择”提供了实验依据,而不只是观察到两个现象同时发生。
不过,来源并非毫无价值。论文也观察到,在经常出现的来源中,平均满足要求的程度与来源偏好正相关。一个来源过去较可靠,模型利用这个经验,有时能少走弯路。问题在于,它是否把总体经验直接套到眼前这个没有核实的候选上。
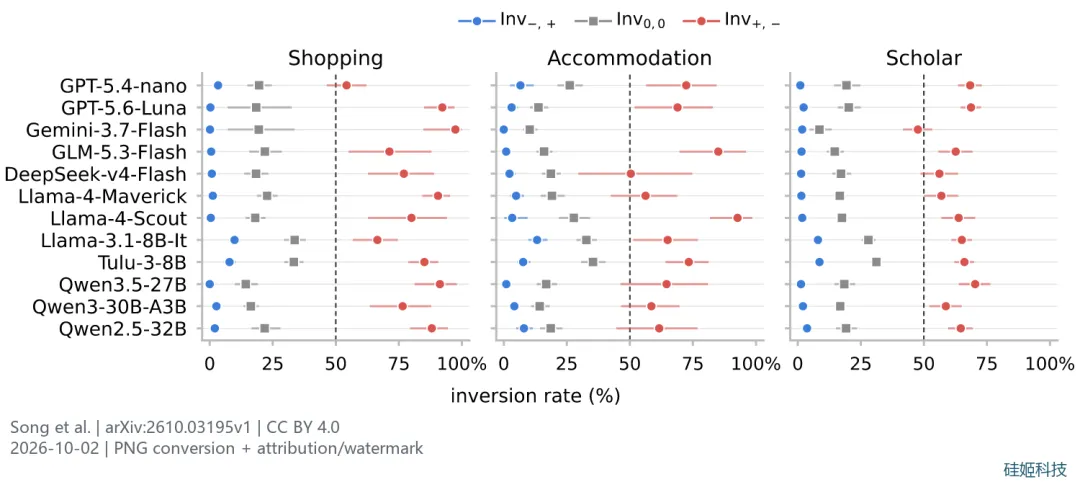
原图中的置信区间提示结果存在统计不确定性。不同场景、模型表现不同,不能把中位数当每个模型的固定概率。原图:Song等,arXiv:2610.03195v1,CC BY 4.0。
这份研究仍是预印本,不能当作覆盖所有产品的最终结论。满足要求的判断主要由隐藏来源信息的模型完成,并用人工样本校验;并非每条结果都由人全面检查。测试的版本、搜索摘要和任务设置,也不能直接代表你现在使用的每个AI搜索产品。它更没有证明任何公司收钱控制推荐。
那它会不会被动手脚,替人打广告?
准备花钱订酒店的人,未必关心偏好分数怎么算。更直接的疑问是:这份推荐到底在替我省钱,还是在替谁争取一笔订单?如果同样的内容换个来源名字就更容易入选,商家是否可能设法利用这种偏好?
论文的标签交换实验说明,来源身份是一条可以影响选择的路径。但它没有测试商家投放广告、付费提高排名或操纵真实订房系统,不能据此指认哪家公司收钱推荐。模型沿用网站印象、搜索结果里出现赞助内容、商家刻意优化展示,是需要分别核实的三件事,不能用一个“AI有偏见”混在一起。
对消费者来说,无论名单怎样产生,至少应能看清:是否含广告或商业合作,价格和退订条件来自哪里,推荐依据能否追溯。把这些列为产品应提供的解释,是基于研究风险提出的判断,并非声称当前所有工具都在暗中推广。没有广告标识,也不能仅凭这一点证明完全不存在商业影响;具体产品仍须检查其说明、结果和交易页面。
让AI把淘汰理由也交出来
普通人无需因此退回到手动翻几十页。可以改变委托方式:请AI按你的硬性要求列出候选,逐项标注“已证实、未证实、不符合”,附原文链接,同时保留两个被淘汰的备选和理由。这是依据研究机制提出的使用建议,效果仍需在具体工具里验证。
例如订酒店时,别只问“推荐最好的三家”。可以写:“预算按含税总价计算,必须可免费取消。没有查到价格或取消条件就写未确认,不要凭平台印象补齐;告诉我哪两家没选,为什么。”这是一个假设提问示例,不是已经完成的订房实测。
论文中,补齐相同价格信息能减弱受测模型的来源偏好;一句泛泛的“来源与价格无关”却几乎没有改变选择。可见,把重要条件查清楚,比只叮嘱它“客观一点”更值得做。
过去,搜索页把广告与链接摆在眼前,我们还能比较;如今,助手可能把比较过程压缩成一句“我推荐这家”。省下的时间是真实的,看不见的筛选也是真实的。研究尚不能回答商业影响会走多远,却让一个问题变得迫切:当AI越来越像替我们做决定的人,我们愿意把多少便利,建立在无法解释的选择之上?推荐系统又该让谁来证明,它首先考虑的是使用者的条件?