ARTICLE · 1131130
我的桌面上住了个会盯着你的 AI 助手,附开发提示词
同事凑过来看屏幕,盯了三秒,说了一句:你这壁纸挺高级啊。我还没答,他接着问:那你刚才是跟它说话吗?
他以为我换了个 4K 动态壁纸。实际上那是跑在电脑上的3D 虚拟人,是“活”的:鼠标划过去,她的眼睛会跟着你转;喊一声名字她会应;说话的时候,她的嘴型会一帧一帧照着声音动。
有意思的地方不在"她像不像人",而在于——她就站在桌面上,却没挡住桌面。
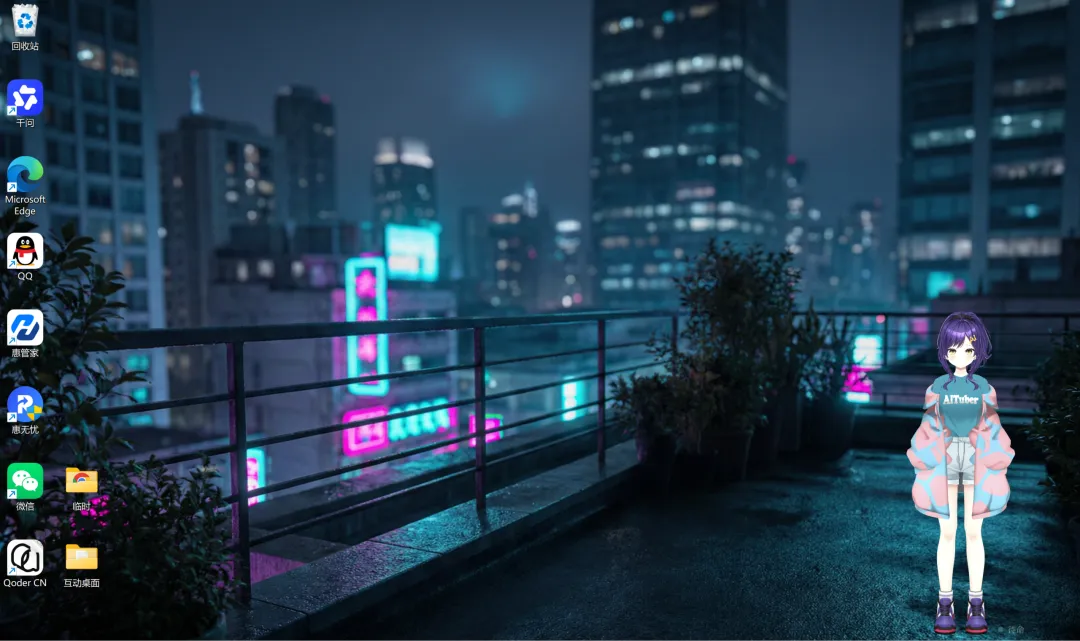
她不是壁纸,是一块「会看你的玻璃」
动态壁纸也能动,但它是铺满整块屏幕的一整张图,图标压在图上,点不动。她不是图。
她更像是浮在桌面上的一小块透明玻璃:玻璃上只"印"了一个人,玻璃以外的区域,鼠标点击全部穿过去,落到桌面。
语音对话:一条能单独换零件的链路
能聊天这件事,最容易高估。很多人以为接一个大模型就完事了,跑起来才发现:识别听不懂、嘴型对不上、说两句就断。
拆开看其实很直白,是一条四节链路:
耳朵(语音识别,听你在说啥) → 大脑(大模型,想怎么回) → 嗓子(语音合成,把回话念出来) → 说(口型,跟着声音一帧帧对齐)。
预设动作不够,就现场拼一个
她会转头、点头、挥手、鞠躬、转圈、跳舞、蹲下、鼓掌——内置预设动作一共 19 个。
但对照着玩久了,问题就冒出来了:动作表里没有的那句话怎么办?硬演一个像的,比不演更假。
所以多了一层判断——表里有,就按表演;表里没有,她会去拆句拼动作:把你的话拆成几个动作片段,重新组合成一个新动作。拼不出来的,就老实回话,不硬演。
她会记住你,但记的不是聊天记录
"有记忆"这三个字已经被说烂了。她这里记的是另一回事:不存你们聊了什么,而是把关于你本人的事挑出来写进去——职业、作息、喜好、正在忙的事。
差别在哪?聊天记录是流水,存着存着又贵又没用;挑出来的是"事实"。下次不用你重新自我介绍一遍,她记得你周三要交方案、你早高峰不想被打扰。
她能调工具,还能自己试新工具
自带三个基础技能:时间、天气、网页搜索。直接问就行,不用先下指令。
往上还留了一个口子— MCP。
这条决定了她以后能长多大——工具是接进来的,不是一开始就写死在代码里的。
脑子可以换:本机模型还是云端,自己挑
她的识别、大脑、嗓子三处,都在设置里能换,本机和云端都行,填过的配置一键切回。
本地跑的好处是完全不依赖网络;云端跑的好处是脑子更灵。
形象本身也能换,不喜欢就换个 3D 虚拟形象。名字同样随时改,改完后记忆要重新写。
附:开发提示词,可以参考修改
这条是折腾完之后提炼出来的整体需求,想自己跑一个的,可以参考:
帮我做一个 Windows 桌面互动的 3D 虚拟人物,跑在我这台电脑上,人物形象可以更换。她只占人像那么大一块,身体以外的点击全穿到桌面,指针落到她身上才收回,图标和任务栏照常能用;背景用系统壁纸。可拖她、滚轮缩放、双击开聊天窗,脚边小牌显示她的状态。她听得见我、能被我打断,喊她名字才应。名字我随时能改,改后凡同音的写法都要认得。她说话要有口型、眨眼、呼吸,眼睛跟鼠标走;会转头、点头、挥手、鞠躬、转圈、跳舞、蹲下、鼓掌。我点名要动作她就演,表里没有的也得现场拼,拼不像就只回话。她的AI大模型、识别、嗓子都能在设置里换,本机和云端都行,填过的配置一键切回。她要有记忆,按名字各存一本。她要有连接 MCP 的功能。桌面 AI 难的不是模型,是让它待在一个不属于它的地方,还不碍事。模型再灵,窗口一挡,桌面就废了;点击一穿透、呼吸一补上,"活着"的感觉就来了。
这篇算是我踩完坑整理出来的笔记,功能描述以实际跑得起来的版本为准。好了,就讲到这了,我们下期再见。