ARTICLE · 1133480
第2篇模型会换、工具会升级,团队 AI 编程真正该搭的七层底座
开篇先说立场:我是 AI 编程的重度用户,也坚定看好 Vibe Coding 这波浪潮。 这个系列不唱衰、不泼冷水,只解决一件事——怎么让团队把 AI 编程的红利真正拿到手。这一篇,讲的是我给团队搭的那套“既能放开用、又不出乱子”的七层架构。
一、为什么你买了一堆 AI 工具,团队还是乱
上一篇我讲了一个观点:只图快、不管控,最后都是返工。文章发出来没几天,Anthropic 就用一组数据替我把这件事又敲了一遍警钟——他们 80% 的代码已经是 Claude 写的,工程师人均交付量涨了 8 倍,可测试涨了 10 倍、CI 任务量半年涨了 25 倍。你看,代码写得越快,下面那套检查、集成、治理的体系崩得越狠。很多朋友看完上一篇来问我:道理我懂了,那到底该怎么管?总不能靠喊口号、靠大家自觉吧。
当然不能。我先问你几个问题,你对照一下自己团队:
公司买了三四种 AI 编码工具,各用各的,谁也不知道别人在用什么;
提示词、规则全存在每个人自己电脑里,骨干一离职,经验跟着走;
哪天换个模型、涨个价、或者某个工具不能用了,团队直接抓瞎,好多东西得重来;
AI 改了哪些代码、谁审的、合没合进主干,一笔糊涂账。
如果中了两条以上,那问题不在工具,在架构——你缺一个把这些工具、能力、规则、数据统管起来的底座。
我做了近 20 年架构,有个根深蒂固的习惯:凡是会重复发生、会规模化、会长期存在的事情,就绝不能靠"人盯人"和"临时发挥",必须用一套分层清晰的架构把它兜住。当年我在M 公司接手的系统,就是各个团队各搞各的,重复架构一大堆,后来做分层重构、整合重复建设,一年省下超百万。省下来的钱从哪来?很大一块就是"分层解耦、各层各司其职、不重复造轮子"。
AI 编码也是一模一样的道理。这一篇,我把这些年带团队、做平台、搞治理沉淀下来的思路,整理成一套七层架构。你不用照抄,但理解了这七层,你就有了一张自己的施工图。
二、先讲两个贯穿全局的原则
在拆七层之前,有两个原则是地基,七层全都建立在这两个原则之上,必须先说清楚。
原则一:工具无关性(Tool-agnostic)。
AI 这个领域,工具迭代快到你无法想象。今天这个模型最强,明天那个工具免费,后天政策一变又得换。如果你的核心能力——规则、知识、流程、组件——全都绑死在某一个工具上,那你就是在给工具商打工,每换一次工具就脱一层皮。
正确的做法是:工具只是可替换的"手脚",真正值钱的能力要沉淀在你自己掌控的中间层里。工具随便换,底座不动摇。
这事我有切身体会。我在一家头部门户Y 公司参与过开源流处理平台的架构升级,也主导、参与过好几个平台级系统的换代。架构做得好的系统,换底层组件是"插拔";架构做得差的系统,换个组件是"伤筋动骨、重写一遍"。差别就在有没有解耦。
这个原则这周刚被行业亲自验证了一把。9 月 18 日,Claude Code 终于认了 AGENTS.md 这个文件——在此之前 Codex、Cursor、Copilot 早就支持了,它是最后一个跟进的。这意味着什么?你在项目根目录写一份规则文件,所有主流编码 Agent 都能读,不用再给每个工具抄一遍规则。这件事在 Hacker News 上拿了 675 分,开发者圈憋太久了。你看,工具无关性不是某个人的洁癖,是整个行业正在往这个方向收敛——规则沉淀在你自己仓库里,工具随便换,底座不动。
原则二:Git 是唯一事实来源(Single Source of Record)。
不管 AI 生成了多少代码、提了多少建议,最终唯一算数的,是合进代码仓库、经过评审、打上提交记录的那份代码。AI 的对话记录、生成过程、中间产物,都不算数。
这一条解决的是"责任"问题。我当年在 Y 公司做老版首页个性化推荐平台的时候,当过 Release Manager,要协调好几个研发组、保证大平台持续迭代上线。那种规模下,如果没有"唯一事实来源"、没有清晰的提交和负责人,根本没法协作,出了问题连谁改的都查不到。
AI 时代更要如此:每一行合进仓库的 AI 代码,都必须有明确的人类责任人。Git 提交记录就是责任链。这条守住了,"AI 写的、跟我没关系"这种甩锅就没了土壤。
三、七层架构,从上往下拆
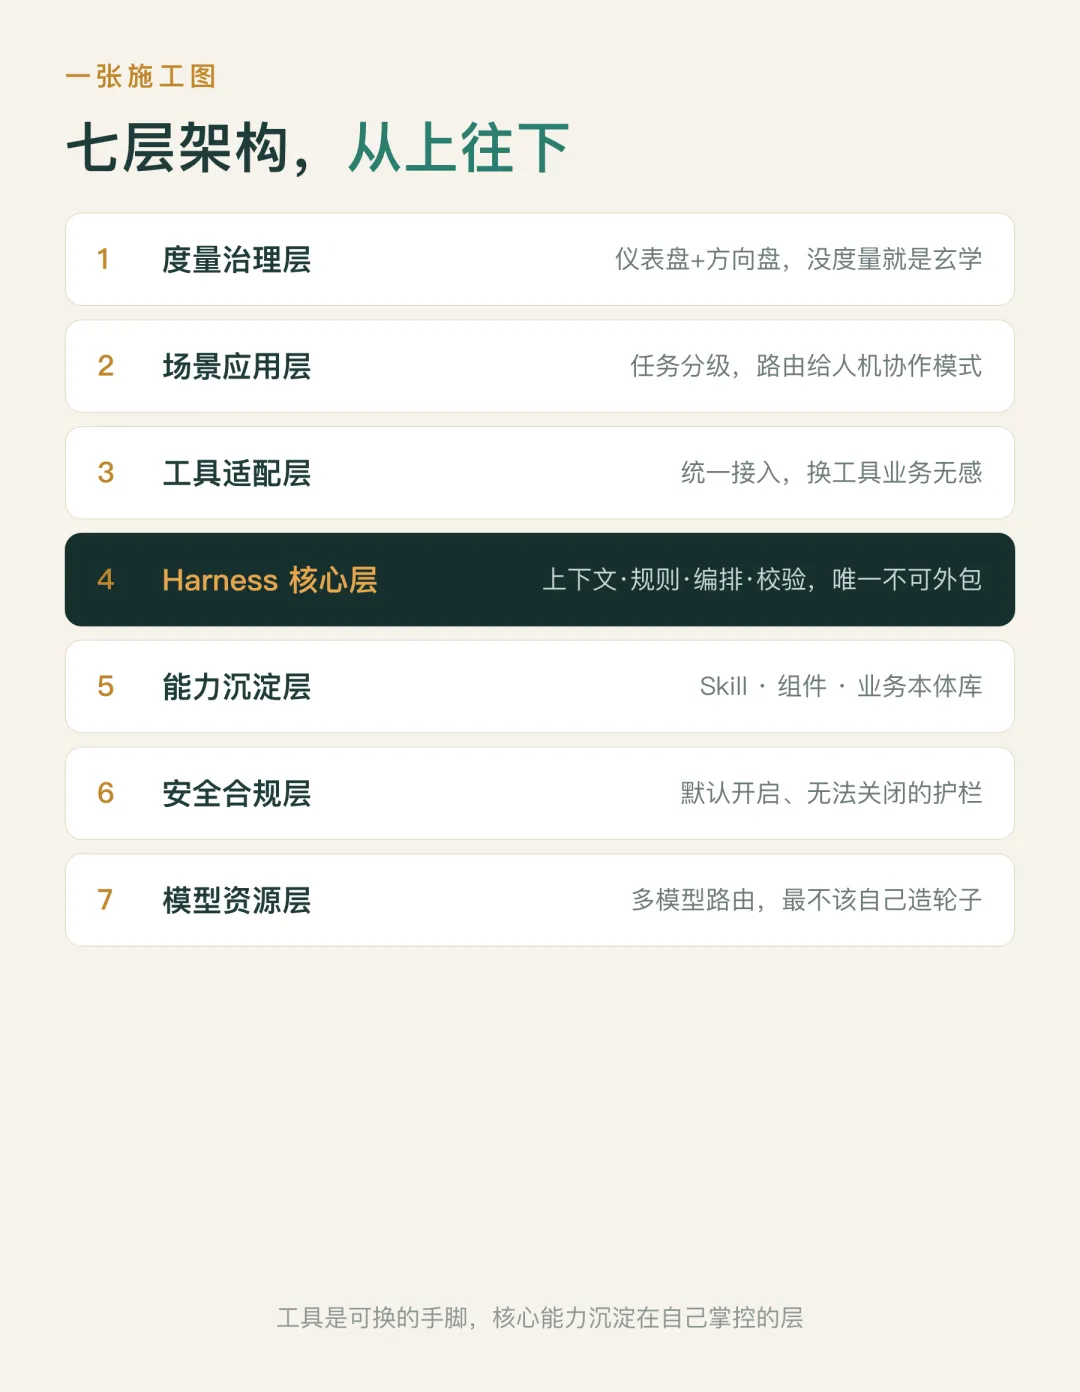
好,地基讲完,上七层。我按"从业务到资源、从看得见的到看不见的"顺序来讲,你在脑子里想象一栋楼:最上面是看得见的管理动作,最下面是算力和模型。
第 1 层:度量治理层——你得先知道到底有没有提效。
这是最顶层,也是绝大多数团队完全没有的一层。AI 用得到底好不好,不能靠拍脑袋、靠"感觉快了"。你需要度量:采纳率、缺陷率、返工率、评审通过率、需求交付周期、线上事故数,以及最终的人效和成本。
我在 M 公司做内容化推荐时,团队上了千人千面的个性化推荐,效果好不好不是谁说了算,是拿"用户停留时长提升 XX%"这种硬指标说话的。任何改进,没有度量就是玄学。度量治理层还负责定规矩、做审计、跑反馈闭环,它是整个体系的"仪表盘 + 方向盘"。
第 2 层:场景应用层——什么活该让 AI 干、干到什么程度。
不是所有任务都一个待遇。这一层把研发工作按"风险高低、重复程度、复杂度"分类分级:哪些可以让 AI 全自动,哪些要人审设计,哪些必须人主导、AI 只打辅助。这就是我后面要专门讲的"分级管控"。这一层的本质,是把任务精准地路由给最合适的"人机协作模式"。
第 3 层:工具适配层——把五花八门的工具管起来。
IDE 插件、各类编码助手、Agent、命令行工具……这一层负责统一接入、统一鉴权、统一配置,对上屏蔽工具差异。上面的层不用关心底下用的是哪个工具,换工具只在这一层动,业务无感。这就是"工具无关性"落地的地方。
第 4 层:Harness 核心层——整套体系的大脑,也是你最该投入的一层。
Harness,直译是"马具、缰绳",我更愿意叫它"AI 编码的工程化底座"。它管的是怎么驾驭 AI:上下文怎么组织、规则怎么注入、任务怎么拆解、流程怎么编排、生成结果怎么校验、出了问题怎么回滚。
这一层是整个七层里唯一不可外包、不可让渡、必须自己掌握的一层。为什么?因为它装的是你团队的规矩和协作方式。我当年在 Y 公司主导一站式机器学习平台时,最深的体会就是:光有模型没用,真正让反作弊能力在整个安全部门铺开的,是那个覆盖"训练—测试—发布—回滚"全流程的平台。模型人人都能调,平台和工程体系才是壁垒。今天也一样,模型是别人的,Harness 是你自己的。
这件事这周又被大厂用钱投票了。9 月 17 日 Anthropic 发布了 Claude Code Projects,把 Harness 这一层直接做成了产品:你描述一个目标,它自动拆任务、开多个云端并行线程去推进,线程之间共享记忆和文件,关了笔记本线程还在跑,手机上也能干预。注意看它做的事——协调者、并行调度、状态持久化、制品共享——全是Harness 核心层该干的活。这说明什么?"Harness 不是工具,是工程体系"这句话,头部厂商已经用产品形态验证了。但厂商给你的 Harness 是通用的,你团队的规矩、红线、协作方式,还得自己往里填——这一层你让不出去。
这一层的价值,9 月中旬微软交的一份"满分答卷"最能说明问题。微软用 AI agent 把 GitHub Copilot 的运行时从 TypeScript 全量重写成了 Rust——约 43 万行 TypeScript 变成 83 万行 Rust,吞吐提升约 16 倍,花在模型 token 上的钱才 12 万美元。听着是不是"AI 一键封神"?但你看它怎么干成的:整整14.5 周、拆成 135 个版本、平均每天 1.3 个移植 PR、分模块逐步迁移,人类工程师前后投入约三周,过程中冒出几十处回归,全靠人一道一道审,微软自己还特意补了一句"这不代表所有 TypeScript 项目都该这么干"。你品品——即便是微软这种顶配团队、顶配模型,也不是放开了让 agent 自己跑,而是靠一套工程节奏、分阶段、随时可回滚,才把"快"变成了真成果。这套节奏,就是我上面说的 Harness 核心层。没有这层,那 16 倍性能根本落不了地,只会变成一次事故。
第 5 层:能力沉淀层——把团队的经验变成可复用的资产。
这一层专门沉淀三类东西:可复用的Skill(原子化能力)、组件/代码模板、以及最关键的——业务知识本体库。
为什么单独强调"业务本体库"?你团队里那些业务概念、数据口径、领域规则、系统依赖关系,过去散落在文档里、老员工脑子里。把它们结构化地沉淀下来,AI 才能真正"懂你的业务",而不是每次都靠你复制粘贴喂上下文。今天你在研发团队里沉淀的规则和业务本体,表面上是服务 AI 编码,往远了看,它就是未来整个企业做 AI 转型、做企业级知识智能的最小单元和地基。这个伏笔我先埋在这儿,后面讲 MCP 和 Skill 还会展开。
第 6 层:安全合规层——横向贯穿所有层的护栏。
数据脱敏、敏感信息拦截、访问权限、操作审计、漏洞扫描、合规留痕,这些能力不是某一层的事,是像安全带一样贯穿每一层的。AI 生成的代码要过安全扫描,喂给模型的数据要先脱敏,所有操作要可审计。我做过开放银行和智慧医疗,对这种"护栏先行"的体系有本能式的重视。这一层第 4 篇专门讲,这里先记住一句话:安全合规不是某一个模块,是一种默认开启、无法关闭的底层属性。
第 7 层:模型资源层——最底下的算力与模型供给。
最底层是各类基础模型、私有部署模型、算力资源、以及多模型智能路由(什么任务用什么模型,又快又省)。这一层变化最快、也最不该自己重复造轮子。你的精力不该花在"自己训个大模型"上,而应该花在上面那几层——尤其是 Harness 和能力沉淀层。
多说一句这一层的不稳定性:GitHub 已经宣布 10 月 19 日要退役一批 Copilot 的旧模型,Claude Code 的版本这一周就连着更了五六个。模型层就是这么个节奏,半年一换。如果你团队的规则、Skill、业务知识全绑死在某一个模型版本的特定 prompt 格式上,半年后就是一笔技术债。这反过来再次证明了上面那句:核心能力必须沉淀在你自己掌控的层,模型只是可替换的"手脚"。
四、七层怎么协同:一次 AI 编码请求的完整旅程
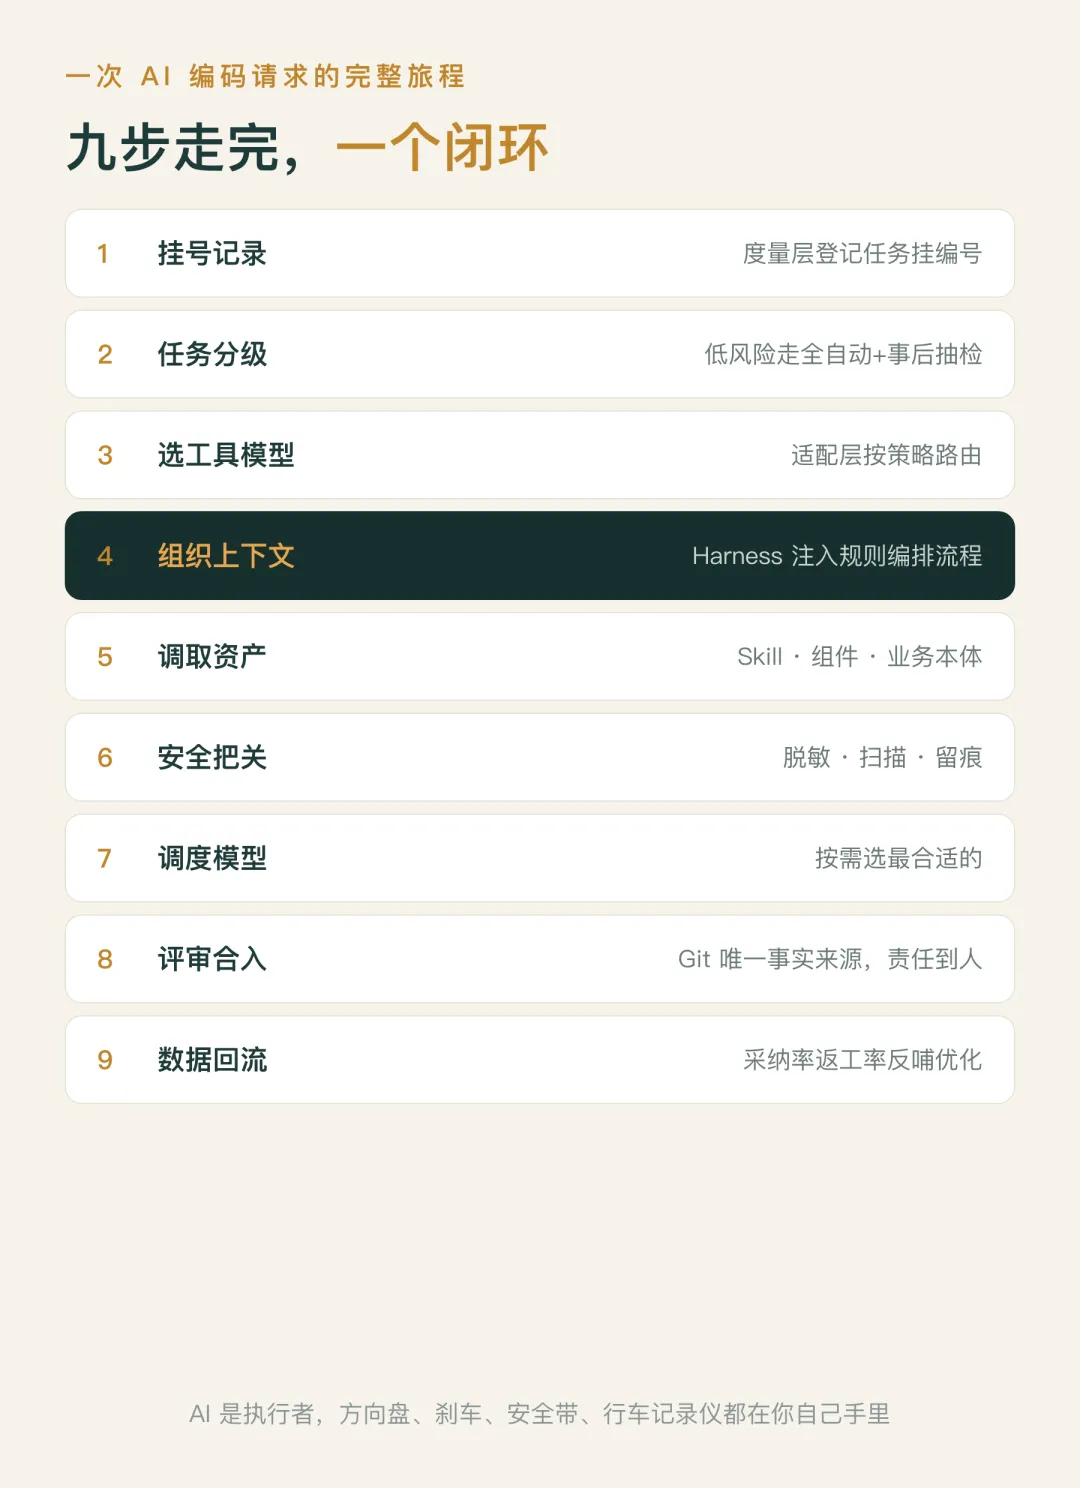
讲完七层,我带你走一遍,你就彻底通了。
一个工程师接到需求:
度量治理层
先记录这个任务、挂上编号;
场景应用层
判断任务分级——比如是低风险的重复代码,走"AI 全自动 + 事后抽检";
请求到工具适配层,按策略选好工具和模型;
Harness 核心层
自动组织上下文、注入对应规则、编排生成流程;
生成过程中,从能力沉淀层调取相关 Skill、组件和业务本体;
全程由安全合规层把关:敏感数据先脱敏、生成代码过漏洞扫描、操作全留痕;
底层由模型资源层按需调度最合适的模型;
生成结果经分级评审后合入 Git——Git 成为唯一事实来源,责任落到人;
最后度量治理层回收这次的数据:采纳了吗、有缺陷吗、返工了吗,反哺规则和流程持续优化。
你看,这就是一个闭环。AI 在里面是强大的执行者,但方向盘、刹车、安全带、行车记录仪,全都在你自己手里。
五、给不同阶段团队的落地建议
这套七层看着唬人,你不用第一天就全建起来,那是大公司的玩法。我给你一个务实的顺序:
小团队 / 刚起步
先守住两条原则(Git 唯一事实来源、明确责任人),再补第 4 层里最基础的"统一规则 + 上下文模板"和第 6 层的"敏感信息红线",就能避开 80% 的坑。
中型团队 / 已经在用
重点建第 2 层分级管控和第 5 层能力沉淀,把散落在个人手里的规则、Skill 收上来,变成团队资产。
大型团队 / 规模化推广
再上第 1 层完整度量、第 3 层统一工具网关、第 7 层多模型路由,追求精细化和成本最优。
顺序千万别反了。我见过太多团队,度量、治理啥都没有,先花钱上了一堆工具和模型,等于还没装方向盘和刹车,先把发动机踩到了最大马力。
这一篇我给你的是全景图,七层每层只讲了个大概。有读者可能会问:每层到底怎么搭?别急,主线九篇发完之后,我会做一系列番外篇,把最关键、也最容易卡住的四层——度量治理层、Harness 核心层、能力沉淀层、安全合规层——单独拆开,每层给你具体的搭建步骤、踩坑清单和最小起步动作。你先把全景图装进脑子里,施工手册在后面等你。
这套七层不用一天建完,先守住"Git 唯一事实来源 + 敏感信息红线"两条,就避开了 80% 的坑。
下一篇,解决最让管理者头疼的那个矛盾:《分级管控才是核心:AI 编码不是全放开,也不是全管死》。