ARTICLE · 1135360
还是那个问题,AI 到底会不会数数?
它不靠谱,是因为每次答得都不一样?
它数错的时候,错得特别稳
稳到你以为它是对的
6 道题 · 各跑 10 次 · 306 次调用
程序员犬余
📦 8 Parts + Conclusion
👉 滑动
PART 01
8 个答案
同一句话
PART 02
五道一字不差
十次连标点都同
PART 03
换个问法翻面
同一串字符
PART 04
它看到的切块
token 边界
PART 05
两个办法都没用
摆整齐、调温度
PART 06
稳到像是对的
四十次只有一个 3
PART 07
那个检查漏在哪
两处漏判
PART 08
数交回脚本
三步做法
PART ///
写在最后
边界在哪
不跟它争会不会,只问这件事该归谁做
凡是脚本能算出来的量,别让它报,让它把东西原样交出来
01
PART
同一句话,它给了 8 个答案
TEST · 现场
我让模型数一句话里有多少个汉字,同一句话发过去 10 次。它给了 8 个不同的答案,22、23、24、25、26、28、29、30。标准答案是 24,10 次里只对了 2 次。
写这个脚本,是因为我手上越来越多的事要模型报一个数。这段日志里有几条错误、这份清单漏了哪几项、这个月的开销加起来多少。数出来得快,可我拿它没办法。它报一个数,我手上没有另一个数可以跟它比。
「AI 到底会不会数数」,这个问题在网上传了很多年。常见的回答是它不会数,只是从训练数据里背过。这句话我信,但它给不了能用的东西,哪一类题它会错、错成什么样、有没有办法绕开,全都答不上来。
所以我换了个问法。不问它会不会,问这个动作能不能不从它手里过。凡是能由一段脚本算出来的量,就别让它报,让它把东西原样交出来,脚本自己数。我把同一批题跑了十来遍,看这个换法管不管用。
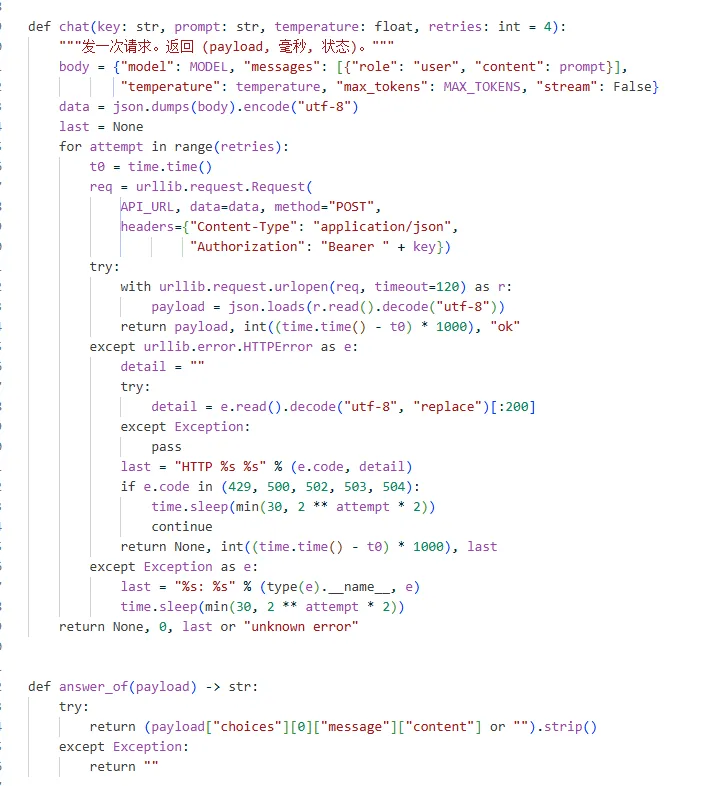
— 发请求的那段代码:直发 POST,带重试与退避,把回答原文取出来
02
PART
六道题,五道一个字都没差
CONSISTENCY · 一致性
先说一个和我预想相反的结果。我拿 6 道有确定答案的题各跑 10 次,一道四步算数、一道单价换算、两道从选项里挑一个、一道找数列下一项,还有一道数一数。我以为会看到 6 组散乱的数。结果5 道题 10 次输出逐字一模一样,连输出的哈希都相同。
这个结果和平时听到的说法对不上。说模型不靠谱,最常见的理由是它每次答得不一样。可在这批有确定答案的题上,它一致得吓人,10 次连一个标点的差别都没有。它的毛病不出在不稳上。它稳,只是稳的地方不对。
唯一飘的是第 6 道,数一串订单号里有几个数字字符。10 次给了 4 个答案,13 出现了 5 次,11 三次,12 和 14 各一次。标准答案是 13。已复现
03
PART
同一串字符,换个问法就翻面
CONTROL · 变量隔离
这道题看着像送分题,只要一行行看过去就行。所以我把变量缩到一个,再跑一次。同一条字符串,INV-2026-1031-00482-A7,同一个问法,只换问的是哪种字符。
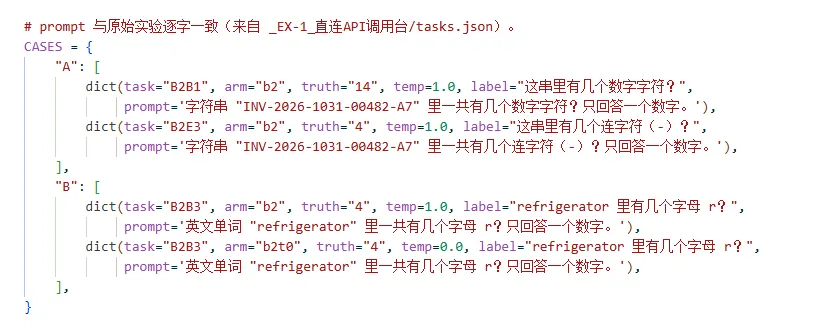
— 四条任务定义:同一串字符,两个问法只差一个词
问这串里有几个数字字符,标准答案是 14。10 次它给了 5 个不同的数,11、12、13、14、15,只对了 1 次。问这串里有几个横杠,标准答案是 4。10 次全给 4,逐字相同。
同一条字符串,字符没变、格式没变、题目看着也不难,变的只有我让它数什么。所以「这题太难」这个解释可以划掉了。
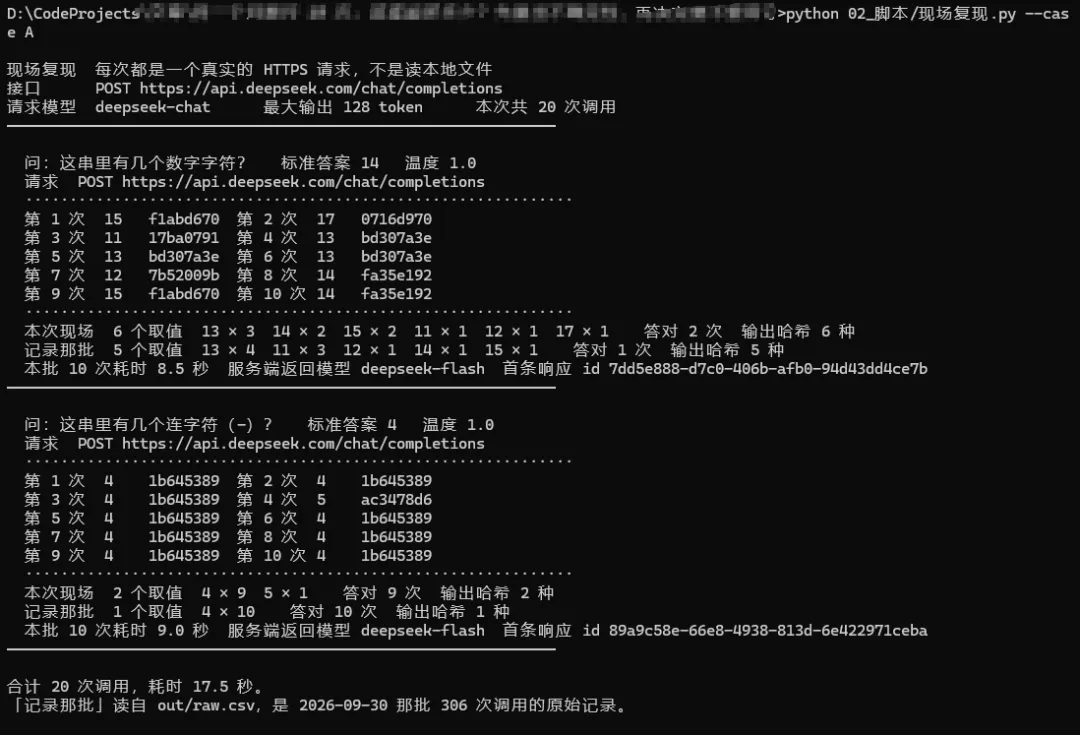
— 终端现场输出:两种问法并排,每格都带服务端响应 id
04
PART
它看到的是一串切块
MECHANISM · 机制
那卡住它的是什么。
先看它眼前摆着什么。它读到的是一段被切成小块的东西。业内管这些小块叫 token,你可以理解成它内部把一段话切开的那把刀,切出来的每一块。这一步住在它读入文本的最前面,你发过去的一段话先被那把刀切过一遍,它看到的是一串小块,看不到小块里面还剩几个字符。
数横杠能行,是因为横杠恰好是这些小块里的一个单位,它能一个一个指着说这里有一个。数数字字符就难了,因为数字散落在这串小块里,它没有一个一个字符看过去、再累加起来的动作。它只能扫一眼,报一个估出来的数。所以「指着一个一个数」和「在小块内部逐个字符判定」是两件不同的事。前者的单位和小块的边界对得上,后者掉在小块里面。
这条线往两边一划,前面的结果就都对上了。数一个 JSON 有几个顶层字段、数一份清单有几条待办、数这串里有几个横杠,这些都是能一个个指着数的。横杠那条后来再跑一批,二十次里错过一次。反过来,数几个汉字、数几个字母、数几个数字字符,都要在连续的文字里逐个判定再累加,三十次里只对上三次。
这一步是我对现象的解释。这批实验没拿到它内部的切分,我没法直接看到那把刀是怎么下的。能确定的是外面这些结果。
05
PART
摆整齐和调温度,都救不了
FAILED FIXES · 两条死路
我接着试了把字符用空格一个个摆开,r e f r i g e r a t o r,看它是不是就能数对了。10 次给了 5 个不同的答案,只对了 4 次。把订单号也拆开,效果更差,只对了 1 次。
摆整齐只是让文本变长,它的动作没变,还是在估。摆好看救不了它,得把数这个动作整个搬出去。
到这里会有一个很自然的反应,那把温度调成 0 不就稳了吗。我试了。温度调到 0,那些飘的数确实不飘了,数汉字那道给的答案从 8 个收到 2 个。但答对率没上去,反而从 10 次对 2 次掉到 0 次。它收敛了,收敛到错的答案上。
温度调的是它随机不随机,调不了它对不对。
06
PART
它稳到你以为它是对的
STABLE ERROR · 稳定地错
还有一层更值得警惕的。数 refrigerator 里有几个字母 r,标准答案是 4。它 10 次全给 3,输出逐字相同,温度调到 0 还是同一个输出。
它没在飘,它是很稳地错。一个偶尔飘的数,你会去核。一个每次都一样的数,你不会核,你会把它当成它算出来的答案。稳错比乱错麻烦。
换个日子把这条重跑,两个温度各 10 次,还是全给 3,输出的哈希和记录那批一模一样。连记录带现场四十次,它给出的数只有一个 3,标准答案那个 4 一次都没出现过。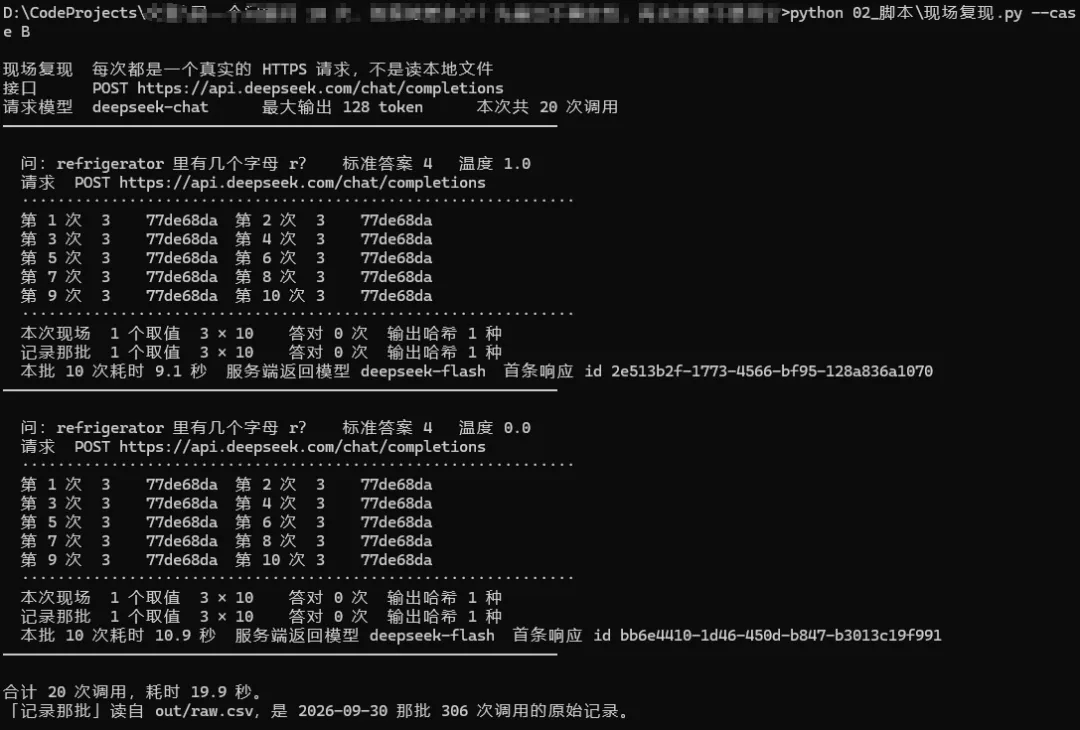
— 两个温度各 10 次,全是 3;两个温度的输出哈希相同
它为什么会稳成这样。refrigerator 里那个 3,是它每次都会报出来的数,稳稳待在正确答案旁边。这个数来自它对这类词形的一个固定判断,跟这一次抽样怎么落没关系。既然是固定的,动采样参数就改不动它,这也解释了前面温度那一节的结果。
07
PART
那个检查,漏在哪
TWO GAPS · 两处漏判
这就是「跑个十来遍,看答案一样不一样」这个校验办法的问题。它漏的地方有两处。
一处是你的要求会把差别抹平。同一个问题,要求只回一个数字,10 次文本一模一样;改成还要给一句理由,同一道题的 10 次产出就有 8 种写法。看起来一致,可能只是你把它问窄了。
另一处就是刚才那条,它稳到你以为它是对的。
所以别把「一样不一样」当判据,把能算的量交回脚本算。
08
PART
把「数」这个动作搬出去
HOW TO · 三步做法
具体分三步。凡是能从结果里数出来的东西,几条、几个、第几,不要让它直接报,让它按固定格式把来源交出来。脚本读这份结果,自己数一遍,和它报的数对一对。两边对不上时,先回原始输出看一眼,错在它还是错在脚本,不要想当然。
比如让它报一段日志里有几条错误行,它回一个 7。只盯着这个 7,你没法判真假。换成让它把命中的行号一条条列出来,脚本拿这个列表数一遍,差几个立刻看得出来。
要记的字段不多,原始问题、它交出来的结构化结果、脚本数出来的值、两边差多少,四个就够。
这条做法不只管数数。加总、去重、排序,这些事写代码的人本来就会交给代码做,反倒是数一数容易被随手丢给模型,因为它看着太简单,简单到你不会觉得需要为它写一行代码。凡是有一个确定答案、你手上又写得出算法的事,都该由脚本判。模型负责把结构交出来,判定交给代码。
有一条边界要写清楚。脚本能算的,只是那些能从它交出来的东西上直接算的。要是错发生在交出来之前,比如它自己漏了一行、把两条并成了一条,脚本把结果数得再准,也是在一个错的底稿上作业。这套校验挡得住报错,挡不住漏报。
///
LAST
写在最后
LIMITS · 边界
最后是这批数的边界。这批题每一条跑了 10 次,整个实验台一共 306 次调用,失败 0。单条 10 次算一批观测,不能读成它总是这样。数 refrigerator 那题我前后跑过好几批,中间有一批它还报过几次 2。它给的数会摆,只是摆来摆去都落在真值旁边那一小块地方,进不到真值上。
回过头看,它会不会数数这件事,取决于你要它数的那个动作归不归它。横杠、字段、清单条目,这些能一个个指着数的,交给它没问题,前后就错过一回。要它在连续的文字里逐个字符判定再累加的,比如数几个汉字、数几个字母,这件事从一开始就不该归它。分清楚这一点,比争它到底行不行有用。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING