ARTICLE · 1138420
AI 生成的人物为什么总换脸?我试了 4 种方法,只有 1 种管用
AI 实操 · 一份踩坑记录
AI 生成的人物为什么总换脸?我试了 4 种方法,只有 1 种管用
小董讲道理 · 2026 年 10 月 5 日
先说结论:AI 生成的人物总在换脸,不是模型不行,是方法不对。
这个问题我前前后后折腾了大半年。从纯文字描述,到垫一张参考图,再到做角色圣经表,最后落在一套“双锚定 + 同批次”的做法上。四种方法我都认真试过,效果差距大到不像同一个工具做出来的。
这一篇把过程完整写出来,包括每一步为什么失败。如果你也在做 AI 视频或者 AI 短剧,这份记录大概能帮你省掉几个月。
问题的样子
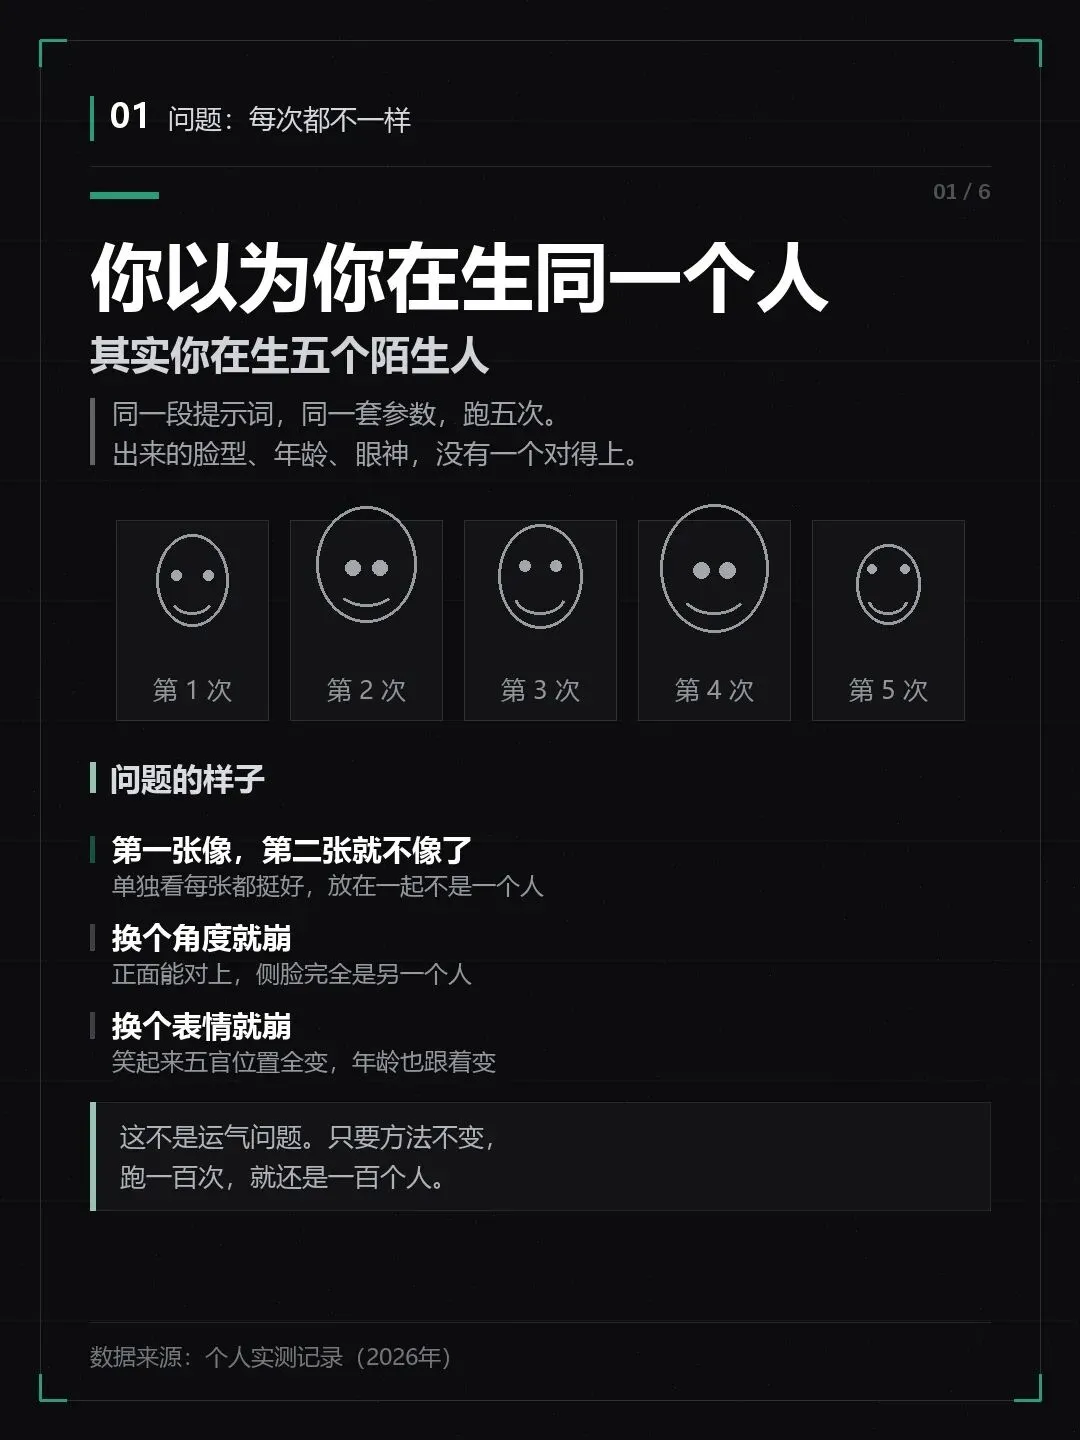
最典型的场景是这样的:同一段提示词,同一套参数,跑五次。出来的五张脸,脸型、年龄、眼神,没有一个对得上。
单独看每张都挺好——构图不错、光影不错、质感也不错。但把它们放在一起,你会发现问题:这不是一个人在不同镜头里的样子,这是五个人。
具体会崩在两个地方:换角度就崩,正面能对上,侧脸完全变成另一个人;换表情就崩,笑起来五官位置全变,年龄也跟着变。
如果你做的是单张图,这个问题不明显。但只要你做的是连续镜头——短剧、动画、广告——它就会在剪辑台上一次性爆发。
为什么会这样
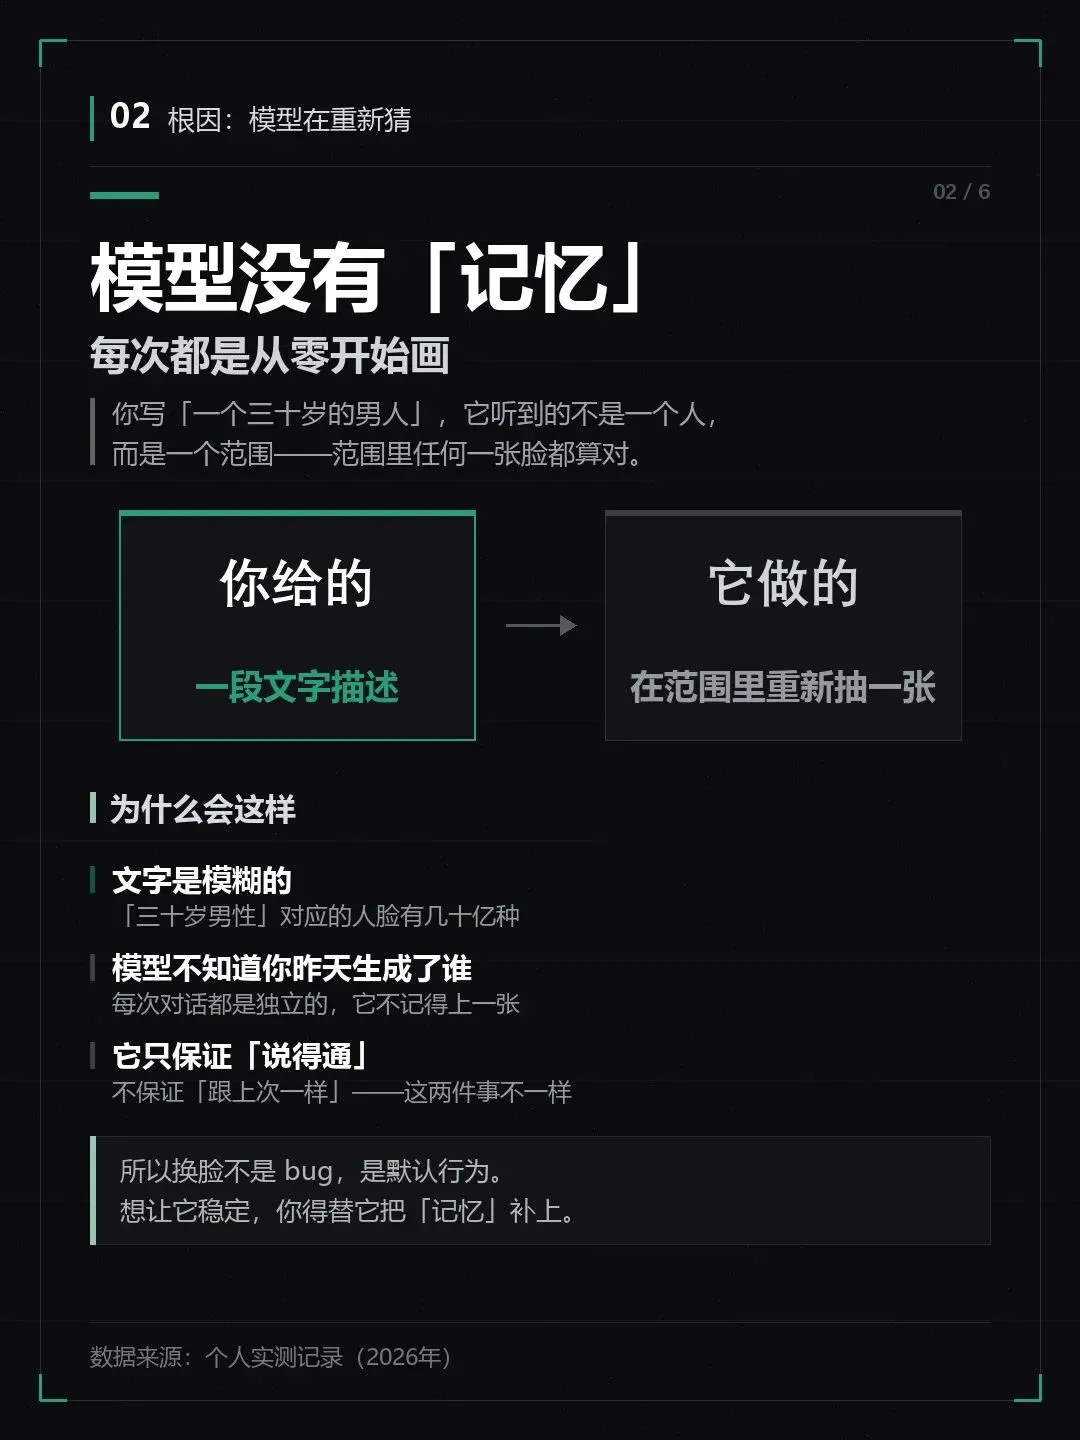
根因是一句话:模型没有「记忆」,每次都是从零开始画。
你写“一个三十岁的男人”,它听到的不是某一个人,而是一个范围。这个范围里有几十亿张脸,任何一张都算“对”。它只需要保证画面说得通,不需要保证跟上次一样——这两件事,完全不一样。
所以换脸不是 bug,是默认行为。它有三个具体来源:
第一,文字本身是模糊的。“三十岁男性”这个描述,对应的可能性是天文数字,你写得再细,也只是把范围缩小了一点点。
第二,模型不知道你昨天生成了谁。每次对话都是独立的,它不记得上一张图长什么样。
第三,它只承诺“合理”,不承诺“一致”。在它的评价标准里,一张全新的、同样合理的脸,和一个跟上次完全一样的脸,是等价的。
想让它稳定,你得替它把这块“记忆”补上。下面这四种方法,就是补记忆的四种思路,效果依次递增。
方法一:纯文字描述人物
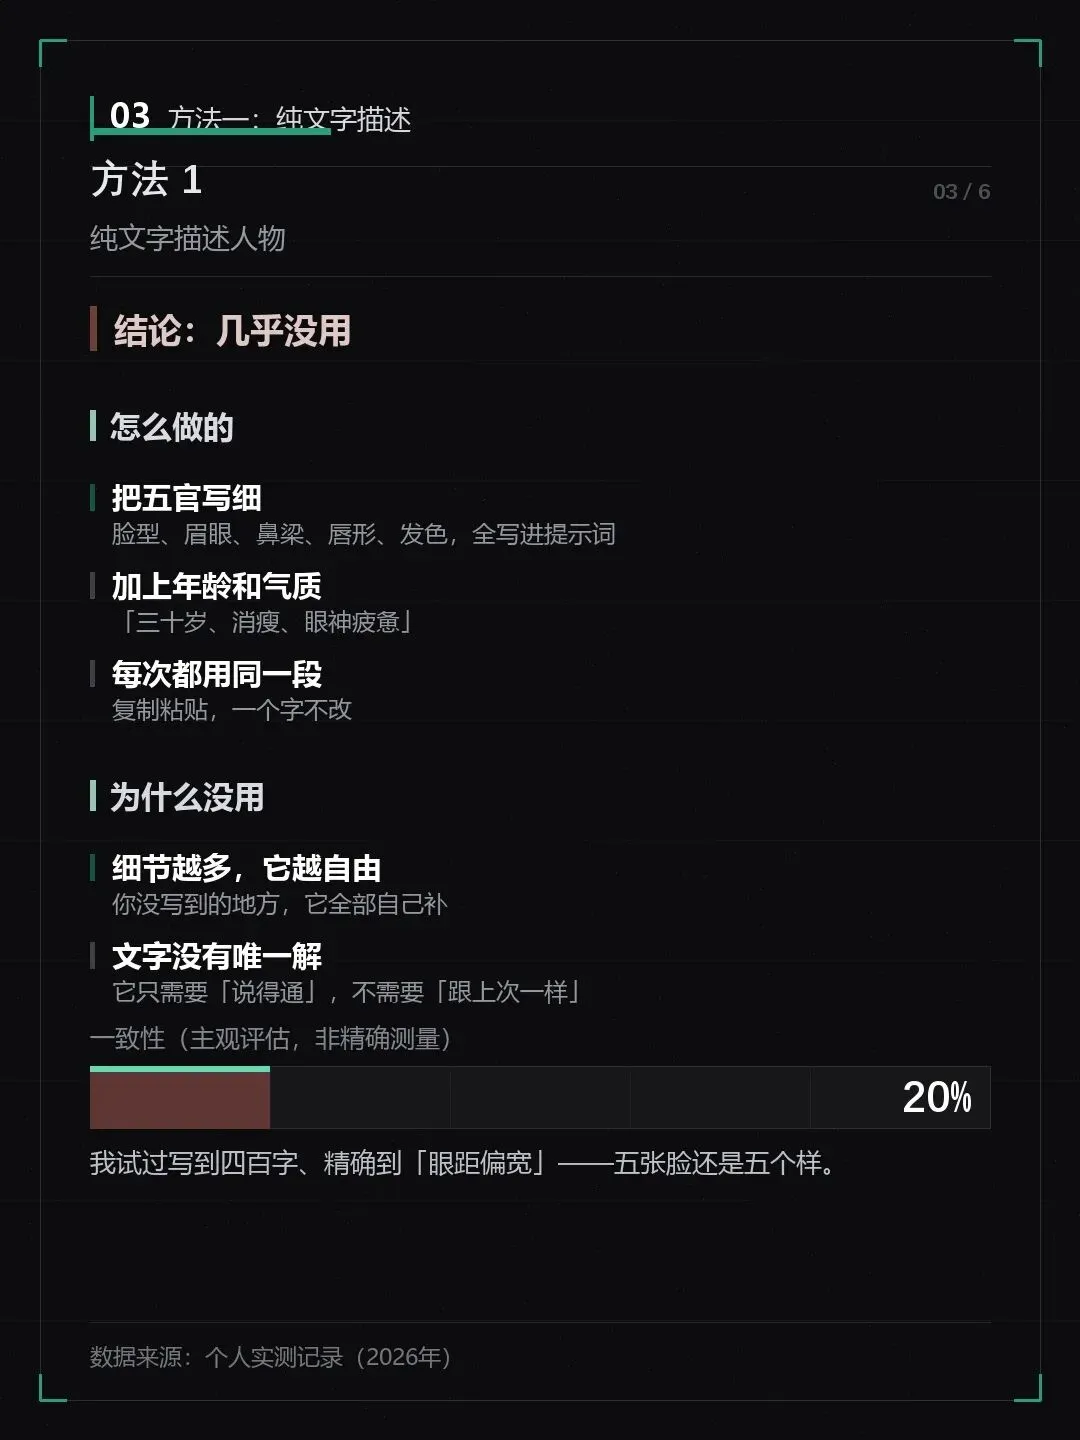
做法很直觉:把五官写细。脸型、眉眼、鼻梁、唇形、发色,全都写进提示词,再加年龄和气质,比如“三十岁、消瘦、眼神疲惫”,然后每次都用同一段,一个字不改。
我的结论是:几乎没用。
我试过把提示词写到四百字,五官精确到“眼距偏宽”。结果是五张脸依然五个样,只是都比较“像描述”。原因也不难理解:细节写得越多,模型自由发挥的空间反而越大——你没写到的地方,它全部自己补,而补的部分每次都不一样。
方法二:垫一张参考图
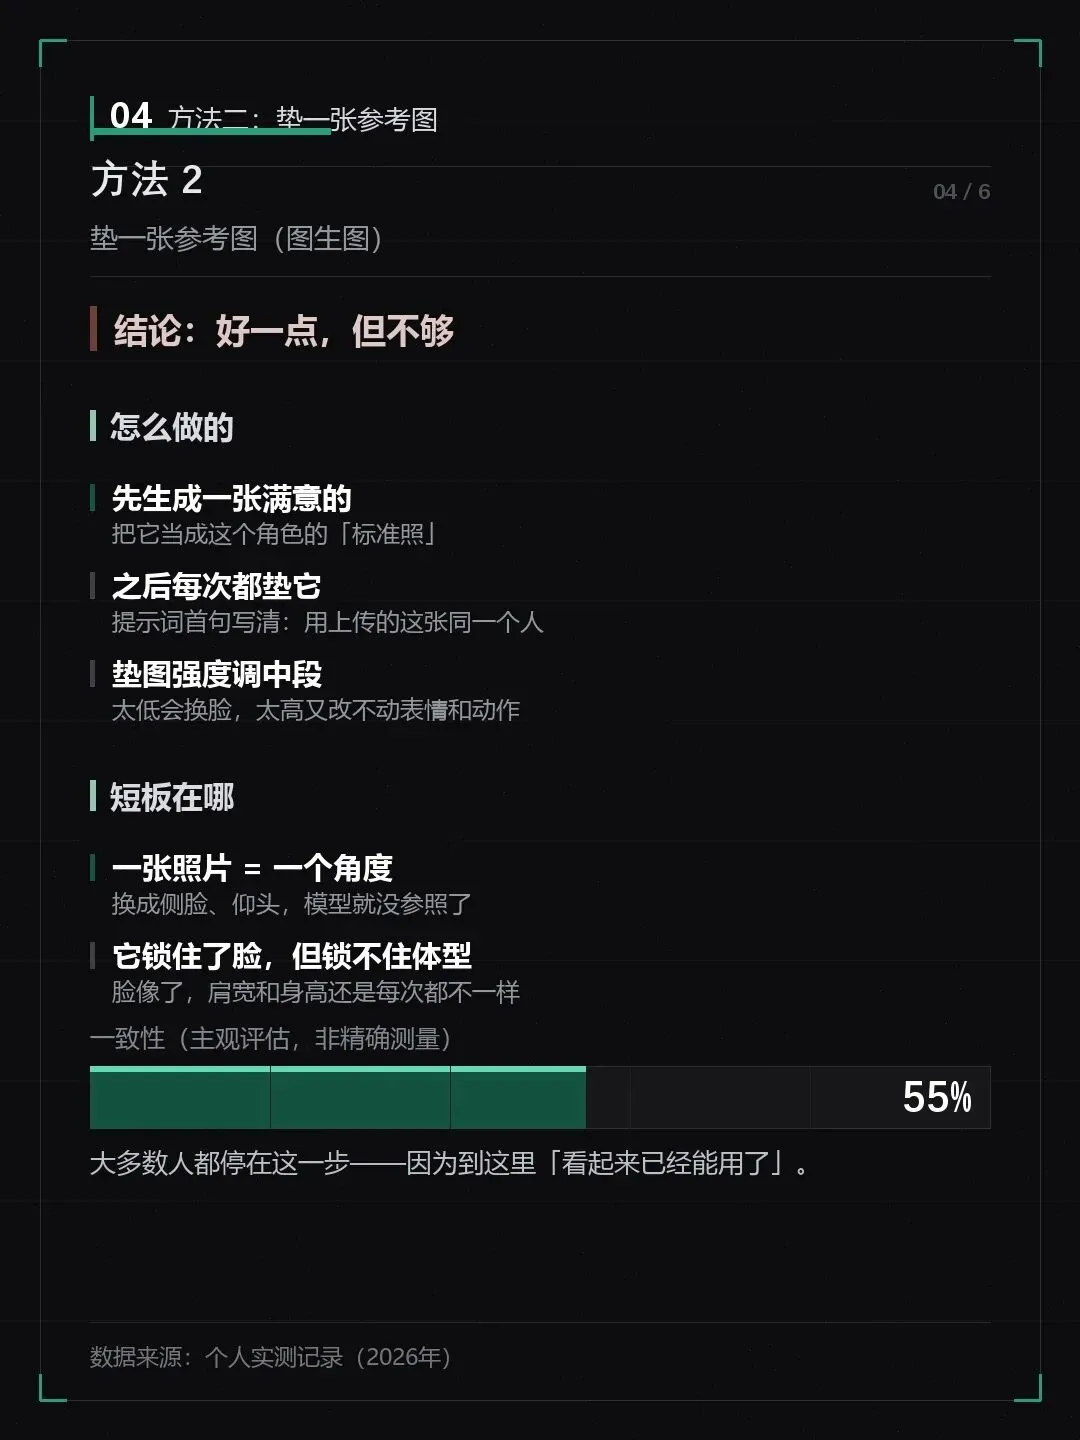
这是大多数人会用的方法:先生成一张满意的,把它当成这个角色的“标准照”,之后每次都垫它。提示词首句写清楚——用上传的这张,同一个人。
垫图的强度要调在中段:太低会换脸,太高又改不动表情和动作。
我的结论是:好一点,但不够。正面镜头基本能对上,一换角度、一换表情,就开始漂。
它的短板很明确:一张照片只能锁住一个角度。你给的是正脸,模型就知道正脸长什么样;侧脸、仰头、回眸,它没有参照,只能重新猜。而且它锁住的是“长相”,不锁“体型”——脸像了,肩宽和身高还是每次都不一样。
大多数人都停在这一步。因为到这里,“看起来已经能用了”。
方法三:做一张「角色圣经表」
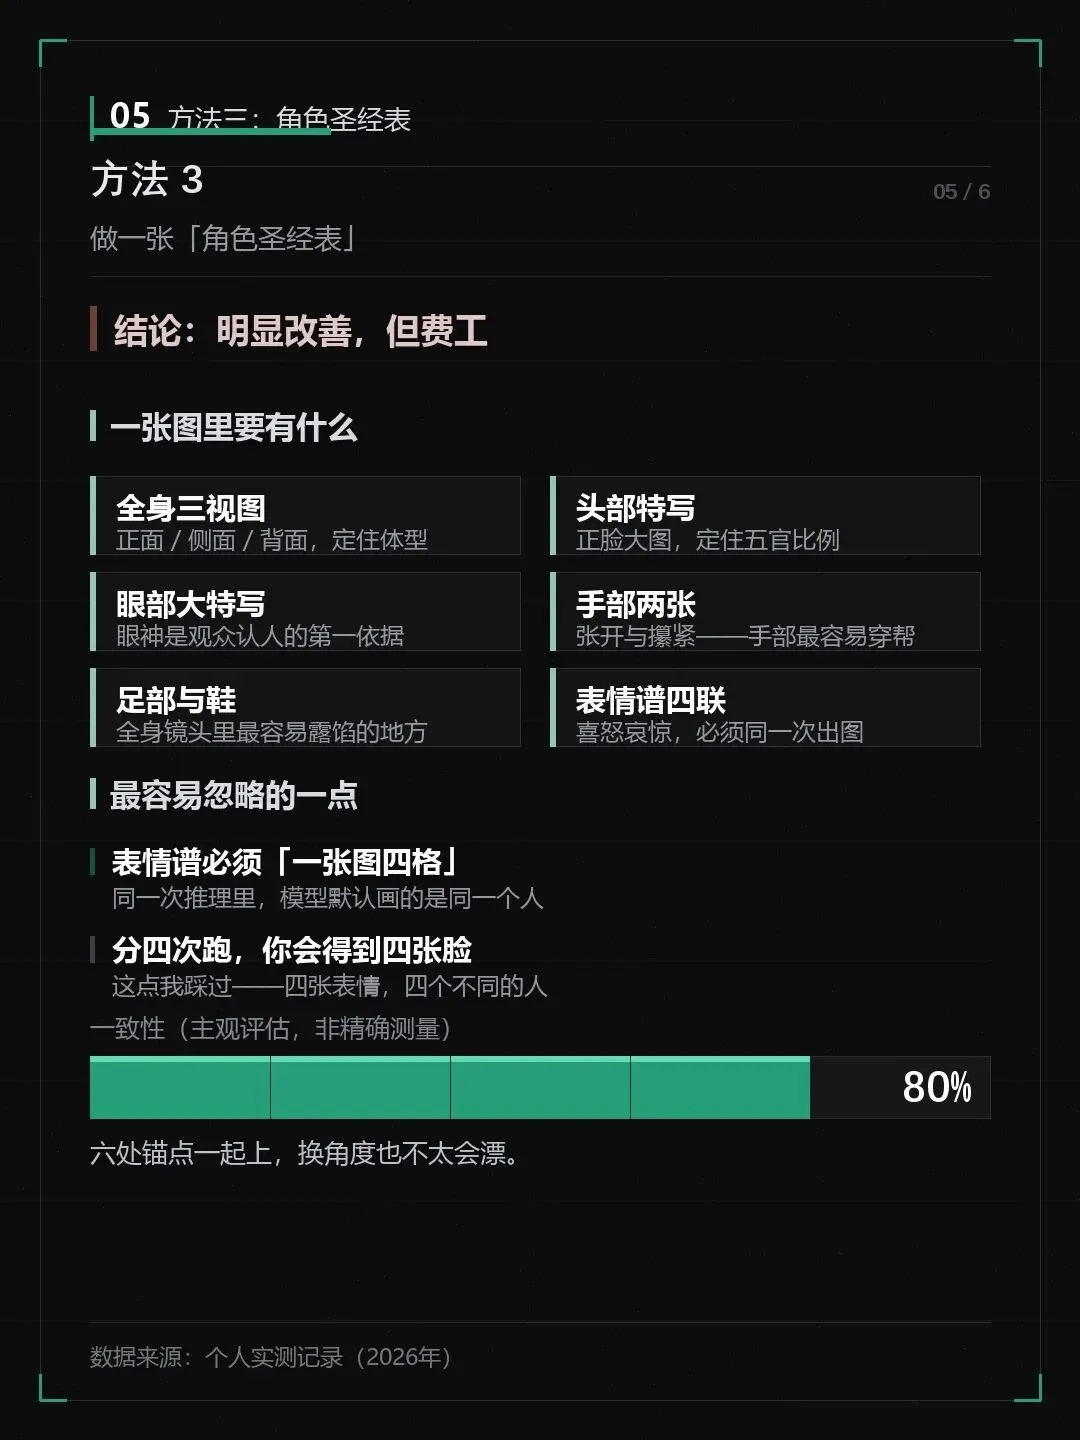
这一步的关键,是承认一件事:三视图不够用。
三视图是给“人”看的设计稿,它解决的是“这个角色长什么样”;但 AI 视频要的是“拍摄素材卡”,它解决的是“这个角色在每一个具体镜头里长什么样”。全身信息,在分镜里基本用不上——因为镜头几乎全是局部的、短的:拍手、拍脚、拍眼神、近景。
所以我把一张图做成了六块:全身三视图(正面、侧面、背面,定住体型)、头部特写(正脸大图,定住五官比例)、眼部大特写(眼神是观众认人的第一依据)、手部两张(张开与攥紧,手最容易穿帮)、足部与鞋(全身镜头里最容易露馅的地方)、表情谱四联(喜怒哀惊)。
我的结论是:明显改善,但费工。六处锚点一起上,换角度也不太会漂了。
这里有一个最容易忽略、但特别关键的细节:表情谱必须做成“一张图四格”。因为同一次推理里,模型默认画的是同一个人;分四次跑,你会得到四张不同的脸——这点我踩过,四张表情,四个不同的人。
方法四:双锚定 + 同一批次
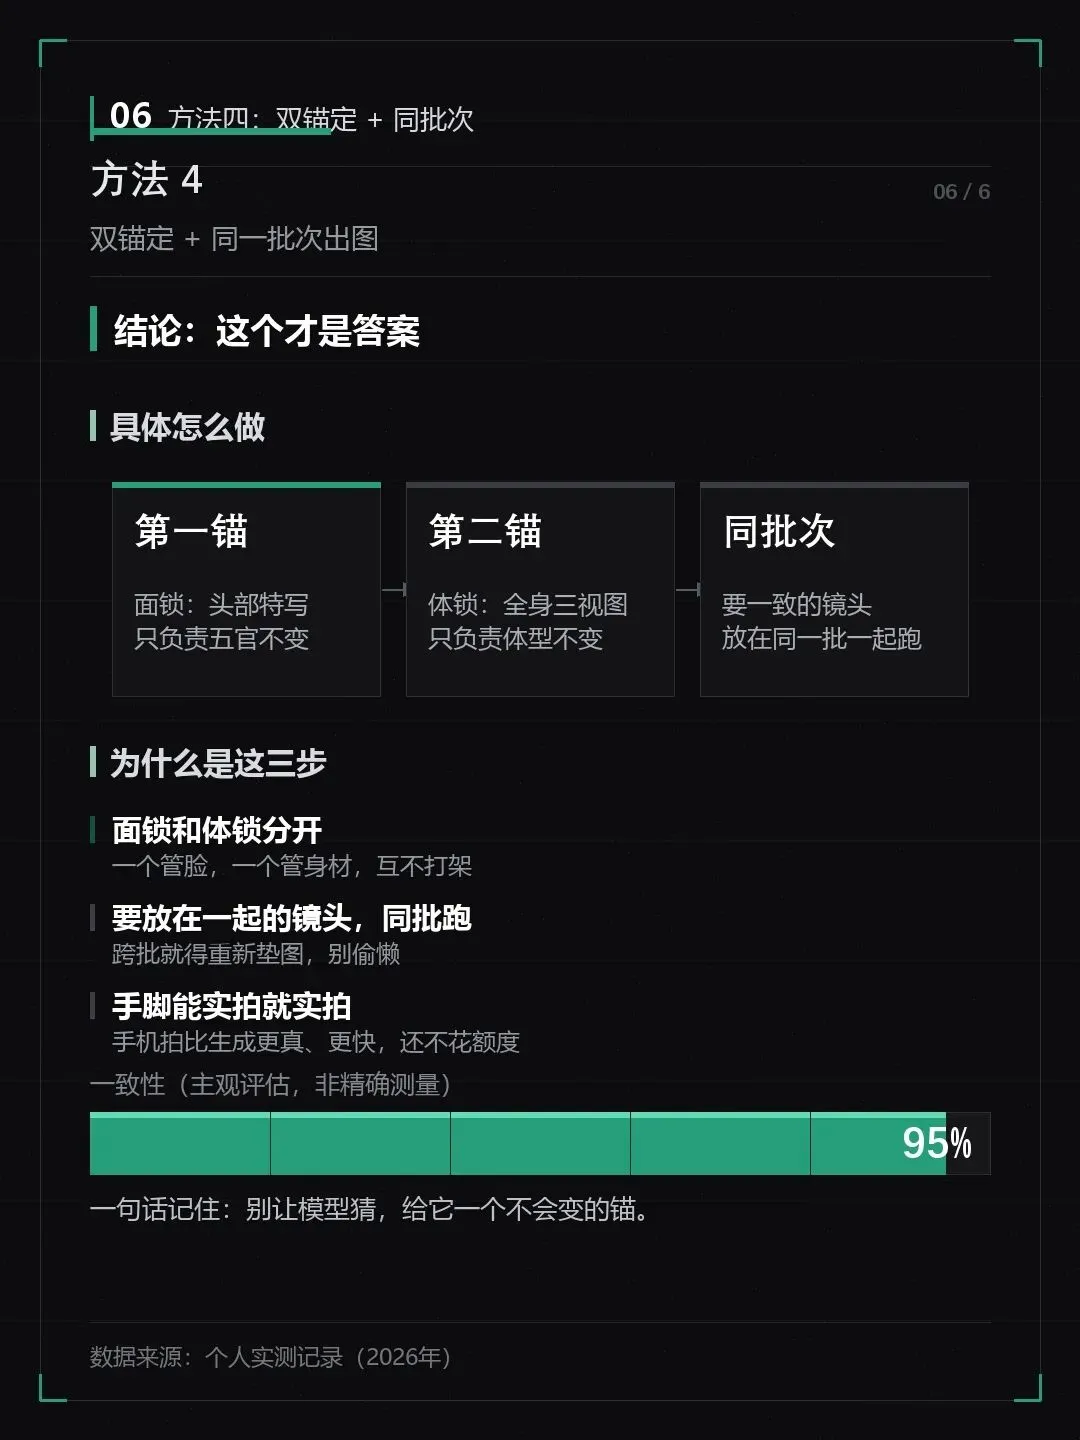
这是最后落下来的做法,也是唯一一个让我觉得“可以拿去干活”的做法。核心是三件事:
第一锚:面锁。用头部特写做参考,只负责一件事——五官不变。
第二锚:体锁。用全身三视图做参考,只负责另一件事——体型不变。
为什么一定要分开?因为一个锚管不了两件事。你让一张正脸照同时锁五官和身材,模型顾此失彼;拆成两个锚,各管各的,互不打架。
第三件事:同批次。所有需要保持一致、并且会出现在同一个镜头组里的画面,放在同一批里一起生成。原因前面说过:同一批推理里,模型默认画的是同一个人。
如果跨批次呢?那就必须重新垫一次图,不要偷懒——隔了几批之后,模型对“这个人”的印象已经淡了。
还有一条很实在的建议:手脚这类特写,能实拍就实拍。用手机拍一段,比生成更真、更快,还不用消耗生成额度。做 AI 视频的人容易陷入一个误区,觉得所有素材都必须生成,其实不是。
最后总结成三句话
把上面四种方法压一下,其实就是三条原则:
一、让模型“抄”,别让模型“猜”。给它一个不会变的锚(参考图),比给它一堆形容词可靠一百倍。
二、要放在一起的东西,放进同一批。需要互相出现的镜头,同一次推理出完。
三、能拍的别生成。手、脚、道具、实景,手机拍更快更真。
这三条背后是同一件事:把不确定的部分,尽量换成确定的。做 AI 内容,很多时候拼的不是提示词写得多漂亮,而是你有没有把不可控的变量一个个摁住。
换成这套之后,同一个角色终于能撑完一整场戏。从 20% 到 95%,差的不是模型,是方法。
别让模型猜。
给它一个不会变的锚,再把要放在一起的镜头放进同一批。
你在做 AI 视频、AI 短剧的时候,角色一致性是用什么办法解决的?评论区交换一下,我踩过的坑可能你也踩过。
#AI视频 #AI短剧 #AIGC #提示词 #角色一致性 #AI绘画 #内容创作 #影视制作 #讲道理
数据来源:个人实测记录(2026 年) 本文为个人整理与解读,以官方发布文本为准。