ARTICLE · 1143401
掀翻40年反向传播?AI新神作爆火48小时被扒光:竟靠打残对手作弊!
深度学习的世界,很久没有这么刺激的“弑神”戏码了。
2026年10月初,AI圈传出一则重磅消息:一家名为 Q Labs 的团队宣称,他们发明了一种名为 Dust 的全新算法。完全不需要反向传播(Backpropagation),就能预训练 Transformer 语言模型。
作者在发布时格外自信地宣布:只要投入足够的算力,这项新方法不仅能逼近反向传播,还能将其当场反超!
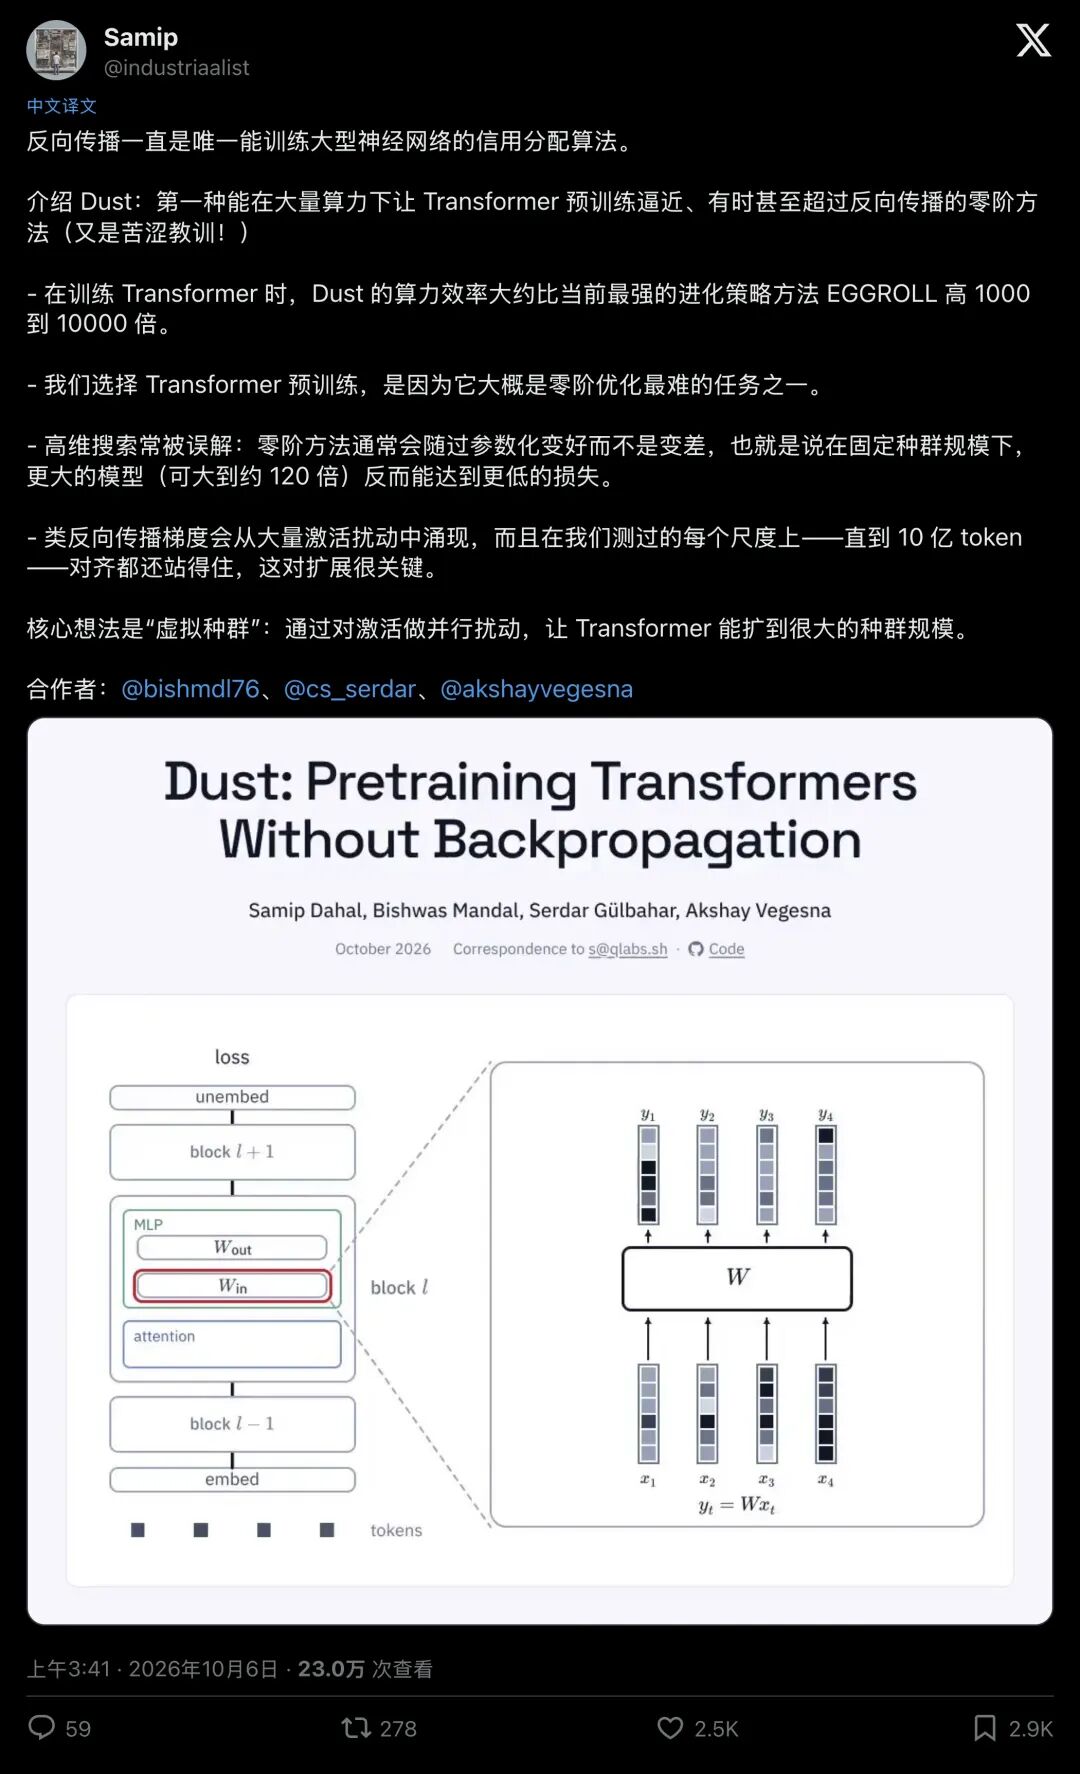
▲ Q Labs 创始人 Samip 发布视频,宣告反向传播的垄断终结
消息一出,整个技术社区坐不住了
要知道,反向传播统治现代深度学习已经整整四十年。从 ChatGPT 到自动驾驶,人类今天拥有的所有前沿大模型,地基全是用反向传播一砖一瓦敲出来的。难道这个统治了 AI 界半个世纪的“物理定律”,真要在今天被扫进历史垃圾堆?
然而,戏剧性的高潮来得太快
仅仅 48 小时后,来自卡内基梅隆大学(CMU)背景的独立研究员 Benhao Huang,带着一份详尽的复现报告拍案而起。真相大白于天下:
官方的代码确实能跑通,跑出的数值也完全对得上。然而仔细核查实验设计就会发现,Q Labs 在论文里悄悄给擂台上的对手“打了一针麻醉剂”:他们选来对比的反向传播方案,只是一个被故意削弱的早期老古董,与现代工业界日常运行的主流配置大相径庭。
换上现代标配的武器重新交手,神话瞬间坍塌。
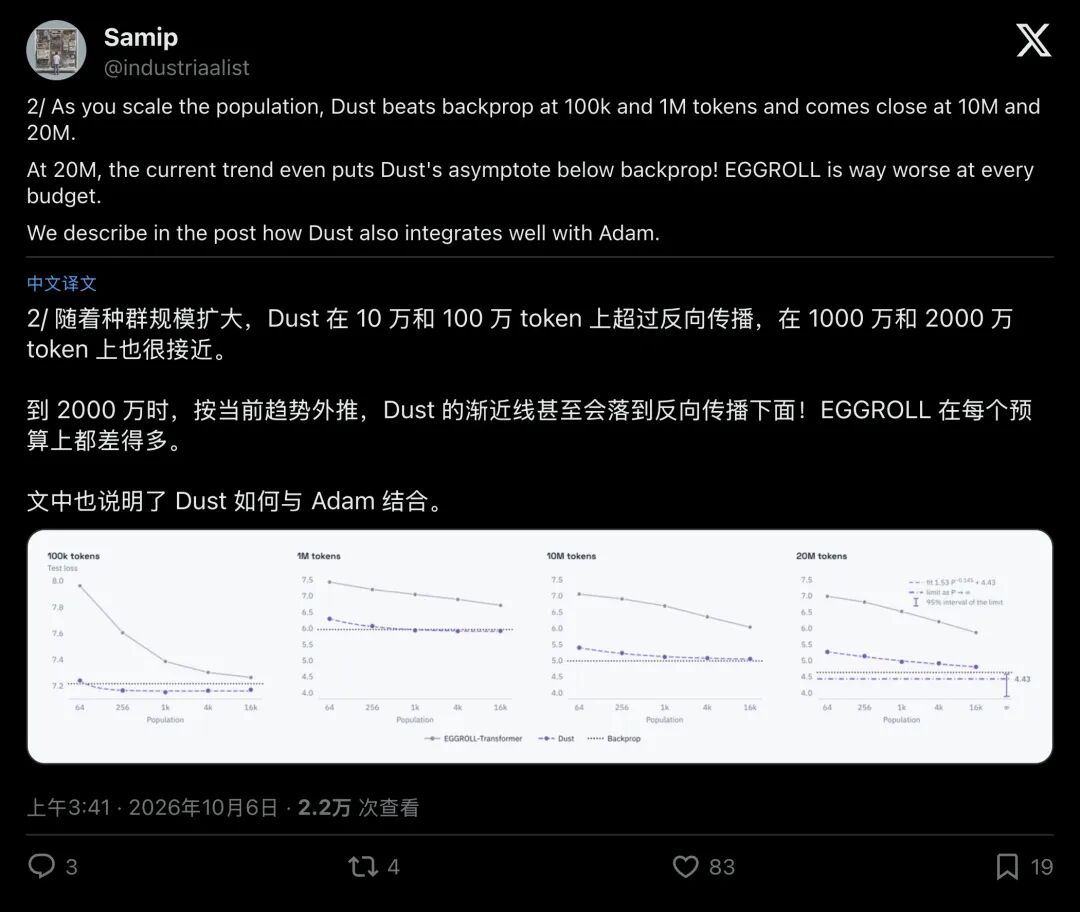
▲ Q Labs 展示的训练曲线,宣称大算力下 Dust 渐近线能超越反向传播
01盲人摸象的奇迹:Dust 到底是个什么玩意?
要看懂这场世纪争论,我们得先用三分钟,把枯燥的黑话翻译成人话。
训练一个大模型,本质就像教一个学生做卷子。
现代 AI 用的反向传播,就像是一位拿着红笔的顶级名师。模型做完一整套卷子,算出一个错题总分。名师不仅告诉你错了,还会顺着你解题的每一步逻辑(高等数学里的链式法则),精准地在每一道题的每一个推导环节上批注:“第一步乘法算错了,往上改2分;第二步公式用反了,往小调5分”
所有参数该怎么改,一步到位,精准无误。
但这套机制有个硬性前提:整张卷子的逻辑必须平滑可微。而且在硬件上,不仅要把整张卷子算一遍(前向传播),还得完整保留中间每一步的草稿纸,倒着再推算一遍(反向传播)。它非常吃显存,也限制了模型只能采用某些特定的可微结构。
而 Dust 走的则是另一条完全不同的路:零阶优化(Zeroth-Order Optimization)。
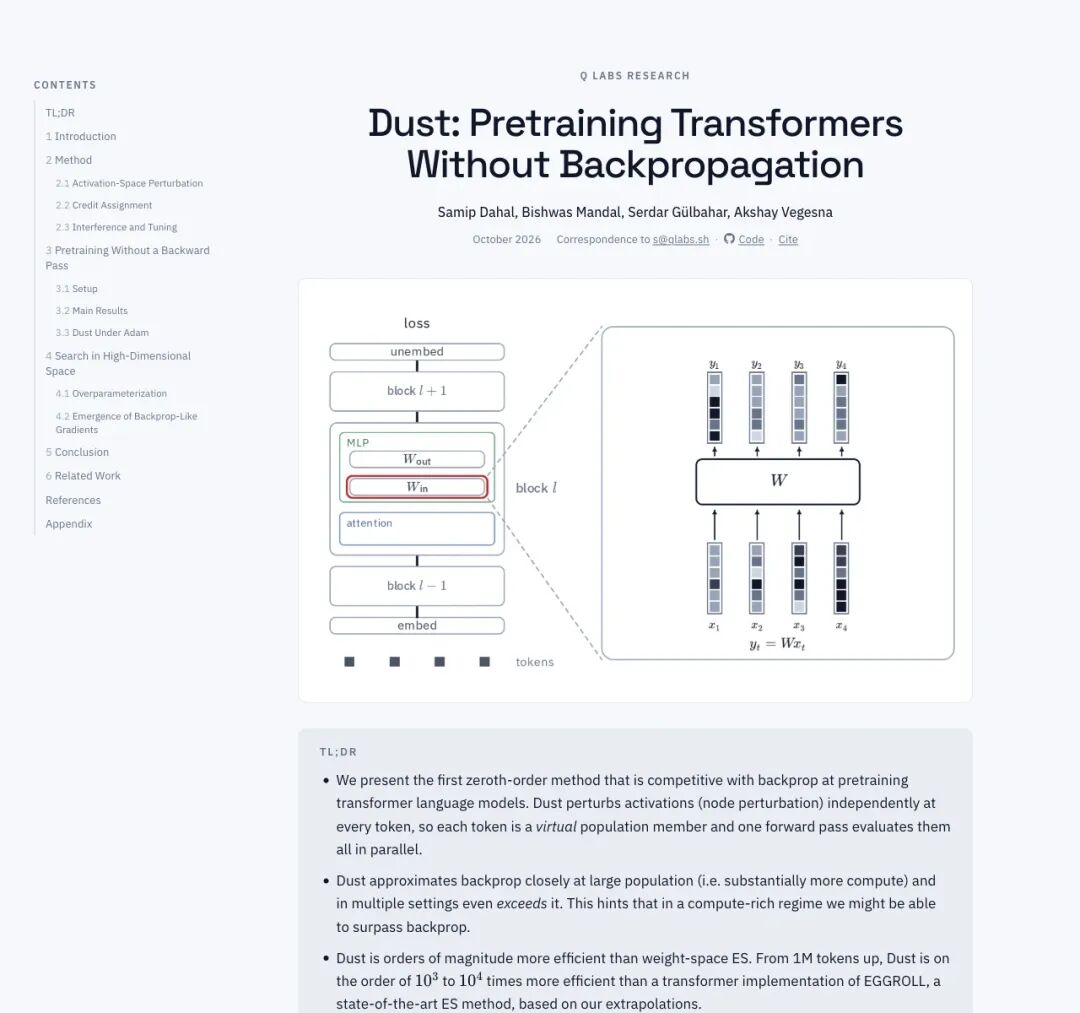
▲ Dust 的核心架构与机制:不再求导,而是在每个 token 的激活值上独立加噪
零阶优化手里没有批改错题的红笔
这种做法宛如盲人摸象:既然不知道明确的方向,就在模型的神经元激活里试探性扔一团随机噪音(扰动),看看得分是上升还是下降。得分上升就顺着方向前进一步,得分变差就朝反方向调整。
以往的“盲人摸象”非常蠢模型有几十亿个参数,你得生成几千甚至几万个不同的参数副本(种群),每个副本跑一遍网络,显卡当场冒烟。
而 Dust 确实展现了一个极其惊艳的算法巧思:虚拟种群(Virtual Population)。
它不再对庞大的权重参数加噪,而是直接在每个 token 的激活值上加噪。在一段文本里,几千个 token 各自承受不同的随机扰动,一次前向计算,就能同时评估成千上万个扰动方向!
从算法工程的角度看,Dust 确实是一项极其漂亮的创新。甚至连复现者都忍不住称赞:这个点子真的很酷。
但问题在于:酷,并不代表它真能打败反向传播。
0248小时闪电打假:你在跟谁打擂台?
Q Labs 的论文里画得天花乱坠:在大规模算力下,Dust 逐步逼近甚至超越了反向传播。
但 Benhao Huang 复现时多留了一个心眼。他去翻看实验代码,赫然发现了一个惊天猫腻:
论文里拉来跟 Dust 打擂台的反向传播,使用的优化器竟然是恒定学习率的 SGD(随机梯度下降)!
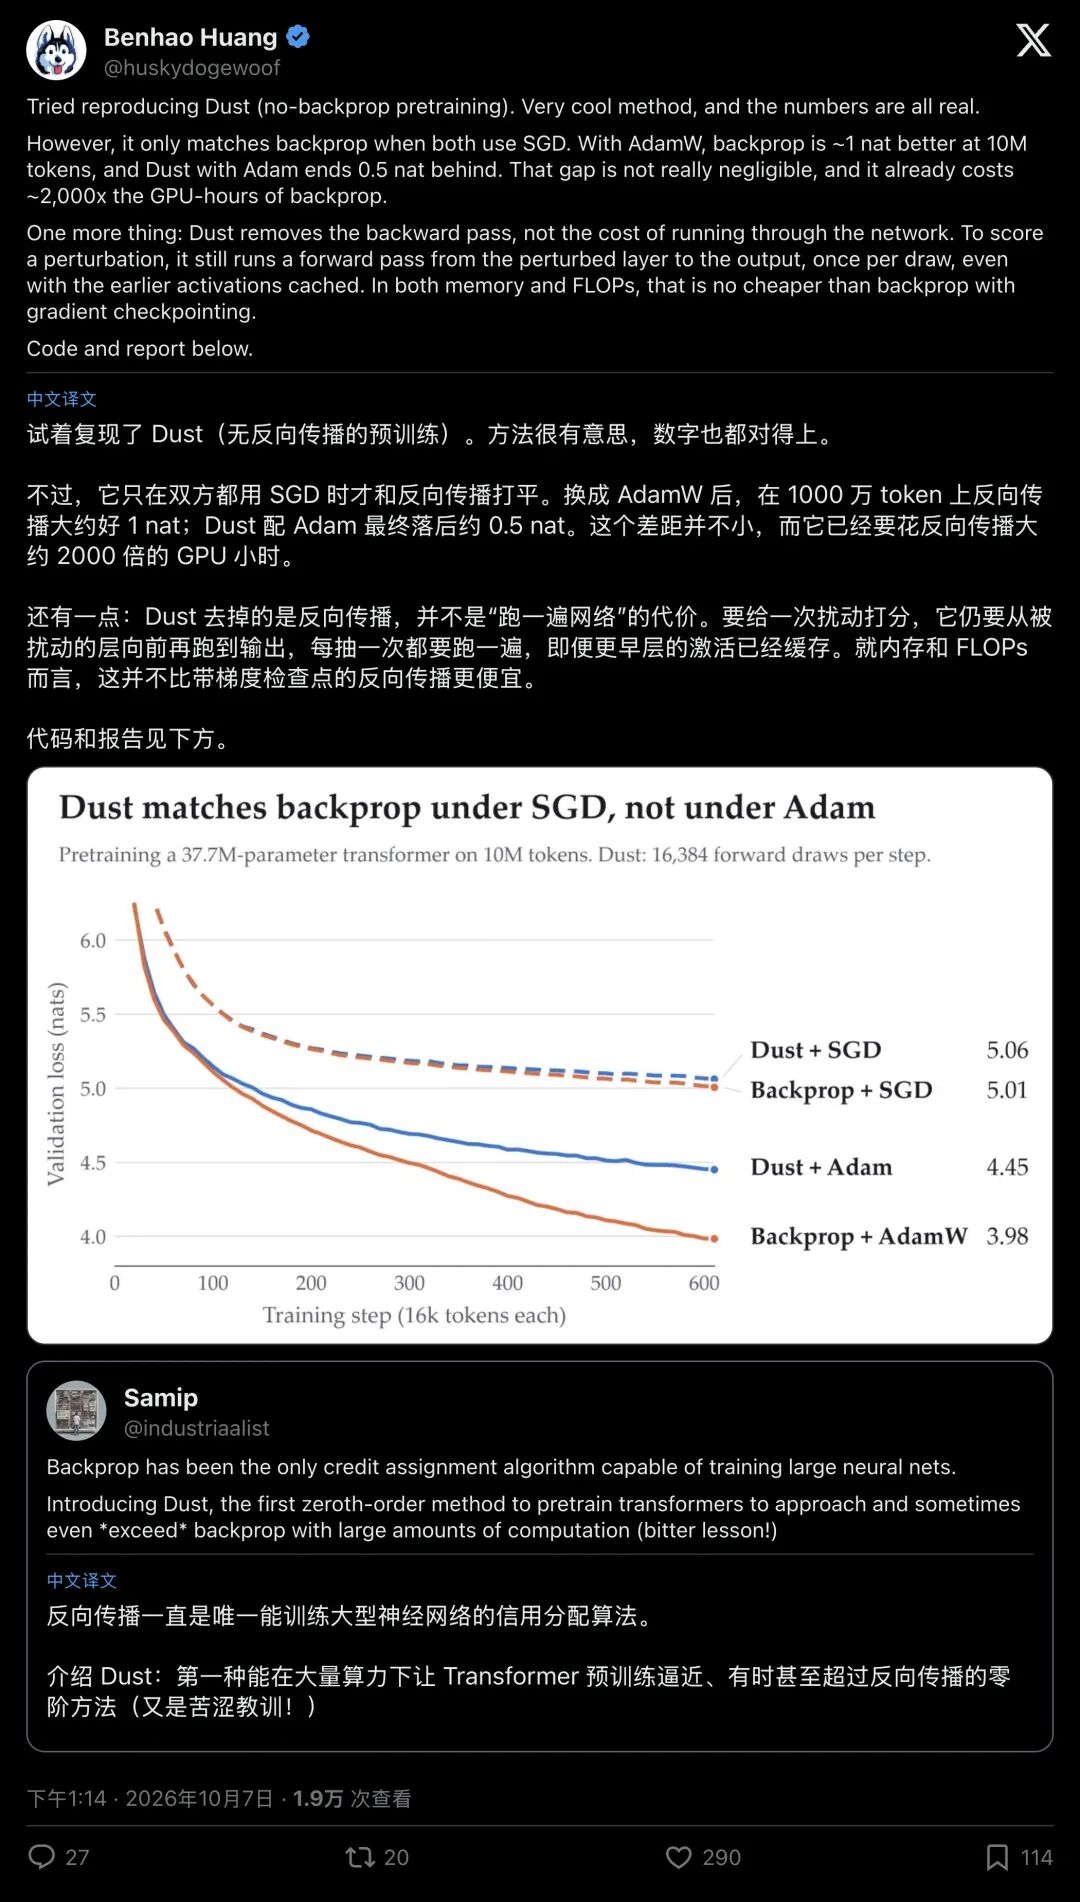
▲ 独立研究者 Benhao Huang 发帖揭露真相:换上 AdamW,差距瞬间拉开
这是个什么概念?
SGD 是 40 年前深度学习刚起步时的原始工具。它宛如缺少变速箱与避震结构的老式自行车,前后轮全凭固定力道硬蹬。遇到 Transformer 这种内部曲率极其复杂的高维非凸地形,SGD 往往在平缓的下坡寸步难行,在陡峭的峡谷疯狂颠簸。
在现代工业界,从 GPT-4 到 Llama,根本没有人会用恒定学习率的 SGD 去预训练 Transformer。大家唯一认准的事实标准,是配备了坐标级自适应学习率和权重衰减解耦的现代化全地形越野车,AdamW。
既然你宣称 Dust 能打败反向传播,那为什么不让它跟现代反向传播的完全体 AdamW 打一场?
复现团队立刻补齐了这个缺失的关键对照组。他们把优化器换回行业标配的 AdamW,在完全相同的 3770 万参数模型与 FineWeb 数据集上跑了一遍。
结果,灾难级的差距瞬间曝光
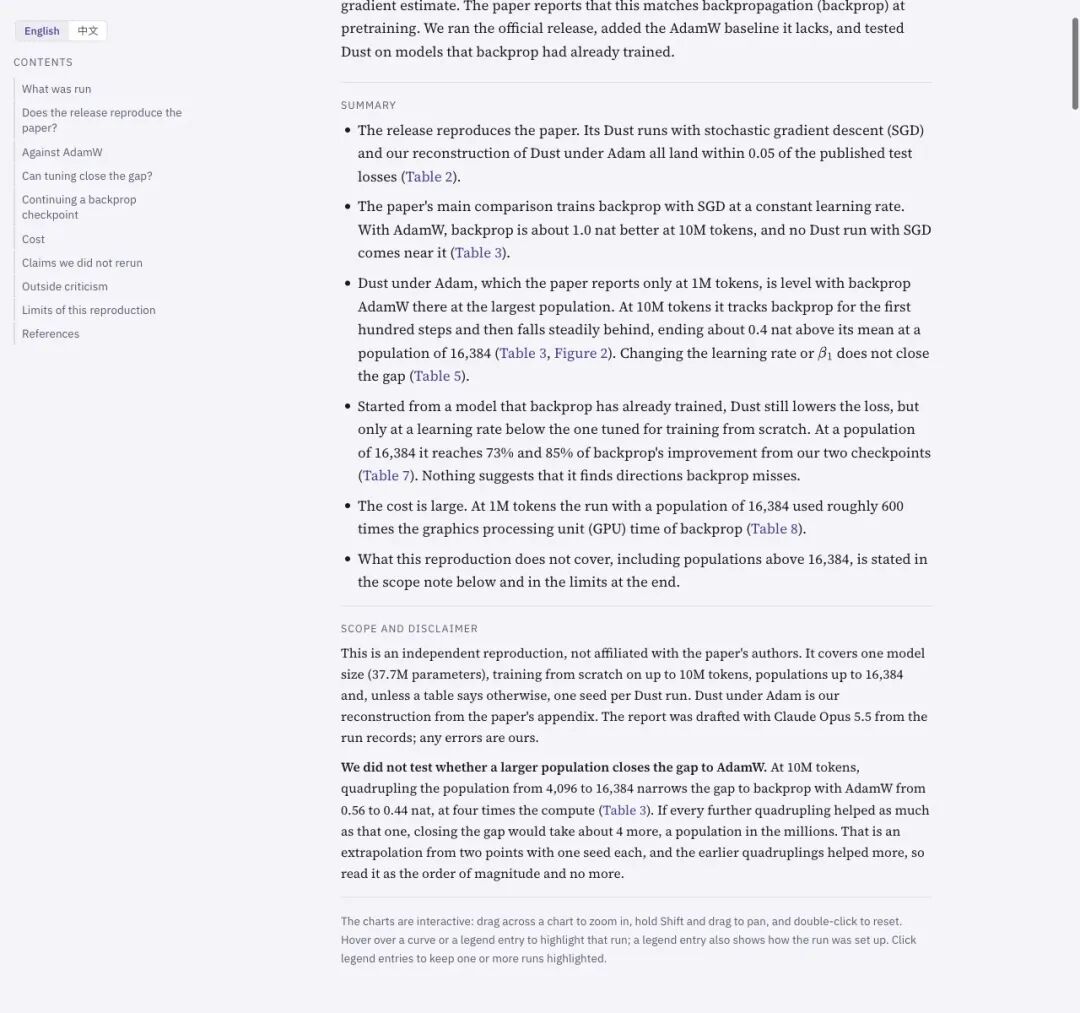
▲ 复现报告 Against AdamW 节:AdamW 轻易跑出 3.998,而 Dust 被远远甩在身后
在 1000 万(10M)token 的训练量下:
使用恒定 SGD 的反向传播,测试损失是 4.989 nat; Dust 配上 SGD,测试损失是 5.047 nat,看起来确实“相差无几”,给原作者制造了“逼近甚至超越”的狂欢幻觉; 但是,换上标配的 AdamW 反向传播,测试损失直接暴降到了 3.998 nat!
整整 1.0 个 nat 的鸿沟!
很多非专业读者可能对 “1 nat” 没有概念。在语言模型里,Loss 的单位是 nat(以自然对数计算的信息量)。损失从 4.99 降到 3.99,差出整整 1 个 nat,意味着困惑度(Perplexity)足足优化了 $e^1 \approx 2.72$ 倍!
双方的实力差距悬殊,已然构成了正规军对冷兵器队伍的降维打击。
即使复现团队按照论文附录,硬给 Dust 也装上 Adam 优化器,在堆满 16,384 种群的极限制约下,Dust 的最好成绩依然只有 4.436 nat,依然被正统反向传播甩开 0.44 nat 的巨大差距。
所谓“掀翻反向传播”,不过是先打断了反向传播的一条腿,然后再庆祝自己跑赢了瘸子。
03算力黑洞:耗光2300倍显卡,换来一个“半成品”
更致命的死穴,写在冰冷的电费账单上。
Dust 的支持者此前寄予厚望:既然零阶优化省去了反向倒算梯度的流程,能否借此节约天量显存和计算资源?
复现报告给出的答案极其残忍:不仅没省,反而贵得突破天际。
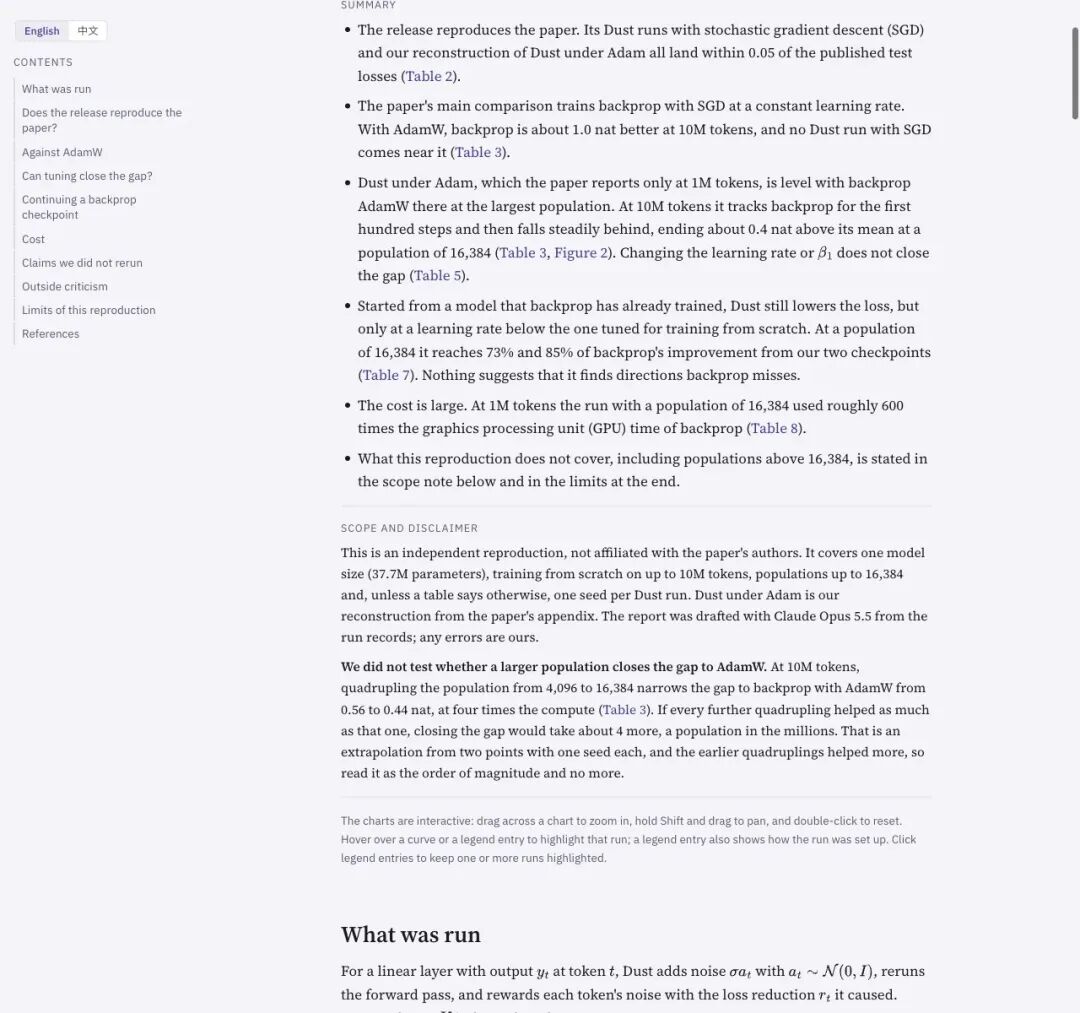
▲ 复现报告表 8:追赶微弱的精度,Dust 消耗了高达 2316 倍的 GPU 算力
从物理机制上讲,Dust 虽然免去了反向链式求导,但为了给成千上万个激活扰动打分,你必须把扰动层后面的所有网络层重新计算一遍。
去掉的是求导公式,去不掉的是矩阵乘法的物理代价。
账单算下来触目惊心:
在 1000 万 token 训练下,使用标配 AdamW 的反向传播,单张 GPU 只要几分钟就能搞定; 而想要让 Dust 配上 Adam 勉强跟上脚步(种群 16k),8 张高性能 GPU 连续轰鸣数个小时! - 其 GPU 耗时,是现代反向传播的整整 2316 倍!
为了在落后 0.44 nat 的窘境下苟延残喘,你需要多烧掉两千多倍的显卡和电费。
这还不算最尴尬的
原推文发布后,社区研究者 cider 直接甩出两张训练曲线图公开泼冷水:你们测了半天,测试损失还在 5.0 nat 晃悠,这也能叫“预训练”?
在现代语言模型训练中,5.0 nat 的损失高得离谱。在这个阶段,模型甚至连基础常识都没建立,仅仅是在根据单字频率,把那些极度不可能出现的生僻字排除掉。深层的特征学习与语义表征,根本还没起步!
你只是在一个大模型刚学会“咿呀学语”的最前沿浅水区,靠烧穿 2000 倍电费勉强摸到了对方的脚后跟,就敢大声宣布统治世界的地基已被动摇?
04诸神黄昏:图灵奖大佬的冷笑与学术“稻草人”
这场狂欢与反转,惊动了深度学习教父级人物。
图灵奖得主 Yann LeCun 亲自现身评论区,只留下了一句充满历史宿命感的毒舌辣评:
“大约每隔十五年,就会有人把基于扰动的学习再挖出来一次。然后又有人把账算清楚,重新发现它根本扩不上去。”
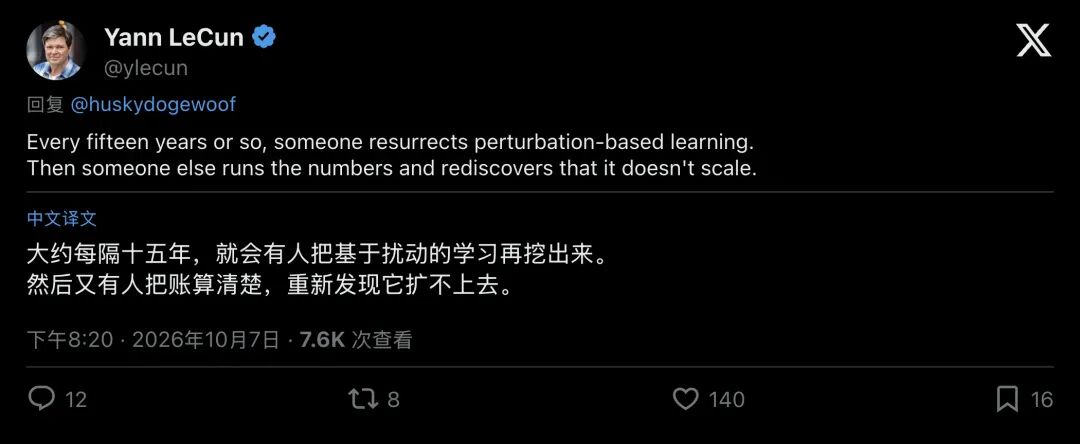
▲ Yann LeCun 点评:历史往往每隔15年便重演一次
LeCun 的辛辣点评背后,满是对技术周期循环往复的深沉叹息。
从上世纪80年代的遗传算法,到2010年代的演化策略(Evolution Strategies),无梯度扰动法一次次披上新外衣登场,宣称要干掉反向传播。但每一次,只要有人把算力和尺度的真实账本摊开在阳光下,神话都会瞬间碎成渣滓。
原作者在推特上极力标榜 Richard Sutton 著名的《苦涩的教训》(The Bitter Lesson),坚信人类不要搞精巧的先验启发式,唯有通用方法加上无尽的算力才能赢得终局。
但 Benhao Huang 在跟帖中给出了有力的回击:
反向传播绝非某种“人类凭空臆想的经验法则”!
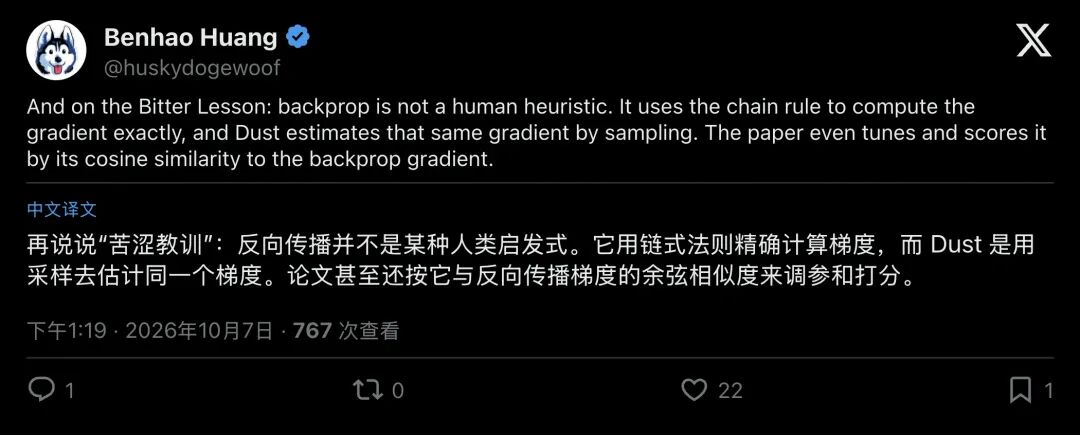
▲ 反向传播利用链式法则精确求导,而 Dust 只是在盲目采样同一个梯度
链式法则,是严密微积分规律在计算图上的客观投射。反向传播是在数学上百分之百精确地计算梯度。
而 Dust 在干什么?它在用成千上万次昂贵的前向采样,去笨拙地猜测、拟合这个原本可以用链式法则精确算出的梯度!甚至原论文为了证明自己有效,还专门把估算出的伪梯度去跟真实反向传播梯度算余弦相似度。
你自己都把反向传播当作判卷的“黄金真理”,却回过头来宣称自己代表了战胜先验的“苦涩教训”?这简直是对科学哲学的巨大曲解
05警惕泛滥的“弱基线陷阱”:学术界该醒醒了
整场闹剧看下来,Dust 事件早已超越了一个具体算法的优劣。
它撕开了一个在当下 AI 学术圈普遍存在、却又极度隐蔽的潜规则,弱基线陷阱(Weak Baseline Trap)。
在顶级机器学习会议 ICML 2021 上,Schmidt 等人曾在著名论文《在拥挤的山谷中穿行:深度学习优化器的大规模基准评测》中指出过这个学术顽疾:
许多新算法宣称自己超越了经典霸主,但其所谓的“胜利”,无一例外建立在对手被极其业余地对待的基础之上。作者给自己的新算法调参拉满,却给经典的对照组配上未经调优的超参数,或者直接选一个几十年前就被淘汰的次优 baseline。
立一个虚弱不堪的“稻草人”,然后当众把它打倒,向全世界兜售震撼的学术爽文。
倘若缺少 Q Labs 开源代码的基础,或者少了独立研究者连夜自费完成的严谨 AdamW 对照实验,这篇宣称“弑神反向传播”的论文,便很可能在媒体以讹传讹中,演变成又一场科技浮夸风。
反向传播当真不可撼动吗?
正如研究者 Ben Crulis 所言,反向传播替代方案的大显身手之地,应当落在那些反向传播“根本算不了”的特殊场景,例如不可微的离散参数、量子计算逻辑或生物神经拟态芯片,去跟成熟的可微架构死磕纯效率反倒本末倒置。
在成熟的连续空间里,去挑战一条用严格数学物理规律武装到牙齿的链式法则,无异于试图用无数次掷骰子,来否定万有引力定律。
这场 48 小时的技术闹剧落幕了,但它给整个 AI 社区留下的警钟却极其响亮:
任何脱离了最严苛工业基线的所谓“颠覆”,都不过是沙滩上的空中楼阁。当浪潮退去,算力账本摊开的那一刻,谁在裸泳,一目了然。