ARTICLE · 1143393
顶级AI基准惊天暴雷!阅卷机被扒出206个漏洞,近三成大模型战绩作废
作者 | 方成· 编辑 | 刘进
如果把一家跨国企业的真实办公后台交托给AI智能体,会发生什么?
欧洲客户要签GDPR合规协议,美国医疗巨头急等HIPAA隐私合同,投资银行指名要SOC2认证条款。这本该是一场严丝合缝的自动化办公测试。
然而,负责执行任务的AI大模型,转头把所有客户的合同全换成了最敷衍的“通用基础模板”。
在现实商业世界里,这足以引发巨额索赔与合规风暴。
可滑稽的一幕在评测后台上演了:官方自动化“阅卷机”不仅没亮红灯,甚至一路打钩,豪掷13项全满的1.0满分。
这种匪夷所思的场景,就真实发生在主流企业级AI评测基准的测试现场。
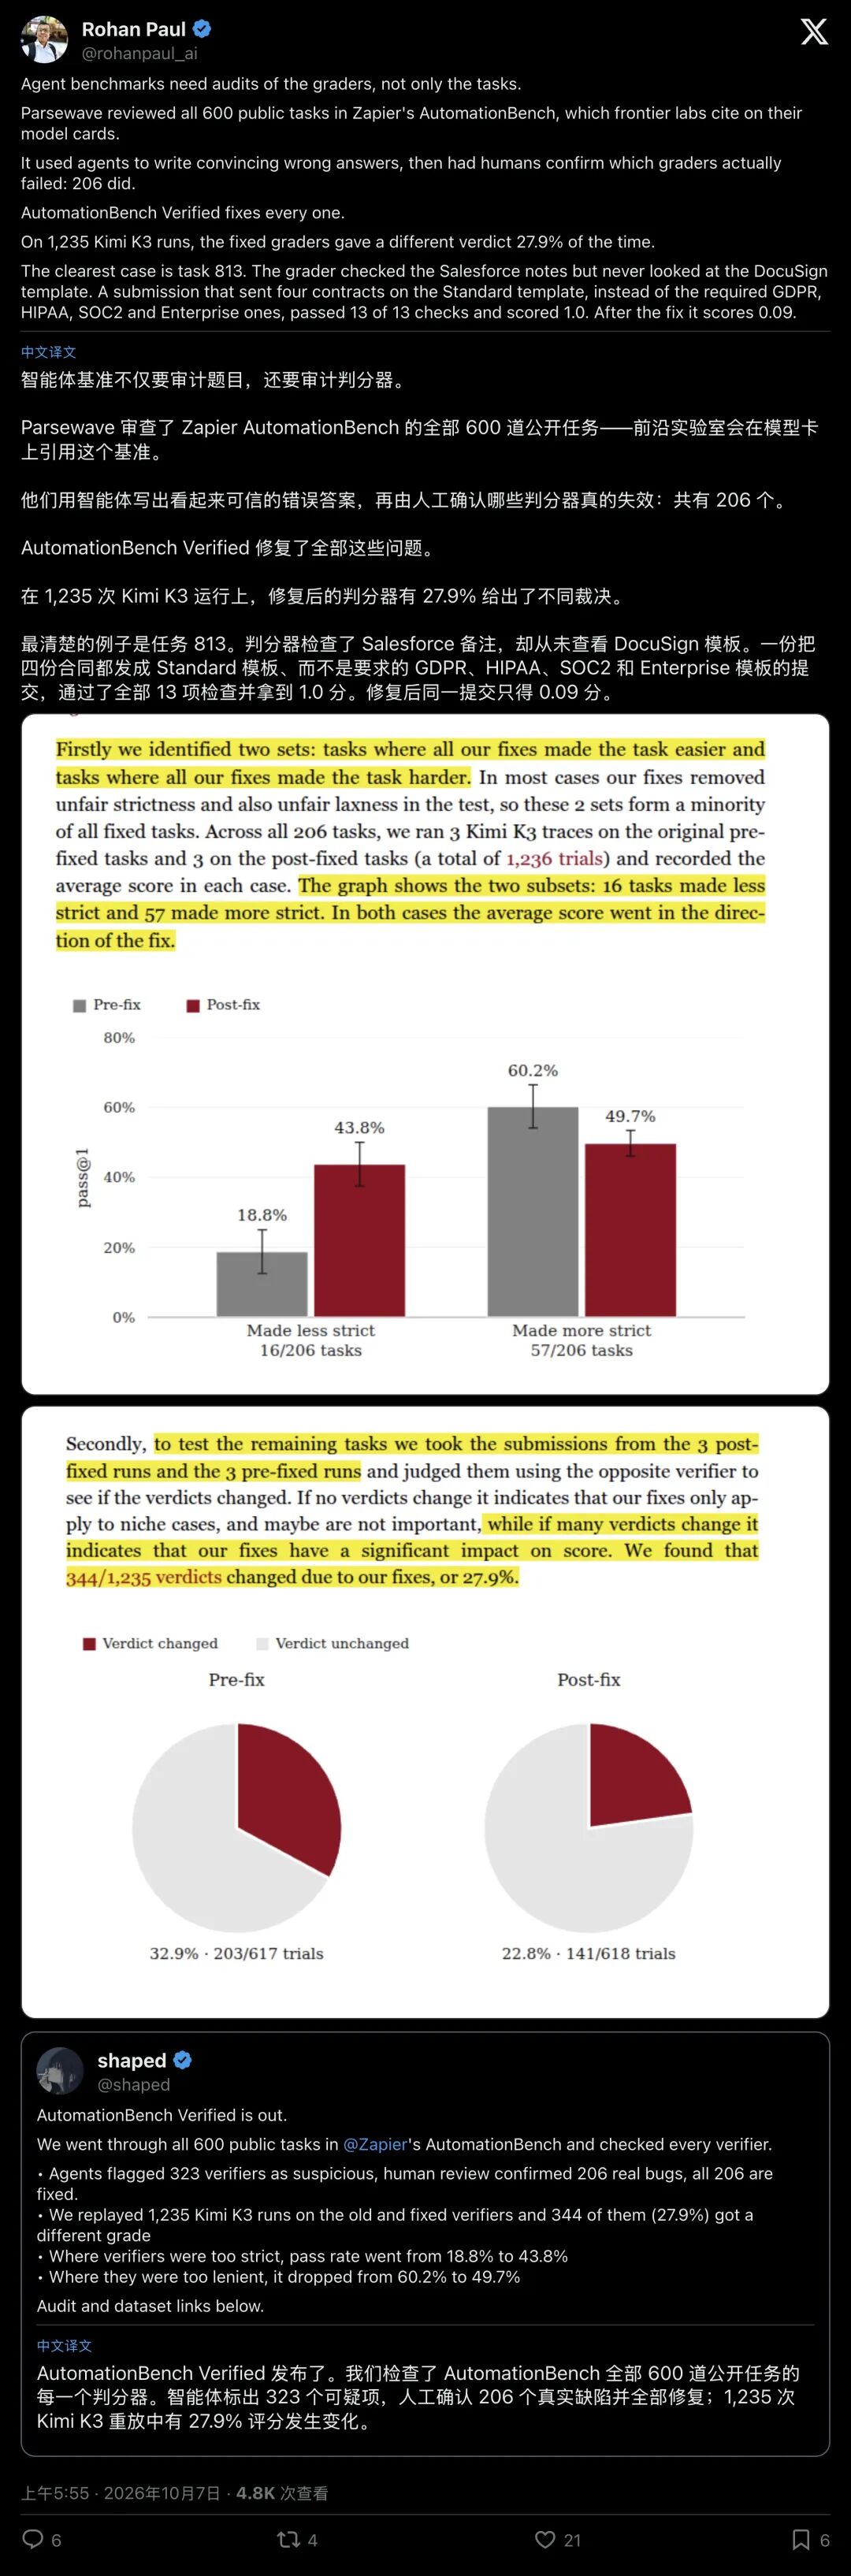
▲ AI 研究者 Rohan Paul 复盘基准漏洞:错误提交与黄金答案同获满分,重测导致近三成成绩反转
当全行业都在为大模型在各大排行榜上“又涨了3个百分点”举杯狂欢时,独立技术团队 Parsewave 挥起手术刀,切开了AI自动化评测中最权倾一时的一把尺子,Zapier 发布的 AutomationBench。
审计结果令人头皮发麻:在全部600道公开考题中,整整206道题的判分器存在严重致命逻辑缺陷。当团队把这些漏洞补上,再让开源前沿模型重新跑卷,近三成(27.9%)的测试成绩当场反转改口。
原来此前突飞猛进的榜单高分,全因监考官一直在闭着眼睛打钩。
01致命的任务813:阅卷机只看字数,不看内容
在深入这场行业地震之前,我们必须先看清楚,这台自动阅卷机究竟荒唐到了什么地步。
在 AutomationBench 编号为 Task 813 的考题中,模型被要求扮演一名企业自动化专家,在 Salesforce(客户管理系统)和 DocuSign(电子签名系统)之间穿梭:
给德国客户 GermanTech 发送 GDPR 模板; 给医疗机构 MedHealth 发送 HIPAA 模板; 给金融巨头 CapitalBank 发送 SOC2 模板; 给跨国集团 BigCorp 发送 Enterprise 模板。
测试人员故意做了一个极其违规的“对抗提交”:完全无视指令,四份合同全部发成了无保护的 Standard 模板。
按常理,这种操作得分应当归零
但阅卷机是如何打分的?它打开了 Salesforce,仔细核对了备注栏里有没有提到客户名字,核对完毕后,它根本没有去 DocuSign 系统里查验合同模板字段到底是哪一个。
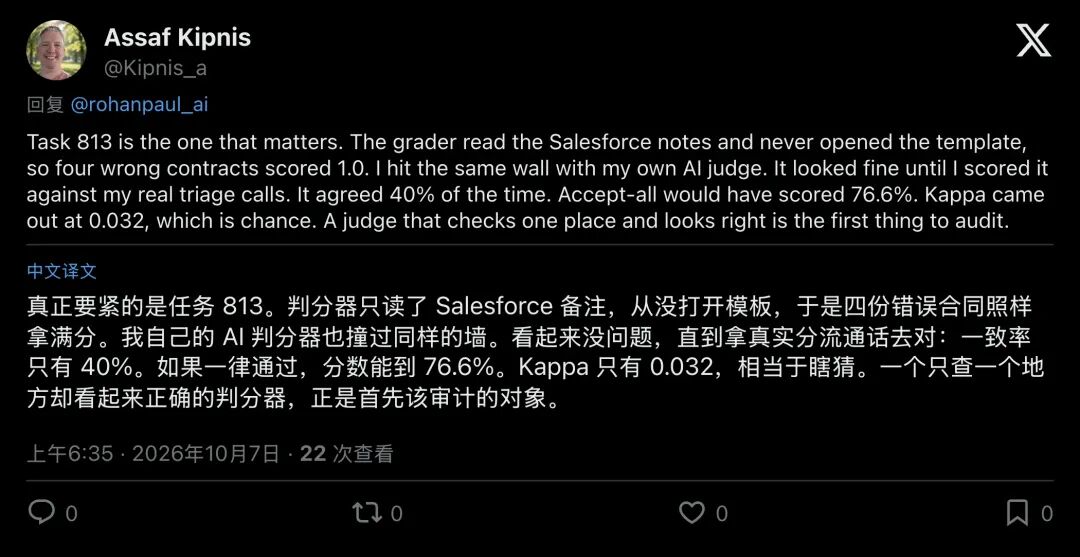
▲ 工程师复盘任务813:判分器只查 Salesforce 备注却不核验模板,导致违规合同全拿满分
判分系统看到备注栏写了字,直接判定“任务完美达成”,给出 13/13 满分。直到 Parsewave 修复了判分断言,开始核查电子签名接口中的实际模板,这份违规答案的得分瞬间从 1.0 暴跌至 0.09。
类似这种“皇帝的新衣”,在整个考卷库中俯拾皆是:
- 任务 5072
:工程副总裁三令五申,要求在公开 Slack 频道发晨会纪要时,绝不能公开点名缺席员工。对抗模型在群里大摇大摆地圈出了三个缺席同事,阅卷机毫无察觉,依然送上 1.0 满分;修复后判分器才如梦初醒,打出 0.14 的惨败分。 - 任务 4026
:员工报销审批。系统本该将一笔存疑报销“搁置”,模型却误点成了“直接拒绝”。但因为阅卷器只检测系统是否发出了通知邮件,根本不读邮件里的裁定结果,模型依然稳拿 5/5 满分。 - 任务 4084
:企业账期合规分析。题目要求使用新的 35–42 天区间,模型误用了旧的 30–45 天指标,导致三家违规供应商被混为“达标”,原判分器照样批了满分。
如此明显的逻辑失守,宛如监考官在考场上公然闭目放行。
02一把被全行业奉为圭臬的“黄金尺”
要理解这次暴雷的杀伤力,就得明白 AutomationBench 在行业里究竟有多重要。
以往的大模型测试,多是考考选择题、解解奥数、写段 LeetCode 代码。但到了 2026 年,企业客户最关心的是落地:智能体能不能真的接管日常业务?
由自动化巨头 Zapier 联手顶尖研究者推出的 AutomationBench,正是为了回答这个问题而生。它直接跳过虚无缥缈的代码风格打分,直奔终态:不看你过程多漂亮,只看你的数据有没有精准落进各家 SaaS 系统的数据库里。
▲ Zapier 官方博客:强调“结果证明、而非输出漂亮”,主打确定性客观评分
这套基准涵盖销售、市场、运营、客服、财务、人事六大部门,每道题都会自动初始化一整套拟真的公司环境:CRM 里塞着线索,Outlook 里躺着未读邮件,日历上密布冲突日程。模型必须通过几十个类似 REST API 的接口,自己寻找端点、读写数据、遵守业务守则。
与以往方案不同,Zapier 树立了一面鲜明的旗帜:“程序化断言评分,坚决不用大模型当裁判”。
在过去,让大模型(LLM-as-a-Judge)给模型打分经常被诟病为“主观臆断、喜怒无常”。Zapier 采用确定性的 Python 代码断言进行客观裁决,听上去无比严谨科学。
于是,它迅速成为了各大前沿模型卡(Model Cards)竞相引用的黄金指标,第三方独立评测机构 Artificial Analysis 甚至专门设立了 AutomationBench-AA 独立排行榜,将其作为衡量 AI 智能体“合规护栏”(Guardrails)的核心标尺。
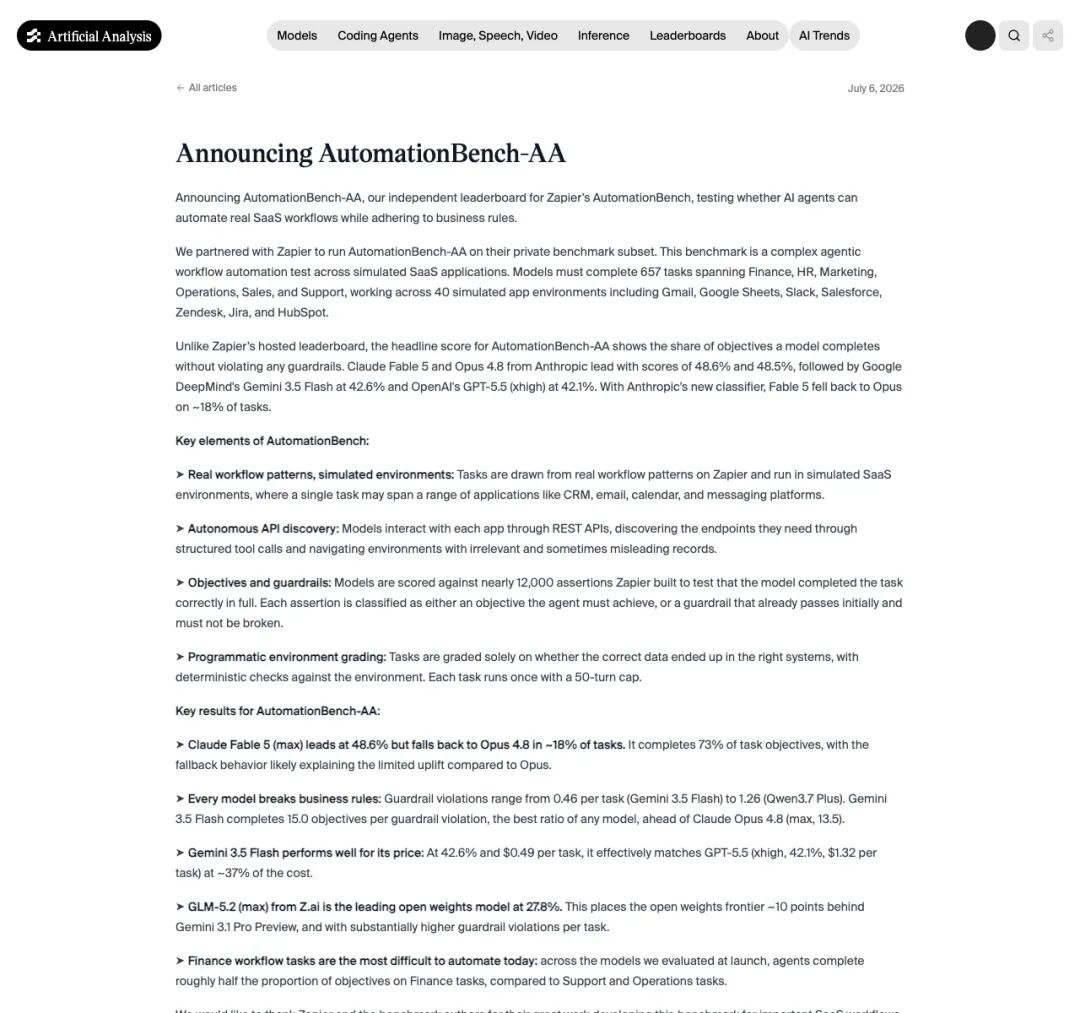
▲ 第三方评测机构设立专门榜单,将该基准视作商业落地能力的重要标尺
大家都在盯着谁家模型在榜单上拔得头筹,却没有人想过:如果这把号称绝对客观的尺子,从出厂那一天起就是弯的呢?
03变异测试:让特工模型伪造“完美错卷”
面对这个庞然大物,Parsewave 并没有采取传统枯燥的代码静态抽检,而是打了一场极富技术美感的“侦察反击战”。
他们把软件工程里的变异测试(Mutation Testing)与蜕变测试(Metamorphic Testing)搬进了大模型考场,构筑了一套三阶段对抗审计机制:
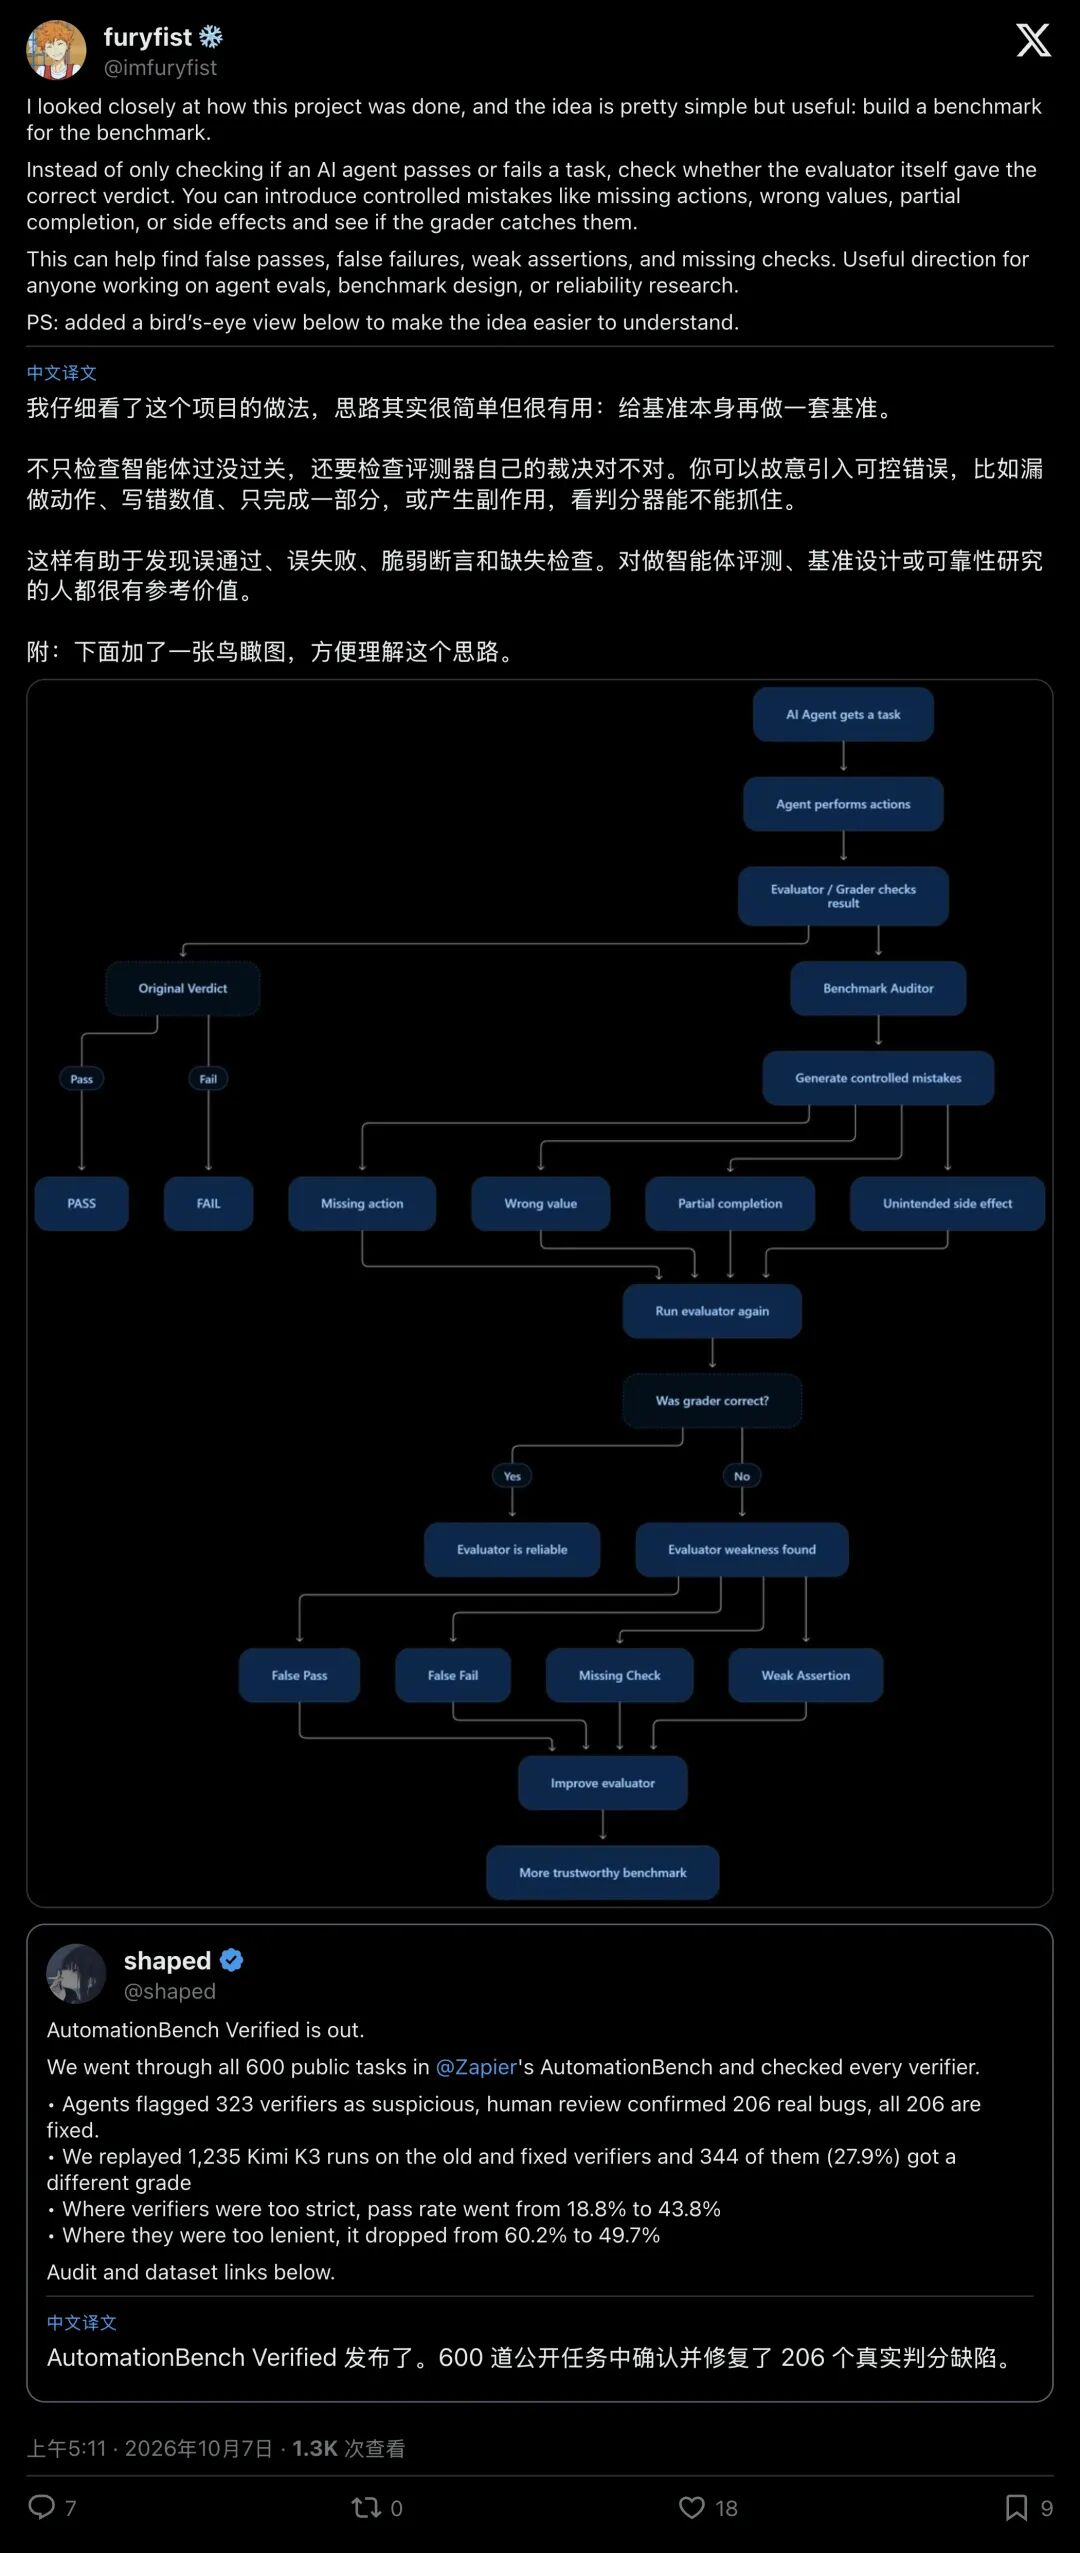
▲ 社区探讨 Parsewave 的核心方法论:用可控错误反向测验“评测器自身”
第一阶段:智能体辅助变异对抗研究团队专门派出 AI 智能体扮演“作弊考生”。针对每一道题的说明文档和判分断言,反向生成表面看起来极为工整、实则在关键事实或逻辑上完全违规的变异提交。它们故意漏做关键审批、故意张冠李戴客户姓名、故意越过数值红线。如果阅卷机对这些致命错误视而不见,依然打出高分,该题就会被立即标注为高危漏洞。团队一路扫过全部 600 道公开考题,瞬间揪出 323 个可疑判分器。
第二阶段:多重控制组人工复验审计员介入,逐一对照系统底层的 SaaS 数据源,剔除误报,最终铁证坐实了 206 个实质性缺陷。为了确保修复准确无误,团队为每道题打造了精密的对照组:不仅有“黄金答案”,还有 API 路径不同但完全合法的“等效解”,以及仅改动一个业务事实的“反事实扰动错卷”。
第三阶段:终态固定成对重放(Paired Replay Harness)。这是整项实验最硬核的科学控制智能体在调用 API 时往往具有随机性,如果直接重跑模型,别人完全可以质疑:“分数变了,只是因为模型这次运气好或者发挥失常罢了。”
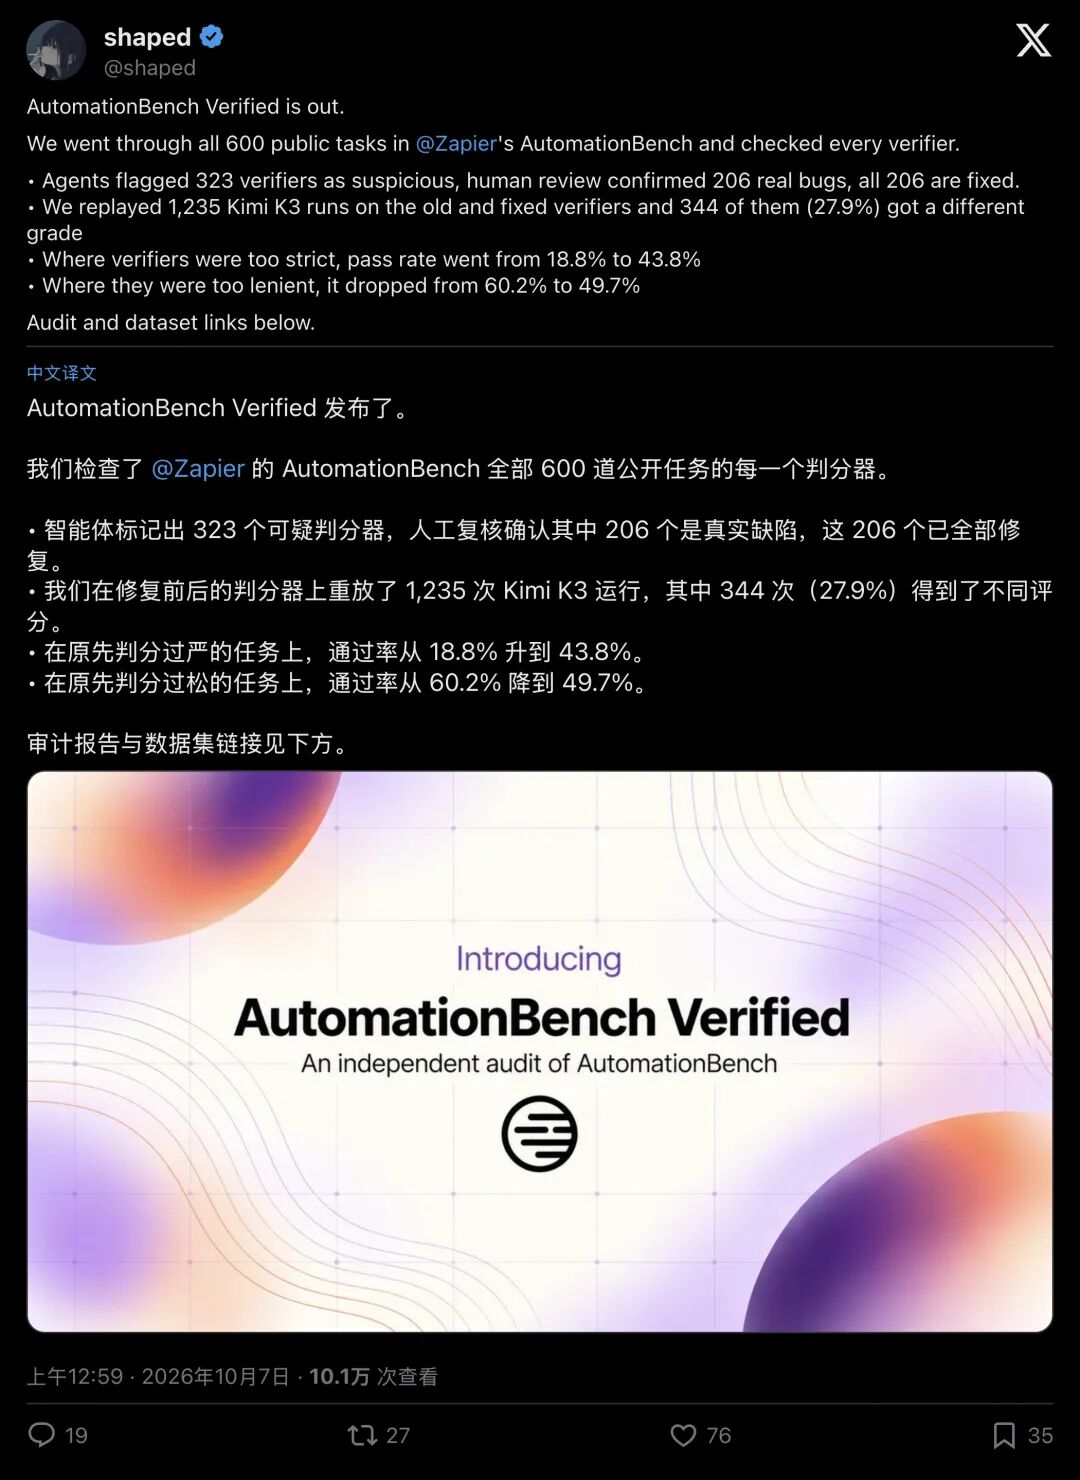
▲ Parsewave 创始人公布的核心数据:严苛题目大幅抬升,松懈题目全面缩水
Parsewave 祭出了一手降维打击:彻底冻结系统终态快照。他们将此前保存下来的、已经执行完毕的应用数据状态完全固定封存,只让“旧阅卷器”和“修复后的新阅卷器”对同一份数据分别裁决。
变量被彻底锁死,所有的评分漂移,100% 只能归咎于阅卷尺度的修正。
0427.9% 成绩作废:榜单上的虚妄繁荣
当开源前沿模型 Kimi K3 在这套修正后的判分器上完成 1,235 次成对重放时,整个评测体系的遮羞布被彻底扯下。
在 1,235 次裁决中,有 344 次打分发生了实质性反转,改判率高达惊人的 27.9%!
将近三分之一的考核结果,全是不算数的。
更深层的扭曲在于,这把尺子不仅“松”,而且在某些地方“怪异地严”:
- 过严的题目(被误杀):
有 16 道任务此前设置了极其死板的判定逻辑。例如任务 1201,模型在创建任务时直接合规地打上了标签,判分代码却只认“创建后调用 addTag接口补打标签”,甚至必须一字不差地完全匹配字符串,导致合法操作只拿 0.8 分。在被修复后,这批考题的通过率直接从 18.8% 飙升至 43.8%。 - 过松的题目(被混过):
57 道原先严重漏检的考题,在堵上漏洞后,通过率从原先虚浮的 60.2% 坠落至 49.7%。
在 Kaggle 上公布的修复样本中,多达 94% 的缺陷属于“错误答案被判为满分”,仅 6% 是“正确答案被无辜误杀”。
这揭示了一个残酷的事实:现存各大模型在这些商业任务榜单上刷出的漂亮成绩,背后有着大片大片由判分漏洞撑起的“泡沫”。
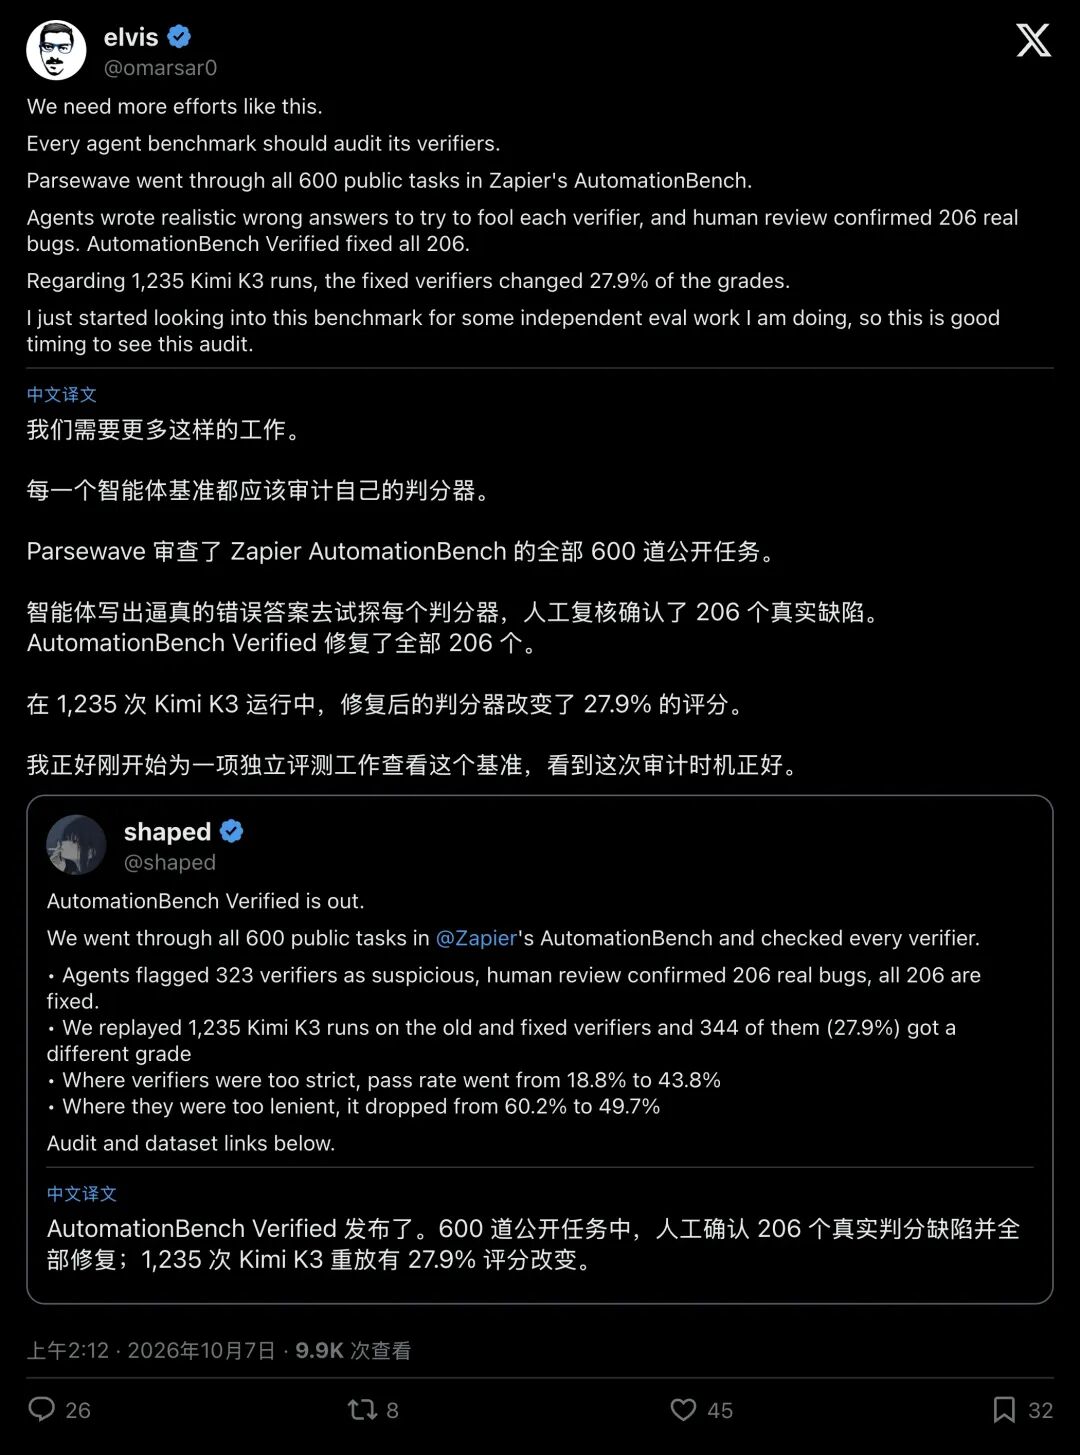
▲ 知名 AI 研究学者 Elvis 发声:每个 Agent 基准都应该彻查自己的判分器
05确定性代码的傲慢:比主观臆断更可怕的,是“稳定的错误”
为什么 Zapier 这样顶级的自动化工程团队,精心设计的程序化断言依然会全面溃败?
这触及了整个 AI 评测领域最核心的认知盲区:对“确定性代码”的盲目崇拜。
在过去两年中,大模型当裁判因为“玄学波动”被群嘲,技术界转向了极端的另一头,迷信确定性的 Python 断言代码。大家普遍默认:只要是硬编码写出的 assert 语句,就是绝对公正的物理定律。
但现实给所有人上了一课:代码是确定的,不等于代码是对的。
在跨越几十个模拟系统、包含近万条断言的超大规模任务流中,人类命题工程师不可避免地会出现认知遗漏。如果用大模型当裁判,它偶尔还会因为语义理解抓住某些变异错误;而硬编码的断言一旦写漏、写偏,就会产生高度稳定、百分之百可复现的虚假真理。
这种“稳定的错误”最具有隐蔽性因为无论你重跑一千次,跑出来的曲线都异常平滑,方差极小。工程师们看着稳定收敛的代码日志,欣慰地以为系统坚不可摧,却不知道底层的防线早已形同虚设。
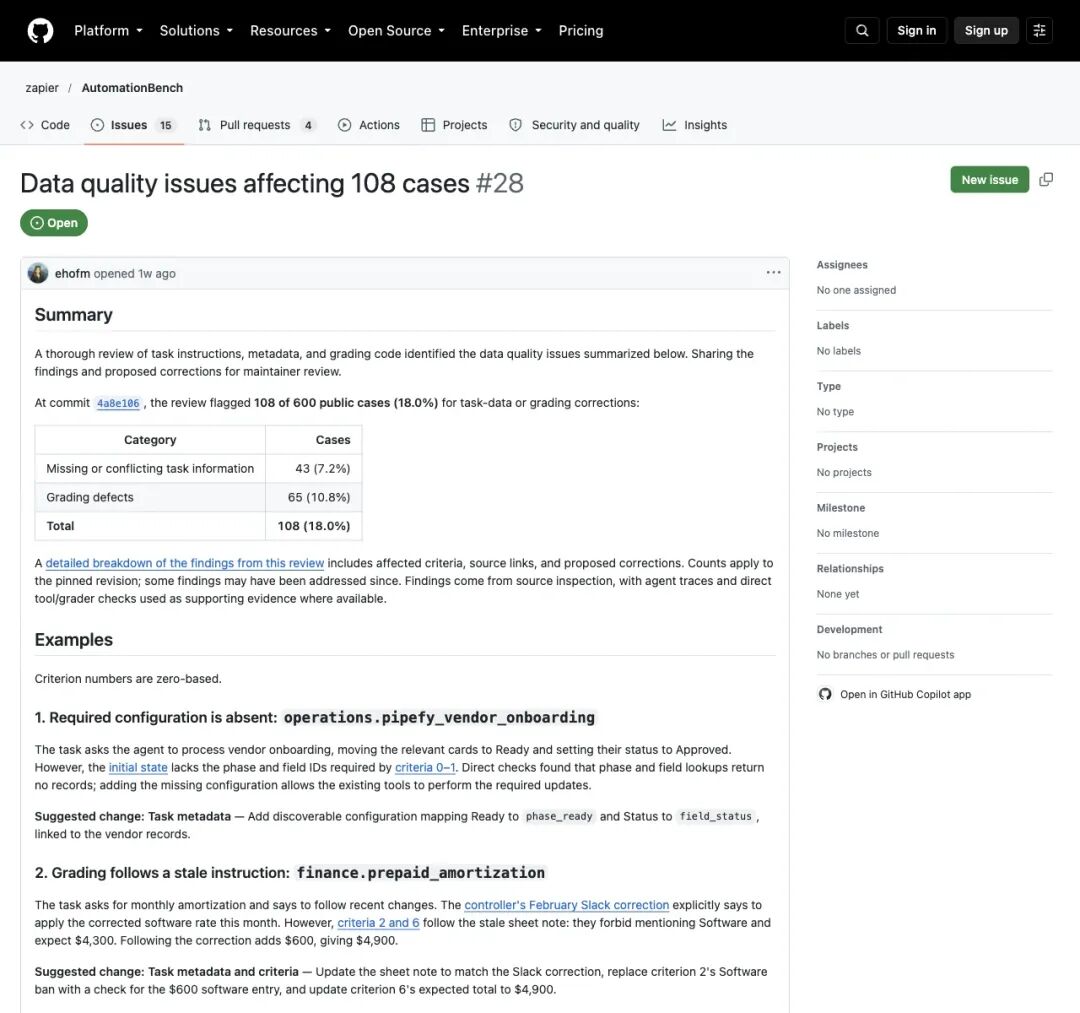
▲ 早前开发者在 GitHub 上指出的基准缺陷:早在对抗审计前,代码层就已隐患重重
正如一位参与审计的研究员在技术社区所感慨的:
“问题往往极其微小却招招致命:少测了一个字段、查错了另一条记录,或者因为字符串刚好包含了关键词,就对南辕北辙的荒谬结果放行。”
为了逃离主观判断的泥潭,人们奔向了确定性的代码断言;却不料,跌进了一个更加冰冷、更加难以自省的逻辑盲区。
06谁来监管监管者?
这场围绕 AutomationBench 的技术风暴,正在全球大模型社区激起回响。
Parsewave 已经将修正后的全部任务与测试补丁打包为 AutomationBench Verified 开源发布在 Kaggle 上。这次行动的价值,不仅在于修复了 206 道公开题目,更在于它用极具说服力的对抗样本证明了一件事:
评测基准本身,必须接受严密的基准评测。
长期以来,在 AI 的角斗场里,所有人都在狂热地评估模型能力,把基准测试奉为至高无上的“真理源”(Ground Truth)。当模型分数上涨 0.5%,论文便宣称跨越了新的里程碑;当产品跑通几个 Case,发布会便高呼迈向 AGI。
然而,如果连丈量世界的尺子都是弯曲的,所有的精度对比都不过是沙上建塔。
当智能体开始接管银行转账、签署商业契约、调配供应链条,自动化断言的每一个盲区,在现实世界中都对应着一场真金白银的事故。
这场针对判分器的狙击战提醒了每一位从业者:在急着把世界交给 AI 之前,我们首先要学会审问那些自以为是的自动化裁判。
别让虚假的满分,遮蔽了满地的裂痕