ARTICLE · 1143702
工业大模型有了国标:AI进电厂,先过这四道硬门槛
2026年7月30日,GB/Z 203—2026《人工智能 工业大模型技术要求》发布。这是第一份给"工业大模型"立规矩的国家标准,从预训练、微调、推理到部署,四个环节全部给出量化指标。对正在往电厂、电网、售电公司里塞AI的厂商和业主来说,这份文件就是未来的采购清单和验收KPI。
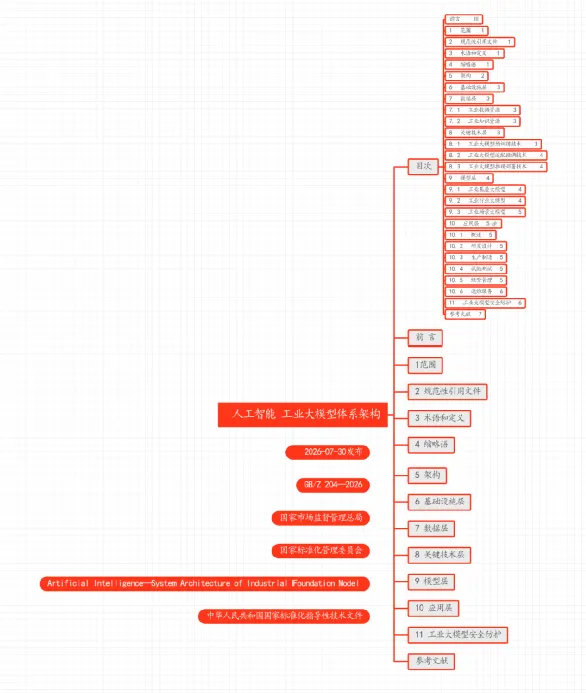
图一 架构总图
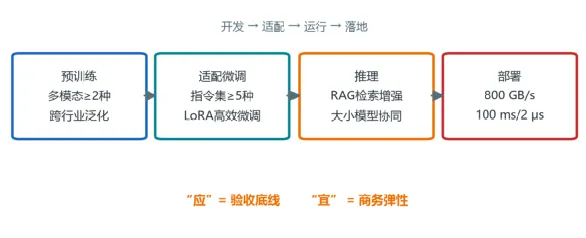
图二 四环节总览
先分清"应"和"宜":一个字,两种合同后果
全文通读下来,最值得注意的不是某个数字,而是措辞:"应"是底线要求,"宜"是加分项。把两类条款分开数一下,预训练环节"应"最多——说明数据底子是第一道关;部署环节量化数字最密集——说明落地验收最容易扯皮。
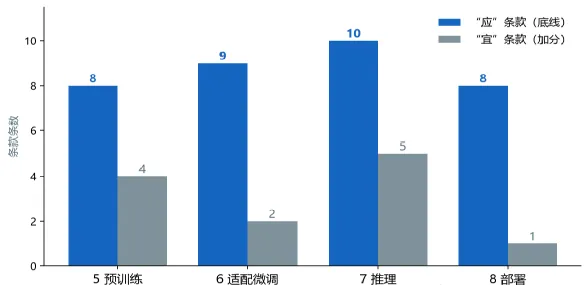
图三 应宜分布
采购技术规范书里,"应"条款逐条对应验收测试项,不满足就是不合格;"宜"条款才是商务谈判里可以换价钱的弹性空间。分不清这两个字,签合同时就已经输了。
四道硬门槛,条条指向电力场景
标准把工业大模型拆成四个环节,每个环节的"应"条款翻译成大白话,就是四道门槛:
·预训练门槛:多模态数据至少覆盖2种及以上模态——工业时序数据(DCS/SCADA曲线)、CAD/CAE文件、机器指令、工业图像,缺了不叫工业大模型;还要支持电力、钢铁、石化等跨行业预训练;
·微调门槛:任务指令集不少于5种——设备健康诊断、生产调度优化、参数调控这些电力行业最关心的任务被直接点名;行业知识微调必须支持LoRA等高效微调方法;
·推理门槛:必须支持RAG检索增强,且要"具备知识库动态更新与版本管理"——模型 hallucinate 一次设备操作建议的代价,在电厂里可能是非停;
·部署门槛:私有化部署的量化指标最扎眼——推理服务器内存带宽≥800 GB/s、TSN网络数据同步精度≤2 μs、蒸馏小模型处理实时数据延迟≤100 ms、云平台日志保留≥3年。
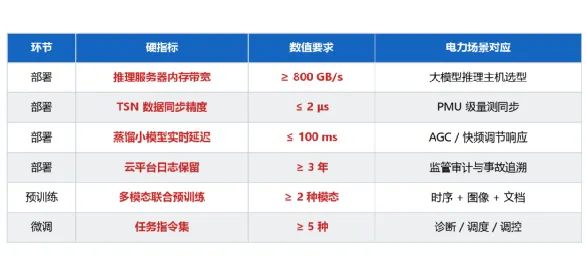
图四 硬指标清单
把这四个数字放进电力场景就明白分量了:100 ms延迟对应的是AGC和快频调节的时间尺度,2 μs同步精度对应的是PMU级量测。标准起草单位里有清华四川能源互联网研究院、石化盈科、中控技术——写的明摆着就是流程工业和能源行业的验收语言。
大小模型协同:电厂AI最可能先落地的一条
第7.2节专门规定了"工业大小模型协同推理":基座大模型管知识、推理和规划,专用小模型管现场实时控制,按任务复杂度和时延要求动态调度,还鼓励"蒸馏机制"把大模型能力迁移给小模型。
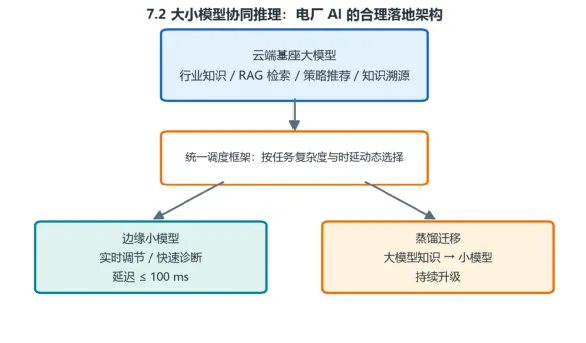
图五 大小模型协同
图六 关键技术层
这正是电厂AI的合理架构:大模型做运行分析、缺陷诊断、检修策略推荐;小模型接进现控做实时调节。之前各家试点系统五花八门,这份标准给了统一的接口和调度框架描述——选型时可以拿7.2节的a)~f)逐条对标。
一个可验证的判断:GB/Z 203会成为"十五五"期间电厂和电网侧AI项目技术规范书的默认引用文件——就像当年的等保2.0之于信息化项目。理由有三条:
·对发电企业:招标时终于有了逐条验收的依据,"你们模型是不是工业大模型"从嘴仗变成对条款;
·对AI厂商:800 GB/s、100 ms这些数字会直接抬高硬件选型门槛,纯软件团队必须提前绑定硬件伙伴;
·对售电与交易团队:7.1节RAG的"知识溯源与引用"要求,恰好是报价辅助工具合规化的技术基础——每一条报价建议都能标注数据来源,这在监管越来越细的现货市场里不是加分项,是入场券。
标准是指导性技术文件(GB/Z),不强制。但参考第一批试点省现货规则的经验:指导性文件先用,用的人多了,就成了事实门槛。