ARTICLE · 1149272
AI小道消息 · 10月10日 05:30
AI小道消息 · 10月10日 05:30我在硅谷看得最清楚的一件事情,就是软件开发已经被 AI 蚕食得差不多了。如果让我选择当前最有价值的一个方向,那就是去做后训练算法或者数据,不论是学习,还是投资,后训练都值得你了解和认识我们理解大模型的后训练,如果只学一个算法,我希望你了解的是 GRPO,现在是工业界最主流的 LLM 强化学习方式之一这个方法是 DeepSeek 团队在 2024 年提出的。用大白话说,就是让模型对同一道题自己尝试多次,再比较这些尝试的结果,通过更新模型参数,让表现更好的生成行为更容易出现。论文:https://arxiv.org/html/2402.03300v3#S4.SS1看完这个帖子,你会明白,那这个“自己学”,到底是怎么发生的?模型做错了一个问题,下一次怎样才有机会写得更好?为什么这个过程非常消耗算力?1/ 先让模型自己尝试我们先准备好任务,以及判断结果好坏的评分规则。这里还是用写代码为例,市面上的所有任务,无论是文科还是理科,都是这个道理举个假设的例子:亚马逊购物车为空时,程序会报错,现在让模型修好这个 bug。把同一道任务交给同一个版本的模型,让模型尝试 8 次。每一次都去读代码、修改、检查结果,可能产生不同的解决过程。你可以认为模型在某些情况下总会蒙对几次2/ 把这 8 次尝试放在一起比较继续用假设来讲,评分程序按测试结果打分:通过得 1 分,失败得 0 分。假设最后有 3 次通过、5 次失败,那么这组的平均分就是:3÷8=0.375得 1 分的尝试,高于本组平均;得 0 分的尝试,低于本组平均。GRPO 就利用这种组内差异,产生学习信号。这里的 1 分和 0 分只是为了简化,实际上各种任务我们都可以有不同的 rubrics 去评判、打分3/ 训练程序根据差异,真正去改模型到了这一步,训练程序会计算损失和梯度,再更新模型参数。训练目标是让高于本组均值的尝试中,那些生成行为更容易出现;低于均值的则受到抑制,那更新完参数后的模型,就更容易产生我们认为好的答案更新完,再拿一批任务让模型尝试,继续比较、继续学习这就是这里说的“模型自己学”:模型负责尝试,评分规则负责衡量结果,训练程序负责更新参数。 任务怎么选、什么结果值得奖励,仍然需要训练者设计。4/ 最后看模型有没有真的进步我举一个具体的例子,用 500 道软件工程任务,对 Qwen3.8-27B-Medium 做了 15 次训练更新后,模型在 DeepSWE 上的平均单次成功率,从 27.8% 提高到 39.1%,增加 11.3 个百分点。1我觉得这件事值得关注的地方,是模型自己尝试产生的结果,可以继续用来训练模型。其次,在强化学习的过程中,模型要不断地去推理、尝试,每一次都是一次训练的消耗但做强化学习,人类的工作也正在这里非常重要:要让模型有值得尝试的任务,再让尝试的结果变成有用的反馈。任务和奖励怎么设计,直接关系到模型最后在学什么。短期之内,我觉得人类还无法被替代,特别是在 rubrics 和 alignment 这块儿 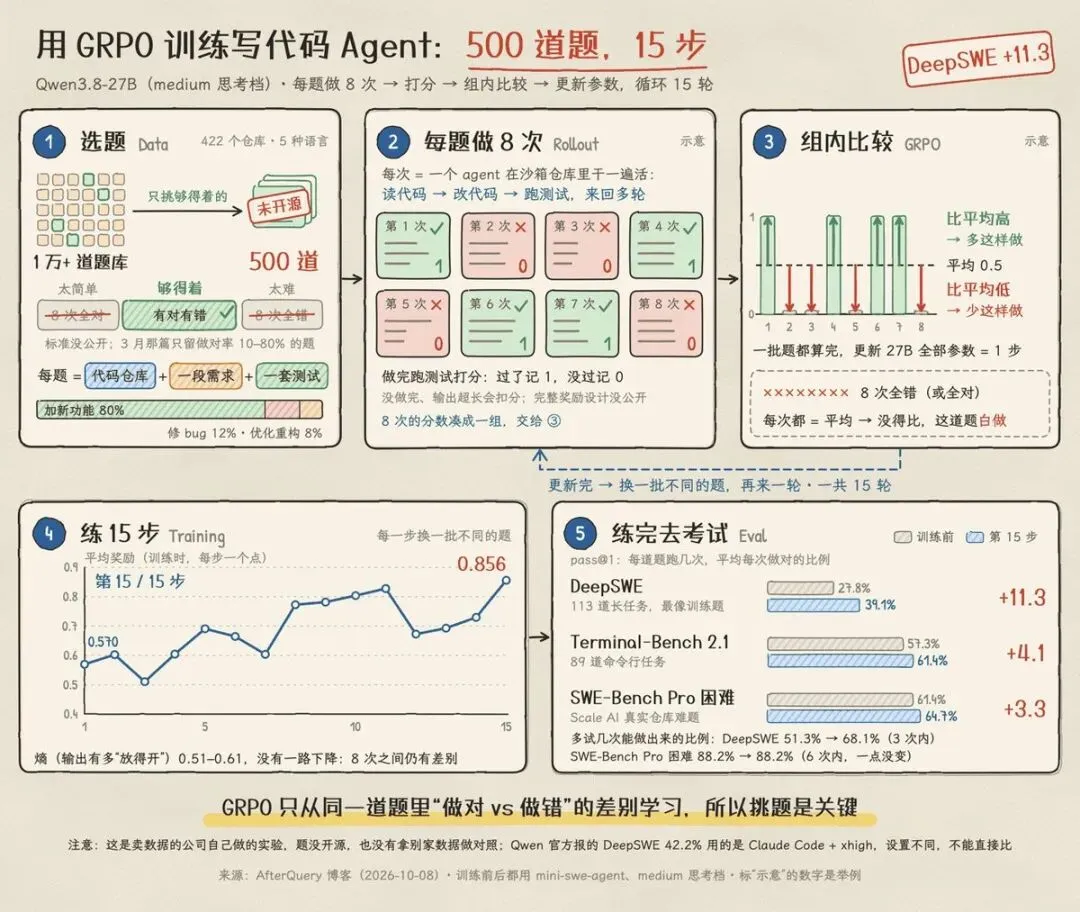
如果你会 AI,但是不投资,那就有点亏大了不论是投资 $MRVL $AMD 等一众算力互联标的,还是 AI Infra学习,收藏搞懂我这篇帖子,对你帮助都一定会很大算力发展远远不足,早点搞懂,就能早点把握住机会。不信你看下去为什么OpenAI 想要提供快的推理速度,就得牺牲订阅额度上限,这个帖子是我认真整理的内部流程,看懂了它,你会更加得心应手。1/ 我先来说两个指标> TTFT (Time to First Token),它来衡量你发出一条消息之后,OpenAI 多久响应吐出第一个字。> TPOT(Time per Output Token),这个来衡量你总体的体感速度,以及什么时候完成?你总的等待时间约等于 TTFT 加 n 乘以 TPOT,n 就是你的 Token output总量,就是 AI 给你回了多少话你可以大致粗略地记一句话。1 个 GPU 如果只给一个用户用,那么两者的速度都会很快,但互联的速度跟不上,因此 GPU 会有闲置时间,会导致浪费那聪明的厂商就把一个 GPU 分给多个用户,这样 GPU 的闲置时间被充分使用了。但每个用户因为 GPU 调度需要等待的时间就会变长,导致整体速度变慢2/ 那 GPU 内部在推理的时候,到底发生了什么呢?我做推理优化,这个循环是每天都要打交道的东西。我把一个请求在推理引擎里走的 5 步画进了一页动图,先说结论,后面按图的顺序讲1. 请求进来不会直接上 GPU,而是先进调度器,由 CPU 驱动。GPU 每跑一步,调度器就重新挑一次人,批次每一步都在换人,这叫 continuous batching2. 评估推理服务,工业界盯三个数,吞吐、出字间隔 ITL、首字延迟 TTFT,而且要看 P99, P50,需要有统计意义3. 这三个数互相拉扯,决定了用户的成本和总的等待时间,总的来说是一个权衡(trade-off)3/ 先过一遍图里的 5 步① 新请求带着整段 prompt 排队② 调度器每一步开跑前问三件事:已经在跑的先上,本轮 token 预算还剩多少,KV cache 的格子还够不够③ 能上的拼成一批。新来的做预填(prefill),整段 prompt 一次算完;老的做生成(decode),每人只写 1 个 token④ GPU 把这一批一起算一步⑤ 写完的释放格子离场,没写完的回到 ②,马上开下一轮2022 年的 Orca 论文把调度单位从“一个请求”改成“一步”,在 GPT-3 175B 上,同样延迟下吞吐做到了 FasterTransformer 的 36.9 倍 [1]。现在 vLLM 默认就按这一套在排 [2]想搞投资,相信你看到这儿已经差不多都懂了。想入门推理,我的建议是先把这个循环自己画一遍,再去读压测报告,每个数都能对回其中一步这里边的水很深,后续我会逐渐跟大家讲解,结合每天的信息以及具体实践,帮大家搭建起科技到投资中间的这座桥梁出处[1] Orca: A Distributed Serving System for Transformer-Based Generative Models,OSDI 2022 https://www.usenix.org/conference/osdi22/presentation/yu[2] vLLM 文档,Optimization and Tuning https://docs.vllm.ai/en/stable/configuration/optimization/[3] Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve,OSDI 2024 https://arxiv.org/abs/2403.02310[4] vLLM 文档,vllm bench serve https://docs.vllm.ai/en/stable/cli/bench/serve/ 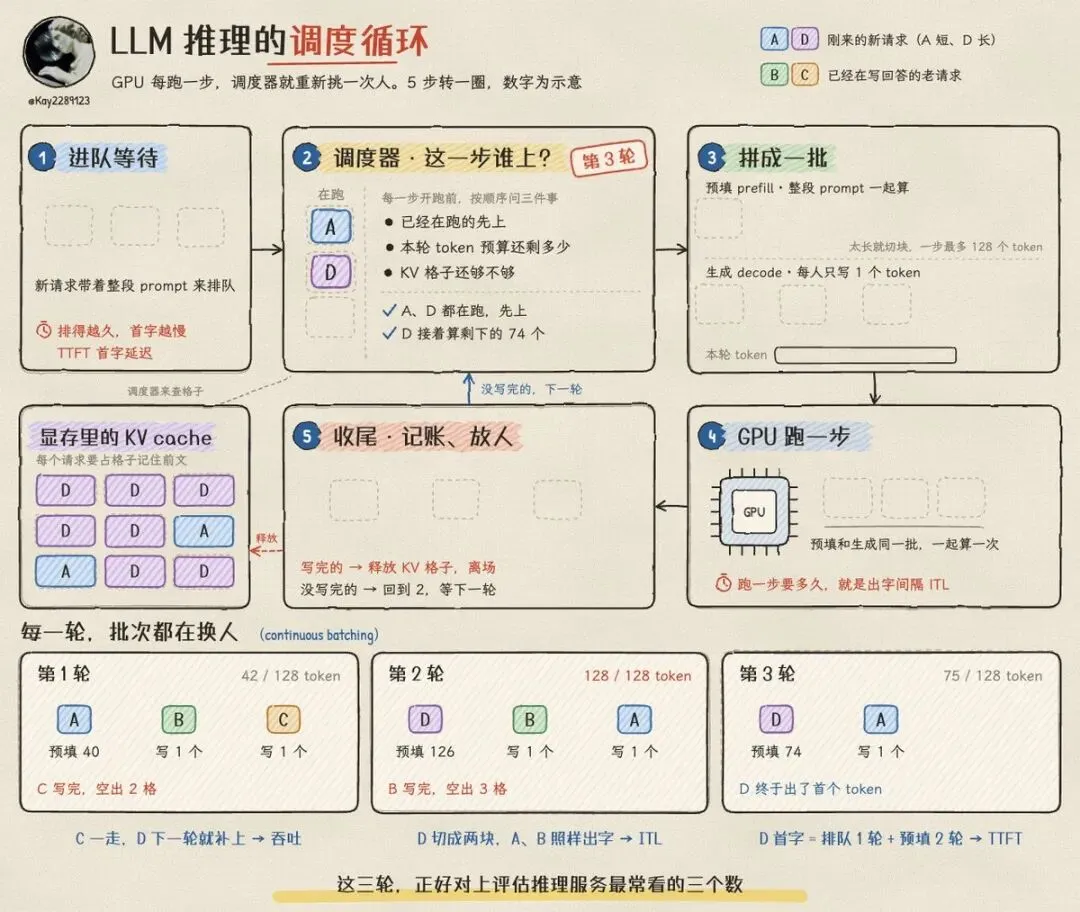
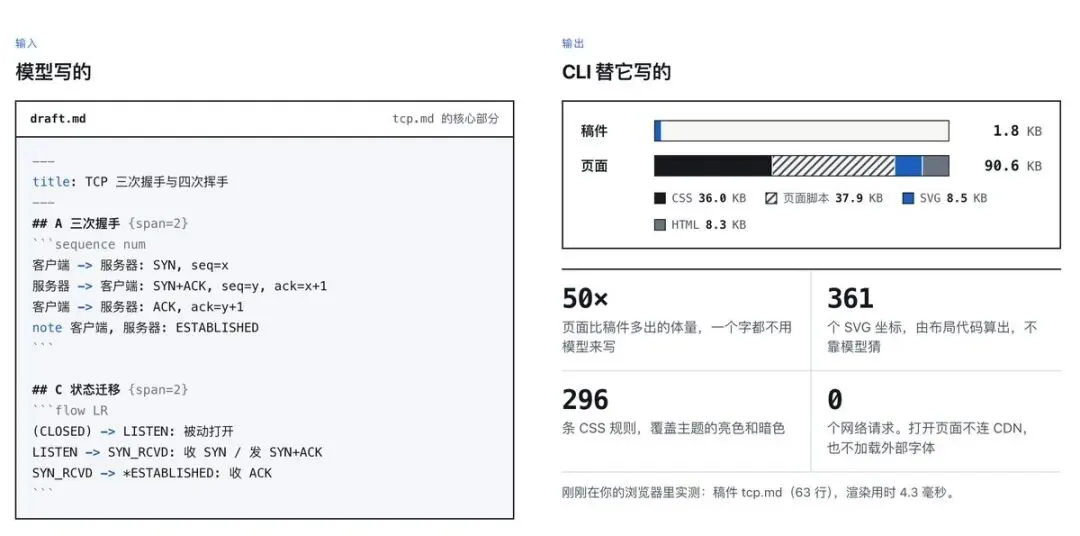
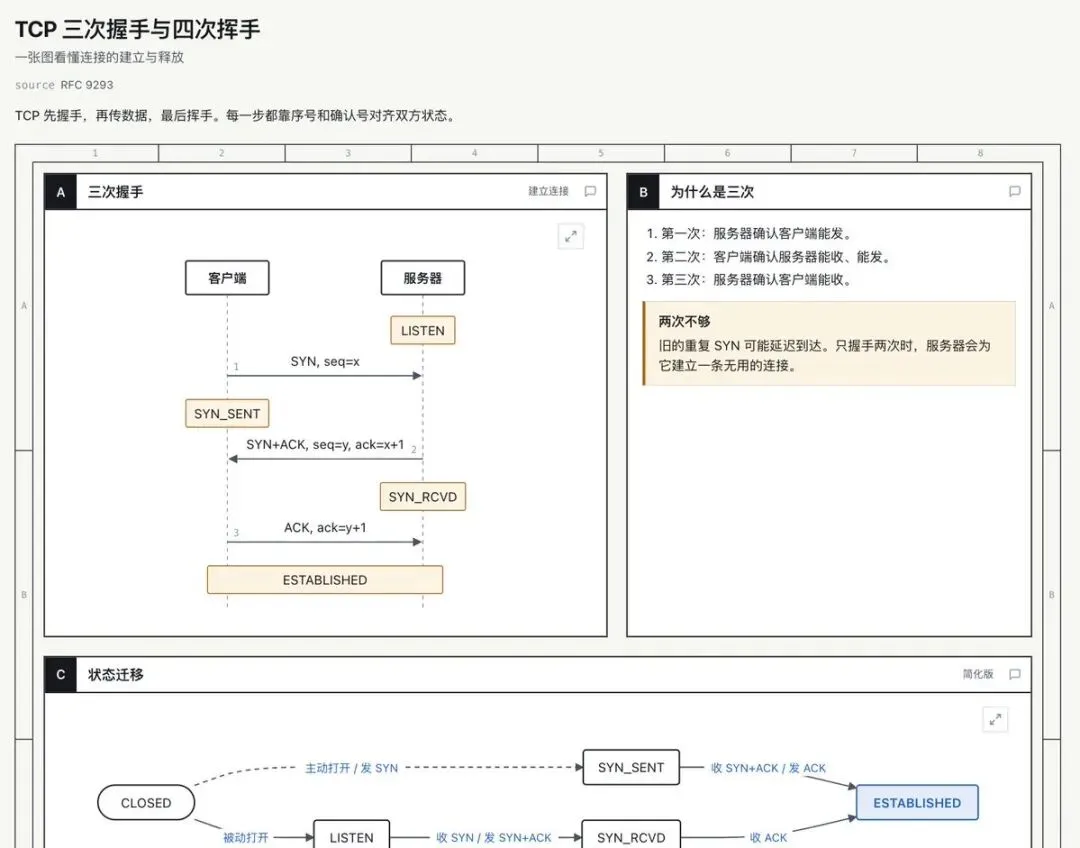
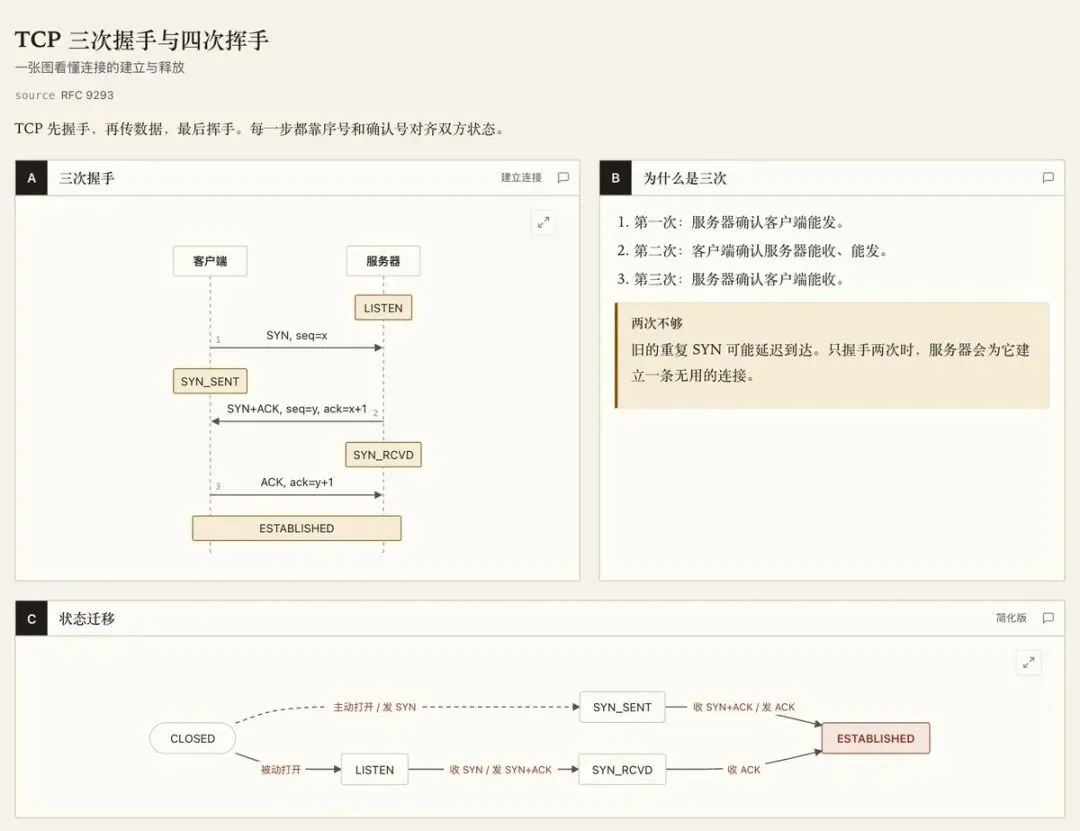
Agent 讲了一大堆,看了半天没看懂,人还累着了?😢介绍一下 skill: answer-me-with-html 🔥 (仅一周 2.4k star)1. 又快又省: 比常规手写 html 快 3 倍,token 省 7 倍,还不出错!2. 讲解视频:把文字转换为视频,比常规方法快 11.8 倍,省 17.8 倍 Token!3. ASD-STE100原则: 航空维修手册原则,让 Agent 说人话!!4. 多语言 & 多主题:总有一款主题你喜欢,支持自定义!! 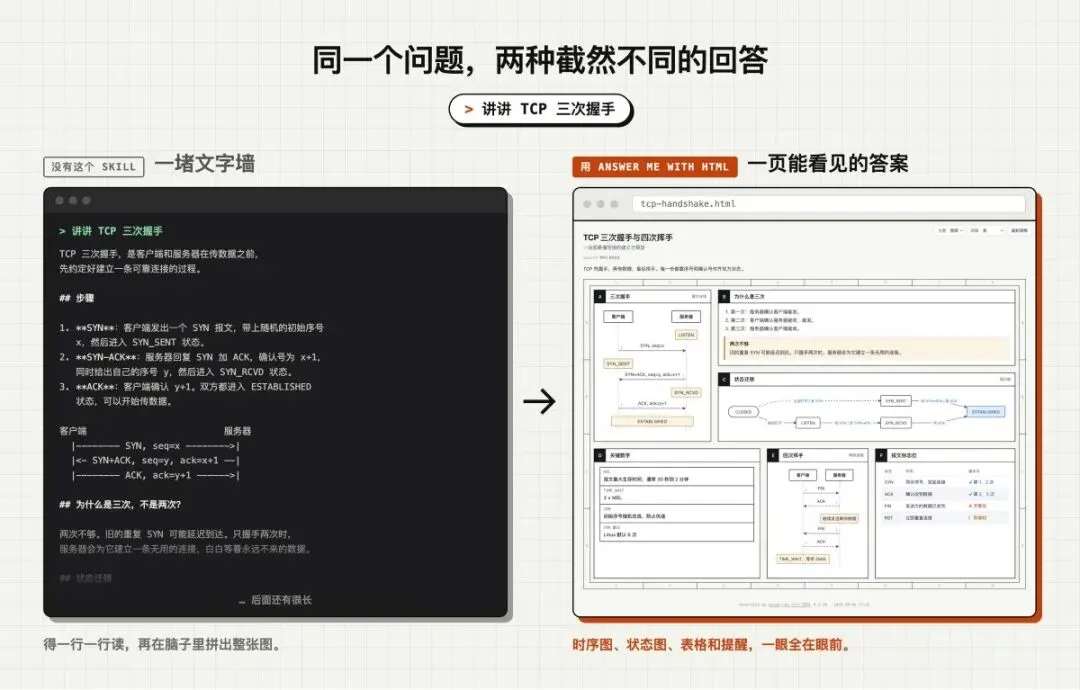
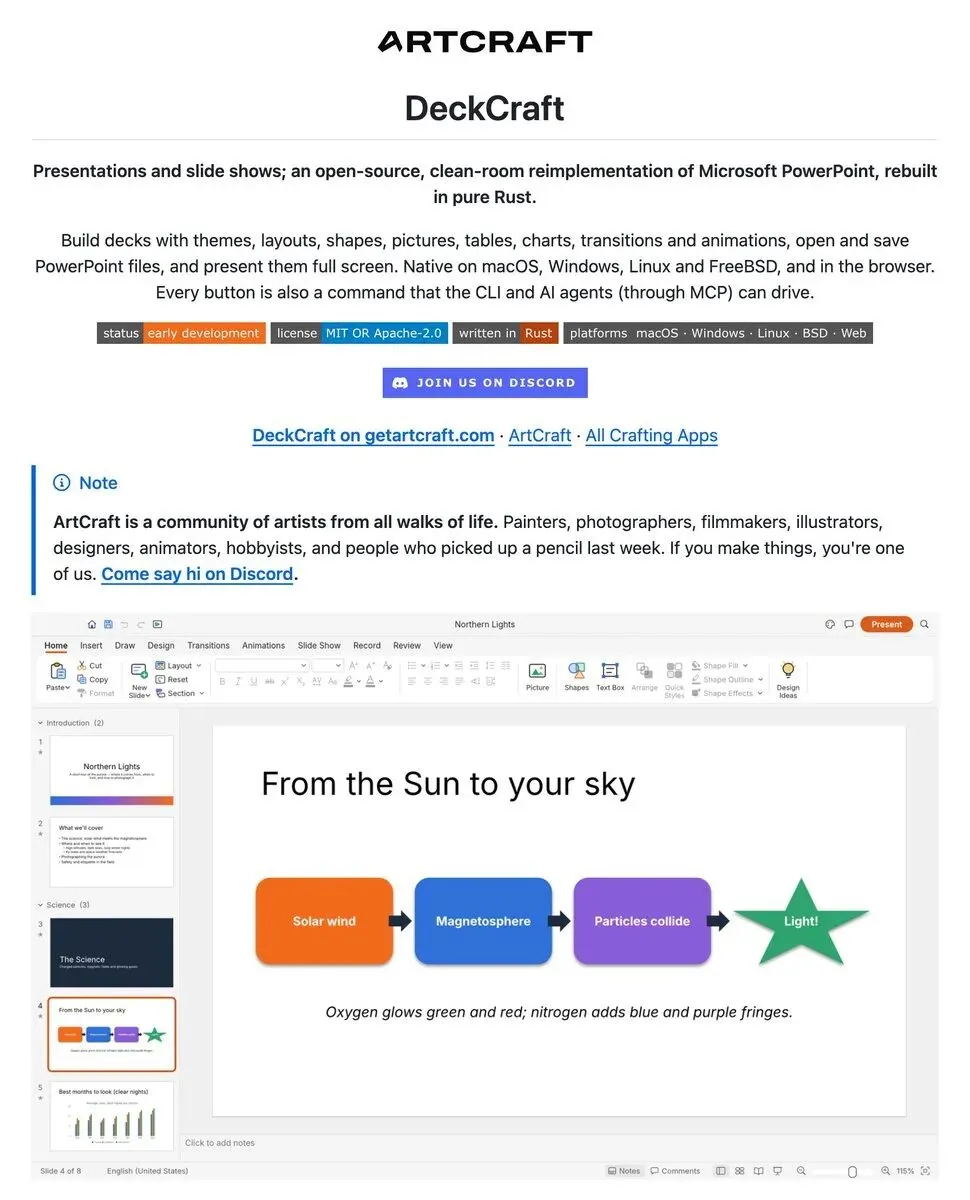
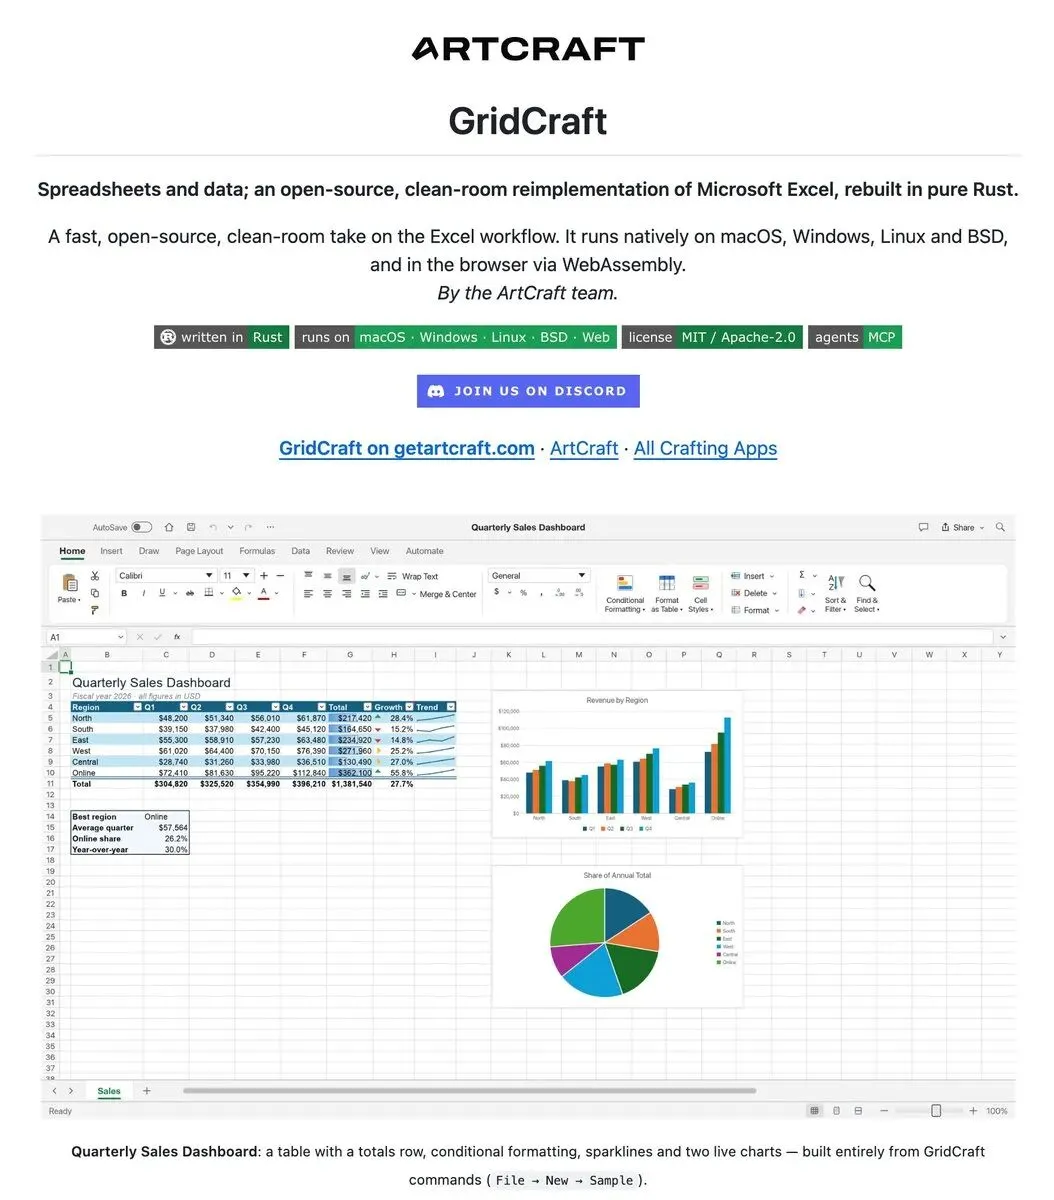
那个复刻 Adobe 全家桶的 **Craft 开源项目,现在又盯上 Office 了:PPT -> deckcraftWord -> wordcraftExcel -> gridcraft@get_artcraft 开源项目https://github.com/orgs/storytold/repositories 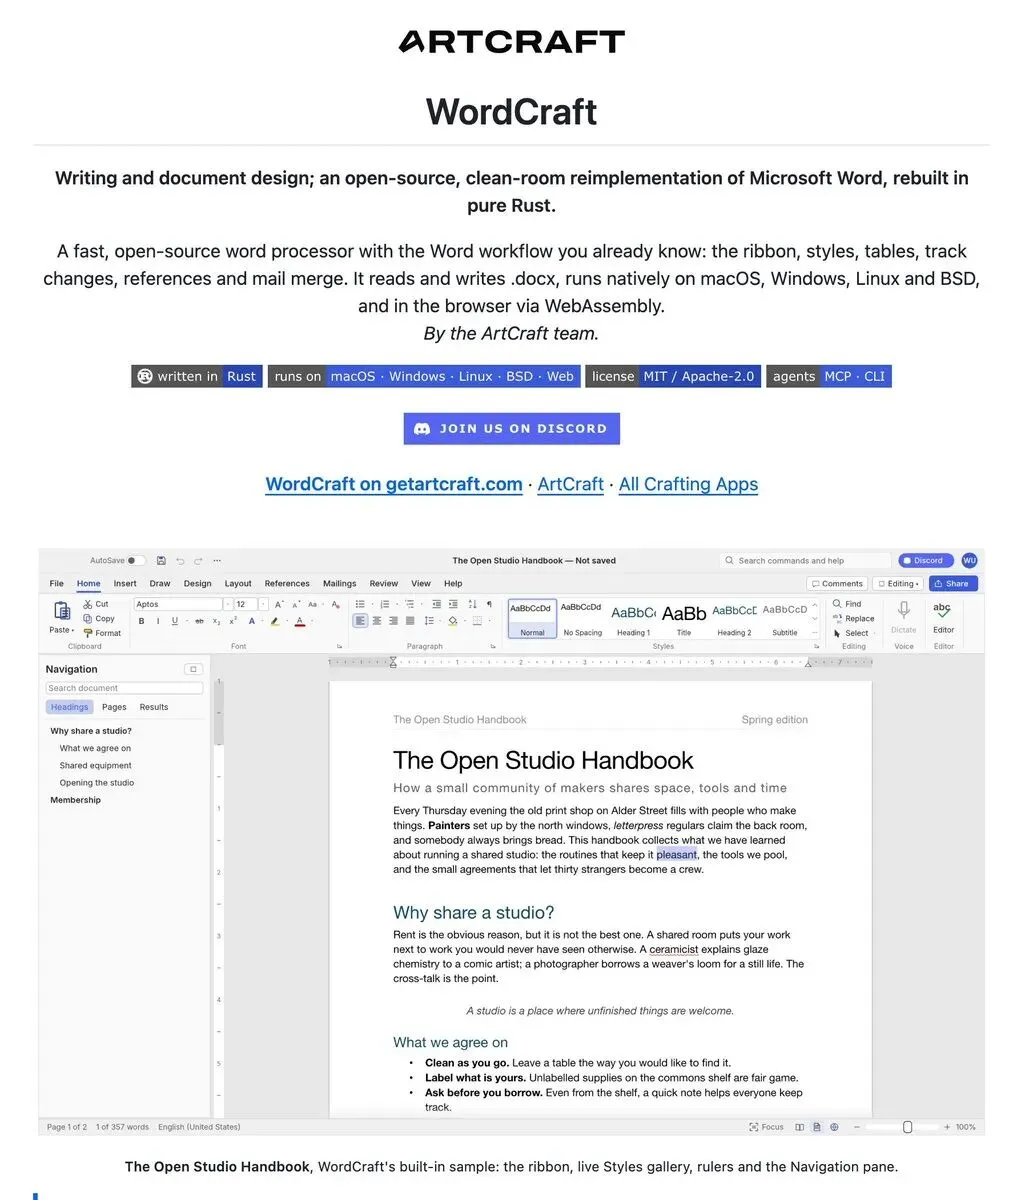
黄仁勋和库克结了十几年的梁子,估计真要被几个搞 Vibe Coding 的老哥给干沉默了。海外有开发者靠着大模型狂灌提示词,硬生生搓出了一个能在现代 macOS 上跑的英伟达显卡驱动。折腾过黑苹果的都知道这事有多离谱。当年苹果为了推自己的 Metal,直接把英伟达赶尽杀绝,High Sierra 之后官方 Web Driver 彻底断更,底层驱动接口一个字都不公开。写 GPU 驱动向来是程序员眼里最折寿的黑魔法:硬啃反汇编、盲猜硬件寄存器、逆向私有微码,开源社区当年为了搞 Nouveau 驱动,几代顶级黑客掉了几万根头发都搞得半死不活。结果现在倒好,几个老哥带着大模型,把内核接口文档和反编译出来的规格往上下文里一倒,硬是让 AI 照着 DriverKit 一行行把驱动代码全给焊了出来,当场把老黄的卡在 Mac 上给点亮了。按这个离谱的解构速度,下一步这帮人真敢找路子把 Arch Linux 顺手刷进 iPhone 里。大厂以前总觉得底层闭源、协议不公开就是不可逾越的护城河。当反编译和写内核脏活的门槛被模型直接砸穿,商业公司筑了十几年的高墙,恐怕真要被冲得渣都不剩了。 很多人喜欢把各种规则、工作流程都写进Memory(记忆)但其实,不管是Claude还是Codex,Memory都是有上限的。工作流一多,AI执行任务时,可能会把一堆规则都读一遍。我的做法只有一句话:让Memory做索引,让Skill存规则。Memory只负责告诉AI,这个任务该读哪个Skill。具体的规则、SOP、操作手册,全都写进Skill,不要写进Memory。这样有两个好处:规则不容易被挤掉 工作流之间也不会互相干扰 AI 画的流程图太丑?试试这个 Skill作者每次让 Claude 画图,出来都是普通圆角框,还得自己去 Figma 调半天后来干脆做了个 diagram-design,把配色、字体、布局的要求写进 Skill,开源了你可以理解为,给 AI 配了一本画图手册,让它画出来的图像点样子!!架构图、流程图、时间线、甘特图,支持 42 种图Claude Code、Codex 都能用而且可以读取你的网站,照着你的配色和字体来画放进文章里风格也能对上但它不光能从头画,你已有的 Mermaid、http://draw.io、Excalidraw 图也能交给它重新画一版生成的是 HTML + SVG,浏览器打开就能看后面想改字、调布局,还能继续让 AI 改浅色、深色、杂志风都有,效果看配图👇https://github.com/cathrynlavery/diagram-design 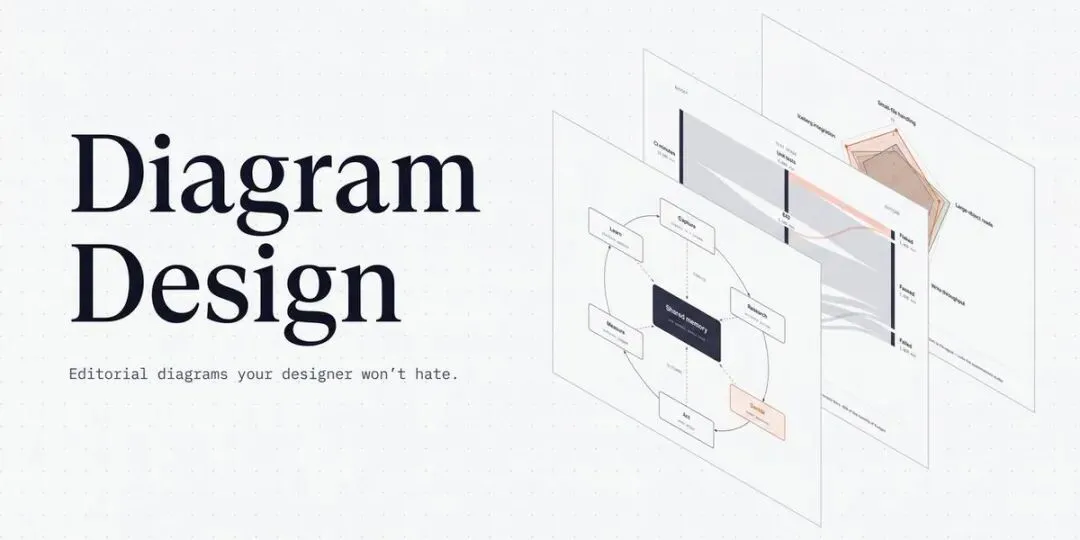
本期速览
01 GRPO用组内比较驱动模型自强化
02 answer-me-with-html省Token提速
03 Craft三工具开源Office替代
04 大模型生成macOS英伟达驱动
05 Memory只做索引Skill存规则
06 diagram-design让AI画图支持42种图
01|GRPO用组内比较驱动模型自强化
来源(X) · @Kay2289123 · 2026-10-10 00:54
引用内容
美研芒格君 @Kay2289123
02|answer-me-with-html省Token提速
来源(X) · @smk7z · 2026-10-09 20:10
03|Craft三工具开源Office替代
来源(X) · @shao__meng · 2026-10-09 18:23
04|大模型生成macOS英伟达驱动
来源(X) · @RealYDT · 2026-10-09 22:39
05|Memory只做索引Skill存规则
来源(X) · @nini_incrypto_ · 2026-10-09 23:40
06|diagram-design让AI画图支持42种图
来源(X) · @lxfater · 2026-10-09 09:30