ARTICLE · 1149266
让 AI 一次读懂 3 万行代码:我给项目建了张"认知索引",附踩坑清单
先给结果。我拿自己手上这个商用项目(微信小程序 + Node 后端)试了一遍:1340 个文件、2.8 万行代码,压缩成 6446 个 token 的一张纯文本地图。
压缩比约 3.6:1。听起来不夸张,但意义不在比例,而在这份地图是持久的:它跟代码一起存在仓库里,被 Git 版本化,AI 每个任务开局读一次,之后就不用再把整个仓库翻一遍了。
每个文件一行,四个字段:
一条真实的(我这个项目里的水印组件):
F 说它是干什么的,R 是必须一起读的文件,A 是别人依赖它的什么,S 是看代码看不出来、但改的人不知道就踩坑的东西。
下面是我这次真实生成的几行(可直接在仓库里的 aoci.code.txt 看到):
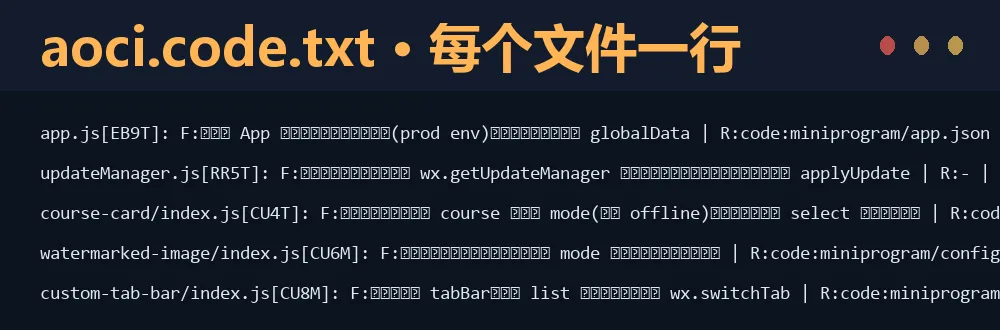
S 这条最值钱,也最容易写坏。规矩是:宁可写 - 也不能编。写了 - 是在声明"我查过了,这里没有坑"。
本地跑、不联网、不上传代码。想让它自动维护,就把 MCP server 配进你的 agent;配完记得重启宿主并在连接器里点「信任」。
起 stdio 子进程发 JSON-RPC 就行,但顺序不能省: 先 initialize → 必须再发 `notifications/initialized` → 才能 tools/call。 少发那条通知,tools/call 会被拒。脚本我放进仓库了。
scan 很快,1340 个文件 2.25 秒。真正的成本在写条目:
官方口径是 20 万行约 1 小时(按模型速度浮动)。我这次只写了前 54 条,用来验证流程,剩下的留着慢慢补,这东西本来就支持渐进建立。
扫描是免费的,写条目才是成本。动手前先想清楚要建到多细。
一、项目不是 Git 仓库,直接卡死。 AOCI 的认知对象就是 Git 跟踪的文件集合。我这个项目原来没进版本管理,第一步是 git init + 首次提交。
二、不写 .gitignore,认知预算被打爆。 第一次 git add -A 把 node_modules、日志、上传文件全带进去了,索引预估冲到 61.8 万 token。补了标准 .gitignore 后降到 14.8 万,差 4.2 倍。 尤其要排除 AI 工具资产目录(.cursor/、.workbuddy/ 这类)。现代项目里它们动辄几千个文件,全是技能文档,跟业务代码一点关系没有。
三、别去改 `.aoci/config.json` 的 exclude_dirs 收窄范围。 会让策略身份漂移,后面所有 maintain 全变 repair_required。 用 scope rule add --action exclude 大批量排除也不行——超过 25% 阈值会被判为高风险变更,要求真人在终端手敲确认串,脚本里过不去。 正解是从 Git 源头解决:写进 .gitignore 再 git rm -r --cached(磁盘文件保留)。认知对象本来就来自 git 跟踪集合。
四、标签格式照文档字面写会被拒。 官方样例是 4 位紧凑形式(main.go[EG7T]),但合同字面写的是 A+B+C+[D]+E,照字面中间插个 -,结果整批拒收:
还有:模块位(第 2 位)不能用 `F`,配置类文件用 C。 我第一轮 28 条全被拒,连修三轮(14 → 10 → 0)才过。
我故意在一个已索引文件的末尾加了一行注释,然后跑 maintain:
它精确知道是这个文件、这条条目过期了。
原理不玄:基线里存了每个文件的源码 SHA-256,改动后哈希对不上即判定漂移。 不看时间戳,也不靠 AI 猜。改完代码跑一次 maintain,它把过期的条目列给你,你(或你的 agent)只更新这几条。
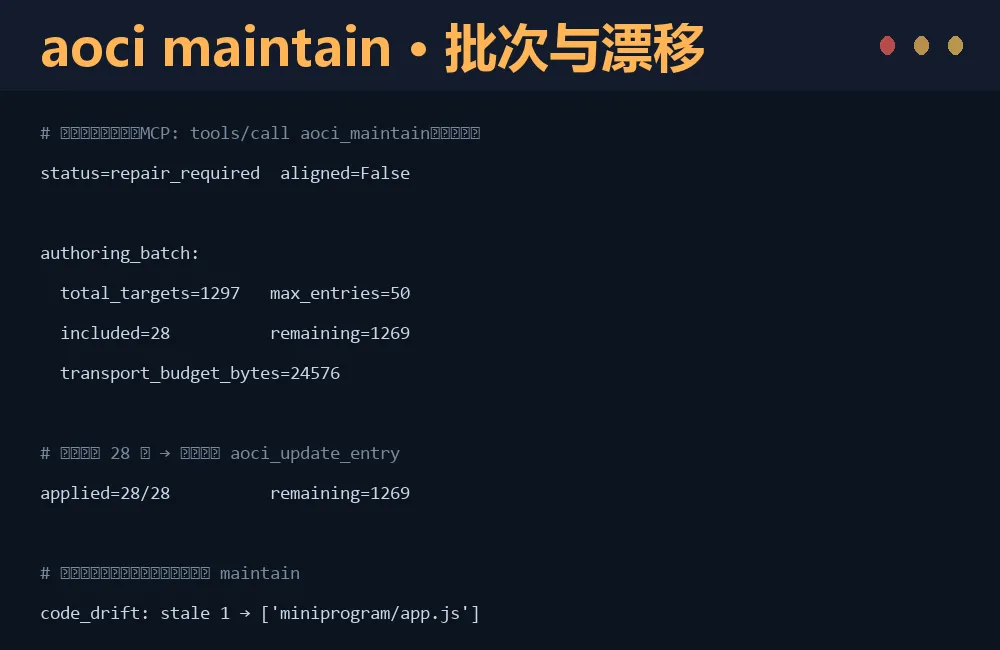
整个批次与漂移的过程,机器输出长这样:
值得:几万行以上、多人协作、经常换 agent 或换会话、需要接手别人的老项目。省的是每个任务开头重复搜索和解释的那段时间。
不值得:几千行的小项目、一次性脚本、你自己天天在写、闭着眼都知道结构的代码。索引本身也是要维护的,小项目是负担大于收益。
一个前提:仓库得是干净的。依赖、构建产物、AI 工具资产没排除掉的话,索引里全是噪声,先花十分钟写 .gitignore 再开始。
我把完整上手流程、FRAS 写作规范、以及踩到的 16 条坑整理成了 skill,开源在下面,照着走一遍大概二十分钟:
上游工具是 aoci-spec/aoci-code。提醒一句:它的许可是 FSL-1.1-MIT,不是 MIT——可以用、可以改,但不能拿它做成竞争性产品对外提供,两年后转 MIT。商用前确认一下这条。
索引能替 AI 记住代码,但决定建不建、建到多细的,还是你。
点击下方蓝色链接,领取《AOCI 代码认知索引上手速查》
资料包里有完整命令链、FRAS 四字段写法与配额表、以及实测踩坑清单,打印出来贴在显示器旁边照着做就行。