ARTICLE · 1151501
普通人用 AI 做短视频:一句话,三步,一条能发的片子
普通人用 AI 做短视频:一句话,三步,一条能发的片子
做短视频的人,卡点往往不在"不会拍",而在前面两件事:
不知道拍什么,和不知道怎么把想法变成画面。
你想做个视频讲讲自己的行业、自己城市的故事,脑子里有画面,但落到"这一格画什么、下一格怎么接",就卡住了。
今天这篇文章,给你一套能落地的三步方法。不用会画、不用会剪,也不用买设备——因为这三个环节,AI 都已经能接过去了。
先看一个变化:三个环节的门槛都被拉平了
传统做视频有三道工序:
| 环节 | 以前 | 现在 | |------|------|------| | 画 | 原画师 | 文生图 | | 演 | 拍摄 + 演员 | 图生视频 | | 剪 | 后期 | 剪映 |
这就是普通人现在能做出片子的原因——不是你有天赋了,是工具把门槛抬走了。
那剩下要做的是什么?三件事:
拆(把想法变成三格)→ 说全(让 AI 听懂)→ 锁(保持角色一致)。
一条 60 秒的短片,工作量大概是:3-6 格分镜 + 3-6 张图 + 3-6 段 5 秒视频 + 一次剪辑。
听起来不多吧?这就对了,它本来就不多。
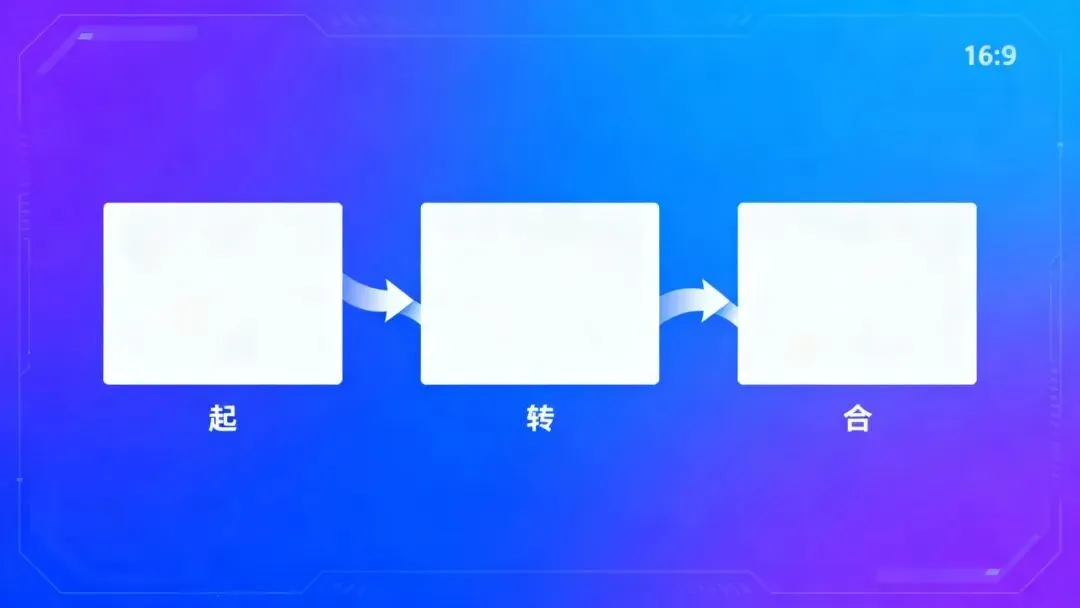
三格结构:起 → 转 → 合
第一步:拆——把一句话变成三格
这一步解决"拍什么"。
方法就一句话:先把 AI 放一边,用大白话把你的想法拆成三个观众看得懂的瞬间。
三格的结构是:起、转、合。
| 格 | 作用 | 你该自问 | |:--:|------|---------| | 起 | 抛出问题 | 主角在哪、遇到什么烦恼? | | 转 | 制造意外 | 发生了什么改变现状的事? | | 合 | 高潮反转 | 最后带来了什么变化? |
为啥缺一不可?
没有"起",观众不知道该替谁着急 没有"转",故事就只是流水账 "合"决定观众会不会点赞转发
让三格立住的公式
光有起转合还不够,每一格要写清这四样:
| 要素 | 说明 | |------|------| | 可见目标 | 观众看得见是否完成的 | | 阻碍 | 另一个人的合理目标、环境或时间 | | 代价 | 失败会失去什么、成功必须放弃什么 | | 选择 | 高潮里人物自己做的动作,不是旁白替他总结 |
给你一句检验的话,写完自己念一遍:
拿掉最后那个选择,人物和关系有没有变化?
没变,它还不算故事。
30 秒短片的节奏表
| 时间 | 做什么 | |------|--------| | 0-3 秒 | 开场立场锚定,先让人选边站 | | 3-5 秒 | 期待建立,层层加码 | | 5-7 秒 | 冲突变大,把情绪压紧 | | 7-9 秒 | 开始反转,用落差爆发 | | 9-15 秒 | 收束下钩子,留一个下一集 |
两条经验:
开场不是介绍背景,是制造立场 反转不要一步到位,分两到三拍给——爽感是一拍一拍推上去的
第二步:说全——让 AI 听懂你说什么
这一步解决"AI 凭什么听我的"。
有意思的是,同样的工具,有人拿到废片,有人拿到成品。差别就在有没有把话说全。
通用指令公式:BARD
B(背景):我是谁、什么情况 A(目标):我要什么、要多具体 R(角色):你扮谁、给谁看 D(要求):什么格式、什么规格落到生图上就是:
- 背景
→ 世界观与场景(如"老城区的傍晚、刚下过雨") - 目标
→ 这一格要什么画面、什么情绪 - 角色
→ 画风 + 主角身份 - 要求
→ 景别、画幅 9:16、光影、画质、不要出现什么
一段好提示词,就是一份给员工的清楚的任务说明书。
镜头咒语:景别 + 动作 + 情绪
- 景别
:电影级特写 / 近景 / 中景 / 全景 / 大远景 - 动作
:必须是动词——猛地睁开双眼 / 单膝跪地 / 把断剑插入地面 - 情绪光影
:眼神凌厉决绝 / 暗夜微光打在脸上 / 电影级光影 / 极致细节 8k
这一条你一定要记住:
形容词 AI 听不懂,动词才听得懂。
对比一下:
❌ "画一个很酷的少年,很帅"——没景别、没动作、没光影,AI 只能自己猜 ✅ 风格 + 景别 + 动作 + 眼神 + 光影 + 画质全写全——每一句 AI 都有事可做
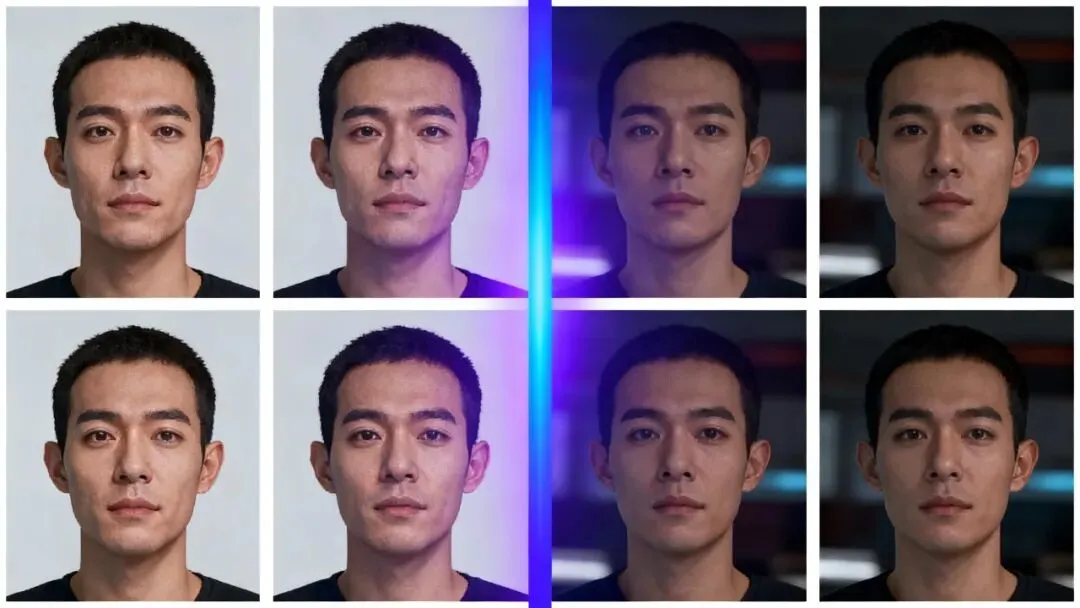
角色一致性:同一张身份证,每格照抄
第三步:锁——别让第二格换个人
这是新手翻车最多的地方。
先说一个真相:AI 不会记得你上一格画的是谁。你写多少,它记多少。
所以要准备"三件套":
① 角色身份证——一段写死外貌的文字,每格照抄:
年龄身份、发型发色、服装、标志性特征、气质用法:每生成一格,这段照抄不变,只改动作和场景。少一样,第二格就换人了。
② 风格前缀——全片统一的一句画风描述。
③ 参考图/垫图——有图比没图稳得多。
两个实战硬招
首尾帧接力:把上一段的尾帧,当下一段的首帧。跨段不换人、不跳光。
地标写结构不写地名:写"白色曲面壳体",别写"某某图书馆"——模型不认识地名。
记住这句话:AI 负责画,你负责拆和锁。
三条红线(做之前先知道线在哪)
- 不用真人肖像生成内容
——改用动漫化造型 - 不碰违法、低俗、暴力、虚假信息
——先看平台规则再开工 - 发布要双标注
——发布页勾选 + 画面前五秒字幕标注"AI 生成"
第三条别嫌麻烦:同质化、模板化的内容会被平台划入低质池。
从哪开始:给你一个最小行动
别一上来就做长篇,也别贪多。
就从这一步开始:做一条 30 秒、只讲一个点的片子。
具体怎么做:
- 选一个你熟悉的场景
——你的城市、你的行业、你身边的故事 - 写出三格
(起、转、合),每格用故事公式过一遍 - 用 BARD + 镜头咒语生成 3 张图
,角色身份证每格照抄 - 图生视频 → 剪辑 → 成片
- 发布前走一遍三条红线
第一次做完,你就知道自己卡在哪了——而卡住的那一步,正是你下次要突破的地方。
最后说句实在话
AI 让"做出来"变简单了,但"做得好"还是另一回事。
工具永远只是工具。真正决定成片质量的,是你有没有把故事拆对、有没有把话说全、有没有守住底线。
"AI 不背锅,方向错了才是废片。"
这句话我常说——因为见过太多人,把失败归给工具,其实是自己没想清楚。
这三件事,AI 替不了你——而那,正是你的价值。
你想用 AI 做一条什么样的片子?讲讲你的城市、你的行业,还是你的故事?
评论区说说你的想法——也许我能帮你把三格拆出来。
如果这篇对你有用,点个关注。接着我会写"怎么让画面动起来""怎么配音和剪辑"这些具体的环节。
把 AI 翻译成人话,用着用着就明白。
星河老师 · AI 知识翻译型讲师