ARTICLE · 1154456
把Cell顶刊选题法写进开源插件:Anthropic官方的插件库让科研工作方法彻底变天
作者/G
多数人对代码智能体的认知,还局限于编写程序和修复代码。
然而,从自动写代码到报错排查,这些 Agent 工具都展现出了极高的效率。除了程序员之外,我们的科研人员,还有大部分知识工作者,还一直处在未使用的边缘。
而在2026年秋季,大模型领军机构Anthropic官方,在开源社区正式发布了面向全行业知识工作者的官方插件库knowledge-work-plugins。该项目上线后引发轰动,关注度迅速突破2.6万星,成为继代码终端之后又一个现象级工程。
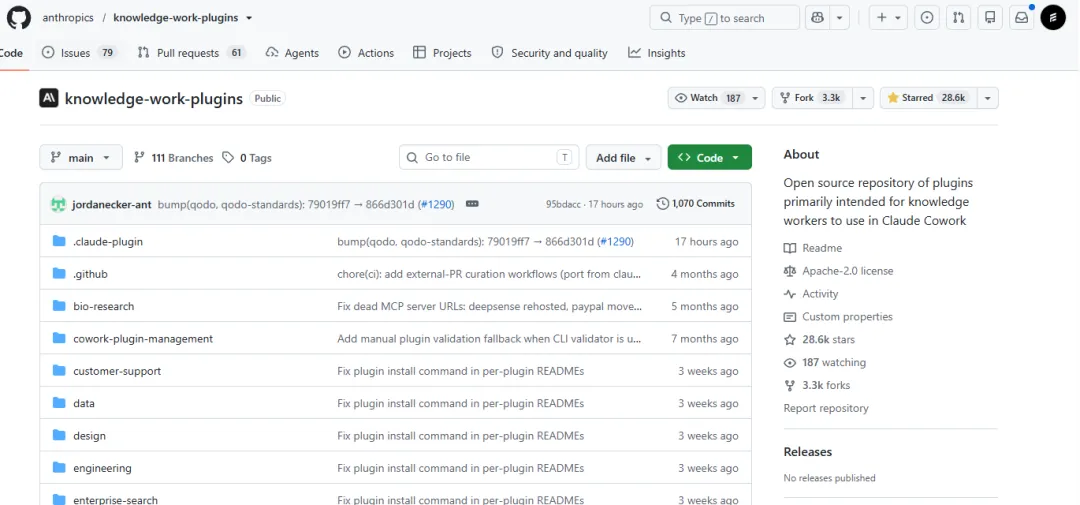
这个开源库的意义在于打通知识工作从目标到交付的闭环,首批开源体系覆盖11个核心工作角色,其中面向了生物医药科研、专业数据科学、法务审查与量化财务等高门槛方向,都展现出了极高的完整度。
当然,其实说白了,这就是相当于一个 skill,一个闭环的固定工作流程。
这个插件库的存在意义就是帮助研究人省去很多繁琐的程序,将学术科研的严谨性发挥到极致。
把《Cell》论文直接开源
在所有开源的插件模块中,最让学术界和生物医药研发圈震撼的是生物科研插件bio-research。
以前我们科研人员使用这种大语言模型,最难的问题就是无法控制它的真实性和严谨性,而且还有很多幻觉,并且一不小心就顺着你的意思往下说、往下做,这就导致整个流程跑偏
Anthropic官方在构建科研插件时,摒弃了这种逻辑,直接将顶刊方法论固化为了机器可执行的确定性程序。
这个插件的核心内容,加入了2024年2月在《Cell》顶刊上的权威论文,这样研究由Fischbach与Walsh共同完成,系统梳理了科学研究中的课题抉择与决策树推导模型。官方开发团队将整篇论文提炼成自动化技能,引导智能体在协助学者立项时,严格按照顶刊科学家思维进行反向压力测试。
学者在终端提出一个课题想法,智能体不会盲目附和,而是立即启动系统化评估流程。围绕着假设是否具备意义、现有的实验室条件、能否接受潜在的失败风险以及替代方案,让模型沿着一个有逻辑的结构层层递进,使研究方案在实验前就能排查好所有的漏洞和可能的问题
比思维模型更关键的突破是官方打通了底层科研基础设施。在数据的来源和分析方法上,这个插件采用了 MCP 协议,一次性接入了 11 个全球顶级的生命科学数据库和专业的分析工具。
在文献检索环节,模型直接调用PubMed医学文献库、bioRxiv预印本平台与Consensus科研证据搜索引擎,确保每项结论都有同行评议支持。
在药物研发与机制推演环节,系统无缝挂载欧洲生物信息学研究所的ChEMBL活性分子数据库、全球临床试验登记中心ClinicalTrials.gov以及开放靶点平台Open Targets。
在生物分析信息和测序领域内,插件还嵌了scvi-tools单细胞深度学习套件,还有标准化的单细胞RNA工作流,研究人员可以在终端用自然语言的形式,整个Agent就能从Pubmed去找最新文章,进行交叉对比临床实验。采用本地算法清洗单细胞测序数据,甚至直接生成生物图表草案。
纯文本架构
Anthropic公司一直是极简和美学融为一体的风格。
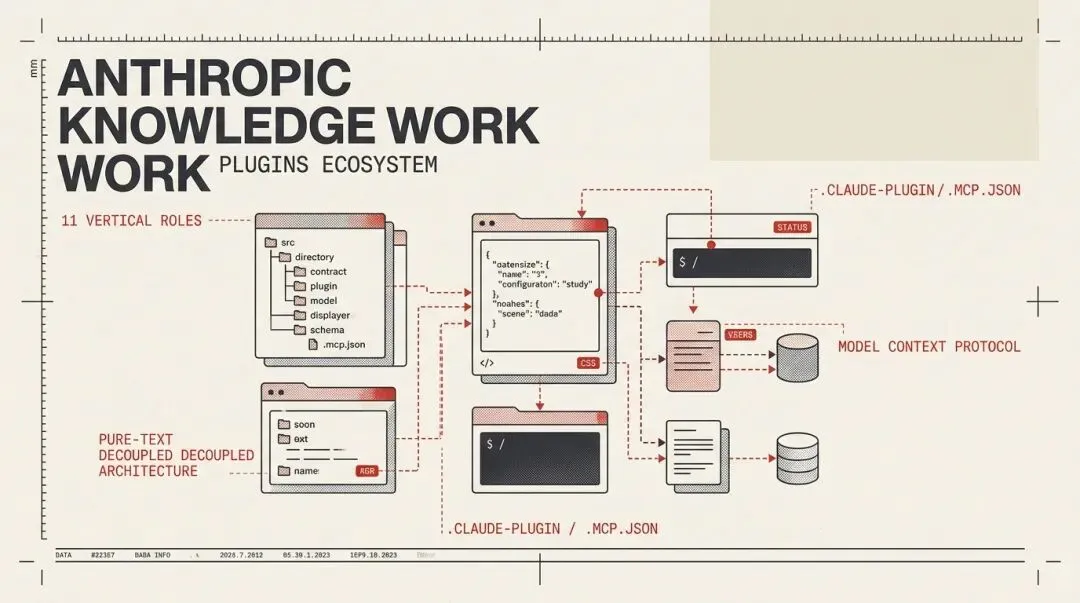
这个开源包,Anthropic官方采取了这个设计哲学:全套系统完全基于纯文本文件构建,不包含任何沉重依赖包,不需要前端构建步骤,所有配置文件均为透明可见的Markdown与JSON。
每个插件在文件系统内均保持高度一致的标准化目录结构:
... # 官方知识工作插件的标准结构plugin-name/├── .claude-plugin/plugin.json # 插件元数据与入口声明├── .mcp.json # 外部工具与数据库连接协议├── commands/ # 终端显式调用的快捷动作指令└── skills/ # 业务专业知识与自动化工作流规则明年
位于根目录的.mcp.json负责连接器的标准化挂载。它利用模型上下文协议,通过轻量级通信将模型与外部数据源绑定。研究组若想接入内部私有知识库,只需在JSON中替换服务地址,无需修改模型的逻辑核心。
位于skills目录下的技能文件,纯粹采用Markdown语法编写。开发团队将复杂的行业规范、审校步骤、业务术语与质量控制门槛,全部拆解为具备明确触发条件的流程说明。模型在交互过程中会根据上下文自动唤醒对应的技能,自主判断何时调用数据库,何时进行统计验证。
位于commands目录下的快捷指令,则为专业人员保留了精确的控制权。在数据分析模块中,输入特定的指令即可瞬时调出SQL优化器或统计检验流程。在法务模块中,单条命令即可触发保密协议风险排查清单。
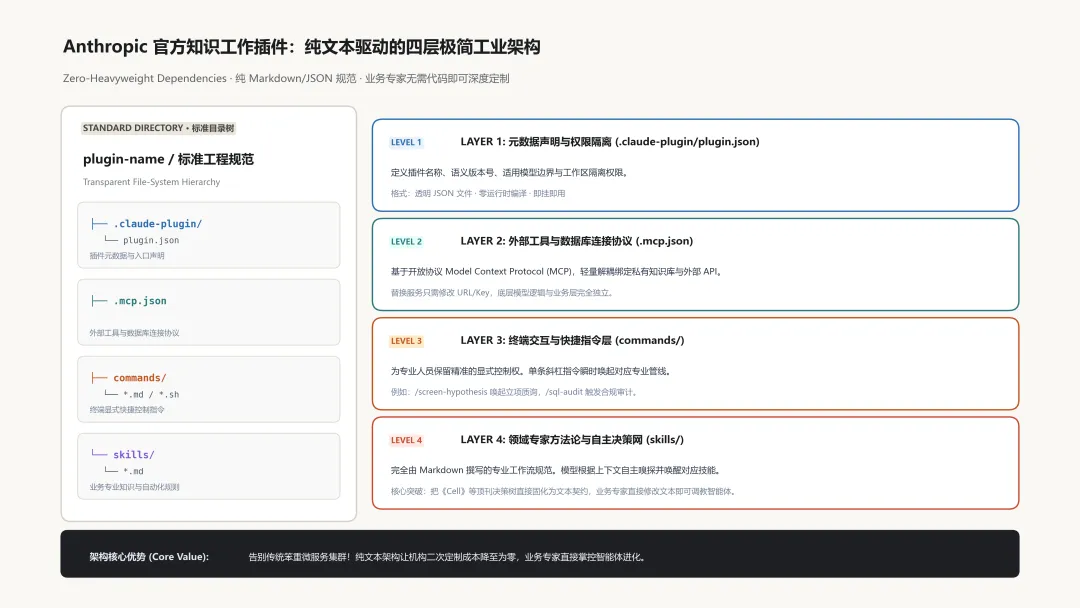
这种完全简洁的文本设计能让普通研究者或机构很容易上手,团队也不用专门聘请工程师,让人可以直接修改 Markdown 文件。很容易就能将团队搭建进这个知识库里面。
学术人员的工作跃迁
而人工智能深入加入到科研,很多科研人员的焦虑都是工具同质化严重、重复造轮子。所有人都在用通用大模型去撰写引言、翻译润色简单的文本,早就没有学术壁垒了。
现在的学术研究瓶颈,在多学科联合、跨系统数据检索上面。以往完成一个严肃的课题综述,学者需要在文献检索网站、靶点数据库、临床试验登记处以及本地数据表之间来回切换十几个浏览器标签页。
并且数据格式还不兼容,你要繁琐地重复手工粘贴,浪费了大量的精力。研究者很容易在这些低价值的重复劳动中感觉到耗费精力。
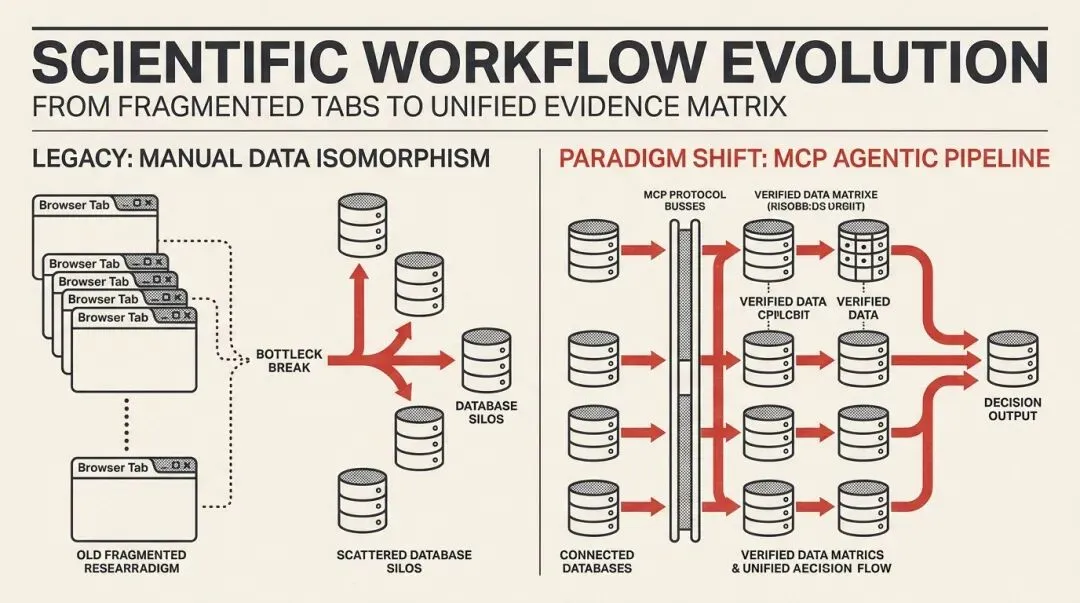
Anthropic插件库的价值,在于把顶尖学术思维模型与全链路基础设施进行统一封装。它把散落在各大孤立数据库中的专业资源,通过标准协议串联成随叫随到的自动化流水线。
对于身处科研一线的硕士、博士研究生和青年学者而言,这种工作流的演进指明了清晰的方向。跳出排版格式与低效搜寻,依靠严密工作流开展多维证据链交叉验证,学者得以把精力集中在假说的独创性与科学问题的核心推导上。
参考文献
Fischbach, M. A., & Walsh, C. T. (2024). Problem choice and decision trees in science and engineering. Cell, 187(4), 785–794. Anthropic. (2026). Knowledge Work Plugins: Open source repository of plugins primarily intended for knowledge workers to use in Claude Cowork. GitHub repository, anthropics/knowledge-work-plugins. Hou, L., et al. (2024). Model Context Protocol Specification: An open standard for connecting AI systems with data sources. Anthropic Technical Report.